调度延迟与 runqueue
更新时间:2026-10-01。这是 off-CPU 的一个关键子类:不是任务想睡,而是 CPU 忙、排队等上。
本文要回答的问题
- 任务被唤醒后为什么不能立刻运行?
- CPU 饱和在指标上怎么体现?
一、runqueue 等待
唤醒把任务放入 per-CPU 运行队列,若该 CPU 有正在运行或更高优先级任务,它要排队,产生调度延迟。CPU 利用率逼近饱和时队列变长,尾延迟急剧上升。
二、测量与对策
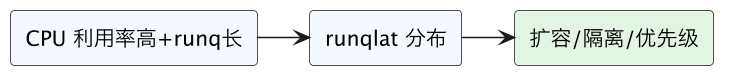
用 sched_stat_*、runqueue 长度和 runqlat 分布衡量“可运行但没 CPU”的时间;非自愿切换(sched_switch 中 preempt)增多是饱和信号。对策:扩容/减少超卖、cpuset/独占隔离核、关键任务提优先级、负载均衡。
三、常见坑
- 平均 CPU 不高却因热点单核造成排队。
- 把排队等待误判成锁/IO。
- 忽视尾部分布只看均值。
小结
调度延迟发生在“可运行但抢不到 CPU”,看 runqueue 长度与 runqlat;靠扩容、隔离和均衡解决。下一篇 perf c2c 伪共享深入。
总结
这是 off-CPU 的关键子类:任务被唤醒后进入 per-CPU 运行队列,若该 CPU 正忙或有更高优先级任务,它就得排队、产生“可运行却上不了 CPU”的调度延迟——这不是任务想睡,而是 CPU 饱和;利用率逼近饱和时队列变长、尾延迟急剧上升,非自愿抢占增多是明确信号。要用 sched_stat_*、runqueue 长度和 runqlat 分布量化,对策是扩容/减少超卖、cpuset 独占隔离核、关键任务提优先级、做好负载均衡,注意平均 CPU 不高也可能因单核热点造成排队。