perf 高级使用指南
更新时间:2026-08-06
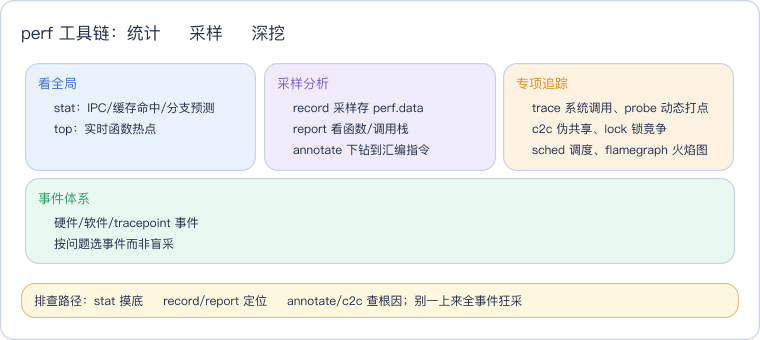
perf 工具系列已拆分至独立目录:每个子命令有专门的深度文档,配合交叉引用构建完整的 perf 知识网络。
📂 新文档结构
| 子命令 / 主题 | 文档 | 一句话 |
|---|---|---|
| perf stat | perf-stat | 整体统计:IPC、缓存命中率、分支预测 |
| perf top | perf-top | 实时函数级热点 |
| perf record | perf-record | 采样采集,生成 perf.data |
| perf report | perf-report | 采样数据分析 |
| perf annotate | perf-annotate | 汇编级性能热点 |
| perf trace | perf-trace | 系统调用追踪 |
| perf probe | perf-probe | 动态探针(内核/用户态) |
| perf c2c | perf-c2c | 缓存伪共享检测 |
| perf lock | perf-lock | 锁竞争分析 |
| perf sched | perf-sched | 调度器分析 |
| 事件体系 | perf-events | 硬件/软件/tracepoint 事件参考 |
| 火焰图 | perf-flamegraph | 火焰图生成与解读 |
📖 总索引:concepts/perf/ —— 子命令全景图、学习路径、排查路径、交叉引用
相关文档
| 主题 | 链接 |
|---|---|
| 场景化学习架构(12 个 demo) | perf-demos-architecture |
| 多线程+IO 三步分析法 | perf-multithread-io-analysis |
| 工具定位深度对比 | tool-perf-comprehensive-guide |
| perf 原理(PMU 采样 → mmap 缓冲区) | perf-internals |
实战案例导航
基于本仓库
demos/cpu-demo/main.cpp三个场景的完整案例分析:
| 案例 | 模式 | 编译 | 视角 | 核心发现 | 链接 |
|---|---|---|---|---|---|
| 1 | 模式 1 纯计算 | -O0 | :u | IPC 0.61, cycles 12G, 理想对照组 | 案例一 |
| 2 | 模式 1 纯计算 | -O2 | :u | IPC 1.68, cycles 2.5G, 优化 4.7× | 案例二 |
| 3 | 模式 2 syscall | -O0 | :u | 和模式 1 O2 一模一样,:u 陷阱 | 案例三 |
| 4 | 模式 2 syscall | -O2 | :u | CPU 利用率 0.99,频率 0.85 GHz 假象 | 案例四 |
| 5 | 模式 2 syscall | -O0 | :u+:k | 真实 cycles 12.28G, 频率 4.09 GHz | 案例五 |
| 6 | 模式 2 syscall | -O2 | :u+:k | O0 vs O2 仅差 1.4%,验证结论 | 案例六 |
核心结论速览
:u后缀是"湖面温度计"——只测表面,内核的真实成本完全不可见- 对 syscall-heavy 程序,O2 优化几乎无效(总 cycles 仅减少 1.4%),正确优化方向是减少 syscall 次数(批量写、mmap、io_uring)
- 4 字段诊断模板:
cycles:u, cycles:k, instructions:u, instructions:k是 3 秒内识别程序类型的终极方案
详细分析请阅读:perf 实战案例集
参考资料
- perf 官方文档:https://perf.wiki.kernel.org/index.php/Main_Page
- 《Linux性能优化实战》 陈莉君
- FlameGraph 官方文档:https://github.com/brendangregg/FlameGraph
- https://www.brendangregg.com/perf.html
总结
perf 进阶最该记住的是「:u/:k 分用户态/内核态」这个视角陷阱与 4 字段诊断法::u 后缀只统计用户态、像「湖面温度计」,syscall-heavy 程序的真实内核成本完全不可见——案例里模式 2(syscall)用 :u 看 O0/O2 几乎无差异、甚至出现「CPU 利用率 0.99 却频率 0.85GHz」的假象,加上 :k 才看到真实 cycles(12.28G、4.09GHz)。由此两条硬结论:对 syscall 密集型程序,O2 优化几乎无效(总 cycles 仅减 1.4%),正确方向是减少 syscall 次数(批量写、mmap、io_uring);cycles:u, cycles:k, instructions:u, instructions:k 这 4 字段是 3 秒内识别程序类型(计算型 vs syscall 型)的终极模板。