CPU 饱和与利用率判读
更新时间:2026-10-01。利用率是最常被误读的指标,尤其在多核和虚拟化环境。
一、拆解字段
us 用户计算、sy 内核(系统调用/网络栈重)、wa 等待 IO(CPU 其实空闲)、st 被 hypervisor 挤占。高 wa 不是算力问题;高 sy 指向系统调用/内核开销。
二、多核陷阱
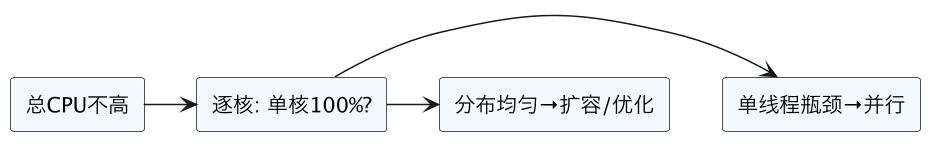
单线程程序最多打满 1 个核,在 N 核机器总利用率仅 1/N 却已到该程序上限——此时“CPU 没满”不代表能更快,要靠并行化而非扩容。要逐核看(mpstat -P ALL)。
三、饱和点
利用率越过某值后排队延迟非线性上升(queueing),延迟敏感服务应留余量运行,不追求 100%。
四、常见坑
- 用总利用率判断单线程程序。
- 高 wa 当成算力不足。
- 服务跑到饱和导致尾延迟。
小结
利用率要分 us/sy/wa/st 并逐核看,单线程满核是并行问题;延迟敏感负载要运行在饱和点以下。下一篇 上下文切换开销。
总结
CPU 利用率是最常被误读的指标:要先拆成 us 用户态/sy 内核态/wa IO 等待/st 被虚拟化偷走——高 wa 不是算力不足、高 sy 才指向系统调用开销;多核机器上总利用率还会掩盖单核打满(单线程程序一核 100%、总体仅 1/N 即已到上限,该并行而非扩容),务必逐核看;且越过饱和点后排队延迟非线性上升,延迟敏感服务应留余量、不追 100%。