SR-IOV 硬件机制:PF/VF 的队列与中断资源切分、直通延迟优势速查
更新时间:2026-10-05。云上拿到一张「SR-IOV 直通网卡」时,多数人只关心带宽数字,很少追问:同一块物理芯片,怎么同时给几十个虚机当「独占网卡」用、互相还看不见?答案在 SR-IOV 硬件机制——设备在 PCIe 层把自己复制成一个 PF 加一串 VF,队列、中断、寄存器窗口按 VF 粒度硬件分身。它是 PCIe 设备模型 在虚拟化方向的延伸,隔离半边靠 IOMMU 与 SMMU 的地址翻译路径,性能对照组是 EPT/NPT 二级地址翻译 之外的另一条虚机 I/O 路线。
本文要回答的问题
- PF 和 VF 在硬件上到底是什么关系?VF 复制了哪些资源、共享了哪些资源?
- 每个 VF 的队列对和中断向量是怎么切出来的?为什么是「页帧复制」而不是「真复制」?
- VF 直通给虚机后,DMA 和中断的隔离靠什么硬件兜底?
- 直通相对 virtio/vhost 省下的延迟具体省在哪几跳?
一、PF 与 VF:一份配置空间,多个功能号
SR-IOV(Single Root I/O Virtualization,单根 I/O 虚拟化)是 PCIe 标准扩展。支持它的设备在配置空间里挂一个 SR-IOV Extended Capability,声明「我能变出 N 个 VF」。物理功能 PF(Physical Function)是完整功能,驱动在宿主机上跑,负责初始化、分配 VF、配 VLAN 和速率;虚拟功能 VF(Virtual Function)是轻量功能,只有数据面能力:收发队列、中断、自己的 BAR 窗口,没有管理权限。
关键点:VF 不是软件模拟,是设备里的真实硬件上下文。宿主机在 PF 驱动里 echo 32 > /sys/bus/pci/devices/<bdf>/sriov_numvfs,设备固件就在 PCIe 总线上「长出」32 个新 BDF(总线/设备/功能号),每个都能被单独 vfio-pci 绑定、直通给不同虚机。虚机里的 VF 驱动看到的就是一个普通的 PCIe 网卡,不需要知道自己只是八十分之一。用完回收也对称:echo 0 > sriov_numvfs,所有 VF 从总线上消失,队列上下文归还资源池。
两个现场可用的快查命令:lspci -nn | grep -i virtual 列出当前已生成的 VF;ethtool -i <vf网卡名> 在虚机里确认驱动认到的是 VF 型号(如 i40evf、mlx5_core)。如果 sriov_numvfs 写入后没反应,八成是 BIOS 里 SR-IOV 开关没开,或者 IOMMU 没启用——直通场景这两样缺一不可。
| 维度 | PF | VF |
|---|---|---|
| 配置能力 | 完整:管理 VF、配队列数、VLAN、QoS | 受限:复位自己、收发数据 |
| 队列资源 | 全部队列池的分配权 | 分到手的固定几个队列对 |
| 中断 | 管理中断加自己的数据中断 | 仅自己的 MSI-X 向量 |
| 驱动位置 | 宿主机内核 | 虚机内核(直通)或 DPDK |
| 数量 | 每口 1 个 | 每口几十到上百(如 128) |
二、资源切分:队列页帧复制与中断向量划分
VF 便宜的秘密在于「复制的是窗口,不是引擎」。MAC 收发包逻辑、SerDes、片上交换都只有一份,所有 VF 共享;真正按 VF 复制的是三样:
- 队列对上下文:每个 VF 分到若干 TX/RX 队列的描述符环基址、头尾指针、门铃寄存器。以常见 25G 网卡为例,128 个 VF 各分 4 对队列,硬件里就是 512 组环上下文。
- BAR 页帧:VF 的 BAR 不指向新内存,而是把同一块寄存器物理区按页(通常 4K 或 16K 对齐)切成 N 帧,第 K 个 VF 的 BAR 映射到第 K 帧。虚机访问自己 BAR 里的「队列 0 门铃」,落在自己帧的偏移上,硬件按帧号路由到对应队列上下文——天然隔离,VF 之间想越界都没有地址可写。
- MSI-X 中断向量:每个 VF 有独立的 MSI-X 表,分配到自己的向量号。虚机里
cat /proc/interrupts看到的网卡中断就是这几根,绑核、调亲和性与裸机完全同款玩法。
还有一个容易踩的坑是资源总量守恒:队列池、中断向量池、IOTLB 容量都是芯片级的,VF 开多了每个 VF 分到的队列就缩水。比如某卡共 768 对队列,开 64 个 VF 时每 VF 能分 8 对,开 128 个就只剩 4 对——虚机里 ethtool -l 看到的队列数变少不是 bug,是池子被摊薄了。规划 VF 数量时先算清单虚机需要几对队列喂满 vCPU。
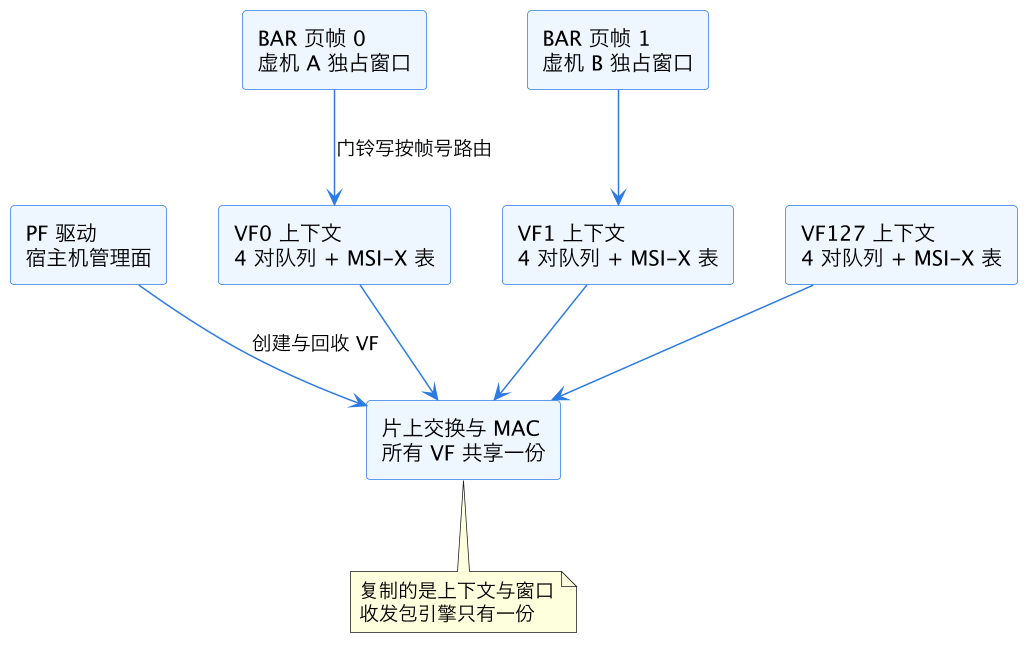
上图是 SR-IOV 硬件机制的资源切分全貌:管理面走 PF,数据面每个 VF 一份队列上下文和 BAR 页帧,昂贵的 MAC 与交换逻辑全局共享。虚机写的每一个门铃、收的每一个中断,都落在自己那份上下文上。
三、隔离兜底:DMA 走 IOMMU,中断走重映射
队列隔离由设备保证,但 VF 能发起 DMA——如果不管,虚机 A 的 VF 可以让 DMA 写到虚机 B 的内存。兜底的是 IOMMU:VF 直通时,hypervisor 给该 VF 的 Requester ID 建一张二级页表,VF 发出的每一笔 DMA 地址都要过 IOMMU 翻译成宿主机物理地址,且只允许落在该虚机的内存范围。路径细节与页表级数见 IOMMU 与 SMMU 的地址翻译路径。
中断同理:MSI-X 本质是往一个地址写一个数据,虚机能配这张表就会失控,所以 Intel VT-d 的中断重映射(Interrupt Remapping)把 VF 的中断消息按向量号再路由一次,只许投递到目标 vCPU。两层兜底之后,VF 在虚机手里就是「看得见、摸得着、跑不满整卡也伤不到邻居」的状态。注意这带来一个真实的性能税:DMA 翻译走 IOTLB,未命中要查内存里的页表,大流量下 IOTLB 压力和 EPT/NPT 二级地址翻译 的 TLB 压力是同构问题——这也是很多 NFV 场景开 hugepage 的原因之一。
排障时有个顺序经验:虚机里 VF 网卡 up 但收不到包,先看宿主机 PF 侧 ip link show 里对应 VF 的 state 是不是 ENABLE、spoofchk 和 trust 标志是否符合预期——不少云场景默认开 spoof 检查,虚机里改 MAC 直接丢包;再查 IOMMU 分组,dmesg | grep -i dmar 有报错基本就是直通没配干净。
四、延迟优势速查:直通省在哪几跳
对照组是 virtio:虚机发包要走「guest 驱动 → virtqueue → VM exit 或 vhost 内核线程 → 宿主机协议栈 → 物理网卡」。SR-IOV 直通后变成「guest VF 驱动 → 硬件队列 → 网卡」,宿主机完全不在数据面上。
| 跳 | virtio + vhost | VF 直通 |
|---|---|---|
| VM exit/内核切换 | 每批包至少一次(eventfd/中断) | 无 |
| 数据拷贝 | vhost 零拷后仍有描述符跨域搬运 | 零,DMA 直落 guest 内存 |
| 宿主机协议栈 | 走一遍(桥/iptables/OVS) | 绕过 |
| 典型单程延迟增量 | 5-20 微秒(视 vhost 模式) | 1-3 微秒(主要是 IOMMU 翻译) |
| 抖动 | 受宿主机调度影响,长尾明显 | 接近裸机分布 |
代价也要记账:VF 通常不支持热迁移(硬件状态搬不走)、部分型号 VF 功能裁剪(无 promisc、无部分 offload 配置权)、安全上依赖设备厂商的分区实现质量。选型口径很直白:要极致延迟和可预期抖动、且虚机位置固定,上 VF 直通;要灵活调度、热迁移、丰富虚拟网络功能,留在 virtio/OVS 世界,用 RSS 多队列 和 vhost 调优去挤性能。
这一篇在知识体系里的位置
本篇属于 microarch 层的 I/O 虚拟化速查,与 IOMMU 与 SMMU 的地址翻译路径(DMA 翻译细节)、EPT/NPT 二级地址翻译(CPU 侧翻译对照)构成虚机性能的三块拼图;向上接 PCIe 设备模型 和 CPU 微架构总览,向网络数据面延伸到 RSS 多队列 与 网络协议栈优化。
总结
SR-IOV 硬件机制的本质是「复制窗口、共享引擎」:PF 管管理面,每个 VF 拿到独立的队列上下文、BAR 页帧和 MSI-X 向量,DMA 与中断由 IOMMU 和中断重映射兜底隔离,换来相对 virtio 每包省掉 VM exit、宿主机协议栈和跨域搬运的三跳,直通延迟压到微秒级——代价是热迁移缺失和对设备固件分区质量的依赖。