分支预测(Branch Prediction)—— CPU 为什么要"赌"下一条指令,赌错有多贵
cpu-out-of-order 讲乱序执行时提了一句"遇到分支还没算出方向,CPU 会猜一条路先执行"。这一句背后是整个分支预测器——现代 CPU 里最精巧的部件之一。它猜得准,流水线满速飞;猜错一次,几十条在飞的指令全作废重来。
本篇详细论述:为什么非猜不可(流水线的宿命)、预测器怎么工作(BTB / 两位饱和计数器 / 历史 / TAGE)、猜错的代价有多大、代码怎么写才对预测器友好、以及它如何催生了 Spectre 这类安全漏洞。 前置最好先读 cpu-out-of-order 建立"流水线 + 投机执行"的框架。
它是微架构演进链的"⑤分支预测+投机"环节(解决④乱序执行遇到分支就卡的控制冒险)——整条链的导读见 cpu-microarch-overview。
前置知识:术语速查
后文大量出现这些词,在此集中解释,省得读到一半来回翻。
0.1 jcc 是什么
jcc = Jump if Condition is met,x86 条件跳转指令族的统称。不是一条指令,是一组:
| 指令 | 全称 | C 等价 |
|---|---|---|
je / jne | Jump if Equal / Not Equal | if (a == b) / if (a != b) |
jg / jl | Jump if Greater / Less | if (a > b) / if (a < b) |
jge / jle | Jump if Greater or Equal / Less or Equal | if (a >= b) / if (a <= b) |
ja / jb | Jump if Above / Below | if (a > b) / if (a < b)(无符号) |
你写的每一条 if/for/while,最终都编译成 cmp + jcc 指令对:
; C: if (x > 0) foo(); else bar();
    cmp    $0, %eax          ; 比较 x 和 0
    jle    .else_label       ; x <= 0 → 跳到 else 分支(jcc 指令)
    call   foo               ; x > 0 路径(预测"不跳"走这里)
    jmp    .end
.else_label:
    call   bar               ; x <= 0 路径(预测"跳"走这里)
.end:
jcc 是分支预测器盯着的物理对象。预测器不关心"这段 C 代码有没有 if"——它只在 fetch 阶段看到 jcc 指令时工作:猜方向(跳 / 不跳)+ 猜目标(跳去哪)。后文所有"分支预测"的讨论,本质上都是"CPU 拿到一条 jcc 时怎么决策"。
0.2 µop(微操作):流水线里的真正"指令"
x86 指令是 CISC 风格——一条 add (%rsi), %rax 同时做了读内存和加法。现代 CPU 内部会把每条 x86 指令译码成 1~N 条 µop(micro-operation),µop 是 RISC 风格的简单操作(一次读、一次算、一次写)。在流水线里真正被调度、发射、执行的是 µop,不是你写的 x86 指令。
| 概念 | 谁产生的 | 流水线里跑的是它吗 | 举例 |
|---|---|---|---|
| x86 指令 | 编译器输出 | 否 | add (%rsi), %rax(1 条) |
| µop | Decoder 译码 | 是 | load µop + add µop(2 条) |
记住:后文说"一条指令在流水线里…"时,绝大多数时候指的是 µop。
cmp + jcc被译码成 1 条 CMP+JCC 融合 µop,就是因为它被 macro-fusion 从 2 条变 1 条了。
0.3 macro-fusion(宏融合):为什么 cmp+jcc 是一条 µop
现代 Intel CPU(Core 2 以来)和 AMD Zen 会把连续的 cmp + jcc 熔成一条 µop("比较并跳转"融合 µop),省一条 µop 的译码带宽。但它仍然是分支 µop:仍然查 BTB、仍然走方向预测、仍然在分支端口执行——融合省的是 µop 槽位,不省预测逻辑。
0.4 分支预测相关的核心硬件
| 缩写 | 全称 | 一句话 | 在哪级 |
|---|---|---|---|
| BTB | Branch Target Buffer | 缓存"指令地址 → 上次跳到的目标地址",专门猜跳去哪 | 取指 |
| BHT | Branch History Table | 记录分支的"历史行为"(最近几次跳没跳),为方向预测器提供输入 | 取指 |
| RSB | Return Stack Buffer | 专用硬件栈:call 时压入返回地址,ret 时弹出预测——专门优化函数返回 | 取指 |
| taken | — | 分支"跳"——下一条指令在跳转目标地址 | — |
| not-taken | — | 分支"不跳"——下一条指令顺序往下走(fall-through) | — |
| IP | Instruction Pointer | 指令指针(x86 里叫 RIP/EIP),指向当前正在被 fetch 的指令地址。预测器用 IP 直接索引 BTB/BHT | — |
0.5 乱序执行核心结构
| 缩写 | 全称 | 一句话 | 在哪级 |
|---|---|---|---|
| ROB | Reorder Buffer | 环形队列,记录所有"正在飞"的 µop,保证乱序执行后顺序退休(见 ooo-renaming-retirement §二) | 重命名→退休 |
| RS | Reservation Station(发射队列) | 存放已译码、待发射的 µop——操作数一就绪就发到执行端口 | 发射 |
0.6 性能观测缩写
| 缩写 | 全称 | 一句话 |
|---|---|---|
| IPC | Instructions Per Cycle | 每周期退休的指令数,<1 说明流水线在空转 |
| PMU | Performance Monitoring Unit | CPU 内部的硬件计数器,perf stat 读的就是它 |
| I-cache | Instruction Cache (L1i) | L1 指令缓存,存的是要执行的指令,与存数据的 D-cache 分开 |
| iTLB | Instruction TLB | 指令侧的 TLB,缓存虚拟地址→物理地址翻译,I-cache miss 可能连带 iTLB miss |
| D-cache | Data Cache (L1d) | L1 数据缓存,存的是 load/store 的数据 |
一、为什么非猜不可:流水线的宿命
现代 CPU 是深流水线:一条指令要经过取指→译码→重命名→发射→执行→退休十几到二十几级(stage),每级一拍。这样才能让多条指令重叠、把吞吐顶上去(见 cpu-out-of-order)。
问题出在条件分支(if、循环判断、switch):
if (x > 0)   // ← 这一步的比较结果,要好几拍后才算出来
    foo();   // 该取这里的指令?
else
bar(); // 还是这里?- CPU 的前端(取指) 必须每拍都喂新指令进流水线,否则后面十几级全空转(叫 pipeline bubble,气泡)。
- 但
x > 0的结果要等到执行级才算出来——那是好几拍甚至几十拍之后(若x还要从内存 load,更晚)。 - 前端等不起:如果每遇到分支就停下来等结果,深流水线的收益全没了,退化成挤牙膏。
1.0 取指不能停:下一拍就要下一条指令
CPU 前端(fetch)的节奏是每拍取一批指令(典型 16B)。当它取到一条 jcc 时:
- 下一拍取指时钟照常打到——必须立刻决定从哪个地址取,没有"等我看看 jcc 方向"的选项。
- 等 jcc 方向算出?那要 5~10 拍之后——这段等待期内取指停掉,流水线就断了。
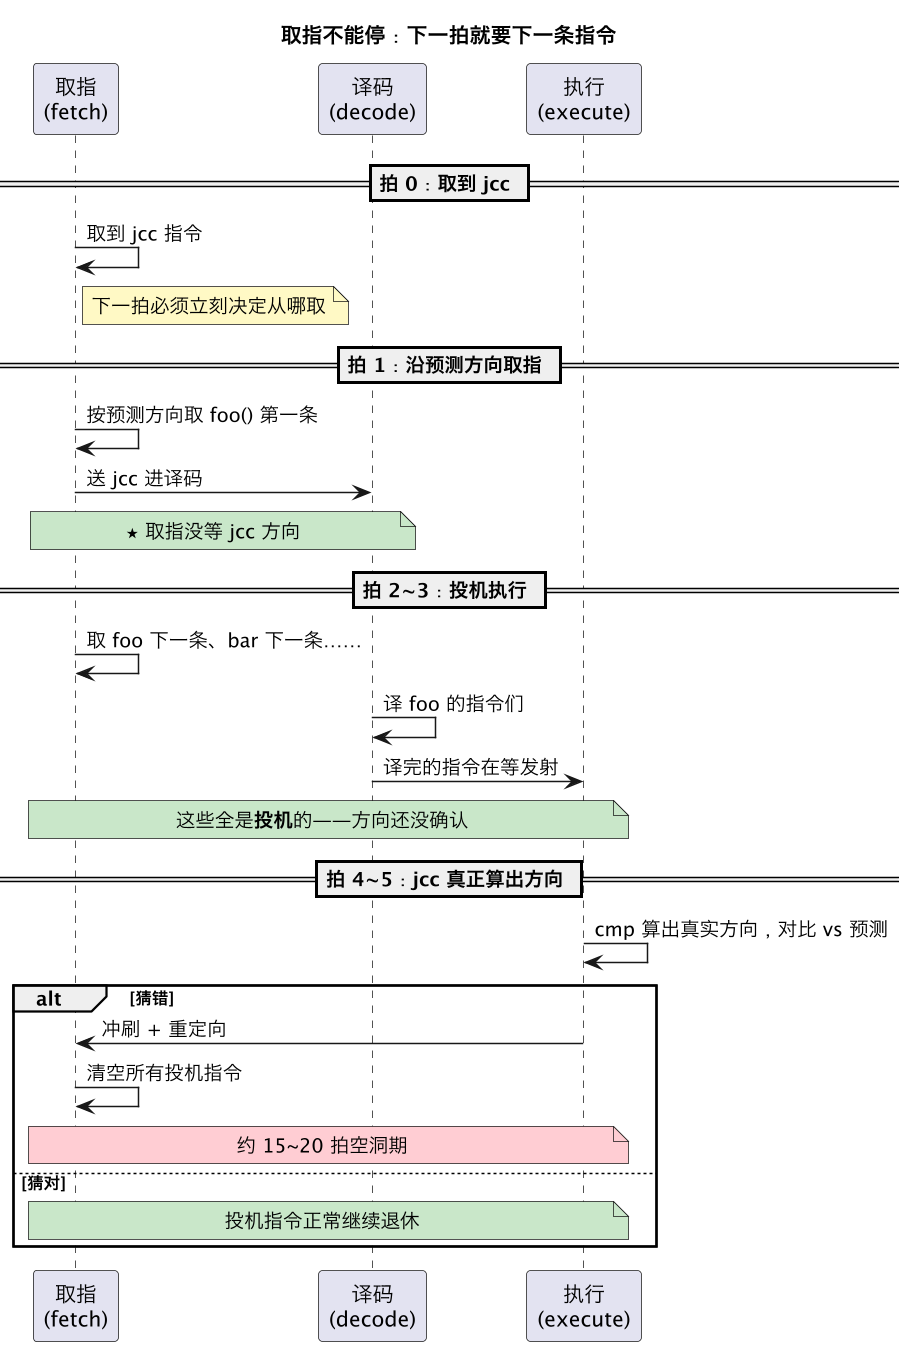
这张图的核心:
| 时刻 | 发生的事 | 为什么必须"猜" |
|---|---|---|
| 拍 0 | 前端取到 jcc | — |
| 拍 1 | 前端立刻按预测方向取了下一条(foo() 的第一条指令) | 取指每拍都要产出 16B——不等 jcc 方向,也等不起 |
| 拍 1~3 | 预测路径上的指令源源不断进入译码、发射——这些全是投机的(方向还没确认) | 如果等确认再取指,这段时间取指全空转(pipeline bubble) |
| 拍 3~5 | jcc 方向终于算出 → 与预测对比 | 此时已经有 ~3 条投机指令在飞 |
| 拍 5~7+ | 若猜错:flush 投机指令 + 重定向取指 → 15~20 拍空洞 | 惩罚 ≈ 流水线深度 |
核心动机:深流水线要求前端永不停顿地喂指令,但分支方向要很晚才知道。于是 CPU 赌——预测一个方向,立刻沿着它投机执行。赌对了,分支几乎零成本;赌错了,把猜错这条路上做的一切回滚重来。 分支预测器的全部工作,就是让这个"赌"尽可能准(现代能到 95%~99%)。
1.1 流水线视角:跟踪一条 jcc 的完整旅程
把上面两张图串联起来——下面跟踪 cmp $0, %eax; jle .else 这组 cmp + jcc 在 Intel Skylake 风格流水线里的逐级行为,看分支预测在哪一级介入、在哪一级兑现。
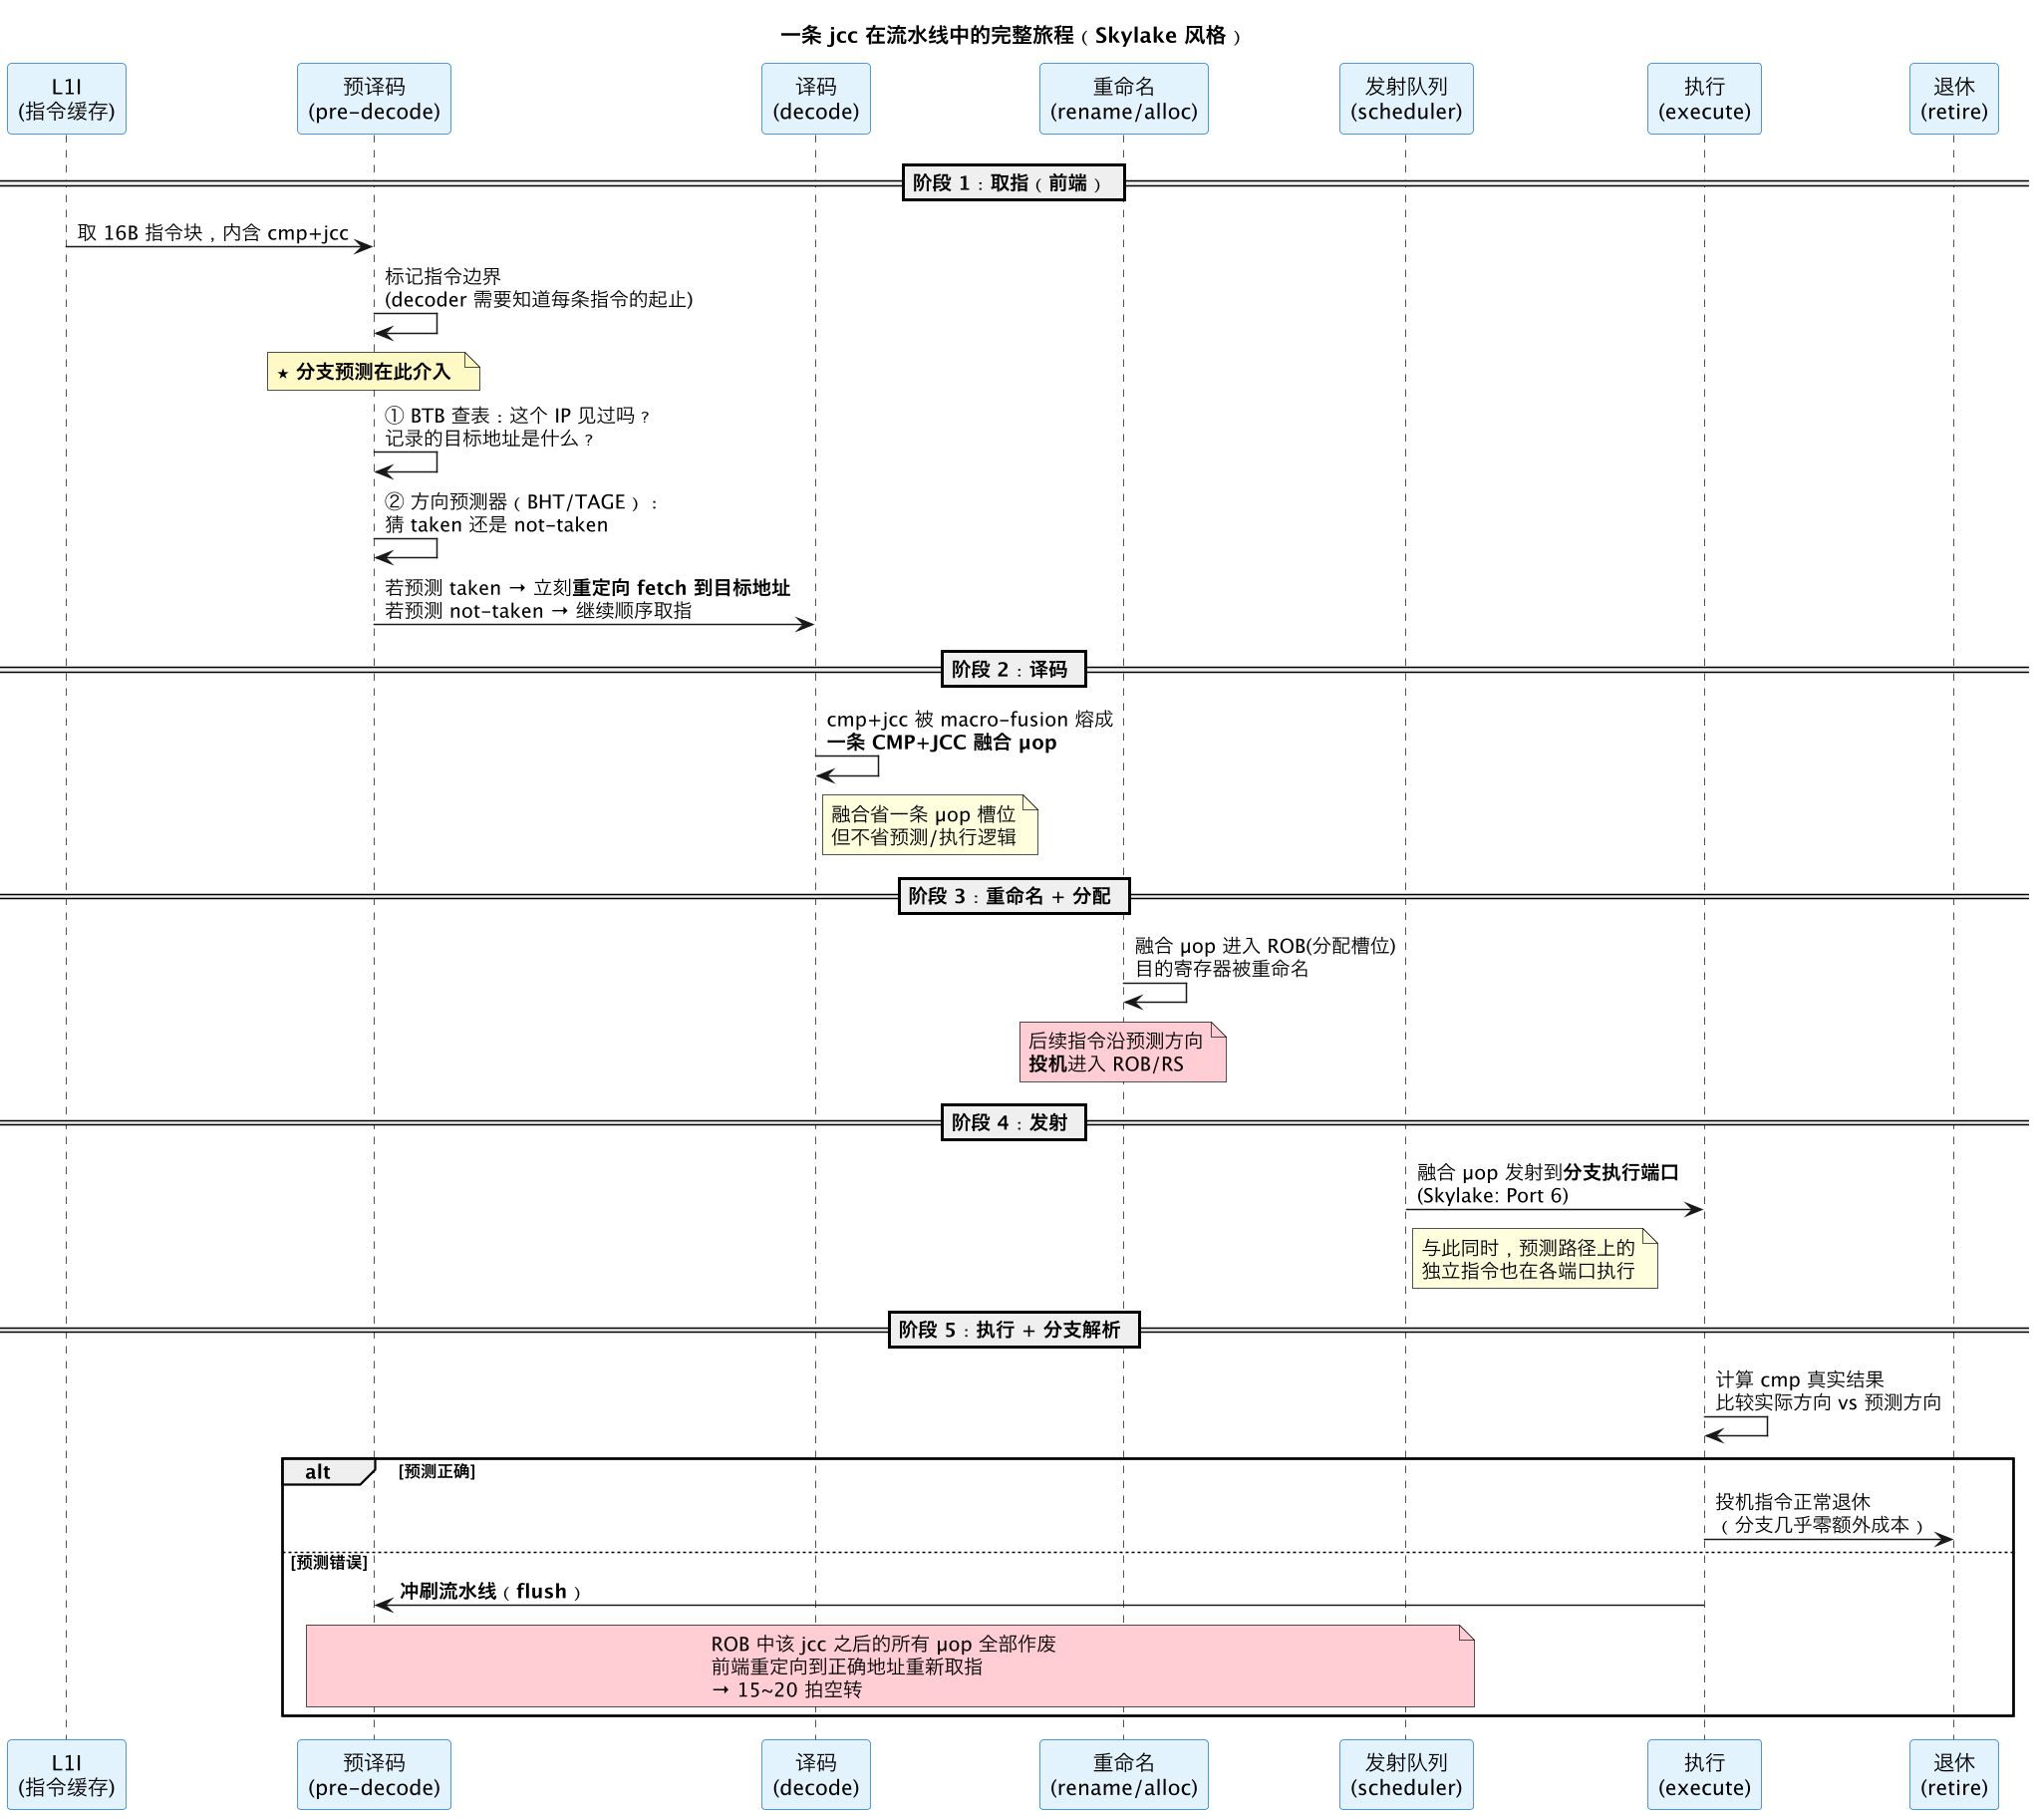
逐级详解:
| 流水级 | 对 jcc 做了什么 | 与普通指令的区别 |
|---|---|---|
| 取指 (fetch) | BTB 查目标地址 + 方向预测器猜 taken/not-taken → 决定下一条取指的地址 | 普通指令:顺序取指,不查 BTB |
| 预译码 (pre-decode) | 标记指令边界,为 decoder 准备 | 无区别 |
| 译码 (decode) | cmp + jcc → macro-fusion 熔成一条 CMP+JCC µop(省一个 µop 槽) | 普通指令:一对一或一对多译码 |
| 重命名 (rename) | 融合 µop 分配 ROB 槽位;预测路径上的后续指令投机进入 ROB | 普通指令:只在确认路径上进 ROB |
| 发射 (dispatch) | µop 被发到分支端口(Skylake Port 6)等待执行 | 普通 ALU 指令走 Port 0/1/5 |
| 执行 (execute) | 计算 cmp 结果,对比真实方向 vs 预测方向 | 普通指令:只算结果,不对比 |
| 退休 (retire) | 预测正确 → 正常退休;预测错误 → 触发 nuke/flush,清空后续所有投机 µop | 普通指令:正常退休,不会触发 nuke |
几个关键细节:
预测发生在取指阶段,不是执行阶段——jcc 还没译码,方向就已经猜完了。预测器和 jcc 之间没有"先译码再猜"的因果关系——用 IP(指令地址)直接索引预测表。
macro-fusion 让
cmp+jcc变成一条 µop 在流水线里跑,但它仍然是分支 µop:仍然查 BTB、仍然走方向预测、仍然在分支端口执行。融合省的是译码带宽(原本两个 µop 槽现在一个),不省分支预测本身。"投机"的本质:CPU 在还不知道 jcc 真实方向的情况下,就已经让预测路径上的几十条指令进了 ROB、占了 RS、甚至执行完了。这些指令在退休前都带着"待确认"标记——一旦预测错误,全部作废。
为什么惩罚是 15~20 拍:从执行级发现错误 → 发 flush 信号 → 前端重新取指 → 新指令灌满流水线到退休,这段"空洞期"的长度 ≈ 流水线深度。这 15~20 拍里,执行端口全在空转。
一句话:jcc 在流水线里的特殊之处不是"它本身跑得慢",而是它控制着前端往哪取指——这个决策必须提前做出(取指阶段等不起),所以 CPU 在没看清方向时就猜、猜错就全盘推倒重来。
二、要猜两件事:跳不跳、跳去哪
一条分支其实要预测两个独立的问题:
| 预测什么 | 问题 | 负责的部件 |
|---|---|---|
| 方向(direction) | 这个条件分支跳还是不跳(taken / not-taken) | 方向预测器(BHT / 两位计数器 / TAGE) |
| 目标(target) | 如果跳,跳到哪个地址 | BTB(Branch Target Buffer,分支目标缓冲) |
- 对
if/for/while这种条件分支,主要难在方向。 - 对
switch、函数指针、虚函数调用(间接分支 indirect branch),目标地址本身就不定——难在目标,由 BTB(以及更专门的 indirect branch predictor)负责。 - 函数返回有个专门的 RSB(Return Stack Buffer):调用时压入返回地址、返回时弹出预测,专门优化
call/ret配对。
下面重点讲最经典、也最能建立直觉的方向预测。
三、方向预测器怎么工作:从"上次怎样"到 TAGE
3.1 最朴素:一位预测(上次跳这次就跳)
给每个分支记一位:上次 taken 就预测 taken。问题:循环边界会连错两次。一个跑 100 次的 for:
- 最后一次(第 100 次)退出循环 → not-taken,但预测器记的是"上次 taken" → 猜错;
- 下次再进这个循环,第一次判断,预测器记的是"上次(退出那次) not-taken" → 又猜错。
每轮循环错两次,太蠢。
3.2 经典:两位饱和计数器(要连错两次才改主意)
给每个分支一个 2 位状态机(0~3),taken 就 +1、not-taken 就 -1(饱和不溢出)。高位决定预测:≥2 预测 taken,<2 预测 not-taken。
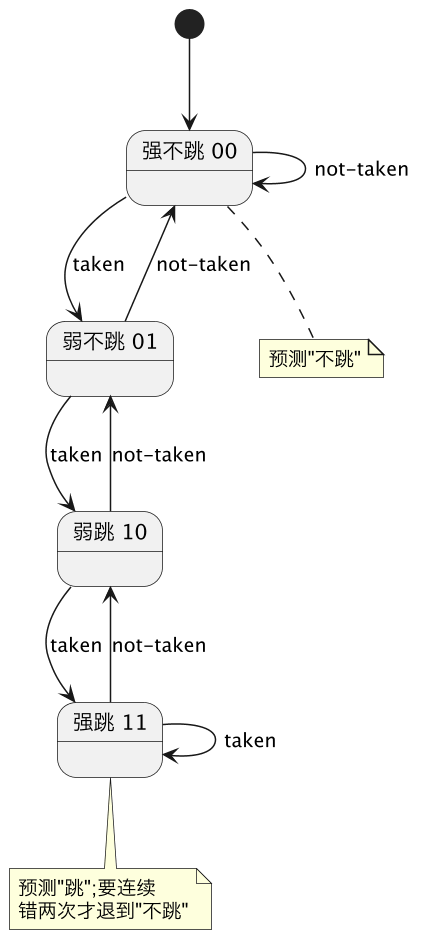
妙处:一次反常不改主意,要连错两次才翻转。那个跑 100 次的循环:99 次 taken 让计数器牢牢停在"强跳",最后一次退出错一次、但不翻主意 → 每轮只错 1 次(退出那次),比一位预测好一倍。这就是教科书级的 2-bit saturating counter。
3.3 进阶:带历史(同一个分支,看它前面几次的模式)
两位计数器只看"这个分支自己的多数票",但很多分支是有规律的模式,比如 TNTNTN...(隔一次跳一次)——多数票是 50%,两位计数器束手无策。历史预测记录最近 N 次分支的 taken/not-taken 序列(分支历史寄存器 BHR),用"历史模式"去索引不同的计数器:
- 局部历史:看这一个分支自己最近几次的模式(能学会
TNTN规律)。 - 全局历史:看最近所有分支的综合模式(能学会分支间的关联,如
if(a) ... if(a&&b),第二个 if 和第一个相关)。
3.4 现代:TAGE 等混合预测器
真实 CPU(Intel/AMD 近十年)用的是 TAGE(TAgged GEometric history length)之类的多表混合预测器:
- 同时维护多张表,各用不同长度的历史(几位到几百位)去索引;
- 对每个分支,用能匹配上的最长历史那张表的预测(长历史命中说明找到了强规律);
- 配合感知机(perceptron) 预测器等,综合多个特征。
结果:现代分支预测准确率 95%~99%+,规律性强的代码几乎 100%。你不用懂 TAGE 的细节,只需记住:预测器非常强,能学会相当复杂的模式——真正让它抓瞎的是"没有模式"(数据相关的随机分支)。
一句话:预测器的进化史 = "用越来越丰富的上下文(自己的多数票 → 自己的模式 → 全局关联 → 多长度历史混合)去猜方向"。它强到:只要分支有规律,基本都能学会;治不了的只有真随机。
四、猜错的代价:清空流水线,几十拍打水漂
预测对了几乎零成本。预测错(branch misprediction) 的代价是这样的:
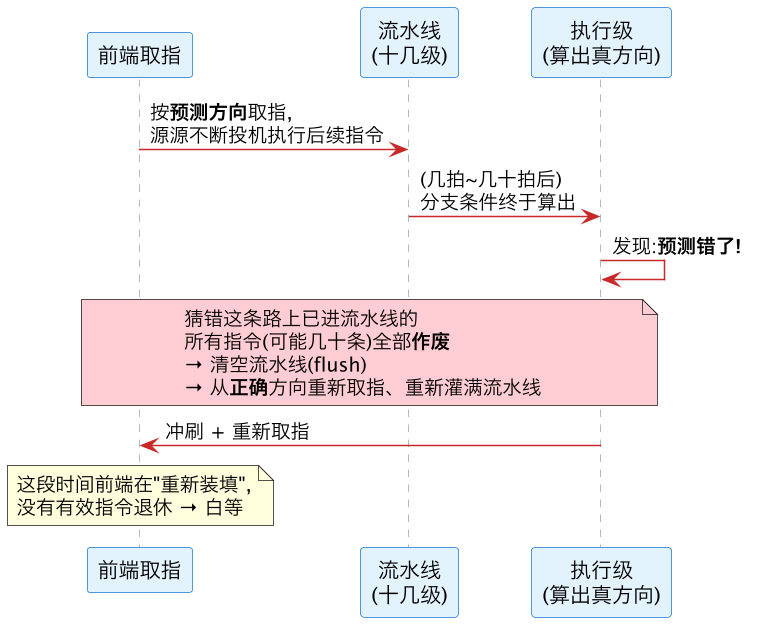
代价量化:
- 误预测惩罚 ≈ 流水线深度,现代 x86 约 15~20 拍(有的微架构更高)。
- 15~20 拍 ≈ 够执行几十条简单指令的时间,全打了水漂。
- 更糟的是它打断了乱序引擎的节奏:ROB 里投机的指令全清、执行端口空转。
放到实际:一个预测准确率 95% 的分支,5% 的误预测率,若这分支在热循环里每次都执行,那平均每 20 次就吃一次 ~18 拍的惩罚——足以让一段看起来 O(n) 的循环慢一倍。这就是"算法复杂度一样,性能差一截"的常见隐藏原因之一(另一个是 tlb 的 TLB miss、mesi 的伪共享)。
五、什么样的分支难猜:数据相关的"随机"分支
预测器怕的不是"分支多",而是"分支方向没有规律"——尤其是方向取决于数据、而数据是随机的。经典例子:
// 对一个数组求和,只加大于阈值的元素
for (int i = 0; i < N; i++)
    if (data[i] >= 128)   // ← 这个分支好不好猜,取决于 data 的分布
sum += data[i];- data 已排序:分支方向是"连续一大片 false,然后连续一大片 true"——极有规律,预测器几乎 100% 命中,飞快。
- data 随机:分支方向像抛硬币,预测器无从学起,误预测率逼近 50%——同样的代码、同样的数据量,能慢好几倍。
这就是 StackOverflow 上那个著名问题 "Why is processing a sorted array faster than an unsorted array?" 的答案:不是 cache、不是别的,就是分支预测。排序让分支变得可预测。
六、怎么写对预测器友好的代码
| 手段 | 原理 |
|---|---|
| 让分支可预测 | 数据能排序/分组就排(把 true 的聚一起),让方向连续成片 |
| 用无分支代码(branchless) | 把 if 改写成算术/位运算/cmov(条件移动指令),根本不产生分支,也就无从误预测。如 sum += (data[i]>=128) * data[i] 或 max = a>b?a:b 编译成 cmov |
__builtin_expect / [[likely]] | 告诉编译器哪条路是热路径,让它把热路径排在 fall-through、优化布局(帮助的是代码布局和 I-cache,现代动态预测器其实不太靠这个静态提示) |
| 减少间接跳转 | 虚函数、函数指针、大 switch 是 BTB 的负担;热路径上能去虚化(devirtualize)就去 |
| 循环展开 | 减少循环边界分支的占比 |
但别过度:
- 分支预测准确率本就 95%+,大多数分支不值得优化——只有 profiler(perf)指出误预测热点时才动手。
- branchless 不总是更快:如果分支其实很好预测(可预测的 if),改成 cmov 反而可能更慢(cmov 有数据依赖、且两条路都算)。要测,别凭感觉。
七、投机执行的阴暗面:Spectre
分支预测/投机执行本是纯性能优化、架构层面透明(猜错会回滚,不改变程序结果——见 ooo-renaming-retirement 的"顺序退休")。但 2018 年的 Spectre 揭示:投机执行虽然会回滚架构状态(寄存器、内存),却回滚不了微架构副作用——尤其是留在缓存里的痕迹。
- 攻击者训练预测器猜某个方向 → CPU 投机执行了本不该执行的指令(如越界读) → 虽然结果被回滚,但被越界读的数据已经把某条 cache line 加载进了缓存;
- 攻击者再用缓存计时侧信道(测哪条 line 变快了)反推出那个"本不该被读到"的秘密值。
要点:投机执行"回滚得了架构状态,回滚不了缓存痕迹"——这道缝隙就是 Spectre。缓解手段(retpoline、屏障指令、微码更新)大多以牺牲部分投机/预测性能为代价,这也是这些漏洞影响深远的原因。细节超出本仓库范围,这里只点出"投机执行 × 缓存侧信道"这个交叉点。
八、怎么观测:perf 看误预测及其连锁反应
8.1 直接指标:branch-misses
分支和误预测有专门的计数器(见 perf):
# 分支总数 vs 误预测数,直接算误预测率
perf stat -e branches,branch-misses ./app
#   branch-misses / branches 就是误预测率;热点代码里 >5% 就值得看
# 定位是哪段代码的分支在误预测
perf record -e branch-misses:ppu ./app && perf report
# 结合 IPC 看:误预测高通常伴随 IPC 偏低(流水线频繁清空)
perf stat -e cycles,instructions,branch-misses ./app判据:branch-misses 占 branches 的比例高(如 >5%~10%)、且集中在某个热点函数,就是分支预测瓶颈——考虑排序数据、branchless 改写、或去虚化。
8.2 连锁反应指标:误预测引发的次生灾害
但只看 branch-misses 不够——一次分支误预测会触发链式次生性能损失,这些损失由其他 PMU 事件反映:
一次分支误预测 → 流水线 flush
                    ↓
              CPU 重定向到正确地址取指
                    ↓
          ┌─ 那个地址的指令在 I-cache 里吗?
          │   ↓ 不在 → L1-icache-load-misses ↑
          │               ↓
          │         从 L2/L3/DRAM 重取指令
          │
          └─ 那个地址的页表翻译在 iTLB 里吗?
              ↓ 不在 → iTLB-load-misses ↑
                         ↓
page walk(4 次内存访问)也就是说,branch-misses 高的时候,以下三个指标应该同时抬头:
# 一次命令看全局:分支误预测 + 它的连锁反应
perf stat -e cycles,instructions,\
branch-instructions,branch-misses,\
L1-icache-load-misses,\
iTLB-load-misses,\
stalled-cycles-frontend,stalled-cycles-backend \
./app| 指标 | 含义 | 与分支误预测的关系 | 正常值 |
|---|---|---|---|
branch-misses / branch-instructions | 分支预测失败率 | 直接指标 | <5% |
L1-icache-load-misses | 指令缓存未命中 | 误预测后跳到新地址,该地址大概率不在 I-cache → 触发 I-cache miss | 越低越好 |
iTLB-load-misses | 指令 TLB 未命中 | 跳到一个新页,iTLB 没有对应条目 → page walk | 越低越好 |
stalled-cycles-frontend | 前端停顿周期 | 综合指标:I-cache miss + iTLB miss + 分支误预测 的总和 | <30% |
stalled-cycles-backend | 后端停顿周期 | 数据侧瓶颈,与分支预测间接相关(误预测导致执行了本不该执行的 load,可能污染 cache) | <30% |
IPC (instructions / cycles) | 每周期指令数 | 上述所有停顿的最终后果——前端喂不饱、后端等数据,都拉低 IPC | >1 |
8.3 诊断流程:从现象到根因
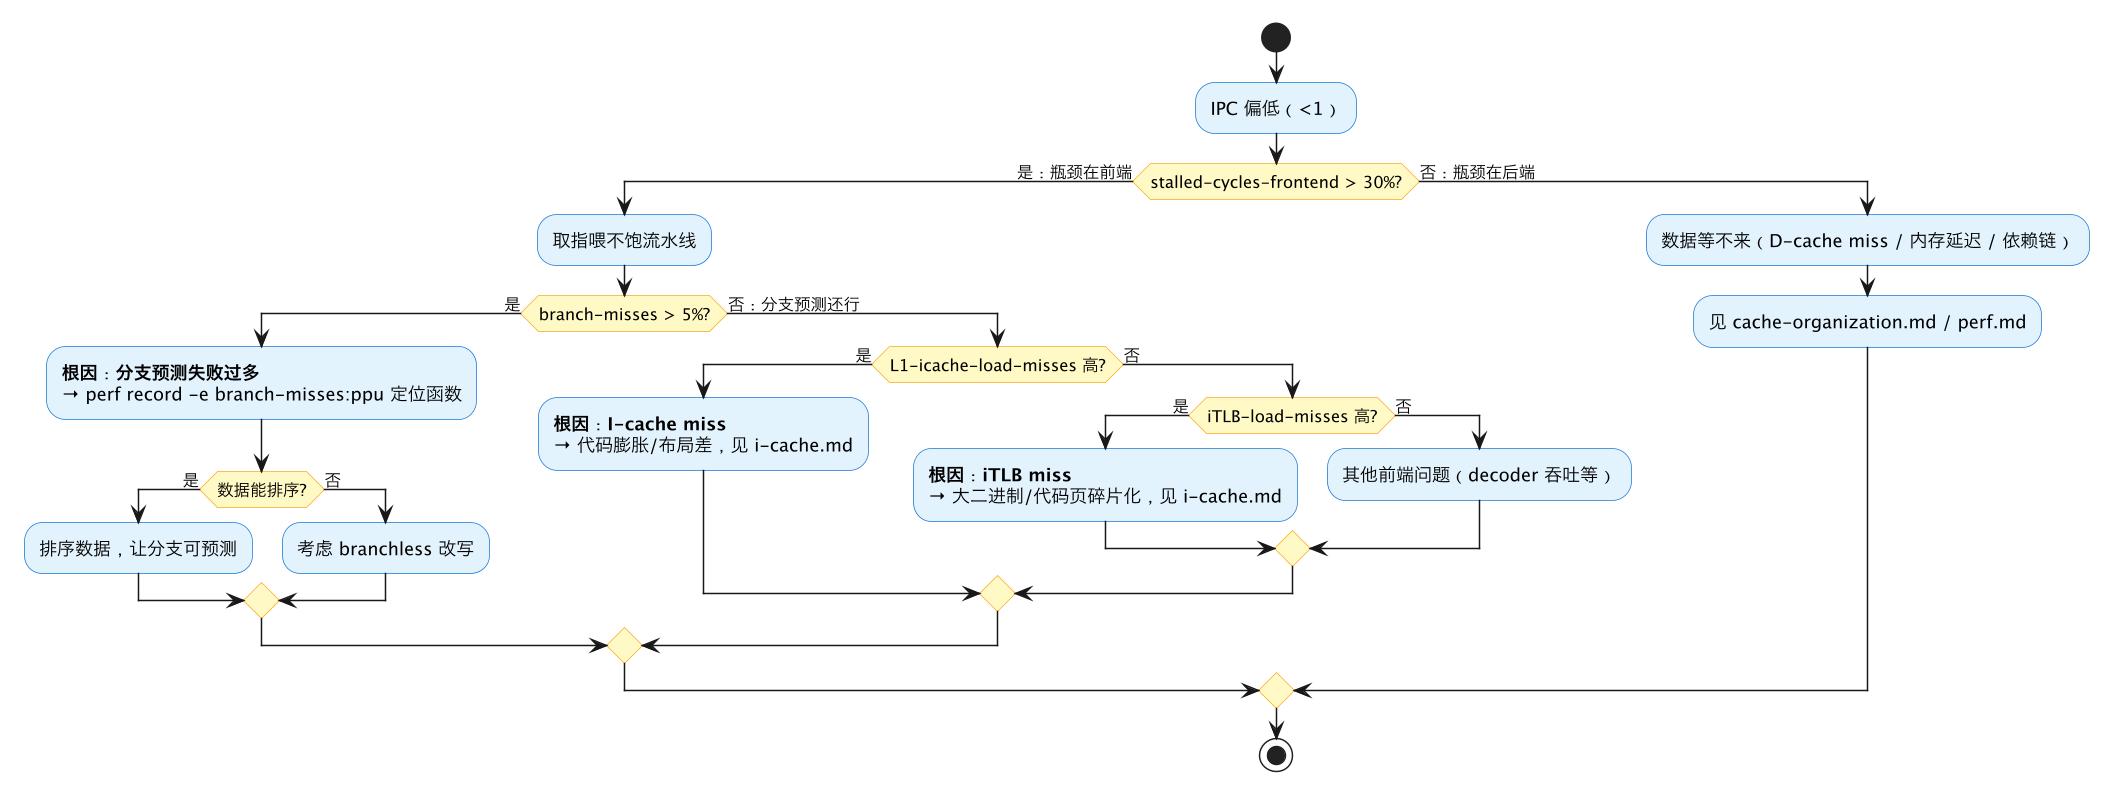
8.4 定位热点函数的三层 drill-down
从宏观到微观,层层收敛:
# 第一层:stat 看全局有没有问题
perf stat -e cycles,instructions,branch-misses,stalled-cycles-frontend ./app
# → IPC < 1 + frontend stall > 30% + branch-misses > 5% → 进入第二层

# 第二层:record + report 看哪个函数在 miss
perf record -e branch-misses:ppu -g ./app
perf report --stdio
# → 找到 branch-misses 占比最高的函数(通常 90%+ 集中在一个函数)

# 第三层:annotate 看哪条 jcc 在 miss
perf annotate
# → 定位到具体的 cmp + jle / cmp + jne 指令,看 Percent 列
8.5 间接分支:虚函数和函数指针
# 间接分支的预测(虚函数调用、函数指针、switch 跳转表)
perf stat -e branch-loads,branch-load-misses ./app
branch-loads / branch-load-misses 专门统计间接分支(jmp *%rax / call *%rax)。C++ 虚函数调用、函数指针、大 switch 跳转表都算间接分支。间接分支预测失败率比条件分支(jcc)更难优化——jcc 只需要猜方向,间接分支还要猜目标地址。
深入阅读:indirect-branch-prediction——间接分支预测完整专题:ITTAGE 预测器原理、单态/双态/巨态虚函数对比、switch 跳转表、去虚化手段、Spectre v2 (BTI) 与 retpoline。
实验代码:indirect-branch demo——对比直接调用 vs 单态/双态/巨态虚函数、函数指针、switch 跳转表六种场景。
make perf-branch-loads直接看branch-loads/branch-load-misses。
8.6 完整指标速查
| 我想知道... | 用这个 |
|---|---|
| 分支预测失败率 | perf stat -e branches,branch-misses ./app |
| 哪个函数在 miss | perf record -e branch-misses:ppu -g ./app && perf report |
| 哪条 jcc 在 miss | perf annotate(在 report 中进入热点函数后) |
| 间接分支预测 | perf stat -e branch-loads,branch-load-misses ./app |
| 是取指瓶颈还是数据瓶颈 | perf stat -e stalled-cycles-frontend,stalled-cycles-backend ./app |
| I-cache 是否被牵连 | perf stat -e L1-icache-load-misses ./app |
| iTLB 是否被牵连 | perf stat -e iTLB-load-misses ./app |
| 全局综合诊断 | perf stat -e cycles,instructions,branch-misses,L1-icache-load-misses,iTLB-load-misses,stalled-cycles-frontend ./app |
核心思路:
branch-misses是直接指标,但它会触发 I-cache miss 和 iTLB miss 的链式反应——这三个指标叠加才等于stalled-cycles-frontend。所以诊断时不要孤立看 branch-misses,要看 branch-misses + I-cache + iTLB → frontend stall 这条完整的因果链。
九、和本仓库其他文档的关系
- 前置/同层:cpu-out-of-order——分支预测是投机执行的方向盘,误预测触发的正是那里讲的"ROB 清空重放"。间接分支的深入讨论见 indirect-branch-prediction。两篇都属核内微架构(单核性能引擎),与多核内存序正交(见 reordering-overview)。
- 同类性能陷阱:tlb(TLB miss)、mesi(伪共享)、cache-organization(cache miss)——都是"算法复杂度看不出、profiler 才现形"的隐藏成本;分支误预测是其中之一。
- 观测:perf(branch-misses、branch-load-misses 等事件)。
十、一句话总结
深流水线要求前端永不停顿地喂指令,但条件分支的方向要很晚才算出来——于是 CPU"赌"一个方向、立刻投机执行,靠分支预测器(BTB 猜目标、两位计数器/历史/TAGE 猜方向)把准确率做到 95%~99%。赌对几乎零成本,赌错要清空流水线、几十条投机指令作废、付 ~15~20 拍惩罚。预测器怕的不是分支多,而是"方向随机没规律"(数据相关的分支,排序数组比乱序快就是这个原因)。优化靠让分支可预测或 branchless 改写,但先用 perf 的 branch-misses 定位、别凭感觉。它纯属性能优化、架构透明——唯一的例外是投机回滚不了缓存痕迹,那道缝隙催生了 Spectre。