Uncore PMU 事件编程:核外计数器的盒式拓扑与 perf 打开方式
承 perf-counter-pmu-programming 对核内 PMU 编程的介绍,以及 uncore-ring-mesh-interconnect 对核外互连结构的拆解。核内 PMU 告诉你「每个核在干什么」,但内存带宽、LLC 命中率、UPI 流量这些全 socket 共享资源的账本,藏在另一套计数器里——这就是 uncore PMU 事件编程要解决的问题。
本文要回答的问题
- uncore PMU 和核内 PMU 有什么本质区别?为什么不能照搬核内的编程套路?
- uncore 计数器的「盒(box)」拓扑是怎么回事?为什么同一个事件有几十个实例?
- MSR 与 PCI/MMIO 两种编程接口分别对应哪些盒子?
- 用 perf 读 uncore 事件的正确姿势是什么?常见的坑在哪?
- 怎么组合 uncore 事件算出内存带宽、LLC miss 率、跨 socket 流量?
一、从「每核一套」到「每盒一套」
核内 PMU 的世界很整齐:每个逻辑核有 4-8 个可编程计数器加 3 个固定计数器,事件编码写在 IA32_PERFEVTSELx MSR 里,RDPMC 读数,语义以「指令/周期/分支」这类流水线事件为主。
Uncore PMU 的世界是分布式的。LLC 不是一个整体——它被切成 20-40 个 slice,每个 mesh 节点一个;内存控制器(IMC)有 2-8 个,每个带若干通道;UPI 链路每 socket 2-4 条;还有 CHA(Caching and Home Agent,管一致性目录与 LLC 请求)、PCU(功耗控制单元)等等。每个这样的部件自带一小组计数器(通常 2-4 个通用 + 少量固定),各自独立编程。于是「统计 LLC 读 miss」不再是一个事件,而是把 30 个 CHA 盒子的同一事件聚合成一个数。
| 维度 | 核内 PMU | uncore PMU |
|---|---|---|
| 组织粒度 | 每逻辑核一套 | 每盒(slice/IMC/UPI…)一套 |
| 计数器数量 | 4-8 通用 + 3 固定 | 每盒 2-4 个,盒数几十 |
| 编程接口 | MSR(IA32_PERFEVTSELx) | MSR 或 PCI 配置空间 / MMIO |
| 事件对象 | 流水线微事件 | LLC、内存、互连、一致性流量 |
| 归属语义 | 线程级(跟随上下文切换) | 全局共享,不跟随线程 |
| 典型消费者 | perf record/stat | perf stat、自研监控、RDT |
「不跟随线程」这一点很关键:uncore 计数器统计的是全 socket 所有核的总和,你不能拿它回答「我这个进程用了多少内存带宽」——只能回答「这台机器的内存带宽现在有多挤」。
二、盒式拓扑与两种编程接口
Intel 服务器核外 PMU 的编程接口分两派,判据是「这个盒子在不在 MSR 空间里有自己的地址」:
- MSR 可达的盒子:CHA/LLC slice、UPI 等,直接
WRMSR/RDMSR配置事件选择与读计数。注意写 MSR 本身是串行化指令且虚拟化下可能 VM-exit,批量采集的固定成本不低。 - PCI 配置空间 / MMIO 的盒子:IMC(内存控制器)最典型——它的计数器寄存器躺在 PCI 设备的配置空间里,得通过
/dev/mem或驱动的 MMIO 映射访问。这也是为什么裸写 IMC 计数器几乎都要走内核驱动。
Linux 把这套复杂度收进了 perf 的 uncore PMU 驱动里:内核启动时枚举拓扑,给每类盒子注册一个独立 PMU 设备(/sys/bus/event_source/devices/uncore_imc_0/、uncore_cha_5/…),事件用 type=uncore_imc_0,event=...,umask=... 的形式打开。
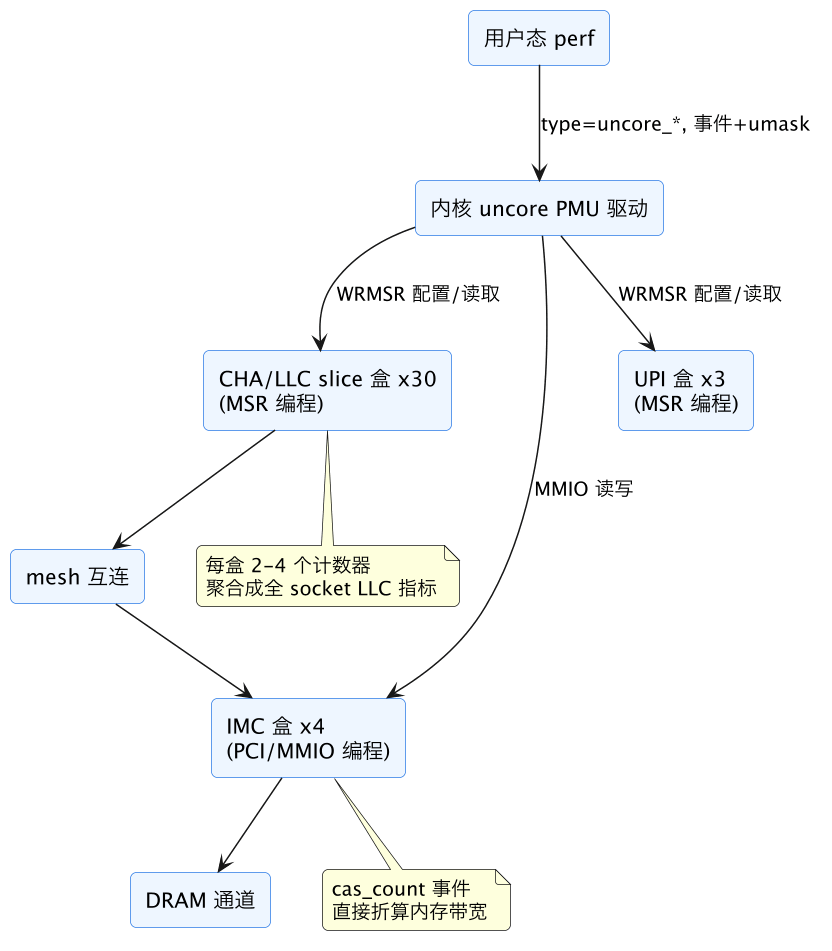
这张图的重点:perf 暴露给你的不是「一个 uncore PMU」,而是按盒型×实例编号的几十个 PMU 设备;同一条 mesh 上的盒子功能互补——CHA 看 LLC 与一致性,IMC 看 DRAM 流量,UPI 看跨 socket。
三、perf 实操:带宽、miss 率、跨 socket 流量
最常用的三个组合。
内存带宽。IMC 盒子的固定/可编程事件 cas_count 按读/写分开计数,每次 CAS 对应 64 字节:
perf stat -a -e 'uncore_imc/cas_count_read/,uncore_imc/cas_count_write/' -- sleep 10
# 带宽 = (read + write) × 64B / 10s
uncore_imc 不带实例号时 perf 自动聚合所有 IMC 盒——这是 uncore 事件编程里最省心的语法。
LLC miss 率。用 CHA 盒的 UNC_CHA_REQUESTS(按读/写/预取分 umask)与 UNC_CHA_REQUESTS 中 miss 子集相除;或者直接数 LLC_LOOKUP 配不同状态过滤。注意 Skylake 之后 LLC 是 non-inclusive,「LLC miss ≈ 去内存」只在流式负载下近似成立,预取与投机访问会掺水。
跨 socket 流量。UPI 盒的 TxL_FLITS 按数据/协议分类计数,NUMA 远端访问一多它先涨——配合 numa-local-remote-latency 的延迟数据,能区分「带宽被打满」与「单纯远端访问占比高」。
三个常见坑:
需要 root 且计数器是稀缺资源。每个 IMC 盒只有 4 个计数器,你占着别人(或别的容器里监控 agent)就采不了,生产上错峰采集。
虚拟化下大多不可用。uncore PMU 几乎不对 guest 暴露,云主机里
perf list uncore通常是空的——这不是 perf 坏了。事件名每代必查手册。
UNC_CHA_*的 umask 语义 Skylake/Cascade/Ice/Sapphire 代代微调,照抄上一代脚本会得到「能跑但数不对」的结果,以对应代的 uncore PMU 手册(Intel uncore performance monitoring reference manual)为准。聚合口径要想清楚再比。
uncore_imc(不带实例号)聚合的是同一 socket 内所有 IMC 盒;双路机器跨 socket 对比时要用uncore_imc_0这类带实例的事件逐盒看,再按 socket 手工求和——盒号与 socket 的对应关系查/sys/bus/event_source/devices/uncore_imc_*/cpumask,别凭直觉。
另外提醒一句单位换算:cas_count 一个计数对应一次 64 字节的列访问,但部分代次的 IMC 还有 prefetch 通道的独立计数,算「业务可见带宽」时别把 DRAM 侧预取流量混进去,否则会高估业务实际吃掉的带宽。
四、一个端到端案例:定位「带宽没满但延迟暴涨」
假设线上一台双路机器报「内存延迟比平时高 40%」,但业务 QPS 没变。按 uncore 的思路排查顺序是这样的。
第一步,看 IMC。uncore_imc/cas_count_read/ + cas_count_write 折算带宽,结果只有理论峰值的 55%——带宽没打满,排除「撞带宽墙」。顺手看一眼 uncore_imc 各实例的分布:如果 uncore_imc_2 的流量是其他三个的两倍,那是地址交织不均或 DIMM 拓扑问题,方向就变了。
第二步,看 CHA。UNC_CHA_TOR_OCCUPANCY(Table of Requests 占用率)事件反映 CHA 里排队未决事务的深度——它持续高位而带宽不满,说明请求在 mesh/一致性层堵着,还没走到内存。再配 UNC_CHA_REQUESTS 里 remote 子事件的占比:远端请求占比从 15% 涨到 55%,结论呼之欲出——流量被 NUMA 错配引到了对端 socket。
第三步,看 UPI 验证。uncore_upi/TxL_FLITS/ 数据 flit 翻倍,坐实跨 socket 流量异常。最后查进程调度与内存绑定,果然是某个新上线的服务没绑核,线程在两路之间漂移,内存全部分配到了远端。
这个案例的价值不在结论本身,而在方法论:核内 PMU 只能告诉你「我这个核的 load 变慢了」,uncore 的 IMC→CHA→UPI 三层视角能把「慢」定位到「堵在哪一段」。延迟类问题按「带宽—排队—远端占比」三步走,基本能把玄学问题变成有数据支撑的假设。
五、什么时候必须上 uncore
核内 PMU 的 OFFCORE_REQUESTS、L2_LINES_OUT 能部分间接推断内存行为,但当你要回答的是「整机的」问题时——内存带宽是否打满、某个 slice 是否热点(地址 hash 不均,见 cache-slice-hash-addressing)、mesh 是否拥塞、UPI 是不是瓶颈——只有 uncore 计数器有第一手数据。做容量规划、定位「单机整体变慢但每个进程看起来都正常」这类玄学问题,uncore PMU 事件编程基本是第一站。
最后给一个落地建议:线上常驻采集不要贪多。每个 IMC 盒 4 个计数器、每个 CHA 盒 2-4 个,挑 3-5 个核心指标(读带宽、写带宽、CHA 远端占比、TOR 占用)做 1-10 秒粒度的常规采集足够;深挖问题时再临时上全套事件跑几分钟。计数器复用冲突、WRMSR 的串行化成本、采集中断对业务的扰动,都是「开得越多越失真」的来源——uncore 观测同样遵守「测量本身有代价」的物理。
这一篇在知识体系里的位置
本篇是 perf-counter-pmu-programming 的核外篇,拓扑背景见 uncore-ring-mesh-interconnect 与 dram-subsystem-organization;核外频率对计数的影响见 uncore-frequency-scaling;端到端的延迟带宽视角见 memory-hierarchy-latency-bandwidth-panorama。
总结
uncore PMU 事件编程的核心是「按盒编程、跨盒聚合」:LLC/IMC/UPI 各有独立计数器组,经 MSR 或 MMIO 配置,perf 以 uncore_<box> 设备统一暴露;它回答的是全 socket 共享资源问题,不归属任何线程——看懂带宽、LLC 与跨 socket 流量,核内计数器给不了的答案都在这里。