ROB 容量与乱序窗口:512 项 ROB 到底意味着什么
承 rob——那篇讲了 ROB(Re-Order Buffer,重排序缓冲区)是什么:指令乱序执行、按序退休的记账本,每条 µop 一进后端就领一个 ROB 槽位,退休时才归还。但有一个数字一直被一笔带过:这个记账本有多大? Intel Golden Cove 给到 512 项,AMD Zen 4 是 320 项,Zen 5 涨到 448 项——这些数字不是规格表上的装饰,ROB 容量直接给乱序窗口封了顶,也决定了核心能"望"多远去挖指令级并行。flush 机制见 precise-exception-pipeline-flush,发射侧见 issue-queue-wakeup-select,本篇只算容量这笔账。
本文要回答的问题
- "512 项 ROB"到底意味着什么?乱序窗口和 ROB 容量是一回事吗?
- ROB 填满时流水线发生什么?为什么这叫结构性停顿而不是数据停顿?
- ROB 扩大一倍,性能就涨一倍吗?收益递减点在哪?
- Intel 与 AMD 近十年 ROB 容量怎么演进的,背后各自在赌什么?
一、ROB 容量的真实含义:乱序窗口的天花板
先把一个常见误读拆开。看到"512 项 ROB",直觉反应是"核心能同时执行 512 条指令"——不对。同时执行的指令数由发射宽度和执行端口决定(Golden Cove 是 12 端口、每拍最多发 12 条 µop),512 项 ROB 的意思是:从"最老的还没退休的指令"到"最新刚进后端的指令",这条指令流窗口里最多容纳 512 条在飞 µop。
这个窗口就是乱序窗口。它的价值在于:窗口越大,硬件越有机会绕过一条卡住的指令(比如一条 L3 miss 的 load,要等上百拍),从它后面几百条指令里挑出操作数已就绪的先执行。窗口只有 64 条时,一条 cache miss 后面没挑几条就没存货了,后端只能干等;窗口 512 条时,同样一条 miss 期间后端可能已经把后续两三个循环迭代的独立计算都做完了。
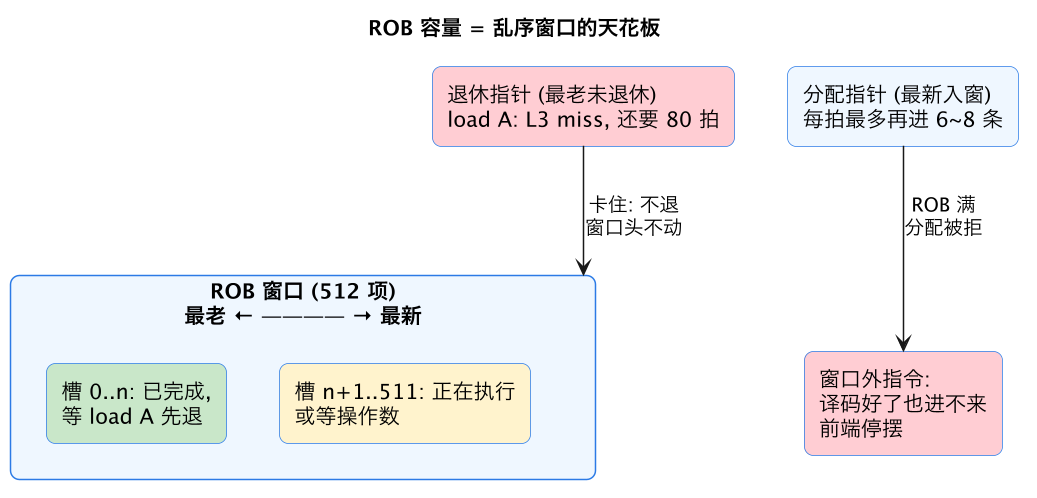
图里最关键的一点:乱序窗口是"以退休指针为头、分配指针为尾"的一个滑动区间,头不动尾就撞墙。那条 L3 miss 的 load 一天不退休,窗口头一天不动;新指令灌满 512 个槽之后,再宽的译码、再多的空闲执行口都使不上劲。所以 ROB 容量本质上买的不是"并行度",而是对长延迟事件的容忍度——窗口越深,能吸收的记忆体层级延迟越长。
二、ROB 填满:结构性停顿长什么样
ROB 满导致的停顿有个专门名字:结构停顿(structural stall),微架构事件里对应 Intel 的 resource_stalls.rob 或 Topdown 里的 backend bound 子项。它和数据停顿(等操作数)的区别值得强调:数据停顿时发射队列挑不出能发的指令,但新 µop 还能进 ROB,窗口还在往前铺;ROB 结构停顿时是分配级整体拒收,前端译出的 µop 无处可放,整条流水线从尾部开始向上游倒灌式冻结。
什么代码容易把 ROB 顶满?两类典型:
- 长延迟指令压在窗口头:链式 cache miss、除法(20~90 拍)、
sqrt、锁定操作。它们占据窗口头不退,后面的指令完成得再快也只能排队等退休。 - 高密度慢事件流:一段代码里 miss 率本身很高,即使每条延迟不算极端,完成速度跟不上进入速度,窗口照样被慢慢灌满——这是"温水煮青蛙"式的 ROB 压力。
一个量化直觉:核心每拍最多分配 6~8 条 µop,512 项的 ROB 从空到满只要 64~85 拍。而一次 L3 miss 就要 40~80 拍、一次主存访问 200~300 拍。只要窗口头压一条主存 miss,ROB 必满——512 项看着多,在 DRAM 延迟面前也就一拍多的缓冲。这也解释了为什么预取器(见 hardware-prefetcher-stride-stream)和 cache 层级对宽核如此重要:前端喂得再快,也代替不了"别让 miss 出现在窗口头"。
三、收益递减:ROB 不是越大越好
既然容量买容忍度,为什么不一劳永逸给到 4096 项?因为 ROB 扩张的收益曲线是明显递减的,而成本是递增的。
收益侧,大量模拟研究(也是各家设计空间的共识)显示:在其他结构等比放大的前提下,ROB 从 64 涨到 128,常见整数负载 IPC 能涨 10%~20%;128 到 224,还剩 5%~10%;224 到 352,普遍只剩 3%~5%;再往上,多数负载的增益跌到 1%~2% 量级。原因有二:一是窗口内的独立指令很快就被挖完了——指令级并行度(ILP)本身有限,窗口再大也挑不出更多能并行的事;二是误预测和异常会连坐——窗口越深,一次误预测 flush 掉的在飞指令越多,bad_speculation 的税越重,窗口的部分收益被自己的投机浪费吃掉(flush 机制见 precise-exception-pipeline-flush)。
成本侧更现实:
| 成本项 | 随 ROB 容量的行为 | 后果 |
|---|---|---|
| 存储面积 | 每项记录 PC、目的寄存器、状态位等几十 bit,512 项即数十 Kbit | 直接吃 die 面积 |
| 分配/退休端口 | 每拍 6~8 条同时分配、同量级退休,多端口 CAM 布线 | 时序变差,限制频率 |
| 唤醒广播 | ROB 号越宽,比较器位数越大 | 发射级关键路径变长 |
| 配套结构 | 物理寄存器堆、load/store 队列、调度器都得跟着放大 | 不成比例的总成本 |
| 功耗 | 每项每拍都被读写的活跃结构 | 宽核的功耗大头之一 |
所以各家实际走的是"ROB 涨一点、配套结构跟一点、频率别掉"的平衡木。ROB 容量从来不是孤立参数,它是一份"我赌负载的记忆体延迟会越来越多"的设计宣言。
四、代际演进:Intel 与 AMD 的容量账
把近十年桌面/服务器旗舰核心的 ROB 容量摆在一起,趋势一目了然:
| 微架构 | 年份 | ROB 容量(µop) | 备注 |
|---|---|---|---|
| Intel Skylake | 2015 | 224 | 经典 4 宽时代的上限 |
| Intel Sunny Cove | 2019 | 352 | 配 5 宽分配、L1D 扩到 48KB |
| Intel Golden Cove | 2021 | 512 | 6 宽分配,号称"最宽 x86" |
| AMD Zen 2 | 2019 | 224 | 与 Skylake 同档 |
| AMD Zen 3 | 2020 | 256 | 延迟优化优先于堆容量 |
| AMD Zen 4 | 2022 | 320 | 配 5.7GHz 高频策略 |
| AMD Zen 5 | 2024 | 448 | 8 宽分派,窗口大幅加深 |
两条路线各有侧重。Intel 从 Sunny Cove 起走"宽而深":分配宽度、执行端口、ROB 一起堆,赌的是服务器和混合负载里记忆体延迟主导,深窗口能直接换成 IPC。AMD 在 Zen 2/3 时代明显更克制——宁可把晶体管花在 opcode cache 和分支预测上,靠"少进错窗口、窗口里少 miss"来提高有效窗口利用率;到 Zen 5 才大步跳到 448 项,因为高频红利吃完、内存墙压力上来,深窗口成了绕不开的选项。
殊途同归的结论:ROB 容量的代际膨胀,本质是摩尔定律喂给前端的晶体管,被记忆体墙逼着换成了"等得起"的能力。同样值得注意的反例是 Apple 系核心(Firestorm 等)走 600+ 项的极端深窗口路线——那是另一个"用面积换单线程性能"的豪赌,逻辑相同,注码不同。
五、怎么观测 ROB 压力
ROB 容量是硬件定死的,但"程序有没有把它顶满"完全可以测:
# Intel: ROB 结构停顿占比
perf stat -e cycles,resource_stalls.rob ./app
# resource_stalls.rob / cycles 即分配级因 ROB 满停摆的比例

# Topdown 视角: backend bound 里的 core bound 部分常由 ROB 压力贡献
perf stat -M TopdownL1 ./app经验判据:resource_stalls.rob 占周期 5% 以下,ROB 不是瓶颈,去查发射或前端;10% 以上且伴随高 cache miss 率,说明窗口头常被 miss 压住——这时优化方向是数据布局、预取、降低 miss 链(比如指针追逐改数组遍历),而不是幻想更大的 ROB。瓶颈定位的系统方法见 ipc-bottlenecks。
这一篇在知识体系里的位置
本篇是乱序执行主线上"ROB"这一环的容量纵深补篇,与既有文章互补不重复:
- rob:ROB 的机制主场——按序退休、异常精确化;本篇只展开"容量"这一个维度。
- cpu-out-of-order:乱序执行全景,ROB 容量是其中"窗口多深"的答案。
- precise-exception-pipeline-flush:flush 机制;窗口越深,每次 flush 冲走的在飞工作越多。
- issue-queue-wakeup-select:窗口内"怎么挑指令发"的发射侧视角。
- hardware-prefetcher-stride-stream:ROB 压力的缓解侧——预取把 miss 挡在窗口之外。
- 落地观测:ipc-bottlenecks 用 Topdown 把 ROB 停顿归进瓶颈分类账。
总结
ROB 容量就是乱序窗口的天花板:512 项意味着核心最多让 512 条在飞 µop 排成一条"从最老未退休到最新入窗"的滑动窗口,窗口头一旦被 cache miss 或长延迟指令压住,后端再宽也只能停摆;容量扩张买对记忆体延迟的容忍度,但 ILP 有限加 flush 连坐让收益在数百项后急剧递减——Intel/AMD 从 224 项一路涨到 512/448 项的十年,本质是把前端晶体管换成"等得起内存"的能力,而观测侧的答案始终是把 miss 挡在窗口头之外。