cache way 预测:L1 way predictor 猜中只读一路的省电机理、猜错代价与命中率统计
更新时间:2026-10-04。现代 CPU 的 L1 数据缓存几乎都是 8 路组相联,一个 32KB、64 字节行的 L1D 有 64 个组、每组 8 路。教科书里的标准动作是:地址进来,同一组的 8 路 tag 同时读出来比较,命中哪路读哪路的数据。这个「同时」在电路层面意味着 8 套 tag 阵列和数据阵列每次访问全部上电翻转,而其中 7 路的读出结果注定被扔掉。cache way 预测(way prediction)要解决的就是这个浪费:访问前先猜「数据多半在第几路」,猜中只点亮一路,功耗降到约八分之一;猜错再回头全查,多花一两个周期。它是功耗墙时代缓存微架构的标配技巧,和 分支预测 共享同一套「用历史换确定性」的哲学。上游背景见 CPU 微架构总览 与 cache VIPT 与同义别名,功耗管理大背景见 时钟门控与功耗门控。
本文要回答的问题
- 组相联缓存「并行读全部 way」到底浪费了多少功耗?8 路里 7 路的读出为什么是白干的?
- cache way 预测器怎么猜?用什么历史信息、存在哪里?
- 猜中只读单路,省下的具体是哪几份功耗?
- 猜错的代价有多大?命中率掉到多少以下反而得不偿失?
- 怎么统计和观测 way 预测的命中率?对性能分析有什么实战意义?
一、并行读全 way 的浪费:八次上电七次白干
先把组相联查找的电路动作拆清楚。一次 L1 读访问进来,地址被切成三段:tag、组索引(set index)、行内偏移。组索引选中某一组之后,这一组的所有 way 是「并联」在读取电路上的——8 路 tag 阵列的 8 个条目同时被读出,8 个比较器同时和地址 tag 比较,命中的那一路用命中信号去选通 8 路数据阵列里对应的那一份,经多路选择器(mux)送到加载端口。
为什么这么设计?为了延迟。tag 比较和数据读出是并行推进的,数据阵列不等待 tag 比较结果就提前读出,比较完成时数据已经等在 mux 输入端,命中即输出。这是 L1 能做到 4 到 5 个周期命中延迟的关键手段之一。顺序执行(先比 tag 再读数据)会把延迟拉长一到两个周期,在 L1 这个每个周期都可能被访问的位置上,这是不能接受的。
但并行是有账单的。每次访问:
- 8 个 tag 条目读出:8 份 tag 阵列的动态功耗;
- 8 个比较器翻转:8 份比较功耗;
- 8 路数据阵列的读出放大器(sense amplifier)全部使能:这是大头,数据阵列一行 64 字节,8 路就是 512 字节的读出电路同时工作;
- 最终只有 1 路的 64 字节被 mux 选中,其余 7 份读出结果直接丢弃。
也就是说,每次 L1 命中大约七分之八的动态功耗花在了「注定被扔掉的数据」上。L1D 是全芯片访问频率最高的 SRAM 之一,每核每周期可支撑两到三次读加一次写,这份浪费乘以访问频率,在移动芯片的功耗预算里能占到核心动态功耗的数个百分比——足够让架构师认真对待。
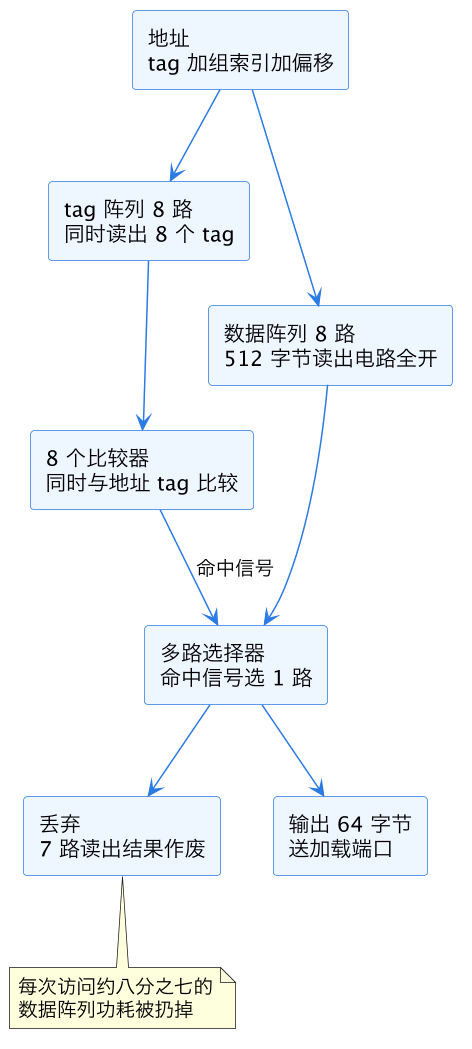
上图就是「并行读全 way」的完整功耗去向。注意数据阵列和 tag 阵列是同时被地址驱动的,这个并行是低延迟的来源,也是浪费的来源。cache way 预测的改造点只有一个:在数据阵列被点亮之前,先给一个「很可能就是这一路」的猜测,让 mux 的输入端只挂一份读出。
二、way predictor 怎么猜:小型历史表加一行元数据
way 预测器的本质是一个微型分支预测器。它不需要百分之百正确——猜错的代价只是重查一次,所以可以用非常小、非常快的结构来换命中率。常见实现有三类。
第一类是基于地址的历史表。用 load 指令的 PC 或者访存地址的若干位索引一张小表,表项存「上次这个访问命中在第几路」(3 位就够表示 8 路)。下次同一个 load 再来,直接按表项猜。这和双模态分支预测器(bimodal predictor)的结构几乎一模一样,只是预测目标从「跳不跳」换成「第几路」,预测器的背景见 双模态与 gshare 分支预测器。
第二类是 MRU 线索。每组维护一个「最近使用」(MRU,Most Recently Used)的 way 编号,访问该组时先猜 MRU 路。程序的时间局部性保证「最近用过的很可能马上再用」,这条线索成本极低——每组只要 3 位寄存器——但对顺序扫描、循环访问热数据的模式命中率意外地高。
第三类是把预测位藏进指令或微码。某些架构(典型如 Alpha 21264 的 icache 路预测、部分 ARM 核的 L1)让预测信息跟随指令流水走:取指时顺便把「这条 load 上次命中第几路」带下来,到访存阶段直接用。好处是不占单独的历史表存储,坏处是上下文切换后预测信息全丢。
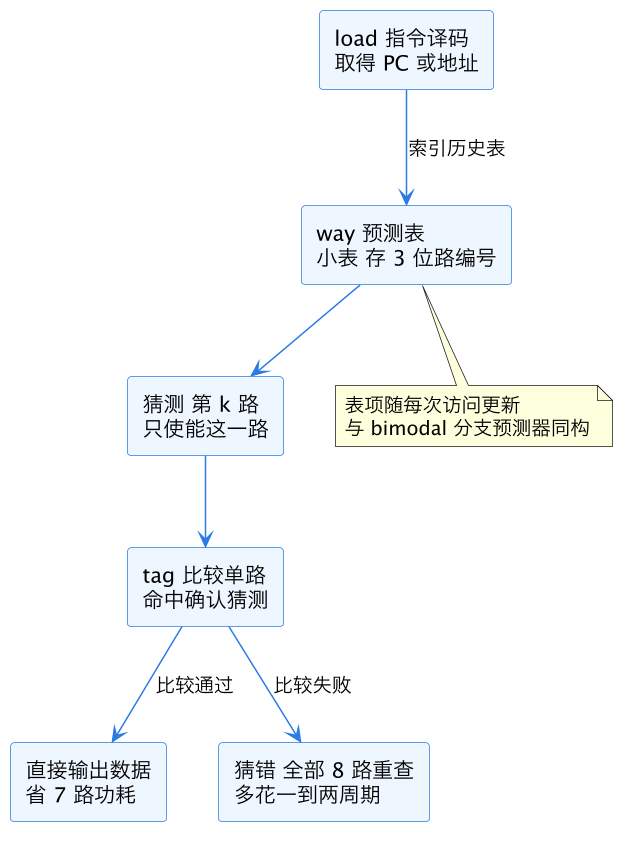
上图是预测命中路径与重查路径的分叉。整个机制的关键性质是:猜错不改变正确性,只改变延迟和本次的功耗——单路比较失败就退化回并行全查,结果永远正确。这和分支预测「猜错要冲刷流水线」完全不同,way 预测猜错不清空任何东西,惩罚温和得多,所以设计上敢用更小的表、更激进的猜测。
三、猜中省了什么:三份功耗各砍一刀
way 预测命中时,省下的功耗不是一个整体,而是三份独立的账单。
第一份是数据阵列的读出功耗。8 路只使能 1 路,读出放大器从 8 套减到 1 套,这是最大头,直接砍掉约八分之七。对 32KB 8 路的 L1D,数据阵列约占整个缓存动态功耗的六七成,这一刀最值钱。
第二份是 tag 阵列与比较器。注意这里有个实现分叉:激进方案连 tag 也只读预测的 1 路(命中确认和功耗都最优,但猜错时完全没有其他路的信息,必须完整重查);保守方案 tag 仍然 8 路全读(tag 阵列小、功耗低,全读可以在猜错的同一拍里直接给出正确路号,重查只补数据读出)。Intel 从 P6 时代起 L1 就带 way 预测类结构,近代核上多是「数据阵列预测、tag 全读」的混合形态。
第三份是连带着省下的翻转功耗。mux 输入端挂的负载小了、数据总线只有一路在翻转,时钟树喂给未使能阵列的部分也可以顺手门控,与 时钟门控与功耗门控 的机制联动。
| 功耗项 | 并行全读 8 路 | way 预测命中 | 节省幅度 |
|---|---|---|---|
| 数据阵列读出 | 8 份 | 1 份 | 约八分之七 |
| tag 阵列读出 | 8 份 | 1 到 8 份(看实现) | 零到八分之七 |
| 比较器 | 8 份 | 1 到 8 份 | 零到八分之七 |
| 总线与 mux 翻转 | 8 路负载 | 1 路负载 | 显著下降 |
把三份加起来,命中时单次 L1 访问的动态功耗大约降到并行全读方案的 30% 到 50%(具体比例取决于 tag 是否也参与预测)。乘以 L1 每周期多次的访问频率,在功耗受限的移动和笔记本 SKU 上,这直接关系到同样散热预算下能跑到多高的频率,与 DVFS 频率切换延迟 讨论的是同一笔功耗预算。
四、猜错的代价与盈亏平衡点
way 预测不是免费的。猜错时,单路 tag 比较失败,硬件退回到全 8 路查找,整个访问多花一到两个周期;本次访问的功耗反而比「不预测」略高——单路那次读出是白花的。
延迟惩罚值得和别的缓存停顿对照着看。L1 正常命中 4 到 5 周期,猜错加一到两周期变成 6 到 7 周期——仍然远好于 L2 命中的 12 到 14 周期。而且乱序引擎对几个周期的额外延迟有很强的掩盖能力:只要后面还有独立指令可发射,这点泡泡大概率被 ROB 吸收掉,乱序窗口的影响见 ROB 大小与乱序窗口。真正敏感的场景是「load 结果马上被依赖链下一环使用」的关键路径代码,比如指针追逐——指针追逐本身就是缓存杀手,模式见 数据冒险之 L1 未命中。
算一笔盈亏账。设不预测时每次访问功耗为 P、延迟为 L;预测命中功耗 0.4P、延迟 L;猜错功耗 1.1P(单路加全查)、延迟 L+2。命中率为 h 时:
- 平均功耗 = h 乘 0.4P 加 (1-h) 乘 1.1P = P 乘 (1.1 减 0.7h)。功耗打平点是 h 约等于 0.14——命中率只要超过 14% 就省电,这个门槛低得几乎没有风险。
- 平均延迟 = L 加 2(1-h)。命中率 90% 时平均多花 0.2 周期,对 IPC 的侵蚀通常在千分之几量级;命中率掉到 50% 时平均多花 1 周期,这时关键路径代码会开始有感。
| 预测命中率 | 平均功耗(相对不预测) | 平均额外延迟 | 评价 |
|---|---|---|---|
| 95% | 约 0.44 倍 | 约 0.1 周期 | 理想区间 |
| 85% | 约 0.51 倍 | 约 0.3 周期 | 良好 |
| 60% | 约 0.68 倍 | 约 0.8 周期 | 省电但延迟有感 |
| 30% | 约 0.89 倍 | 约 1.4 周期 | 鸡肋,接近关闭阈值 |
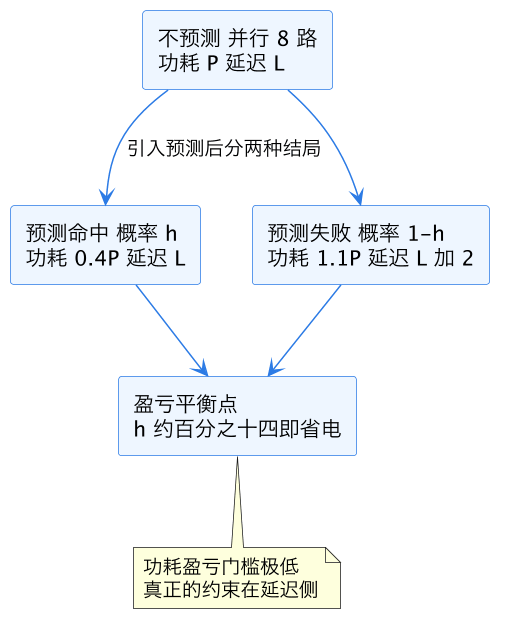
上图中两条分支汇合出的结论值得记住:way 预测的功耗盈亏平衡点低到 14% 命中率,所以「要不要开预测」从来不是功耗问题,而是延迟问题——只有当负载的命中率烂到 50% 以下、且代码对 L1 延迟敏感时,预测才开始帮倒忙。现实中的典型负载命中率在 80% 到 95%,这是工作集的冲突模式决定的:8 路组相联里,一个热组内真正反复争夺的 way 通常只有两三个,预测表很容易锁定。
五、命中率统计与实战观测
way 预测命中率怎么测?坏消息是:主流 x86 的 PMU 没有直接暴露「way 预测命中/失败」的计数器,它不像分支预测有 BR_MISP_RETIRED 这样的一等公民事件,PMU 的一般用法见 PMU 性能计数器编程。好消息是它有多个间接观测窗口。
第一个窗口是 L1 命中延迟的分布。用指针追逐微基准(pointer chasing)测 L1 命中延迟,如果测得的平均延迟比手册标称值高零点几个周期、且随工作集增大而上升,上升部分里就混着 way 预测失败的惩罚。把工作集压到单组只有一两个 way 热的小尺寸再测,延迟回落的差值就是预测失败率的近似刻度。
第二个窗口是功耗计数器。Intel RAPL 或功耗仪表下,跑「同命中率、不同 way 冲突烈度」的两个负载(比如同样是 L1 常驻 16KB,一个按路均匀分布、一个集中砸在单组冲突上),功耗差里能分离出数据阵列多读的比例。这是学术界验证 way 预测器行为的经典手段。
第三个窗口是仿真与文档。gem5 这类模拟器里 way predictor 是可配置组件,能直接吐命中率;厂商优化手册(尤其 ARM 核的技术参考手册)常会写明 L1 是否采用路预测以及预测的粒度。
对性能工程师,命中率真正的影响在「误判」上:一段热代码 L1 命中率 99% 却跑不快,火焰图显示时间都花在 load 上——排查过 cache bank 冲突、cache 伪 LRU 树 替换抖动之后,way 预测失败率是最后一个值得怀疑的隐形税,尤其当数据布局刻意把热行散布到同组多路时(某些对抗缓存侧信道的混淆布局会人为制造这种模式)。
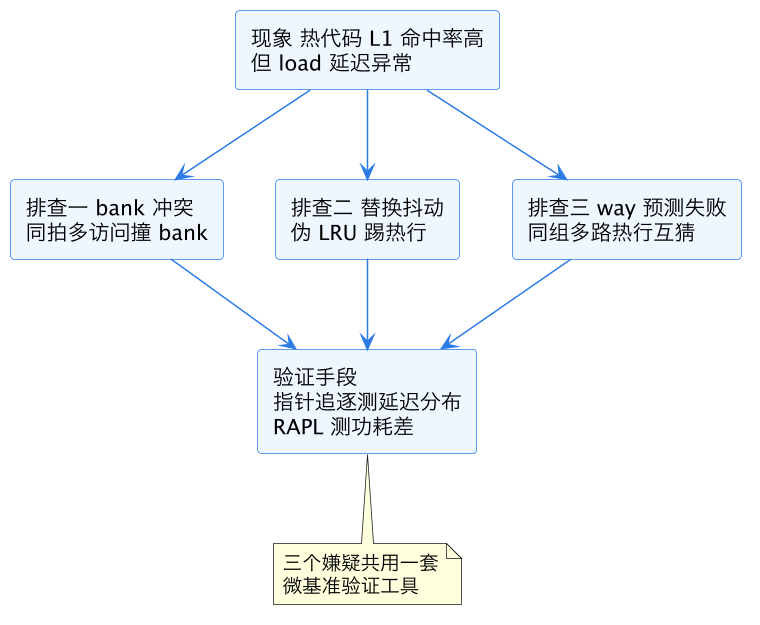
上图把「load 延迟异常」的三路排查画成了一张鉴别诊断表。way 预测失败排在最后不是因为它罕见,而是因为前两个嫌疑有直接的 PMU 事件可查,它只能靠延迟分布和功耗的间接证据定罪。
这一篇在知识体系里的位置
本篇是微架构模块「缓存与功耗线」上的一篇专题,回答 L1 组相联查找的功耗优化问题。上游是缓存组织的基础文 cache VIPT 与同义别名(组相联索引方式)与 CPU 微架构总览。同线相邻的功耗话题是 时钟门控与功耗门控 和 DVFS 频率切换延迟;同样用「预测换资源」哲学的姊妹篇是 分支预测 与 存储依赖预测。排查延迟异常时的相邻嫌疑见 cache bank 冲突,观测手段统一见 PMU 性能计数器编程。
总结
cache way 预测用一张微型历史表(与双模态分支预测器同构,按 PC 或地址索引,存 3 位路编号)在 L1 组相联查找前先猜一路:猜中只使能单路 tag 与数据阵列,把「并行读 8 路、7 路读出注定作废」的动态功耗砍到约三成到五成,功耗盈亏平衡点低到 14% 命中率;猜错则退回全 8 路重查,代价仅一到两个周期且不清空任何状态,远轻于分支预测失败的流水线冲刷——真实负载 80% 到 95% 的命中率下它是稳赚不赔的省电机制,唯一需要警惕的场景是热行被刻意散布到同组多路时,预测失败率上升会以「L1 命中延迟莫名变高」的形式出现,且 PMU 无直接计数器,只能靠指针追逐延迟分布与 RAPL 功耗差间接定罪。