PREFETCHWT1 提示:预取写提示的语义、编码方式与实测收益边界
承 hardware-prefetcher-stride-stream 对硬件预取器的拆解,以及 prefetch-feedback-throttling 对预取反馈节流的讨论。硬件预取擅长抓规则的数据流,但「马上要写」这个意图硬件猜不出来——PREFETCHWT1 提示就是程序员把这个意图直接告诉 CPU 的那条通道。它属于软件预取(software prefetch)家族里唯一面向「写」的提示,用对了能砍掉一次 RFO 往返,用错了纯属白占缓存。
本文要回答的问题
- PREFETCHW 和 PREFETCHWT1 提示是什么关系?语义上差在哪?
- 为什么说它能省一次 RFO(Read For Ownership,读所有权)往返?
- 怎么检测 CPU 是否支持这条指令?不支持时会怎样?
- 什么场景下实测有收益?边界在哪里?
- 和其他预取提示(NTA/T0/T1/T2)怎么选?
一、PREFETCHW 家族:写给未来的 store 看的预取
x86 的 PREFETCHh 指令族(PREFETCHNTA/T0/T1/T2)解决的都是「读」的问题:把行提前拉进某级缓存,等 load 命中。PREFETCHW 是 3DNow! 时代就有的老指令,语义是预取并意图写入——把行拉进缓存的同时,直接以 MESI 协议里的 Modified 或 Exclusive 状态落位,而不是 Shared。
PREFETCHWT1 提示是 Intel 在 Broadwell 时代随 PREFETCHW CPUID 叶子一起规范化的新写法:操作码 0F 0D /2,T1 后缀表示「拉进 L2 及以上层级,不进 L1」(和 PREFETCHT1 的层级语义一致)。换句话说,它是「PREFETCHW 的写语义」加上「T1 的层级语义」的组合。
| 指令 | 目标层级 | 缓存行状态意图 | 适合的消费方式 |
|---|---|---|---|
| PREFETCHT0 | L1 | Shared(可读) | 马上 load |
| PREFETCHT1 | L2 及以上 | Shared | 稍后 load,不想占 L1 |
| PREFETCHNTA | 非临时路径 | Shared,弱缓存 | 读一遍就扔的流数据 |
| PREFETCHW | L1 | Modified/Exclusive | 马上 store |
| PREFETCHWT1 | L2 及以上 | Modified/Exclusive | 稍后 store,不想占 L1 |
为什么「状态」这么重要?看一次普通 store 的开销:目标行不在本地时,核要发出 RFO 请求,把行以独占状态取回来——这是一次完整的缓存一致性往返,延迟和一次 LLC miss 同量级(本 socket 约 40-80 纳秒,跨 socket 更高,参考 numa-local-remote-latency 的量级表)。而 PREFETCHWT1 提示把这个 RFO 提前发出去,等真正的 store 到达时行已经是可写状态,store 直接在缓存里完成,那几十纳秒被藏进了预取与 store 之间的时间差里。
二、一条 store 的两种命运
下面这张图对比「裸 store」与「先用 PREFETCHWT1 提示再 store」两条路径上,缓存一致性流量的差别。
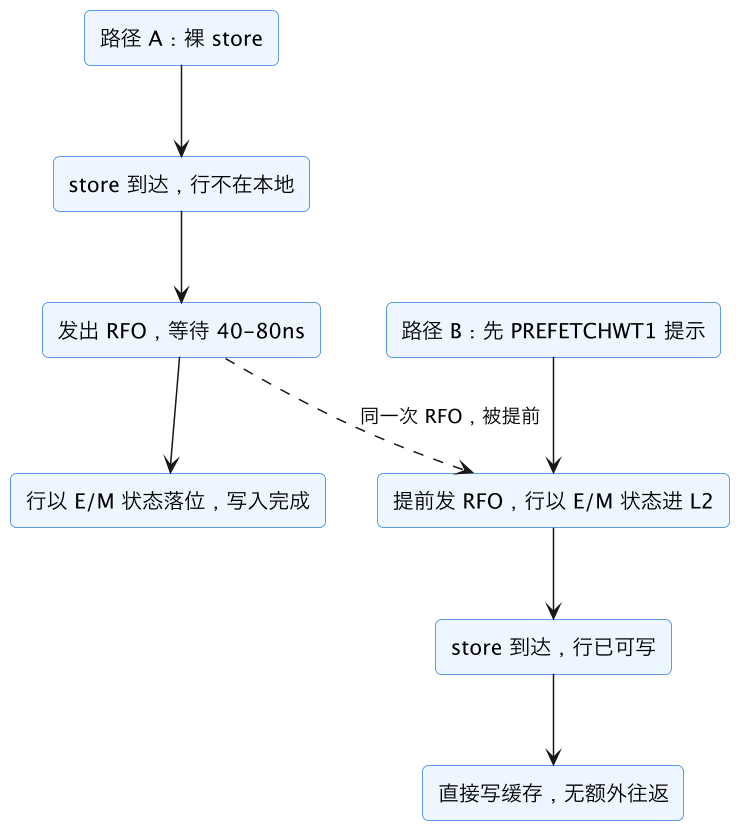
图的关键在虚线:两条路径的 RFO 总量是一样的——PREFETCHWT1 提示不减少流量,只移动时间点。所以它的收益完全取决于「预取和 store 之间有没有足够的事可干」。如果 store 紧跟预取、中间只有几条指令,RFO 延迟没藏住,等于白发一条指令;如果中间隔着几十上百条有效指令(比如处理前一个元素的计算),延迟被完全掩盖,store 变成「免费」的。这就是实测收益忽正忽负的根源。
三、检测、编码与不支持时的行为
CPUID 检测看 CPUID.07H:ECX.PREFETCHWT1 [bit 0];老的 PREFETCHW 看 CPUID.80000001H:ECX[bit 8](3DNow! 扩展位)。编译器侧 GCC 提供 __builtin_prefetch(p, 1, locality)——第二个参数为 1 表示写意图,locality 0-3 对应 NTA 到 T0;当 locality 为 1 或 2 且写意图置位、目标 CPU 支持时,就可能生成 PREFETCHWT1。
两个容易踩的点:
- 不支持的 CPU 上它不是非法指令。PREFETCHh 家族全是「提示」,语义上允许被当成 NOP 丢弃,执行不会 #UD。所以检测失败的最坏结果是白执行,不是崩溃——这也是它能在通用二进制里安全出现的原因。
- 它要的还是权限。地址必须可读,否则照样可能触发页错误(具体行为依实现而定,Intel 手册写明 PREFETCHW 在不可写页上可能 fault)。对只读映射的区域发写预取,属于自找麻烦。
四、实测收益的边界:什么时候值得用
把社区与实测报告里的结论压缩成一张判断表。典型场景是「先写后读命中率高的生产者」:环形缓冲区生产者写槽位、memset 大数组、初始化后马上要用的对象分配。
| 场景 | 预期收益 | 原因 |
|---|---|---|
| 生产者持续写新缓存行(ring buffer、对象分配) | 正,常见 5-15% 吞吐提升 | RFO 被提前并行发出,写流水不再等一致性往返 |
| memset/大数组初始化后立即消费 | 正但有限 | 考虑 streaming-nt-load-store 的 NT store 往往更优——NT store 连 RFO 都省了 |
| store 紧跟预取、中间无计算 | 负或为零 | RFO 延迟没藏住,多一条指令开销 |
| 写后即被其他核读(锁、标志位) | 负 | 行以 M 状态落位,其他核一读就要做 M→S 降级,多一次一致性流量 |
| 硬件预取器已经抓到的规则写流 | 为零 | 硬件 L2 streamer 对规则写序列同样有效,软件提示是重复劳动 |
最后一条值得展开:Intel 的 L2 streamer 对「顺序写」也能预取,且部分微架构的 L2 预取器会主动以 RFO 形式预取写流(见 l1i-l2-prefetch-coordination 对各级预取协作的讨论)。所以上 PREFETCHWT1 提示前,先用 perf 数一下 MEM_LOAD_RETIRED 相关事件和 store 停顿周期,确认写流确实在等 RFO——如果硬件已经干了这个活,软件提示只会增加前端压力。
测量时推荐的对照组:同一代码分别编译「预取开/预取关」两个版本,用 perf stat 看 cycle_activity.stalls_total 与 store 相关事件,配合 prefetch-accuracy-coverage-metrics 里的覆盖率/准确率口径评估提示质量。收益小于 3% 的场景,代码复杂度多半不值。
五、一个微基准的读法
看一个典型的测试写法:分配一块几 MB 的数组,循环按缓存行(64 字节)步进写入。版本 A 直接写;版本 B 在写 line[i] 之前对 line[i+distance] 发 PREFETCHWT1 提示,distance 分别取 8、16、32 行。单核 Skylake-SP 级机器上,distance 取 16 时常见 8-12% 的写吞吐提升——此时预取领先 store 约 16 次循环迭代,恰好盖住本 socket 的 RFO 延迟。distance 拉到 64 以上收益回落,原因是行在 L2 里等得太久,可能被其他流量挤掉或触发不必要的回写;distance 缩到 2 收益接近零,RFO 没藏住。
把循环改成多线程、每核写自己的分片,收益通常保持甚至放大——因为此时 RFO 面对的是更拥挤的一致性互连,提前量更值钱。但把测试改成「核 0 写、核 1 立刻读同一行」,PREFETCHWT1 提示版本会比裸写更慢:行以 M 状态落在核 0 的缓存里,核 1 每次读都要触发一次跨核的状态降级传输。这个反转用一张表概括:收益符号取决于行的下一个读者是谁。
| 下一个访问者 | 预取写提示的效果 |
|---|---|
| 自己马上写 | 正收益的本职场景 |
| 自己写后马上读 | 中性偏正 |
| 其他核读(共享标志、锁) | 负收益,M 状态降级多一跳 |
| 没人再碰(写后即弃) | 不如直接用 NT store |
另一个常被忽略的变量是内存是否已建页。对刚 mmap、尚未触碰的匿名页发预取,触发的是缺页或至少页表遍历,提示本身帮不上忙;这类「冷内存首次写」场景,预取写提示的收益主要来自预取引发的页遍历前置,幅度小且不稳定。
六、和其他提示怎么选
决策顺序很朴素:先问会不会再读。写一遍就再也不碰的大块内存,NT store(movntdq 等)是最优解,连行都不进缓存;写完自己马上要读回来的,用 PREFETCHW/PREFETCHWT1;写完主要是别的核读,什么都别预取,让 store 自然触发 RFO 反而最快完成状态移交。层级选择上,距离 store 还有几百条指令就用 WT1(停 L2,不占 L1),几十条以内才用 T0 级的 PREFETCHW。
这一篇在知识体系里的位置
本篇是软件预取专题的「写」分支,姊妹篇视角见 hardware-prefetcher-stride-stream(硬件流预取)、streaming-nt-load-store(非临时访存)、prefetch-feedback-throttling(预取节流);一致性协议背景见 MESI/MOESI 相关篇目,跨 socket 延迟量级见 numa-local-remote-latency。
总结
PREFETCHWT1 提示的价值是把 store 必需的 RFO 一致性往返提前发出、用预取与写之间的时间差把延迟藏掉:它不省流量只挪时间,所以收益全看「中间有没有活可干」——生产者写新行场景常见 5-15% 提升,紧跟 store 或写后被别的核读则为负;用之前先确认硬件预取器没把这个活干了,并和 NT store 这个更狠的选项比一比。