IOMMU 翻译路径:DMA 地址翻译、IOTLB 与 EPT 叠加的性能账
更新时间:2026-10-05。CPU 侧的虚拟地址翻译我们已经讲过两轮:TLB 与页表遍历缓存见 TLB 与页表遍历缓存,虚拟化引入的第二级翻译 EPT/NPT 见 EPT 与 NPT 二级地址翻译。但内存系统里还有一类发起方经常被忽略——设备。网卡收包要写内存、NVMe 读盘要写内存、GPU 搬数据也要写内存,这些 DMA(Direct Memory Access,直接内存访问)请求绕开 CPU,直接打到内存控制器上。谁来保证设备写的地址是它该写的地方?答案就是 IOMMU(Intel 叫 VT-d,AMD 叫 AMD-Vi,ARM 服务器上叫 SMMU)。本篇讲清 IOMMU 翻译路径的完整流程:设备地址怎么被二级页表翻译成物理地址、IOTLB 怎么缓存翻译结果、虚拟化场景下 IOMMU 与 EPT 叠加后一次 DMA 最多要走多少级页表,以及大页、ATS、直通这些手段各自省下哪一段开销。
本文要回答的问题
- IOMMU/SMMU 站在总线的什么位置?它给 DMA 加了哪些动作?
- IOMMU 翻译路径上一次设备地址翻译要遍历几级页表?开销量级是多少?
- IOTLB 是什么?命中率、失效(invalidation)开销怎么估算?
- 虚拟机里设备直通时,IOMMU 翻译与 EPT 翻译怎么叠加?最坏要走几级?
- 大页、ATS(Address Translation Services)、绕开 IOMMU 各在什么场景划算?
一、IOMMU 站在哪:DMA 路径上的地址关卡
没有 IOMMU 的年代,设备 DMA 用的是裸物理地址。驱动分配一块内存,把物理地址直接写进设备寄存器,设备就按这个地址读写。这在裸机单系统下能跑,但有两个致命问题:一是安全——设备(或设备固件里的漏洞)写错地址就能踩坏内核任意内存;二是虚拟化——虚拟机里的驱动看到的「物理地址」是 GPA(Guest Physical Address,客户机物理地址),不是真实的机器地址,设备拿着 GPA 去 DMA 必然写错地方。
IOMMU 解决这两个问题的办法是在设备与内存控制器之间插入一级翻译:设备发出的每个 DMA 地址先经过 IOMMU,由它查页表翻译成真实物理地址并做权限检查,通过后才放行到内存。ARM 阵营的 SMMU(System MMU)角色完全相同,只是叫法和编程接口不同,本文以 IOMMU 统称。
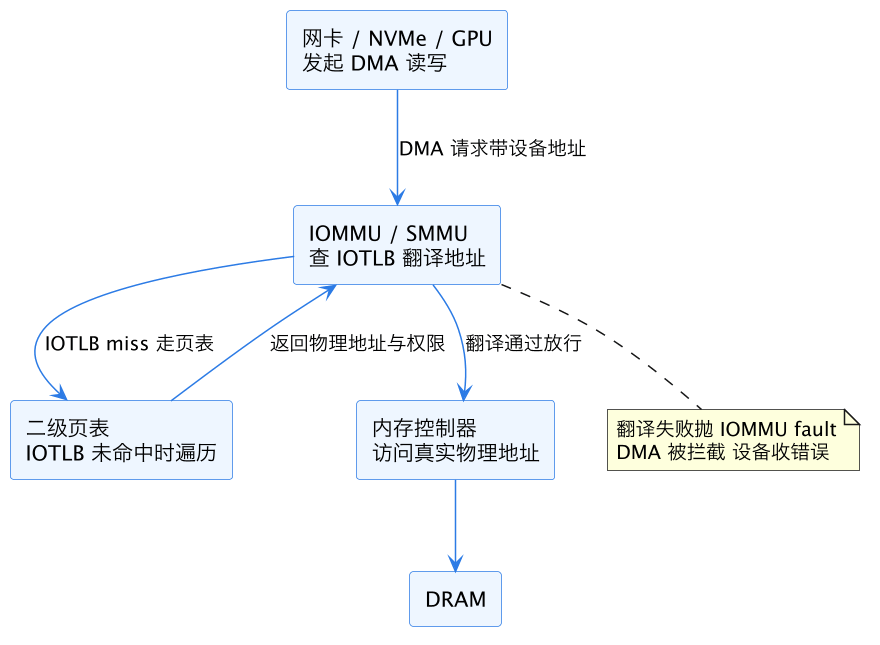
上图是 IOMMU 在数据路径上的位置:它不是旁路观察员,而是串在 DMA 路径上的关卡。每一个 DMA 读写事务都要过它一次——这正是性能敏感的根源。CPU 侧的 TLB miss 只是偶发的页表遍历,而网卡线速收包时每秒产生几十万次 DMA 写,如果每一次都在 IOTLB 里 miss、都去走内存里的页表,翻译开销会直接吃掉吞吐。
权限检查是同一关卡顺带做的事:IOMMU 页表项里有读写位,设备的每次 DMA 都会被核对「这个设备对这个页有没有读/写权」。驱动给网卡只映射了接收缓冲区,网卡就算被攻破固件也写不到缓冲区之外——这是 IOMMU 的隔离价值,也是虚拟化安全的底座。云厂商把直通网卡、直通 GPU 交给多租户混部,靠的就是这一关:没有 IOMMU,设备直通等于把宿主机内存的读写钥匙发给租户,安全模型直接崩塌。
IOMMU 按设备的 PCIe BDF(Bus/Device/Function 编号)区分翻译上下文,每个设备(精确到每个 function)有独立的页表视图。SR-IOV 场景里一块物理网卡虚拟出的每个 VF 都是独立 function,各自有独立映射,虚拟机之间互相不可见对方的 DMA 区域,粒度比「整卡一个视图」细得多。
二、IOMMU 翻译路径的页表遍历:四级起步,一次几百周期
IOMMU 翻译路径的核心是第二套页表。它的格式在 Intel VT-d 上与 CPU 的 x86-64 页表几乎同构(四级或五级,4KB 粒度),ARM SMMU 则直接复用 ARM 的 stage 页表格式。翻译流程也类似:从 IOMMU 的上下文表(context table,按设备的 BDF 编号索引)找到该设备的页表根,然后逐级索引页表项,直到拿到最终物理页框号和权限位。
一次完整的四级页表遍历意味着四次内存读:每级页表项都可能不在缓存里,每次读按 DRAM 延迟约 80 到 120 纳秒计,一次 miss 到底的遍历就是 300 到 500 纳秒量级。对比一下:不开 IOMMU 时 DMA 直达内存只是一次 DRAM 访问,开了 IOMMU 最坏情况下翻译本身比数据访问还贵 4 倍。
| 路径环节 | 命中情况 | 延迟量级 | 说明 |
|---|---|---|---|
| IOTLB 查询 | 命中 | 数纳秒 | 翻译缓存直接出结果 |
| IOTLB 查询 | miss | 进入页表遍历 | 触发硬件 page walk |
| 页表遍历(4 级) | 页表项在 LLC | 几十到一百纳秒 | 每级一次缓存访问 |
| 页表遍历(4 级) | 页表项在 DRAM | 300 到 500 纳秒 | 最坏情况 |
| DMA 数据访问 | 正常 DRAM 读 | 80 到 120 纳秒 | 翻译之后的实际数据搬运 |
IOMMU 也有类似 CPU 侧 page walk cache 的优化(VT-d 里有 context cache、paging-structure cache,缓存中间级页表项),可以把遍历缩短到只读最后一两级,背景与 CPU 侧的对应结构见 TLB 与页表遍历缓存。但根本结论不变:IOMMU 翻译路径的成本正比于「miss 率 × 遍历级数 × 每级延迟」,优化的所有手段都在砍这三个因子。
为什么 DMA 场景对延迟如此敏感?因为翻译结果不回来,DMA 事务就挂在总线上等。PCIe 的 posted write 虽然不要求响应,但 IOMMU 前的请求队列深度有限,翻译停顿会反压设备的发送流水线;读请求更是硬等数据。线速 100G 网卡每秒处理上千万个描述符,哪怕只有百分之几的 IOTLB miss,平均延迟也会被尾部拉高,最终体现为丢包或吞吐爬坡上不去。
三、IOTLB:DMA 侧的翻译缓存与失效代价
IOTLB(I/O TLB)就是 IOMMU 内部的翻译缓存,职能与 CPU 的 TLB 完全对应:缓存「设备地址 → 物理地址」的翻译结果,命中就免去页表遍历。它也是分页的——4KB 映射缓存一条,2MB 大页映射一条覆盖 512 倍范围,这与 CPU 侧大页减 TLB 压力的道理一致,参见 大页与 TLB 压力。
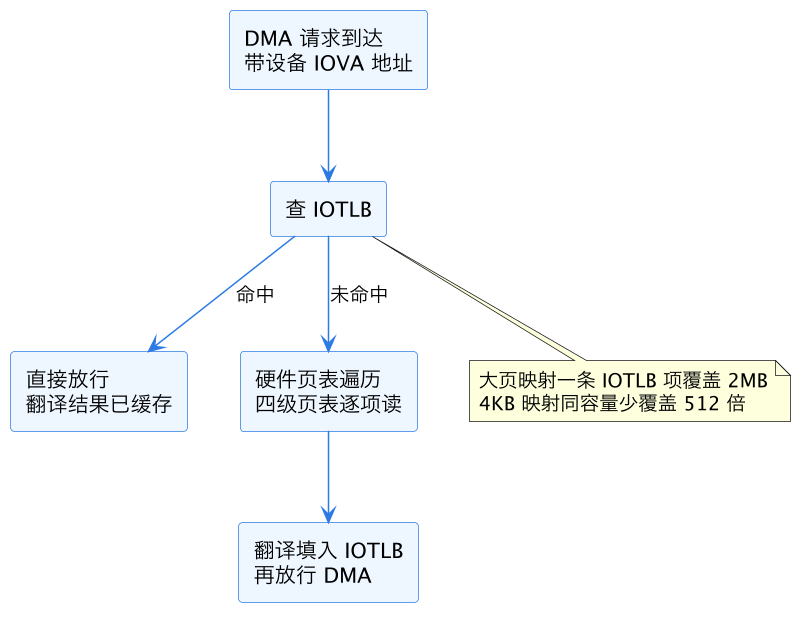
上图是 IOMMU 翻译路径在 IOTLB 层面的分流。真正麻烦的往往不是 miss 本身,而是失效(invalidation)。CPU 侧改页表要发 TLB shootdown(见 TLB shootdown 与失效),IOMMU 侧同样要作废 IOTLB 项:驱动 unmap 一块 DMA 缓冲区时,必须通过 IOMMU 寄存器接口提交 invalidation 请求,等 IOMMU 确认对应翻译已从 IOTLB 和 walk cache 清掉之后,这块内存才能安全复用。这个确认是一个硬件往返,单次几十到上百纳秒不等人——而且很多实现里 invalidation 粒度粗,unmap 一个 4KB 页可能把整个设备的 IOTLB 冲掉。
这直接塑造了高性能驱动的行为模式。网络栈的经典做法是把 DMA 映射的建拆从「每包一次」改成「每批一次」:IOMMU 开启时,dma_unmap_single 逐包调用的路径会积累大量 invalidation 往返,XDP、DPDK 这类框架因此倾向一次性映射整个环形缓冲区并长期持有(page pool、persistent mapping),把 invalidation 频率压到接近零。Linux 内核侧也在同方向演进:dma-iommu 层实现了惰性 unmap 与批量 invalidation,把多次 unmap 攒成一次硬件通告;iommu.strict=0 就是打开这个行为的开关,吞吐型负载下通常值得测一把。iommu=pt(passthrough)内核参数走的则是另一条路:让 DMA 地址等于物理地址,IOMMU 只做权限透传不做翻译,IOTLB 压力归零——裸机上吞吐最高的配置,代价是放弃隔离。
还有一个容易踩的坑是 IOMMU 的映射粒度与 bounce buffer。当设备 DMA 能力受限(比如老式 32 位设备访问不了高位内存)或映射失败时,内核会退回到 swiotlb 反弹缓冲区:数据先 DMA 到一块低地址跳板内存,再由 CPU 拷到目的地。这一退避路径多一次全量内存拷贝,吞吐直接腰斩,排查 DMA 性能问题时 dmesg 里的 swiotlb 字样是第一嫌疑。
| 策略 | 翻译开销 | 隔离性 | 适用场景 |
|---|---|---|---|
| 完全启用 IOMMU(4KB 页) | 高:miss 遍历加 invalidation | 最强 | 多租户、设备不可信 |
| IOMMU 加大页映射 | 中:IOTLB 覆盖大、invalidation 少 | 强 | 虚拟化宿主力推 |
| iommu=pt 透传 | 近零:地址直通只查权限 | 弱 | 裸机高性能网络与存储 |
| ATS 设备端缓存 | 最低:设备自己缓存翻译 | 强 | 支持 ATS 的 PCIe 设备 |
四、虚拟化叠加:IOMMU 与 EPT 的双重翻译
虚拟化场景是 IOMMU 翻译路径最长的形态。设备直通(VFIO/passthrough)给虚拟机时,设备 DMA 发出的是 GPA;IOMMU 用一套「第二级页表」把 GPA 翻译成 HPA(Host Physical Address,宿主机物理地址)——这套表与 EPT 是同一张表(VT-d 支持直接复用 EPT 页表根,也可以维护独立副本)。也就是说,DMA 地址翻译与 CPU 内存访问的第二级翻译在页表结构上同源,差别只在发起方:一个来自设备经 IOMMU,一个来自 CPU 经 MMU,EPT 侧的机制见 EPT 与 NPT 二级地址翻译。
更长的路径出现在嵌套虚拟化或 vIOMMU(虚拟 IOMMU 暴露给客户机)场景:客户机自己的 IOMMU 驱动先把 IOVA(I/O Virtual Address)翻译成 GPA(stage 1),宿主机 IOMMU 再把 GPA 翻译成 HPA(stage 2)。两级串联。
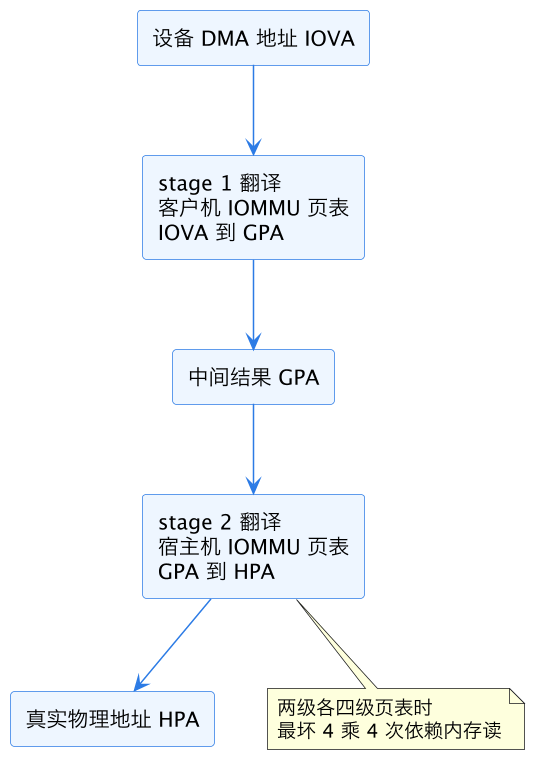
上图里要警惕的是级数相乘。ARM SMMUv3 的 stage 1 加 stage 2 串联是最直观的例子:stage 1 每读一级页表项,这个读本身又是 stage 2 的地址,需要再做一次 stage 2 翻译。stage 1 四级、stage 2 四级时,一次完整翻译最坏需要 4 × 4 = 16 次相互依赖的内存访问,纳秒级延迟累加到微秒级不是玩笑。这正是 IOTLB 在虚拟化场景格外重要的原因——一次命中的 IOTLB 项缓存的是「IOVA 直达 HPA」的合并结果,整条 16 步路径全部跳过。x86 VT-d 的 scalable mode 与 ARM SMMU 都按合并翻译设计 IOTLB 项,道理与 CPU 侧 EPT miss 时 TLB 缓存合并结果的逻辑一致。
实战含义有三条。第一,宿主机给直通设备分配大页(2MB 甚至 1GB)能把 stage 2 的遍历级数和 IOTLB 项数同时砍掉一到两级,是虚拟化 I/O 性能的第一优化。第二,中断重映射(interrupt remapping)与地址翻译共用 IOMMU 的上下文索引,排障时 IOMMU fault 常常和中断投递失败一起出现,别当成两件事查。第三,vIOMMU 只在客户机里有不可信驱动或要做设备热迁移时才值得开,普通直通场景让宿主机 IOMMU 单独做 stage 2 已经够,两级串联的开销大多数负载付不起。
五、ATS 与工程选型:把翻译缓存推到设备端
ATS(Address Translation Services,PCIe 地址翻译服务)是另一条压缩 IOMMU 翻译路径的思路:与其让设备每次都问 IOMMU,不如让设备自己缓存翻译。支持 ATS 的设备在 DMA 前先向 IOMMU 发一个轻量的「翻译请求」,拿到物理地址后存在设备本地的 ATC(Address Translation Cache)里,之后的 DMA 直接用已翻译地址(带标记的事务直接穿透 IOMMU 的翻译级)。效果上等于把 IOTLB 分布式地推到了每个设备端,IOMMU 只在 ATC miss 和 invalidation 时介入。
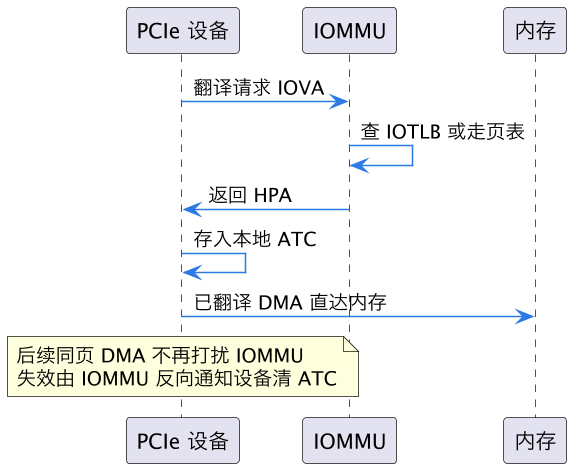
上图是 ATS 的交互序列。它改变的是翻译流量的分布:IOMMU 从「每个 DMA 事务都查一次」变成「每个新地址区域查一次」,IOTLB 压力大幅下降,这对多设备高并发场景(整机几十块网卡与 NVMe)尤其关键——共享 IOTLB 的容量竞争被设备端缓存化解了。代价是 invalidation 复杂度上升:宿主机作废映射时要给所有持有翻译副本的设备发 invalidation 通告并等确认,这正是 ATS 必须配套 PRI(Page Request Interface)协议的原因。
综合全篇,IOMMU 翻译路径的选型逻辑可以归纳成一句话:先确认你要不要隔离。裸机追求极限吞吐用 iommu=pt;虚拟化必须隔离时,优先级是大页映射、减少 stage 串联、能上 ATS 就上 ATS;诊断性能问题时先看 IOMMU fault 计数和 invalidation 频率,再看驱动是不是在 DMA map/unmap 的热路径上反复建拆映射。观测上,perf 与 IOMMU 的 PMU 事件(VT-d 提供 IOTLB miss、context cache miss 计数)能把翻译开销量化出来,方法见 PMU 性能计数器编程。
这一篇在知识体系里的位置
本篇是微架构模块「地址翻译线」的 I/O 侧收口篇。CPU 侧第一级翻译与缓存结构见 TLB 与页表遍历缓存,两级 TLB 设计见 TLB 两级结构与 STLB,失效机制见 TLB shootdown 与失效,大页减压见 大页与 TLB 压力;虚拟化第二级翻译的姊妹篇是 EPT 与 NPT 二级地址翻译——本篇的 IOMMU stage 2 与它同根。观测手段见 PMU 性能计数器编程,全景见 CPU 微架构总览。
总结
IOMMU 翻译路径是设备 DMA 进入内存前的地址关卡:IOMMU/SMMU 用独立页表把设备地址翻译成物理地址并做权限隔离,一次 IOTLB miss 最坏要付四级页表遍历的三五百纳秒,而 unmap 引发的 invalidation 往返逼出了批量映射、持久映射这类驱动优化;虚拟化下 IOMMU 的 stage 2 与 EPT 同源,嵌套 vIOMMU 时两级串联最坏 4×4 次依赖内存读,靠合并翻译的 IOTLB 项和宿主机大页才能压回可接受范围;裸机可用 iommu=pt 直通换吞吐,设备端 ATS 则把翻译缓存推到 PCIe 设备本地。记住成本公式——miss 率乘以遍历级数乘以每级延迟——所有优化手段都在砍这三个因子。