PMU(Performance Monitoring Unit)—— CPU 里的"黑匣子"
perf 为什么能告诉你 cache-miss 了几次、分支预测失败了多少回?不是在软件里插桩——是 CPU 芯片里有一组硬件计数器在默默地数。这个硬件模块叫 PMU(性能监控单元)。本篇从硬件角度讲清 PMU 的架构、事件选择机制、溢出中断和精确采样,不涉及 perf 用户态工具的实现(那部分见 perf-internals)。
关联:core-and-uncore(Core/Uncore 划分)、cpu-architecture(CPU 架构全景)、perf-internals(perf 原理,PMU 为数据源)、interrupts(PMU 溢出走 NMI 通道)
零、一句话结论
PMU 是 CPU 芯片内置的一组硬件性能计数器(MSR 寄存器),每发生一次微架构事件(指令退休、cache miss、分支预测失败等)就 +1。计数器溢出可触发 PMI 中断(走 NMI),perf 利用这个中断抓取现场(IP、调用栈)实现采样。PMU 分 per-core PMU(每个核心独立)和 uncore PMU(共享基础设施),Intel 和 AMD 的实现有差异但原理相通。
一、PMU 是什么,解决什么问题
1.1 没有 PMU 的时代
在没有 PMU 的年代,要回答"这段代码的 cache miss 率是多少"只能靠:
- 模拟器 / 周期精确模型:慢 100~10000 倍,无法用于生产环境
- 代码插桩:改代码加计数器,引入额外开销,改变程序行为(Observer Effect)
- 定时采样 PC:只能看到"在哪个函数",不知道"为什么慢"
这些手段都无法在真实硬件上、不影响程序行为的前提下、精确地回答微架构级别的问题。
1.2 PMU 的核心价值
PMU 是 CPU 设计者在芯片里预留的一张"体检报告单"——它不干扰程序执行,只是旁路观测:
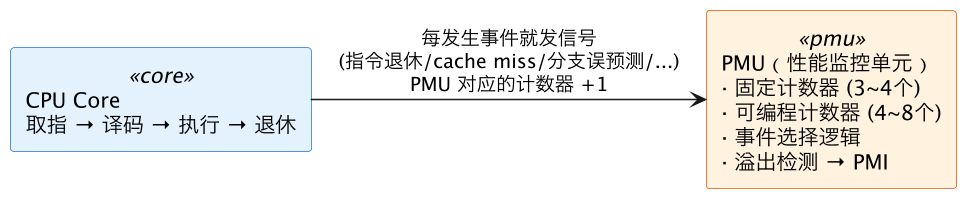
PMU 回答的问题不是"CPU 在干什么"(那是 PC 采样),而是 **"CPU 内部发生了什么微架构事件" **:
| 问题 | 对应 PMU 事件 |
|---|---|
| IPC(每拍执行几条指令)是多少? | instructions ÷ cycles |
| L1 缓存命中率? | L1-dcache-loads / L1-dcache-load-misses |
| 分支预测准确率? | branches / branch-misses |
| 前端还是后端瓶颈? | stalled-cycles-frontend vs stalled-cycles-backend |
| TLB 抖动了吗? | dtlb_load_misses.miss_causes_a_walk |
二、PMU 硬件架构
2.1 整体结构:计数器 + 事件选择 + 溢出逻辑
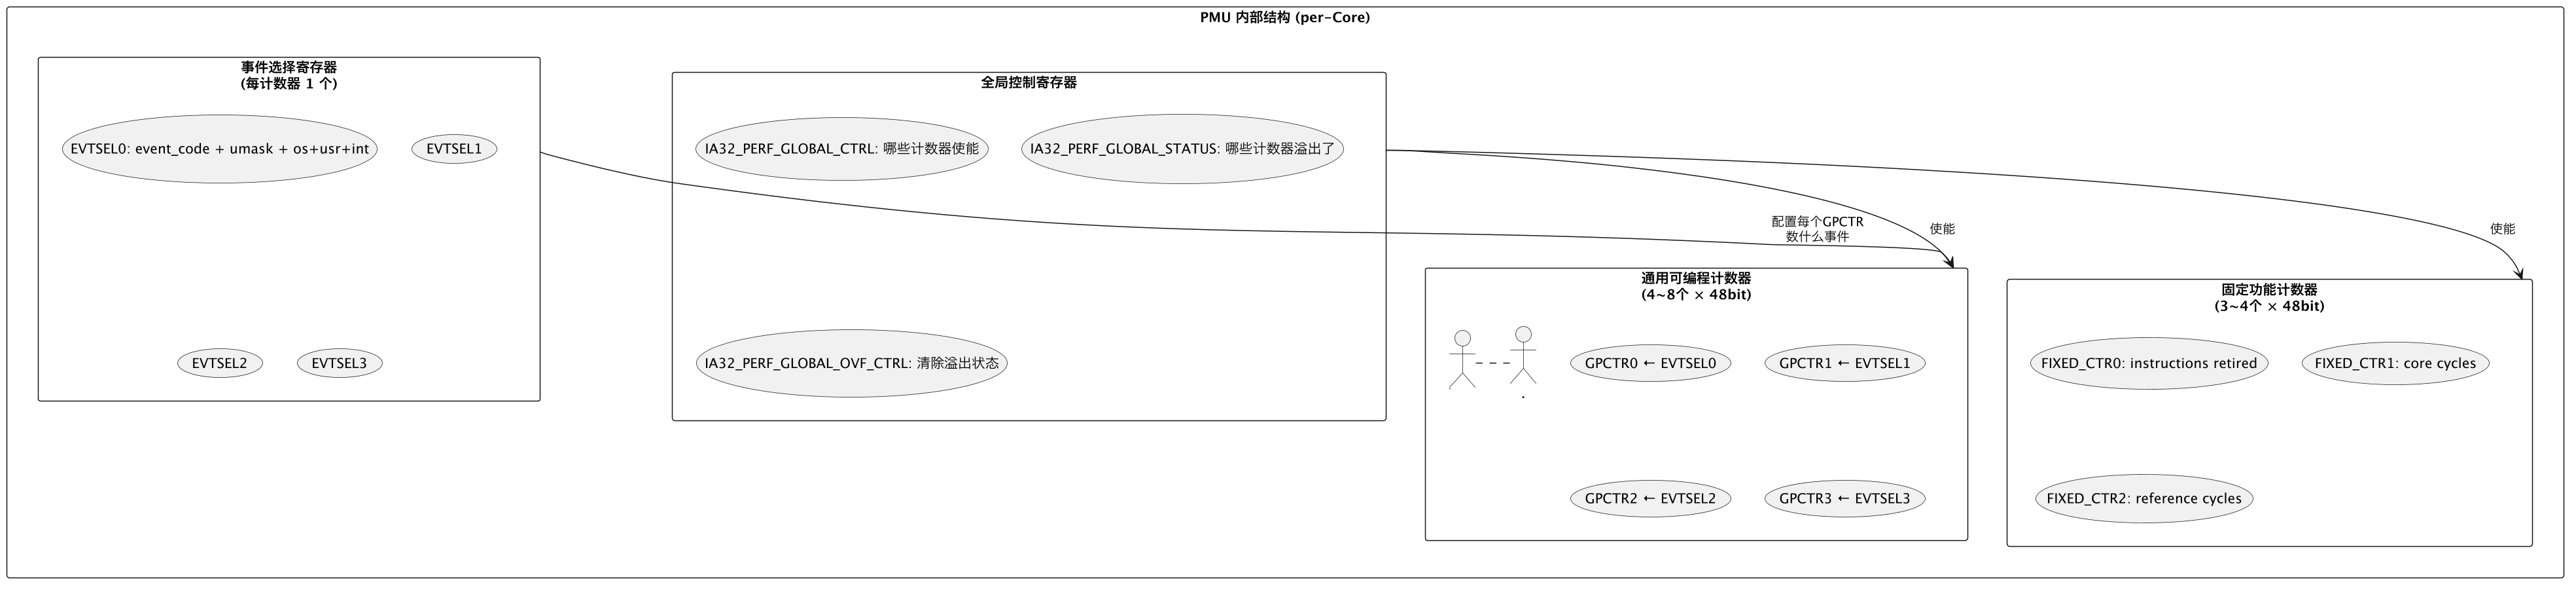
2.2 三类寄存器
| 类别 | MSR 地址范围 | 宽度 | 数量 | 作用 |
|---|---|---|---|---|
| 固定计数器 | 0x309 (IA32_FIXED_CTR0) ~ 0x30B | 48 bit | 3~4 个 | 硬件固定只计一种事件,不可编程 |
| 通用计数器 | 0xC1 (IA32_PERFCTR0) ~ | 48 bit | 4~8 个 | 可编程,通过 EVTSEL 配置数哪种事件 |
| 事件选择寄存器 | 0x186 (IA32_PERFEVTSEL0) ~ | 64 bit | 与 GP 等数 | 配置对应 GPCTR 的 event_code + umask + 权限过滤 |
| 全局控制 | 0x38F (IA32_PERF_GLOBAL_CTRL) 等 | 64 bit | 3 个 | 全局使能/状态/溢出控制 |
2.3 固定计数器 vs 可编程计数器
| 固定计数器 (Fixed Counter) | 可编程计数器 (GP Counter) | |
|---|---|---|
| 数量 | 3~4 个 | 4~8 个 (Skylake 4 个, Icelake+ 8 个) |
| 事件 | 硬件写死,不可改 | 通过 EVTSEL 配置,几百种事件可选 |
| 占用 MSR | 不占 EVTSEL | 每个 GP 配 1 个 EVTSEL |
| 典型事件 | instructions retired, core cycles, reference cycles | cache-misses, branch-misses, TLB misses, 各种微架构事件 |
| perf 中的体现 | perf stat 默认输出大部分来自固定计数器 | perf stat -e xxx 或 perf record -e xxx 用可编程计数器 |
关键约束:固定计数器不占可编程计数器的槽位。所以
perf stat默认输出(cycles + instructions + ...)和自定义事件(-e cache-misses)可以同时使用而互不抢占。
2.4 计数器宽度与溢出
每个计数器 48 bit(Intel)/ 48 bit(AMD):
48 bit 计数器最大值 = 2^48 - 1 ≈ 281 万亿 (2.81 × 10^14)
在 3GHz CPU 上计 cycles:281T / 3G ≈ 93700 秒 ≈ 26 小时才溢出
在 3GHz CPU 上计 instructions (IPC=2):281T / 6G ≈ 13 小时
正常做 perf stat 几乎不会溢出。溢出机制真正的用途不是"防止溢出",而是充当采样触发器——见 §三。
三、事件选择:怎么让计数器"数正确的东西"
3.1 EVTSEL 寄存器的位域
每个 GPCTR 配一个 64 位的 IA32_PERFEVTSELx 寄存器(x = 0,1,2,3...):
IA32_PERFEVTSELx (0x186 + x, 64-bit)
┌──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┐
│  63  │ 58   │ 56   │  40  │  24  │  16  │   8  │   0  │
├──────┼──────┼──────┼──────┼──────┼──────┼──────┼──────┤
│ 保留  │ CMASK│  INV │ 保留  │ UMSK │ USR  │  OS  │ E.C. │
│      │(8bit)│ (1b) │      │(8bit)│ (1b) │ (1b) │(8bit)│
└──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┘
                                                    ↑
                                     Event Code: 具体数什么事件
UMSK: 事件的子类别掩码| 位域 | 位 | 含义 |
|---|---|---|
| Event Code | 7:0 | CPU 微架构事件编号(Intel 手册卷 3 第 19 章) |
| UMASK | 15:8 | 事件的子类别过滤(如 MEM_LOAD_RETIRED 的 UMSK=0x01 表示 L1 hit, 0x02 表示 L2 hit) |
| USR | 16 | 计数用户态 (Ring 3) 事件 |
| OS | 17 | 计数内核态 (Ring 0) 事件 |
| E (Edge) | 18 | 边沿检测模式:计数器从 0 变 N 时记录 |
| PC (Pin Control) | 19 | 开启 PEBS(精确事件采样),见 §四 |
| INT (APIC Interrupt) | 20 | 溢出时产生 PMI 中断(perf 采样的核心) |
| INV | 23 | 反转 CMASK 比较逻辑 |
| CMASK | 31:24 | 计数器阈值:每拍事件数 ≥ CMASK 才 +1 |
3.2 Event Code + UMASK 的含义
perf 里看到的通用事件名(cache-misses)是内核到硬件事件的映射别名。实际硬件层面是 (event_code, umask) 二元组:
perf 事件名          →  硬件 (event_code, umask)
─────────────────────────────────────────────────
cycles              =  固定计数器 1(不可编程)
instructions        =  固定计数器 0(不可编程)
cache-misses        =  (0x2E, 0x41) — LONGEST_LAT_CACHE.MISS
cache-references    =  (0x2E, 0x4F) — LONGEST_LAT_CACHE.REFERENCE
branch-misses       =  (0xC5, 0x00) — BR_MISP_RETIRED.ALL_BRANCHES
cpu-cycles          =  (0x3C, 0x00) — CPU_CLK_UNHALTED.THREAD
L1-dcache-load-misses = (0xD1, 0x01) — MEM_LOAD_RETIRED.L1_MISS
dTLB-load-misses    =  (0xD0, 0x01) — MEM_INST_RETIRED.STLB_MISS_LOADS
用
perf list --details或libpfm4的showevtinfo可以看到当前 CPU 支持的完整 (event, umask) 映射表。
3.3 CMASK 和 INV:阈值计数
CMASK 不是"每发生事件就 +1",而是"每拍事件数 ≥ CMASK 阈值才 +1":
CMASK=0:每发生一次事件 +1(最常用)
CMASK=1:每拍至少发生 1 次 +1(等于事件发生的拍数)
CMASK=2:每拍至少发生 2 次 +1(找"事件密度高"的拍)
INV=1 时反转:每拍事件数 < CMASK 才 +1
→ 可以计数"流水线空闲的拍数"
四、Per-Core PMU vs Uncore PMU
4.1 两类 PMU 的分工
CPU 芯片里不是只有一个 PMU——每个 Core 有自己的 per-core PMU,共享的 Uncore 区域有独立的 uncore PMU:
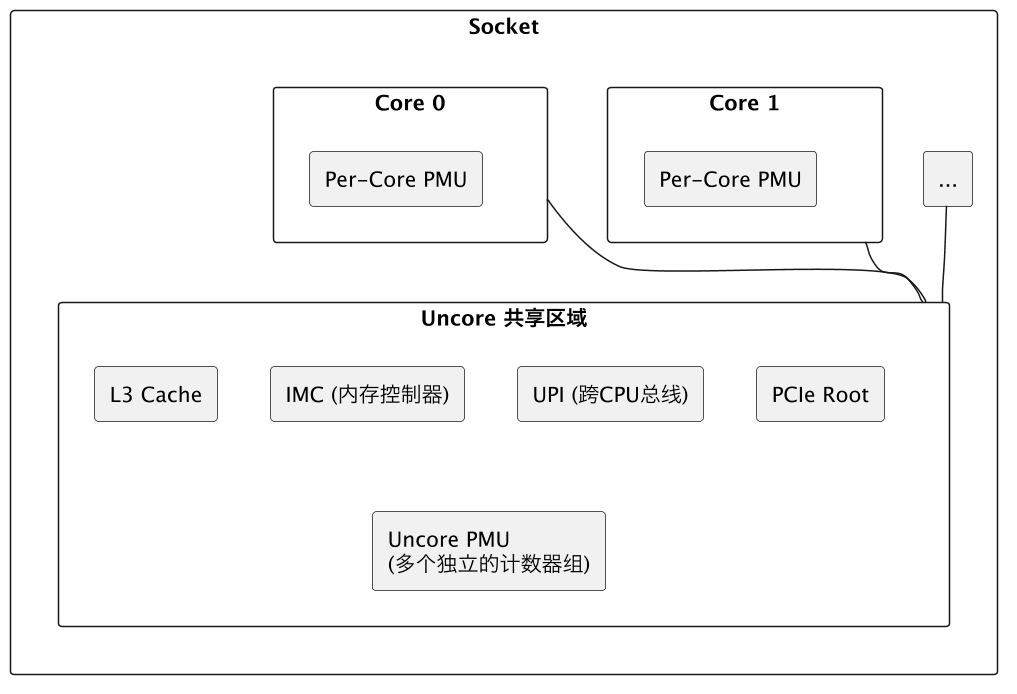
| Per-Core PMU | Uncore PMU | |
|---|---|---|
| 位置 | 每个物理核心里 | 片上共享区域(L3/IMC/UPI 旁边) |
| 数量 | 每组 3~4 固定 + 4~8 GP | 多组独立计数器,每组针对一种共享资源 |
| 观测对象 | 这个核上的指令执行情况 | 整个芯片共享资源的使用情况 |
| 典型事件 | cycles, instructions, cache-miss, branch-miss, TLB miss | L3 命中率、内存带宽、UPI 带宽、PCIe 带宽 |
| perf 访问 | perf stat -e cycles (默认 per-core) | perf stat -e uncore_imc/cas_count_read/ |
| CPU 型号差异 | 较小,Intel 和 AMD 事件名基本标准化 | 极大,每代 CPU uncore 事件完全不同 |
4.2 Uncore PMU 的典型用途
# 看内存读带宽(Intel IMC uncore 计数器)
perf stat -e uncore_imc/cas_count_read/ -a sleep 10
# 看跨 socket 通信量(Intel UPI uncore)
perf stat -e uncore_upi/tx_flits/ -a sleep 10
# 看 L3 miss 总量(Intel CBOX uncore)
perf stat -e uncore_cbox/event=0x0,umask=0x0/ -a sleep 10注意:Uncore PMU 事件是系统级的(不按进程隔离),因为 L3 和内存控制器被所有核心共享,无法区分"这次 L3 miss 是哪个进程导致的"。
五、计数器溢出 → PMI → perf 采样
5.1 为什么需要溢出机制
大多数时候 perf stat 只读计数器的最终值。但 perf record / perf top 需要采样——每隔 N 次事件抓一次现场(哪个 IP、什么调用栈)。
方案 A(轮询):每隔 1ms 读一次计数器 → 开销大 + 时间不准
方案 B(溢出中断):编程计数器初值 = -N(补码),每 N 次事件溢出 → 硬件触发中断 → 抓现场
CPU 硬件选择了方案 B,这就是 PMI(Performance Monitoring Interrupt)。
5.2 溢出 → PMI → NMI 的完整路径
perf record -e cycles -F 99 ./a.out
        ↓
perf 设 GPCTR0 = -SAMPLE_PERIOD (用补码)
SAMPLE_PERIOD = cpu_freq / 99 ≈ 3GHz/99 ≈ 3030万 cycles
        ↓
CPU 每执行 ~3030万个 cycle  →  计数器溢出
        ↓
硬件: 置 IA32_PERF_GLOBAL_STATUS.OVF 位
硬件: 通过 LAPIC 发 PMI
        ↓
x86 上 PMI 走 NMI 通道 (不可屏蔽中断)
        ↓
NMI handler → perf_events NMI 回调:
  1. 读当前 IP (指令指针)
  2. 读调用栈 (frame pointer / dwarf / LBR)
  3. 写 record 到 mmap 环形缓冲区
  4. 重置计数器 = -SAMPLE_PERIOD
  5. 清除溢出状态位
        ↓
用户态 perf: poll() 感知有新数据 → 搬记录 → 写 perf.data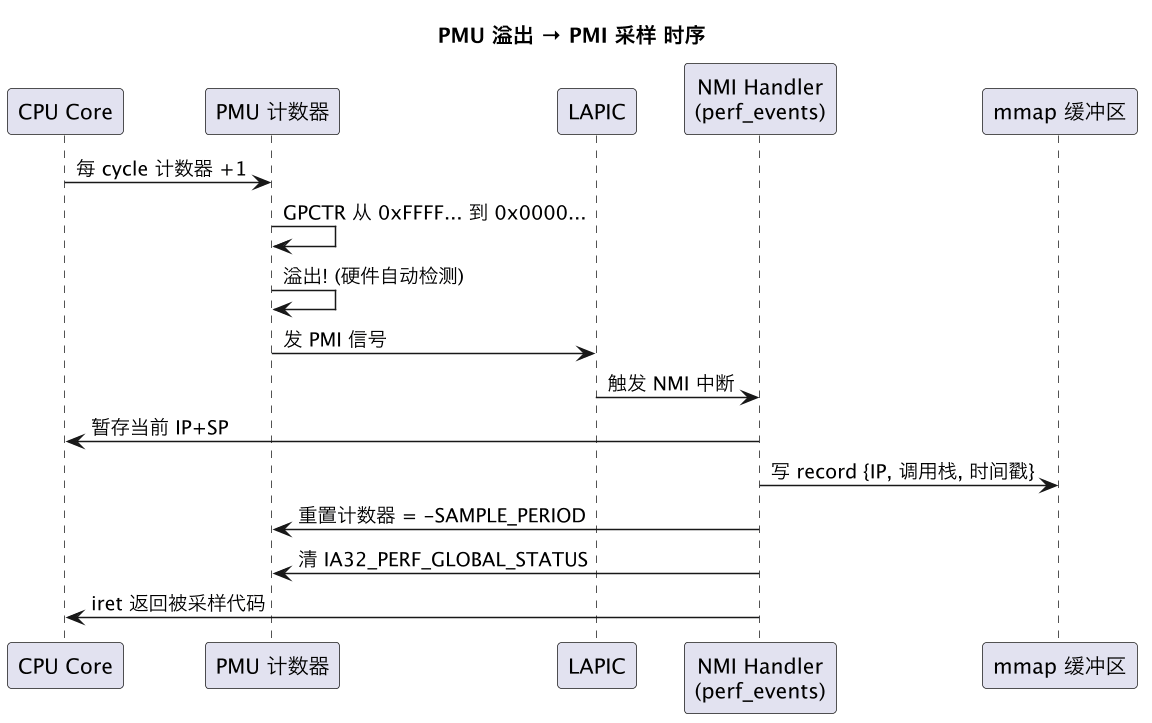
5.3 为什么 PMI 走 NMI 通道
PMI 走 NMI(不可屏蔽中断)通道是精心设计的:
| 如果走普通 IRQ | 现实是走 NMI |
|---|---|
| 关中断的代码段(spin_lock_irqsave)里无法采样 | NMI 可以打断任何代码,不受 CLI 影响 |
| 采样会丢内核锁持有时、中断处理时的热点 | 能看到"关中断期间在干什么" |
| 可能被其他中断延迟 | NMI 优先级最高,立即响应 |
详见 interrupts §四,
/proc/interrupts中的 NMI 行包含 PMI 计数。
5.4 Skid(采样偏移)
PMI 从"计数器溢出"到"NMI handler 读到 IP"之间有 指令流水线深度 × N 条指令的延迟。这意味着采到的 IP 通常不是真正导致溢出的那条指令——这就是 skid:
真正导致溢出的指令 (第 1000 条)
  → 流水线继续执行 ~5-20 条指令 (skid)
  → PMI 触发
  → NMI handler 读到 IP → 指向第 1005~1020 条
perf report 的 --no-skid 选项或 PEBS(见 §六)可以减轻这个问题。
5.5 采样开销:NMI 对 CPU 的性能影响
会打断 CPU 运行吗?—— 会。 NMI 是最硬的中断,硬件自动保存当前指令流的状态(IP/SP/EFLAGS),跳转到 NMI handler,执行完毕 iret 返回。被采样代码在这段时间内完全停止执行。
有性能问题吗?—— 有开销,但通常可忽略。 开销取决于采样频率和单次 NMI handler 耗时:
采样开销(%) = (采样频率 Hz) × (单次 handler 耗时 s) × 100%
perf record -F 99:   99 × ~3μs  = ~0.03%   ← 几乎无感知
perf record -F 999:  999 × ~3μs = ~0.3%    ← 生产环境常用上限
perf record -F 4000: 4000 × ~5μs = ~2%     ← 最大频率,可测量但不大
NMI handler 内部做了什么(耗时来源):
| 步骤 | 耗时 | 说明 |
|---|---|---|
| 硬件保存现场 + 切换栈 | < 0.5μs | 硬件自动 push SS/RSP/RFLAGS/CS/RIP |
| perf_events NMI callback | ~1-2μs | 读 IP、读 PMU 状态寄存器、判断事件来源 |
| 回退调用栈 (unwind) | ~1-5μs | FP unwind ≤ 1μs,DWARF 可达 ~5μs |
| 写 record 到 mmap 环形缓冲区 | < 0.2μs | 纯内存写入 |
| 重置计数器 + 清溢出位 | < 0.2μs | 几条 MSR 写指令 |
| iret 返回 | < 0.3μs | 硬件恢复现场 |
| 合计 | ~3~8μs | FP unwind 场景约 3μs,DWARF 约 5~8μs |
为什么
-F 4000下 NMI handler 更慢? 因为采样频率越高,环形缓冲区写入越频繁,用户态 perf 进程被唤醒越勤,上下文切换 + cache 污染也会叠加。
NMI 的隐蔽开销(比 handler 本身更难测量):
| 开销类型 | 影响 |
|---|---|
| Cache 污染 | NMI handler 代码 + 栈数据会抢占被采样程序的 L1-I / L1-D / L2,导致 iret 后出现短暂的 cache miss 潮 |
| TLB 污染 | handler 的代码页和数据页竞争 dTLB/iTLB 条目,退出后原程序的部分 TLB 映射被挤出 |
| 分支预测器污染 | handler 的分支历史覆盖了原程序的分支预测状态 |
| NMI 不可嵌套 | 一个 NMI 处理期间,后续 NMI 被硬件屏蔽,高频采样时样本可能被合并或丢弃 |
实际建议:
| 场景 | 推荐频率 | 开销量级 |
|---|---|---|
| 生产环境长期 profiling | -F 49~99 | < 0.05%,放心用 |
| 常规性能分析 | -F 99~999 | < 1% |
| 短时热点分析(低流量服务) | -F 2000~4000 | 1~2%,可接受 |
| 长尾延迟敏感(HFT / 高频交易) | 避免 PMI,用 PEBS + 极低频率 | → §六 |
一句话:
-F 99采样 ≈ 每 10ms 停 ~3μs,相当于每 10000μs 停 3μs = 0.03% 开销,比操作系统调度器本身的开销还小一个数量级。
六、精确采样:Intel PEBS vs AMD IBS
6.1 普通 PMI 采样的"不精确"问题
普通 PMI 采样(§五)的 IP 有 skid,这在统计上问题不大(热点函数仍然清晰),但有两个场景很致命:
- 想知道"哪条 load 指令导致 cache miss"——skid 偏移后 IP 可能指向下一条、甚至下下条指令
- 想知道"数据地址是什么"——PMI handler 拿不到已经消失的 load 地址
6.2 Intel PEBS(Precise Event-Based Sampling)
PEBS 的核心思路:不让 PMI handler 临时去读,而是硬件在事件发生时就把全套信息(IP + 数据地址 + 延迟)自动写入一个内存缓冲区。
普通 PMI:  溢出 → NMI → 软件读寄存器 (有 skid)
PEBS:      事件发生 → 硬件写 PEBS buffer (IP+数据地址+延迟)
            → buffer 满了 → PMI → handler 批量取走记录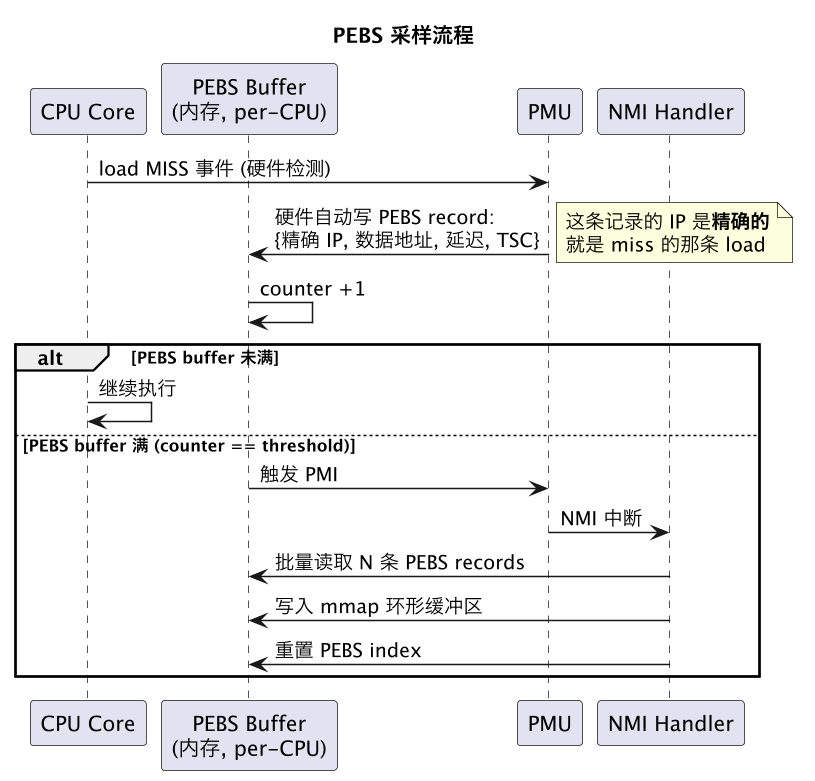
PEBS 的关键优势:
| 普通 PMI | PEBS | |
|---|---|---|
| IP 精度 | 有 skid (~5-20 条指令) | 精确,就是触发事件的那条指令 |
| 数据地址 | 拿不到(load 已完成) | 硬件记录在 PEBS record 里 |
| 延迟信息 | 无 | 有(L1/L2/L3/memory 命中延迟) |
| 开销 | 低(每个样本一次 PMI) | 更低(N 个样本才一次 PMI) |
| 适用事件 | 所有事件 | 仅 Precision Events(perf list 中带 [Precise] 标记) |
perf 中开启 PEBS:在事件后加 :pp(precise)或 :ppp(more precise):
perf record -e cycles:pp  ...    # PEBS 精度
perf record -e mem_load_retired.l3_miss:pp ...  # 精确定位哪条 load 导致 L3 miss
6.3 AMD IBS(Instruction-Based Sampling)
AMD 没有 PEBS,用的是 IBS(Instruction-Based Sampling)——机制不同但目标相同:精确采样。
IBS Fetch 采样:  随机选一条取指的指令 → 记录"取指阶段"的延迟
IBS Op 采样: 随机选一条 μOP → 记录"执行/访存阶段"的延迟 + 数据地址| Intel PEBS | AMD IBS | |
|---|---|---|
| 触发方式 | 事件发生后硬件记录 | 随机选一条指令/μOP |
| 记录内容 | IP + 数据地址 + 延迟 | 分段:Fetch(取指) 和 Op(执行) 两类采样 |
| 统计特性 | 事件驱动(cache miss 多→样本多) | 均匀随机采样(每条指令被采概率相等) |
| 适用场景 | 分析特定微架构事件的热点 | 均匀覆盖所有指令,适合找"整体瓶颈" |
# AMD IBS 采样
perf record -e ibs_fetch/period=100000/ -e ibs_op/period=100000/ ./a.out
perf report
七、PMU 和虚拟化:vPMU
7.1 虚拟机里能用 PMU 吗?
云服务器和容器里跑 perf stat,能不能读到硬件 PMU?分三层:
| 环境 | PMU 可用性 | 说明 |
|---|---|---|
| 物理机 / 裸金属 | ✅ 完全可用 | 直接操作 MSR |
| 容器 | ✅ 取决于 perf_event_paranoid | 不改 /proc/sys/kernel/perf_event_paranoid 只能用用户态事件 |
| KVM 虚拟机 | ⚠️ 需显式开启 | 通过 vPMU 虚拟化,性能有折损 |
| 公有云 VM | ❌ 通常不可用 | 云厂商默认关闭 vPMU(安全+性能考量) |
7.2 vPMU 的原理
虚拟机里的 perf 无法直接操作物理 MSR——KVM 需要拦截并模拟 MSR 读写:
Guest perf 设 EVTSEL0 → 写 MSR 0x186
        ↓
VM-Exit(KVM 拦截)
        ↓
KVM 判断:这个虚拟机开 vPMU 了吗?
  ├─ 开了 → 映射到物理 PMU 计数器(或软件模拟)
  └─ 没开 → 注入 #GP 异常 → perf_event_open 失败
关闭 vPMU 是云厂商的常见策略——减少 VM-Exit 开销 + 防止 PMU 侧信道攻击。
八、PMU 的硬件限制与坑
8.1 Counter Aliasing(计数器混叠)
在 §一~§四里看到的情况:dTLB-load-misses 计数器在特定 CPU 上值严重偏小(实际数百万次 miss 只计到 831)。
原因:某些 CPU 微码(microcode)对特定事件使用同一组内部信号线,当多个事件共享同一个硬件资源时发生 counter aliasing——计数器读数不准确。
对策:
- 不用有 aliasing 的事件,改用子事件(如用
stlb_hit+miss_causes_a_walk代替dTLB-load-misses) - 用
perf stat -e xxx:u加:u后缀切换到用户态专用计数器(有时避开 aliasing)
8.2 计数器数量不足
当同时监控的事件数超过可编程计数器数量时:
| CPU 代 | 可编程计数器 | 固定计数器 | 同时可用事件数 |
|---|---|---|---|
| Skylake | 4 | 3 | 7 |
| Ice Lake | 8 | 4 | 12 |
| Sapphire Rapids | 8 | 4 | 12 |
| AMD Zen 3/4 | 6 | 0 | 6 |
perf 的 multiplexing(时分复用) 可以在事件数 > 计数器数时轮流计数,但每个事件的精度会下降:
perf stat -e cycles,instructions,cache-misses,cache-references,branches,branch-misses,L1-dcache-loads,L1-dcache-load-misses ./a.out
# 如果只有 4 个 GPCTR,perf 会自动 multiplexing
# 输出中会出现 "(scaled from xx%)" 表示精度损失
8.3 Hyper-Threading(SMT)下的 PMU
启用超线程时,两个逻辑核共享同一套物理 PMU 计数器。PMU 硬件可以配置为:
- Per-thread 计数:每个逻辑核独立计数(perf 默认行为)
- Per-core 计数:两个逻辑核合并计数
大多数情况下 per-thread 是正确选择。但在高负载 SMT 场景下,如果另一个逻辑核也在跑热点代码,共享硬件资源(L1/L2/TLB)上的事件会被两个线程交叉干扰,使单个线程的 PMU 数据难以归因。
九、常见 PMU 事件速查
9.1 核心计算类
| 事件 | 含义 | 诊断 |
|---|---|---|
instructions | 退休指令数 | IPC = instructions / cycles |
cycles | 非停机 cycle 数 | 越高越忙 |
ref-cycles | 固定频率 cycle(不受 Turbo 影响) | 判断 CPU 是否 boost 了 |
stalled-cycles-frontend | 前端停顿(等取指/译码) | 高 → I-cache miss / 分支预测差 |
stalled-cycles-backend | 后端停顿(等内存/执行资源) | 高 → cache miss / 内存瓶颈 |
9.2 缓存类
| 事件 | 含义 |
|---|---|
cache-references | 最后一级缓存(LLC)访问次数 |
cache-misses | 最后一级缓存未命中次数 |
L1-dcache-loads / L1-dcache-load-misses | L1 数据缓存 Load 及 Miss |
L1-icache-load-misses | L1 指令缓存未命中 |
dTLB-load-misses | 数据 TLB miss |
l2_rqsts.miss | L2 缓存 miss |
9.3 分支与乱序
| 事件 | 含义 |
|---|---|
branches | 分支指令总数 |
branch-misses | 分支预测失败数 |
branch-load-misses | 间接分支(函数指针/virtual call)预测失败 |
uops_retired | 退休微操作数 |
uops_executed | 执行微操作数(含推测执行) |
9.4 Uncore 类(型号依赖)
| 事件 | 含义 |
|---|---|
uncore_imc/cas_count_read/ | 内存读次数 |
uncore_imc/cas_count_write/ | 内存写次数 |
uncore_cbox/event=0x1,umask=0x1/ | L3 命中的 cache line 数 |
uncore_upi/tx_flits/ | UPI 发送 flit 数 |
十、PMU 与 Linux 软件栈的关系
PMU 只是硬件。用户通过 Linux 的 perf_events 子系统访问它:
                          用户空间
┌──────────────────────────────────────────────┐
│  perf 工具     libperf / PAPI    自定义工具   │
│  (stat/record)   (编程接口)    (perf_event_open) │
└──────────────────┬───────────────────────────┘
                   │ perf_event_open(2)
                   │ read() / mmap()
┌──────────────────▼───────────────────────────┐
│         Linux 内核 perf_events 子系统          │
│  · 计数器分组 & 调度 (multiplexing)            │
│  · PMI/NMI handler → 写环形缓冲区              │
│  · 权限控制 (perf_event_paranoid)              │
│  · vPMU 虚拟化支持                             │
└──────────────────┬───────────────────────────┘
                   │ MSR 读写 (rdmsr/wrmsr)
                   │ PMI → 通过 LAPIC → NMI
┌──────────────────▼───────────────────────────┐
│            CPU 硬件 PMU + Uncore PMU           │
│  · 固定计数器 (FIXED_CTR0~3)                   │
│  · 可编程计数器 (GPCTR0~7) + EVTSEL0~7         │
│  · PEBS buffer (Intel) / IBS (AMD)            │
└──────────────────────────────────────────────┘
软件侧详细机制见 perf-internals。
十一、一句话总结
PMU 是 CPU 芯片内部的一组硬件性能计数器(固定 + 可编程 × N),通过 Event Code + UMASK 选择要数的事件,计数器溢出触发 NMI 中断实现采样(perf record),Intel 的 PEBS 和 AMD 的 IBS 提供精确 IP 和访存延迟。perf 通过 perf_event_open(2) 操作 MSR 来配置 PMU,是硬件观测能力在用户态的唯一标准化入口。