缓存写策略
更新时间:2026-10-24。读缺失好理解,写命中/写缺失时数据放哪、何时下发,决定写带宽和一致性复杂度。
本篇是缓存簇里讲「写」的一篇。缓存簇的读路径相对单纯——命中直接用,缺失去下层取;写路径却藏着一组两两正交的决策:写命中时是只写缓存还是连下层一起写?写缺失时要不要先把行装入缓存? 这两组决策组合出真实硬件的全部写行为。本篇上接 缓存替换策略(被踢出的脏行怎么收场正是写策略的事),多核下脏行还要过 MESI 的一致性关。
本文要回答的问题
- write-through 和 write-back 各牺牲了什么?
- dirty 位到底省了什么事?
- write-allocate 与写策略怎么搭配才合理?
- write buffer 是干什么的,没有它会怎样?
- 这些策略组合在真实硬件上长什么样?
一、写命中两条路:write-through vs write-back
CPU 执行一条 store,地址命中 L1 的某一行。接下来有两个截然不同的选择:
- write-through(写穿):每次写都同时更新缓存行和下一层(L2 或内存)。缓存里永远不会有「比下层新」的数据。
- write-back(写回):只更新缓存行,顺手把这一行的 dirty 位(脏标记)置 1;下层数据暂时是旧的。等这行被替换策略踢出去时,才把它整体写回下层。
两者差别用一次循环写数组就能感受到:一个 4KB 的数组反复原地累加 1000 次,write-back 下全部写都落在 L1 里,一次都不碰 L2;write-through 下 1000 次写全部穿到 L2,L1 与 L2 之间的带宽被白白吃掉。
读这张图抓一个不对称:左路的箭头是每次写都发生,右路的箭头是每行至多发生一次。一个被反复写的行,write-back 把 N 次写折叠成 1 次回写——这就是它省带宽的全部机理,代价是缓存与下层之间出现了一个「缓存新、下层旧」的时间窗,一致性复杂度全部来自这个窗口。
二、dirty 位与回写时机
write-back 的每行元数据里多一个 dirty 位。它的作用是在替换时刻做一道分流:
- 行被踢出时 dirty=0(干净行):直接丢弃,一个字都不用写。
- dirty=1(脏行):先写回下层,再让位给新行。
这道分流很重要——程序里大量缓存行是只读的(代码、常量、只读数据),干净行踢出零开销;只有真正被改过的行才付回写成本。这也是为什么 缓存替换策略 里「踢谁」和本篇「踢的时候做什么」是两篇:前者选牺牲者,后者决定牺牲者的葬礼规格。
回写还有一个隐蔽代价:踢出脏行的那次缺失变慢了。普通读缺失只需「取新行」;踢中脏行时是「先写旧行、再取新行」两个事务串行,延迟几乎翻倍。连续踩中一串脏行时,缺失延迟会出现可见的毛刺。
三、写缺失:装不装入(allocate)
写缺失时缓存手里连这一行都没有,这时第二个决策登场:
- write-allocate(写分配):先把整行从下层装入缓存,再在缓存里完成写。后续对同一行的写就直接命中了。
- no-write-allocate(写不分配,也叫 write-around):跳过缓存,直接把数据写到下层,缓存不装入。
两个维度正交,理论上四种组合,工程上合理的只有两种主流搭配:
| 组合 | 合理性 | 典型场景 |
|---|---|---|
| write-back + write-allocate | 主流。装入后连续写全部命中,写流量留在缓存层 | 现代 CPU 的 L1/L2/LLC |
| write-through + no-write-allocate | 反正每次写都要穿下去,装入意义有限;实现最简 | 简单微控制器、部分 L1 |
| write-through + write-allocate | 罕见但存在(早期 x86 L1):装入为了后续读命中 | 读多写少的老设计 |
| write-back + no-write-allocate | 别扭:后续写仍不命中,write-back 的折叠优势拿不到 | 基本无人用 |
读这张表抓住「搭配错」的那一行:write-back 的全部价值在于「同一大行被写多次时折叠成一次回写」,如果写缺失不装入,每次写都直奔下层,等于缴了 write-back 的复杂度学费却没拿到收益。这就是为什么现代通用 CPU 几乎清一色 write-back + write-allocate。
四、write buffer:write-through 的救生圈
write-through 有个显而易见的问题:每次 store 都要等下层写完成吗?如果真等,store 的延迟从 L1 的几个周期暴涨到 L2 的十几周期甚至内存的上百周期,流水线天天堵车。
答案是不等——写一个 write buffer(写缓冲):store 把「地址+数据」丢进这个队列就算完成,由它在后台慢慢把数据穿到下层。CPU 只在 buffer 满时才停顿。
write buffer 也带来一个经典坑:自己写的数据,紧接着自己读,可能读到旧值——读请求查缓存不命中,去下层取,而真正的最新值还躺在 write buffer 里没下去。所以 write buffer 必须支持 store-to-load forwarding(写读转发):读路径先嗅探 buffer,命中就直接用 buffer 里的值。
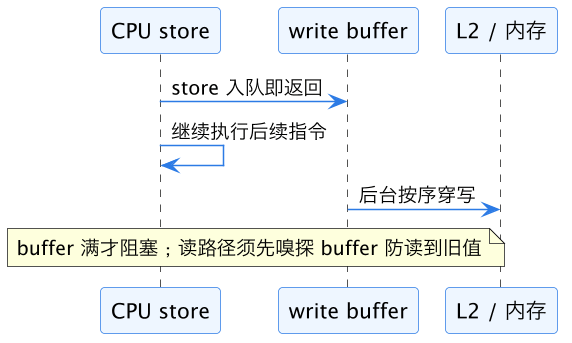
这张时序图的关键在「入队即返回」那一步:store 的可见延迟被固定在 buffer 入队的开销上,与下层延迟解耦。代价是 buffer 深度有限(通常几十项),突发写超过深度照样堵;以及多核场景下「自己的写何时对别人可见」变得微妙——那已经是内存序的地界,见 store-buffer。
五、写放大与 write combining
write-back 以整行(64B)为粒度回写。如果程序只改了行里的 4 个字节,回写照样是整行 64B——写放大 16 倍。对普通缓存这不是问题(行内其他字节迟早也可能被写),但对某些路径是真痛点:GPU 显存、持久内存(PMEM)上,部分更新的行反复整行回写会显著吃掉有效带宽。
反方向的优化也存在:write combining(写合并)。对标记为 WC 的内存区域(典型是显存映射区),CPU 把多次对部分字节的写先攒在合并缓冲里,凑满一整行再一次突发写出。条件是程序按地址顺序连续写——乱序写会把 buffer 提前冲掉,合并失败,性能反而更差。
六、真实硬件速览
| 层级/设备 | 写命中 | 写缺失 | 备注 |
|---|---|---|---|
| x86 L1 D-cache | write-back | write-allocate | 早期奔腾 L1 曾是 write-through |
| x86 L2/LLC | write-back | write-allocate | 多级都是写回,靠 MESI 管一致性 |
| ARM Cortex-A 系 | write-back | write-allocate | 部分核可配置 |
| 简单 MCU 缓存 | write-through | no-write-allocate | 面积和验证优先 |
| 显存映射区 | write combining | — | 顺序整行写才有效 |
可以看到一条清晰的分界线:算力越贵、越在乎带宽的地方越 write-back;面积/验证预算越紧的地方越 write-through。没有谁是绝对正确,只有预算表上的取舍。
七、常见坑
- 混淆写命中策略与写缺失策略。write-through/write-back 回答「命中时写哪」,write-allocate/no-write-allocate 回答「缺失时装不装」,是两个正交维度,两两搭配才构成完整策略。
- write-through 不配 write buffer。没有 buffer 的写穿等于每次 store 都吃下层全延迟,流水线直接瘫痪。
- 忘记读路径要嗅探 write buffer。不自查就会「刚写的值读不回来」,这是最经典的硬件 bug 温床之一。
- write-back 脏行与一致性回写处理遗漏。脏行被踢、被其他核嗅探(见 MESI 机制篇)都必须先回写或转发,漏一处就是数据损坏。
这一篇在知识体系里的位置
本篇与同簇的 替换策略 LRU 是一体两面:替换选出牺牲者,写策略决定牺牲者(脏行)怎么回写。多核下脏行的可见性由 MESI 保证;store 何时对其他核可见则进入内存序领域,见 store-buffer;再往下是 缓存组织 里 dirty 位等行元数据的物理实现。
总结
写命中分两条路:write-through 每次都穿写到下层、一致性简单但费带宽、必须配 write buffer 吸收延迟;write-back 只更新缓存并置 dirty 位、等行被替换时才一次回写,把 N 次写折叠成一次,省带宽却要维护脏位、回写时机与一致性。写缺失则要选 write-allocate(先装入再写,与 write-back 是黄金搭档)还是 no-write-allocate(直写下层,常配 write-through);搭配错(如 write-back + no-allocate)会让后续写享受不到缓存,等于白付复杂度学费。