I/O 编址 —— CPU 怎么"找到"外设寄存器
你说"向网卡的控制寄存器写一个值",CPU 在硬件层面怎么知道这个寄存器在哪?是专用的 I/O 指令去访问,还是像访问内存一样用
mov就行?这就是 I/O 编址 要回答的问题。从 8086 时代延续至今的端口映射 I/O(IN/OUT 指令),到现代 PCIe 设备统一使用的内存映射 I/O(MMIO),再到 CPU 一条mov指令如何穿过 Store Buffer、Root Complex 最终变成 PCIe TLP 包——本篇一次性讲清楚。
相关:PCIe 总线细节见 pcie,DMA 原理见 dma,8259 的中断寄存器编址实例见 8259,8237 的 DMA 寄存器编址实例见 dma-8237,CPU 写操作在硬件层面的完整链路见 memory-order。
零、一句话结论
CPU 访问外设有两种编址方式:
| 方式 | 指令 | 地址空间 | 代表设备 |
|---|---|---|---|
| PMIO(Port-Mapped I/O,端口映射) | x86 专用 IN/OUT 指令 | 独立 64KB I/O 空间 | 8259 PIC、8237 DMA、古老的键盘控制器 |
| MMIO(Memory-Mapped I/O,内存映射) | 普通 mov 加载/存储 | 物理内存地址空间的一部分 | PCIe 所有设备(网卡/NVMe/GPU/FPGA) |
现状:x86 还保留 PMIO 用于兼容老设备(8259、LAPIC),但所有现代 PCIe 设备全是 MMIO。ARM/RISC-V 从一开始就没设计 I/O 空间,天生只有 MMIO。
一、PMIO:端口映射 I/O
1.1 独立的 I/O 地址空间
8086 设计之初给了两类地址空间:
物理地址空间:
  ┌─────────────────────┐  0x00000000
  │                     │
  │   内存地址空间       │  CPU 用 mov 指令访问
  │   (DRAM、ROM)       │
  │                     │
  ├─────────────────────┤  物理内存上限
  │                     │
  │   MMIO 设备映射区   │  ← 后期才出现的
  │                     │
  └─────────────────────┘
  ┌─────────────────────┐  0x0000
  │                     │
  │   I/O 地址空间       │  CPU 用 IN/OUT 指令访问
  │   64KB (0~0xFFFF)   │  与内存地址空间**完全独立**
  │                     │
└─────────────────────┘ 0xFFFF关键:0x0060 这个数字,在内存地址空间里是一块 RAM,在 I/O 地址空间里是键盘控制器数据端口——两个空间物理上不重叠,靠 CPU 的 M/IO# 引脚信号区分。地址总线上的值一样,但 CPU 拉高或拉低 M/IO# 这根线,芯片组就知道该路由到内存还是 I/O 设备。
1.2 x86 IN/OUT 指令
; 读 I/O 端口 0x60(键盘数据寄存器)→ AL
IN  AL, 0x60
; 写 0x20 到 I/O 端口 0x20(8259 主片 ICW1 寄存器)
MOV AL, 0x20
OUT 0x20, AL
; 16 位 I/O 读
IN  AX, DX        ; DX 存端口号(0~0xFFFF)
; 32 位 I/O 读(386+)
IN EAX, DX硬件层面发生了什么:
IN AL, 0x60
  1. CPU 把 0x0060 放到 16 位地址总线
  2. CPU 把 M/IO# 信号拉低 = "这次访问的是 I/O 空间"
  3. 芯片组(南桥/PCH)解码:0x0060 → 键盘控制器
  4. 键盘控制器把数据放到数据总线上
  5. CPU 读入 AL
核心:PMIO 依赖一根独立的 M/IO# 引脚(现代 CPU 已经不用这根物理引脚了,但语义保留在总线协议如 DMI/PCIe 的 TLP 类型字段里)。
1.3 经典 PMIO 设备速查
| 设备 | I/O 端口范围 | 典型端口 |
|---|---|---|
| 8259 PIC 主片 | 0x20–0x21 | 0x20(ICW1/OCW2/OCW3),0x21(ICW2-4/OCW1/IMR) |
| 8259 PIC 从片 | 0xA0–0xA1 | 0xA0(命令),0xA1(数据/IMR) |
| 8237 DMA 控制器 | 0x00–0x0F(主片),0xC0–0xDF(从片) | 0x00(CH0 基地址),0x08(命令寄存器) |
| 键盘控制器(8042) | 0x60–0x64 | 0x60(数据),0x64(状态/命令) |
| PIT 8254 定时器 | 0x40–0x43 | 0x40(CH0 计数),0x43(控制字) |
| CMOS/RTC | 0x70–0x71 | 0x70(索引),0x71(数据) |
| LAPIC(传统模式) | 0xFEE00000 起 | 虽然是 MMIO 地址但早期也用 IN/OUT 路径配置 |
/proc/ioports可以看到当前系统已经分配出去的 I/O 端口范围。
1.4 PMIO 的局限性
- 地址空间太小:64KB,现代网卡一个 BAR 就可能要 16MB MMIO 空间
- 指令带宽低:IN/OUT 本质上是不可缓存的串行化指令,每次只能搬 1/2/4 字节,开销大到发指
- 没法用乱序执行:IN/OUT 是序列化指令,CPU 流水线要排空才能执行
- 不跨架构:ARM/RISC-V 根本没有 I/O 空间这个概念
- 不方便 DMA:DMA 引擎没法用 IN/OUT 去读设备,它只能访问"内存地址空间"
二、MMIO:内存映射 I/O
2.1 原理
把设备寄存器映射到物理内存地址空间的某个区域。CPU 想读写设备寄存器时,直接用 mov 指令像访问普通内存一样去读写那个地址。
CPU 不知道也不关心这个地址背后是 DRAM 还是设备寄存器——地址路由由芯片组/PCIe Root Complex 负责。
物理地址空间(统一视图):
  ┌─────────────────────┐  0x00000000
  │  DRAM               │
  │  (0x00000000~)      │
  ├─────────────────────┤  top of low memory
  │                     │
  │  MMIO 区域          │  设备寄存器映射在这里
  │  ├─ 0xF0000000: GPU │  CPU 用 mov 读写
  │  ├─ 0xF2000000: NIC │
  │  └─ 0xF4000000: NVMe│
  │                     │
  ├─────────────────────┤  0xFFFFFFFF
2.2 PCIe BAR:谁来分配这些地址
BAR = Base Address Register,存在 PCIe 设备的配置空间里。启动时:
- 设备在 BAR 里写一个全 F 值,告诉 BIOS/OS "我需要多大 MMIO 空间"
- BIOS/OS 读回 BAR,发现低若干位固定为 0(比如低 12 位为 0 = 需要 4KB),算出大小
- BIOS/OS 在物理地址空间的 MMIO 区域分配一段连续地址,写回 BAR
- 之后所有发往这个地址区间的内存访问,都会由 Root Complex 转发到这个设备
BAR 分配示意:
  Root Complex
      │
      ├─ → Switch → GPU      MMIO: 0xF0000000~0xF0FFFFFF (16MB)
      │             BAR0 = 0xF0000000
      │
      ├─ → Switch → NIC      MMIO: 0xF2000000~0xF2003FFF (16KB)
      │             NVMe     MMIO: 0xF4000000~0xF4003FFF (16KB)
/proc/iomem可以看 MMIO 分配情况;lspci -vvv的Memory at ...行就是 BAR 值。
2.3 MMIO 为什么比 PMIO 好
| 维度 | PMIO | MMIO |
|---|---|---|
| 指令 | 专用 IN/OUT | 普通 mov(加载/存储) |
| 地址空间 | 独立 64KB | 和物理内存共享 |
| 数据宽度 | 1/2/4 字节 | 1/2/4/8/16/32 字节(取决于 CPU 指令和是否对齐) |
| 缓存 | 不可缓存 | 可通过 PAT/MTRR 标记为 UC/WC/WB |
| 乱序执行 | 序列化指令(排空流水线) | 一般可以乱序(取决于内存类型) |
| DMA | 不能 | 能(DMA 引擎访问的就是 MMIO 地址) |
| 跨架构 | x86 专属 | 所有架构通用 |
三、一条 CPU 写指令如何变成 PCIe TLP 包
这是本篇的核心问题:CPU 执行 mov [BAR_addr], value 时,硬件层面发生了什么?
3.1 端到端时序
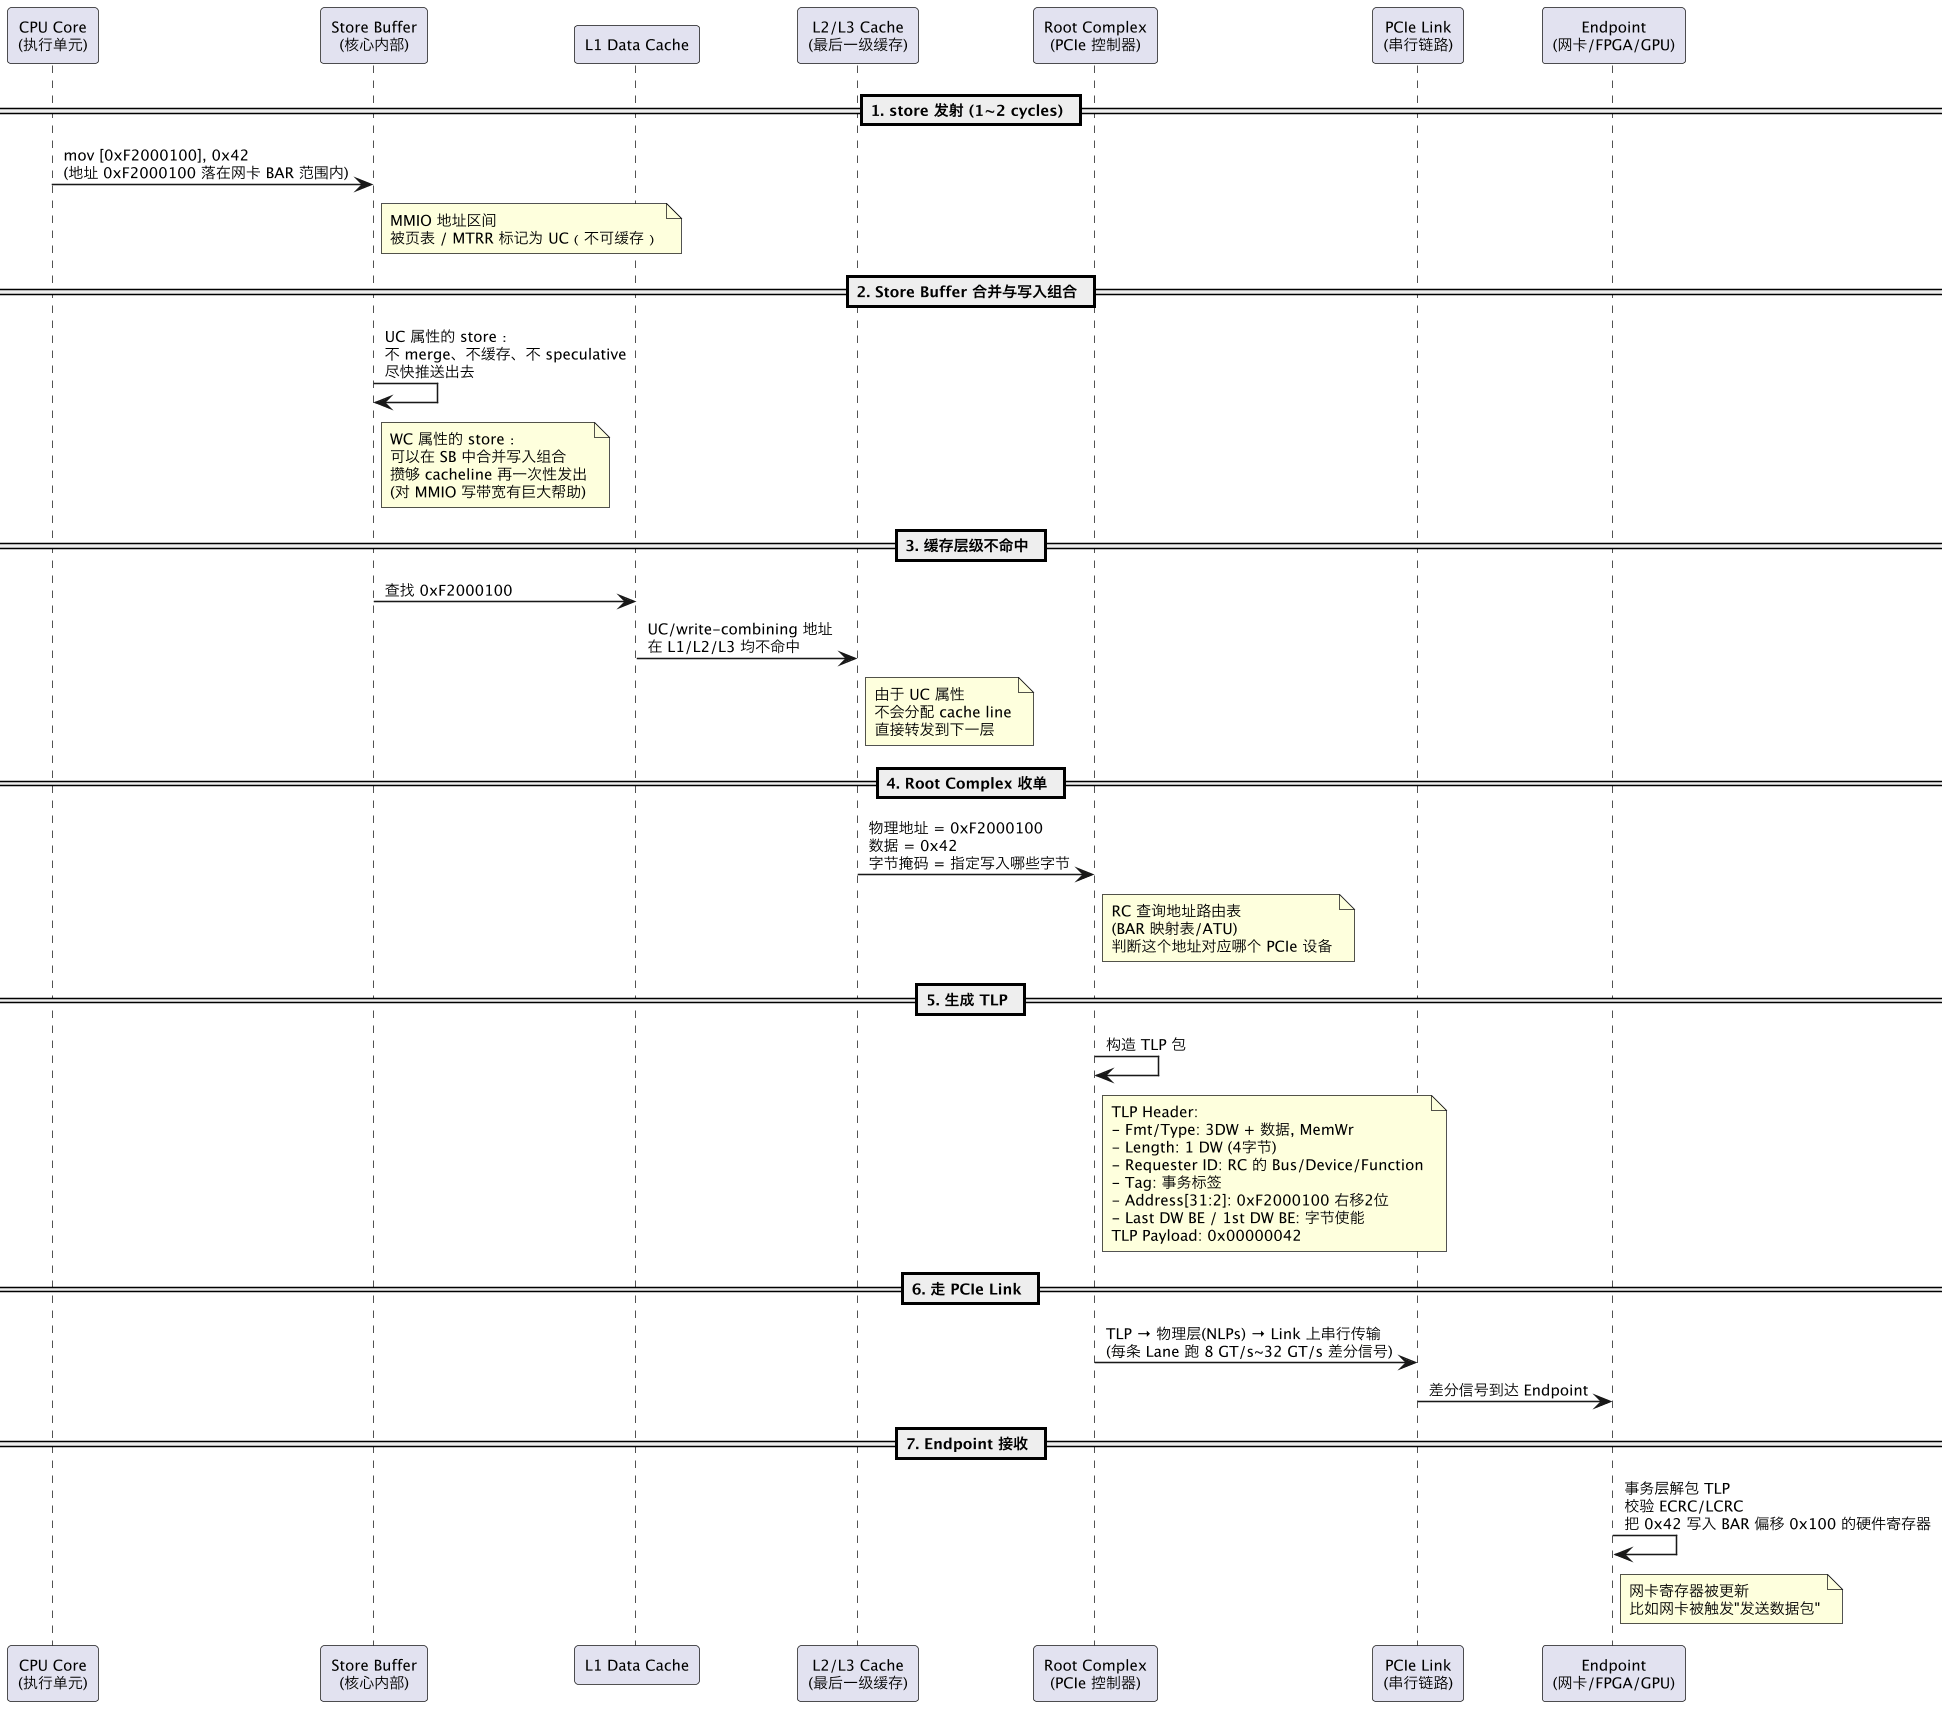
3.2 关键机制:Store Buffer + 写入组合
为什么 CPU 可以在写的时候就转成 TLP,而不需要等显式"flush"指令?
答案在于 Store Buffer + 内存类型属性(PAT/MTRR) 的组合:
1. MMIO 映射时,页表条目被标记为 UC (Uncacheable) 或 WC (Write-Combining)
   - UC:每一笔 store 立即推送,不强求合并,保证严格的写顺序
   - WC:多笔连续的 store 可以先在 Store Buffer 里攒成一条 burst,再整条发出去
2. 对于 UC 地址:
   - 执行 mov 后,结果进入 Store Buffer
   - Store Buffer 尽快退休 (retire),退休后立即可见
   - 从 L1 查询开始一路不命中,直到 Root Complex 接管
   - Root Complex 发现目标地址在 PCIe 域 → 直接组 TLP
3. 对于 WC 地址:
   - 多笔 store 在 Store Buffer 里合并(同 cacheline 的连续写入)
   - 合并结果一次性作为单条 TLP 发出去,吞吐远高于一条一条发
- 典型场景:framebuffer 写入、FPGA 寄存器批量配置核心要点:整个过程中 CPU Core 执行 mov 的语义和写普通内存一模一样。地址路由是被动的——Store Buffer 只管把物理地址和数据推出去,芯片组/Root Complex 负责认出"这是 PCIe 设备的地址"并组建 TLP。CPU 核心不需要知道 TLP 的存在。
3.3 MMIO 写是 "Posted Write"
PCIe TLP 的 Memory Write(MemWr)是 Posted 事务——发送方发出去后不需要等接收方的完成响应就认为"这笔写已经做了":
Posted Write(MemWr):
  CPU                RC                Endpoint
  │                   │                    │
  │  mov [BAR], 42    │                    │
  │──────────────────→│                    │
  │                   │   TLP MemWr        │
  │                   │───────────────────→│  ← 不需要 Completed TLP 回应
  │  ← mov 指令 retire │                    │
  │                   │                    │  设备收到,更新寄存器
  │                   │                    │
│ CPU 继续执行... │ │对比:MMIO 读(MemRd)是 Non-Posted 事务,RC 发 TLP 后必须等 Endpoint 回 Completion TLP 带数据回来。这就是为什么 MMIO 读比写慢几个数量级——一次 MMIO 读可能花费 500~2000+ 个 CPU 周期(取决于 PCIe 往返延迟),而 MMIO 写可能只需几十个周期。
3.4 Store Buffer 不是为 MMIO 设计的,但恰好兼容
Store Buffer 本身是为 CPU 写穿透+缓存一致性 设计的,不是专门为 MMIO 设计。但它恰好为 MMIO 写→TLP 转换提供了天然的"窗口":
- CPU 发出 store → 进入 Store Buffer(由内存序模型控制何时对别人可见)
- 如果是 UC/WC 地址 → Store Buffer 把它尽快排空到缓存层级
- 缓存层级不认识这个地址 → 一路往下掉,直到 Root Complex
- Root Complex 认识这个地址 → 翻译成 PCIe TLP
没有 SB:CPU 需要等这个写"物理上完成"(即 TLP 送达设备),那 mov 的延迟就是 PCIe 往返延迟,性能噩梦。
四、MMIO 读和写的实际延迟
4.1 为什么 MMIO 读这么慢
MMIO 读(Non-Posted)时间线:
  T0: CPU mov rax, [BAR]          ← 执行单元发出
  T1: Store Buffer 不参与(读)    ← load queue 排队
  T2: L1 miss → L2 miss → LLC miss ← MMIO 地址不缓存
  T3: RC 收到读请求
  T4: RC 构建 MemRd TLP           ← 组包
  T5: TLP 穿过 PCIe Link         ← 串行传输延迟 (~100ns)
  T6: Endpoint 收到,取寄存器值   ← 设备响应
  T7: Endpoint 发 Completion TLP  ← 带数据回来
  T8: Completion TLP 穿过 Link    ← 再走一次串行
  T9: RC 收到 Completion,数据给 CPU
  总延迟:~500~2000+ cycles (Gen3 x16, ~300ns 往返)
4.2 MMIO 写为什么快
MMIO 写(Posted)时间线:
  T0: CPU mov [BAR], 42
  T1: 进入 Store Buffer → retire
  T2: 推到缓存层级 → 一路 miss → RC
  T3: RC → MemWr TLP → 串行发送
  CPU 端结束 (tens of cycles)
为什么写快?因为 Posted —— 发了就走,不等确认。代价是如果途中出错(比如链路断了),CPU 不知道。
五、两种编址在现有文档中的实例
| 设备 | 编址方式 | 关键端口/BAR | 细节在哪 |
|---|---|---|---|
| 8259 PIC | PMIO | 0x20/0x21(主片),0xA0/0xA1(从片) | 8259 的 ICW/OCW 编程 |
| 8237 DMA | PMIO | 0x00–0x0F(主片),0xC0–0xDF(从片),页面寄存器 0x80–0x8F | dma-8237 的寄存器编程 |
| LAPIC(传统) | PMIO+MMIO | 0xFEE00000(MMIO 重映射) | irq-affinity |
| I/O APIC | MMIO | 固定的 MMIO 基地址 | irq-affinity |
| 现代 PCIe 网卡 | MMIO | BAR0 通常 16KB~128KB | pcie 的 BAR 空间 |
| 现代 NVMe 控制器 | MMIO | BAR0 通常 8KB(控制器寄存器) | pcie |
| LAPIC(x2APIC) | MSR | MSR 0x800–0xBFF(不是 I/O 编址,是 MSR 寄存器空间) | irq-affinity |
六、为什么现代体系转向全 MMIO
PMIO 是 8086 时代的遗产,当时内存只有 640KB,地址线只有 20 根,64KB I/O 空间绰绰有余。四十年后的今天:
- 地址空间需求暴增:一个 GPU 的 MMIO 空间就可能到 256MB,PMIO 的 64KB 连一个设备都装不下
- 跨架构统一:ARM/RISC-V 从一开始就没设计 I/O 空间,OS 和驱动用同一套
ioremap+readl/writelAPI 就够了 - 写入组合性能:WC 内存类型的 store 合并 + burst TLP 发出,MMIO 写带宽远超 PMIO 的 OUT 指令
- DMA 统一:DMA 引擎只能访问"内存地址空间",如果设备寄存器在 PMIO 空间,DMA 引擎就没法碰它们
- 虚拟化友好:MMIO 地址可以走 EPT/NPT 二级页表翻译,PMIO 的 IN/OUT 必须由 VMM 模拟(VM Exit → VM Entry),开销巨大
x86 之所以还保留 PMIO,纯粹是为兼容 8086/PC-AT 时代的老设备(8259、8237、PIT、键盘控制器)——这些设备在现代主板 PCH 里变成了"软模拟"的兼容逻辑,但 IN/OUT 指令和端口号依然有效。
七、总结
| 问题 | 答案 |
|---|---|
| CPU 怎么找到外设寄存器? | PMIO 用 IN/OUT + 独立 I/O 空间,MMIO 用 mov + 统一物理地址空间 |
| 现代 PCIe 设备用哪种? | 全是 MMIO(BAR 映射到物理地址空间) |
| mov BAR 怎么写进 TLP 包? | Store Buffer → 缓存 miss(UC 地址)→ 推送到 Root Complex → RC 根据地址路由表查出目标设备 → 组 MemWr TLP → 发到 PCIe Link |
| 为什么 mov 写完不卡? | MMIO 写是 Posted 事务——发了 TLP 不等 Completion,指令 retire 后 CPU 继续跑 |
| 为什么 MMIO 读这么慢? | MMIO 读是 Non-Posted——必须等 Endpoint 回 Completion TLP |
| PMIO 还用吗? | x86 保留给 8259/LAPIC 等老设备,ARM/RISC-V 从不用 PMIO |
总结
CPU 找外设寄存器有两条路:PMIO 用 IN/OUT 指令走独立的 64KB I/O 空间,MMIO 用普通 mov 走统一物理地址空间,现代设备(PCIe 网卡/NVMe,BAR 映射)全是 MMIO。性能上 MMIO 写是 Posted 事务——发出 TLP 不等 Completion,指令 retire 后 CPU 继续跑所以不卡;MMIO 读是 Non-Posted,必须等 Endpoint 回 Completion,因此慢。现代体系全面转向 MMIO 的原因是地址空间需求暴增(GPU 的 MMIO 可达 256MB,PMIO 装不下)、跨架构统一(ARM/RISC-V 本无 I/O 空间)、WC 写合并带宽高、DMA 只能访问内存地址空间、以及 MMIO 可走 EPT/NPT 二级页表虚拟化而 PMIO 的 IN/OUT 必触发 VM Exit。x86 保留 PMIO 纯粹为兼容 8259/8237 等老设备。