AddressSanitizer (ASan) 的原理 —— 编译期插桩的内存错误猎手
崩溃排查主线的"提前防御"环节。事后看 core(core-dump)是"死了再验尸";ASan 是在错误发生的那一刻就抓现行,精确报出错误类型、内存地址、分配栈和访问栈。属于内存/线程错误检测器三兄弟之一:ASan 抓内存访问错误、TSan 抓数据竞争、Valgrind 无需重编译但慢。
一、ASan 是什么、解决什么
AddressSanitizer(简称 ASan)是 GCC / Clang 内置的内存错误检测器,编译时加上 -fsanitize=address 即可开启。它的核心手段是编译期插桩(instrumentation):编译器在生成机器码时,往每一次内存读写前面插入一小段检查代码,运行时实时判断这次访问是否合法。
它能抓的错误类型:
| 错误类型 | 英文 | 典型场景 |
|---|---|---|
| 堆越界 | heap-buffer-overflow | malloc(8) 后访问第 9 个字节 |
| 栈越界 | stack-buffer-overflow | 局部数组 int a[4] 访问 a[4] |
| 全局越界 | global-buffer-overflow | 越界访问全局/静态数组 |
| 释放后使用 | use-after-free | free(p) 后又读写 *p(悬垂指针) |
| 返回后使用 | use-after-return | 返回了局部变量的地址,函数返回后还在用 |
| 重复释放 | double-free | 同一块内存 free 两次 |
| 非法释放 | invalid-free | free 一个非 malloc 返回的指针 |
| 内存泄漏 | memory leak | 由内置的 LeakSanitizer (LSan) 负责,进程退出时报未释放的块 |
应用内存的堆、栈、全局各在进程地址空间的哪个位置,见 memory-layout。ASan 对这三个区域用的手段略有不同(堆靠 redzone、栈靠编译器改写栈帧、全局靠改写全局变量布局),但判定机制统一走 shadow memory。
和 core dump 的分工:很多内存错误(越界、UAF)不一定当场崩,可能踩坏了别处的数据,过很久才在一个"无辜"的地方触发 SIGSEGV/SIGABRT——这时 core 里的调用栈指向的是"受害者"而非"凶手"。ASan 则在第一次非法访问就叫停并打印凶案现场,把"隔了十万八千里才崩"的难题变成"当场抓现行"。
一句话:ASan = 编译期给每次内存访问装摄像头,越界/悬垂当场报警。
两个独立机制
ASan 的原理其实可以拆成完全独立的两件事,分开理解就清晰得多:
| 机制 | 是什么 | 谁干的 | 什么时候 |
|---|---|---|---|
| 记账系统(shadow memory) | 一块额外内存,把应用地址空间按 8:1 压缩映射,每字节记录"对应 8 字节能不能访问" | ASan 运行时库(进程启动时分配) | 进程启动 → 整个 shadow 初始为 0;之后随 malloc/free/栈帧进出而持续更新 |
| 检查员系统(插桩代码) | 编译器在每次内存访问(*p = ... / ... = *p)前面注入的检查逻辑:算 shadow 地址 → 读 shadow 字节 → 判断是否合法 | 编译器(-fsanitize=address) | 编译期注入到二进制;运行时每次内存访问都执行 |
二者的关系:插桩代码是"检察员",shadow memory 是"值班日志"。插桩代码自己不记录任何状态,它只做三件事:(addr>>3)+offset → 读 1 字节 → 判断 → 放行或报警。所有的"谁能访问、谁不能访问"的状态,全部由 ASan 运行时(通过接管 malloc/free、改写栈帧等)提前写进 shadow memory。
下面用一个序列图展示二者的分工——注意插桩代码只管"查","写"shadow 是 ASan 运行时的工作:
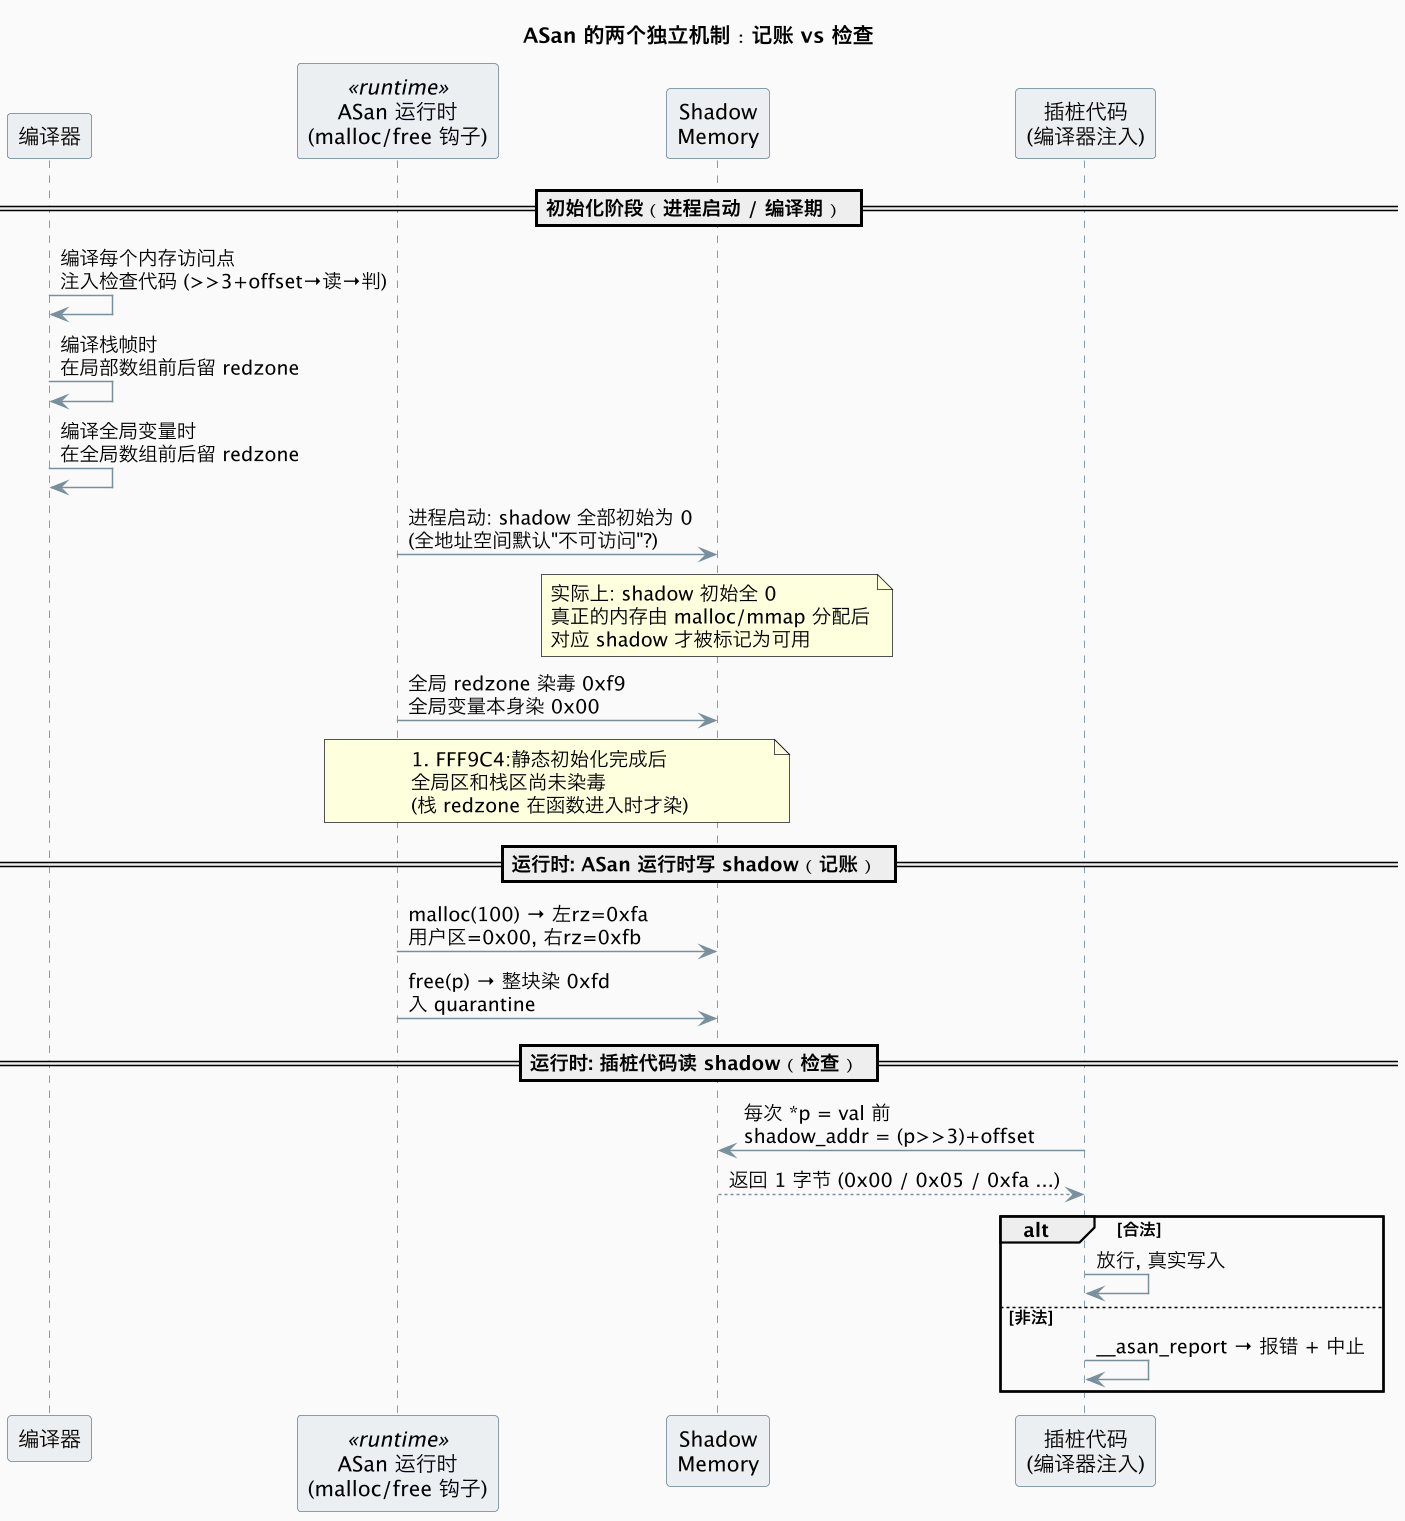
关键区分:shadow memory 的写入(红色区"染毒")全部由 ASan 运行时(malloc/free 钩子、栈帧入口/出口代码)负责,发生在内存分配/释放/栈帧切换时。shadow memory 的读取和判定由插桩代码负责,发生在每次内存访问时。写入低频、读取高频——这就是 ASan 设计成"快读取(>>3+offset)、慢写入(无妨)"的原因。
三种内存区域的 shadow 初始化策略
堆、栈、全局三种内存的 shadow 初始化和毒化时机各不相同:
| 内存区域 | 何时初始化 | 何时"上毒"(写 redzone) | 何时"解毒" |
|---|---|---|---|
| 堆 | malloc 调用时,ASan 钩子从实际分配器拿到原块后,立即写左右 redzone(0xfa/0xfb)和用户区(0x00) | 分配时 | free 时:整块染 0xfd 并进 quarantine;quarantine 淘汰时真正释放给分配器 |
| 栈 | 进程启动时 shadow 为该栈区域预留,但具体每帧的 redzone 在函数进入时由插桩代码写入(0xf1/0xf2/0xf3) | 函数进入(prologue)时 | 函数返回(epilogue)前,把本帧的 redzone 还原为 0x00("解毒",堆栈帧收回后内存可复用) |
| 全局 | 进程启动、main 之前,ASan 运行时遍历所有全局变量,在变量前后写 redzone(0xf9),变量本身写 0x00 | 程序启动时一次性 | 从不解毒——全局变量生命周期=进程生命周期 |
栈的"上毒/解毒"开销很小(只是写几个 shadow 字节),但频率极高(每次函数调用都做)。堆的"上毒"开销大一些(每块要写几十字节的 redzone shadow),但频率低(只在 malloc/free 时)。全局一次性搞定。
完整生命周期:一条链路走到底
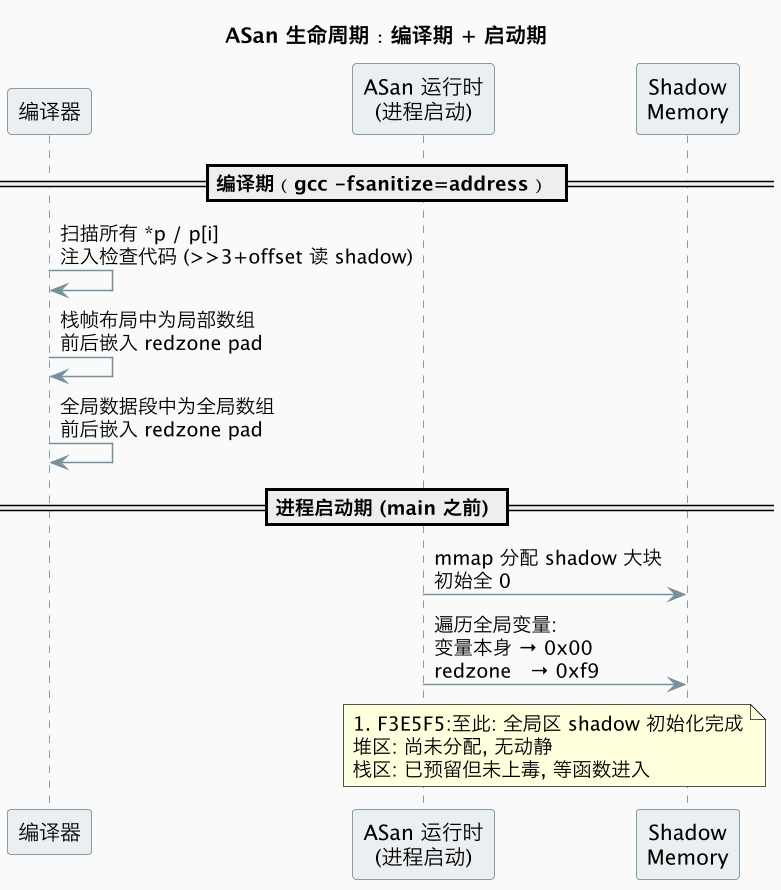
理解了"记账系统 + 检查员"的分离,再把它们放到一个进程从诞生到运行的时间轴上,整个 ASan 的原理就可以串成一条清晰的链路。
你的理解有一点需要修正:运行时每次内存访问的插桩代码只读 shadow、不写 shadow。shadow 的"写"全部发生在生命周期的关键节点(进程启动、malloc、free、函数进入/返回),由 ASan 运行时或编译器生成的栈帧代码负责。下面按时间顺序走一遍:
第一步:编译期 —— 编译器注入检查代码
编译 -fsanitize=address 后,编译器对源码里每一处 *p = ... 和 ... = *p 做一件事:在真实内存读写指令前面,插入一段"先查 shadow、再真访问"的检查代码。这段代码逻辑固定:
shadow_addr = (addr >> 3) + offset    // 算影子地址
sh = *shadow_addr                      // 读影子字节
if (sh != 0) SlowPathCheck(sh, addr)   // 非全可用就走慢路径
编译期做的另一件事:为栈上的局部数组和全局数组前后留出 redzone 内存空间(编译器在栈帧布局和全局数据段里嵌入额外的 pad 字节),但这些 redzone 尚未来得及"上毒"——shadow 里还没有对应的负值标记。上毒的时机在下一步。
关键:编译器注入的检查代码只负责"查"——它读写的是用户数据、不是 shadow。它对 shadow 是只读的。
第二步:进程启动期 —— ASan 运行时分配 shadow + 初始化全局区
程序加载后、main() 执行之前,ASan 运行库的初始化代码做三件事:
分配 shadow memory 大块:按进程地址空间 / 8 的比例,
mmap一大块连续内存作为 shadow,整个 shadow 初始值全为0(全可用——但别忘了,此时进程里除了代码段和已加载的数据段,大片虚拟地址还未真正映射物理页,这些未映射区的 shadow 实际上是映射到bad区域的,查 shadow 时硬件就会报段错误,ASan 再把它转成自己的错误报告)。给全局变量区"上毒":遍历所有全局/静态变量,变量本身对应的 shadow 字节写
0x00(可用),变量前后的 redzone 对应的 shadow 字节写0xf9(全局毒)。从此刻起,任何越界访问全局数组的代码,插桩检查一读 shadow 就会命中0xf9。堆和栈暂不处理:堆还没分配(
malloc还没调过),栈区 shadow 虽已预留但还没有具体函数的 redzone——每个栈帧的 redzone 在函数进入时才逐个上毒。
第三步:运行时 —— "写 shadow"(低频,只在状态变更节点)
这是 shadow 被写入的唯二时机——注意,不是每次内存访问都写:
| 时机 | 谁写 | 写什么 | 频率 |
|---|---|---|---|
malloc(N) 被调用 | ASan 的 malloc 钩子 | 左 redzone → 0xfa,用户区 → 0x00/部分值,右 redzone → 0xfb | 每次分配 |
free(p) 被调用 | ASan 的 free 钩子 | 整块 → 0xfd(freed) | 每次释放 |
| 函数进入(prologue) | 编译器生成在函数开头的代码 | 本栈帧局部数组前后的 redzone → 0xf1/0xf2 | 每次函数调用 |
| 函数返回(epilogue) | 编译器生成在函数返回前的代码 | 本栈帧 redzone 还原为 0x00(解毒) | 每次函数返回 |
| 隔离区淘汰 | ASan 运行时 | 老块的 shadow 随物理归还而失效(实际归还给分配器后,对应 shadow 由后续分配逻辑管理) | 偶尔 |
一句话总结这一步:shadow 的写入全部发生在**"内存所有权变更"**的时刻——分配、释放、栈帧进出——而不是在普通的
*p = val这种数据读写上。后者只读 shadow、不写 shadow。
第四步:运行时 —— "读 shadow + 判定"(高频,每次内存访问都做)
这才是插桩代码的舞台。进程正常跑业务逻辑时,每次 *p = val 或 val = *p,编译器注入的检查代码就执行一次:
1. shadow_addr = (p >> 3) + offset    // 移位+加法,1~2 条指令
2. sh = *shadow_addr                   // 读 1 字节,1 条 load
3. if (sh != 0) goto slow_path         // 比较+条件跳转,绝大多数时 sh==0 直接过
4. 放行,执行真实内存读写 // 快路径,到此为止绝大多数正常内存(malloc 后、未 free、未越界)的 shadow 都是 0x00,所以只多出 3~5 条指令的代价——这就是 ASan "只慢 2x" 的根本原因。
如果 sh 不是 0(可能是 0xfa 踩了堆 redzone、0xfd 用了已释放内存、0x05 部分可用但访问越过了可用字节数等),则进入慢路径细判,非法就调 __asan_report_error 打印三段栈并中止。
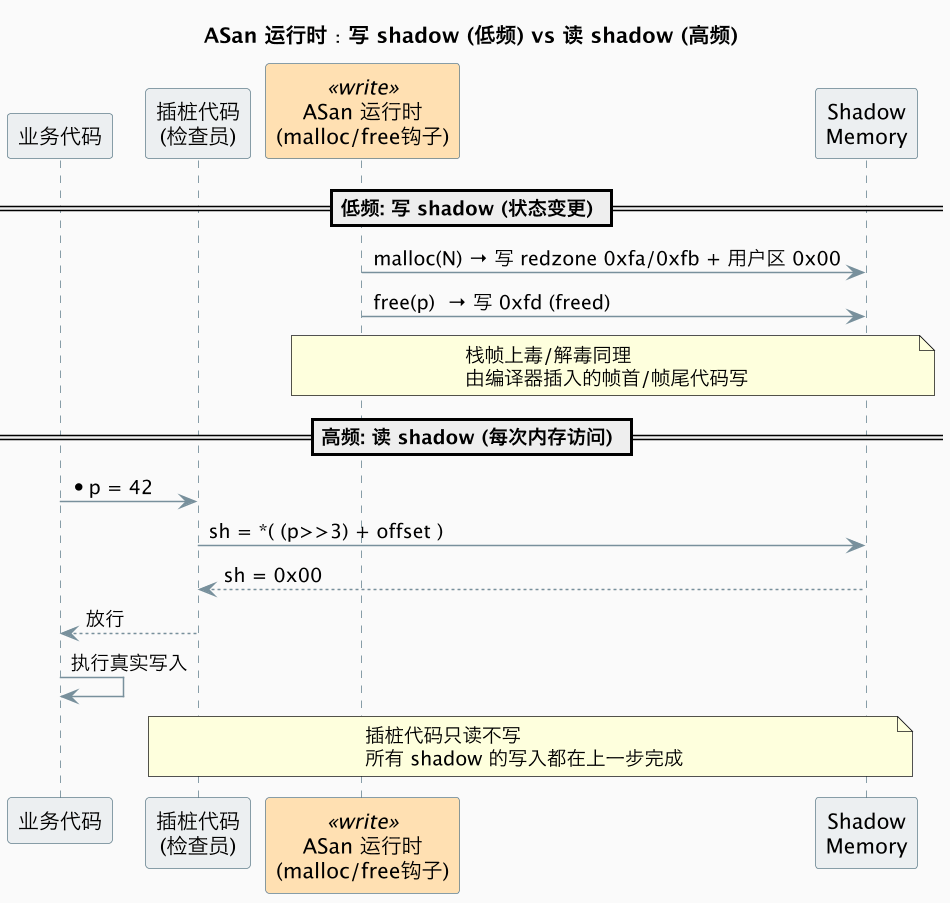
把四步串起来,ASan 的完整原理就是:
- 编译期注入检查代码(只管读 shadow、不管写 shadow);
- 启动期分配 shadow 大块、初始化全局区的毒;
- 运行时在
malloc/free/函数进出时,由 ASan 运行时代码把新状态写入 shadow(低频); - 运行时每次内存访问,由插桩代码读出 shadow、判定、放行或报警(高频)。
shadow memory 就像一份"城市地图"——规划局(ASan 运行时)在盖楼/拆楼时才更新地图上的标注;导航软件(插桩代码)在司机每次转弯时只读取地图来判定能不能走。司机不画地图,同理,*p = val 不写 shadow。
二、核心原理一:shadow memory(影子内存)
这是 ASan 的灵魂。ASan 把整个应用地址空间"镜像"出一份影子内存,用极少的空间记录"每个字节能不能访问"。
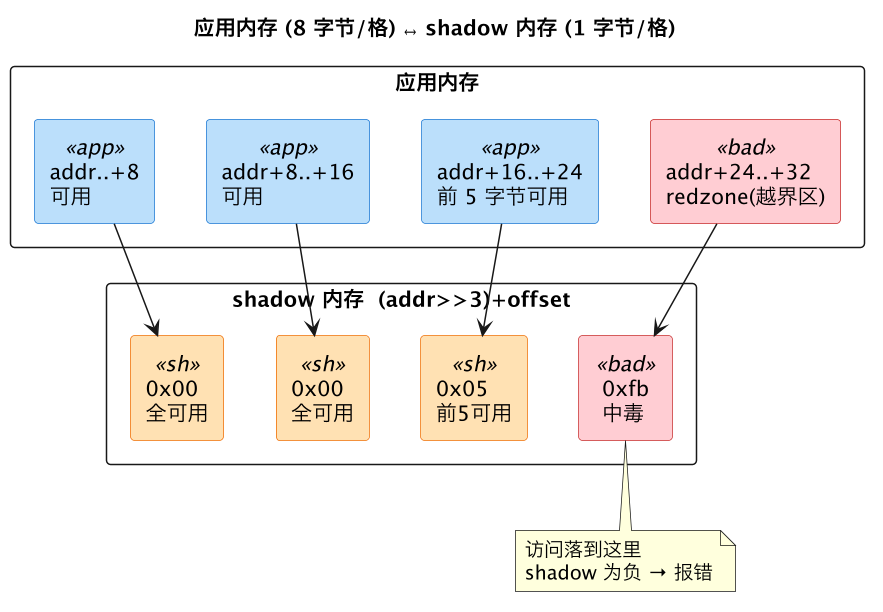
8:1 的映射比例
- 每 8 字节应用内存 → 1 字节 shadow(1/8 的空间开销)。
- 之所以是 8,是因为
malloc保证 8 字节对齐,一个 8 字节块的可访问状态可以用一个 shadow 字节完整描述。
一个 shadow 字节的取值含义:
| shadow 字节值 | 含义 |
|---|---|
0 | 这 8 字节全部可访问 |
1 ~ 7 | 这 8 字节里只有前 k 个可访问(部分可用,常见于 malloc(9) 这种非 8 整数倍,尾部对齐补齐的边界字节) |
负值(如 0xfa、0xfd、0xf1…) | 整块中毒(poisoned)/ 不可访问,不同负值编码不同"毒因"(redzone、已释放、栈越界、全局越界等) |
常见的"毒因"编码(负值):
| shadow 值 | 含义 |
|---|---|
0xfa | 堆左 redzone(heap left redzone) |
0xfb | 堆右 redzone |
0xfd | 已释放的堆内存(freed,在 quarantine 里) |
0xf1 | 栈左 redzone |
0xf2/0xf3 | 栈中/右 redzone |
0xf9 | 全局变量 redzone |
地址映射公式
应用地址到 shadow 地址是一个简单的移位加偏移:
shadow_addr = (addr >> 3) + offset>> 3 就是"除以 8"(8 字节压成 1 字节),offset 是一段预留的固定偏移(64 位 Linux 默认 0x7fff8000)。这个计算极快,只有一次移位和一次加法。
插桩:每次访问前先查 shadow
编译器把源码里每一处形如 *p = ... / ... = *p 的内存访问,改写成"先查影子、再真访问"——这就是 ASan 检测能力的物理来源:没有插桩就没有检查。
下面用序列图展示一次内存访问从触发到判定完毕的完整交互过程:
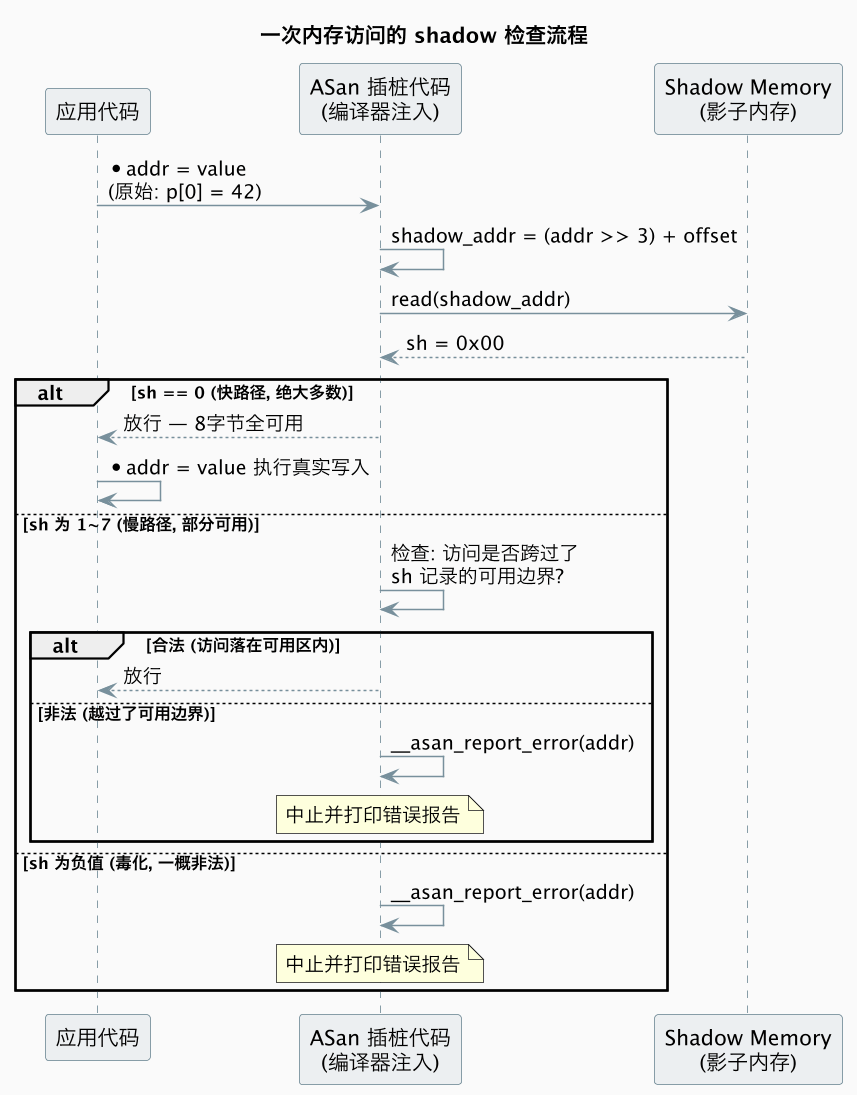
关键理解:三条路径的性能差异巨大:
- 快路径(
sh == 0):只多了一次移位 + 一次加法 + 一次影子读 + 一次与 0 比较,约 5 条指令,这是 ASan "只慢 2 倍"的根本原因——绝大多数正常内存都在全可用区,一比较就过。 - 慢路径(
sh为1~7):需要额外计算"这次访问到底用到哪些字节",但合法访问也放行。 - 非法路径(
sh为负):触发报错,无所谓性能——程序马上要崩。
下面是编译器注入的伪代码,和序列图的三个分支对应:
// 原始:  *addr = value;
// 插桩后:
byte  *shadow = (byte*)((addr >> 3) + offset);
int8_t sh     = *shadow;                 // 读那一个 shadow 字节
if (sh != 0) {                           // 非全可用,需要细判
    // 若访问跨越到了不可用字节(如 addr 的低 3 位 + 访问宽度 越过 sh 记录的可用数)
    if (SlowPathCheck(sh, addr, size))
        __asan_report_error(addr);       // 非法 → 报错并中止
}
*addr = value;                           // 合法 → 放行
走读一个具体地址
用数字走一遍会更直观。假设应用访问了堆上越界 1 字节的地址:
用户 malloc(6),实际分配 8 字节块(malloc 最小对齐 8),
ASan 在两侧包了 redzone。用户拿到 addr = 0x7fff12340010。
用户区的 6 字节 shadow 标为 0x06(前 6 字节可用)。
越界访问 addr+6 → 0x7fff12340016。
走一遍检查流程:
addr       = 0x7fff12340016
addr >> 3  = 0x7fff12340016 >> 3
           = 0x0fffe2468002       (右移 3 位 = 除以 8)
shadow     = 0x0fffe2468002 + 0x7fff8000  (假设 offset = 0x7fff8000)
           = 0x1ff927f40002

查 shadow[0x1ff927f40002] → 得到 0x06 (前 6 字节可用)
addr & 7   = 0x7fff12340016 & 7 = 6    (第 6 字节, 从 0 开始)
访问宽度  = 1 字节

检查: 起始偏移 6 + 访问宽度 1 = 7 > shadow 记录的可用数 6
     → 越过合法边界!
     → __asan_report_error(0x7fff12340016)
     → 报 heap-buffer-overflow
这就是 ASan 抓住越界的物理过程:不是"看见了越界",而是算出来影子字节不答应。每 8 字节的"账本"只有 1 字节,但精度足够——因为越界要么踩进 redzone(shadow 为负),要么跨过可用字节的边界(shadow 的
1~7值不够用),两种情况都逃不掉。
一句话:shadow memory 用 1/8 的内存镜像出"每字节可不可访问",插桩代码每次访问前查一眼,(addr>>3)+offset 一步定位;sh==0 一条分支极快放行,非法则触发 __asan_report_error。
三、核心原理二:redzone(红区)与 quarantine(隔离区)
shadow 只是"记账本",真正让越界和悬垂"必然踩雷"的,是 ASan 改写了内存的分配/释放策略。
redzone —— 在每块内存前后砌毒墙
ASan 接管了 malloc:申请 N 字节时,它实际分配的是 [左redzone] + [N字节用户区] + [右redzone],并把两侧 redzone 在 shadow 里染成中毒值(0xfa/0xfb)。
- 只要越界访问(读/写第 N+1 字节、或第 -1 字节),必然踩进 redzone;
- 插桩代码一查 shadow 发现是负值,当场报 heap-buffer-overflow。
栈和全局同理:编译器给栈上的数组、全局数组前后也留出 redzone 并染毒(栈的 redzone 在函数进入时由插桩代码"上毒",退出时"解毒")。
下面用序列图展示 malloc 被 ASan 接管后的一次完整分配流程——用户申请 N 字节,实际返回的却是 [毒墙 + N + 毒墙] 中间的指针:
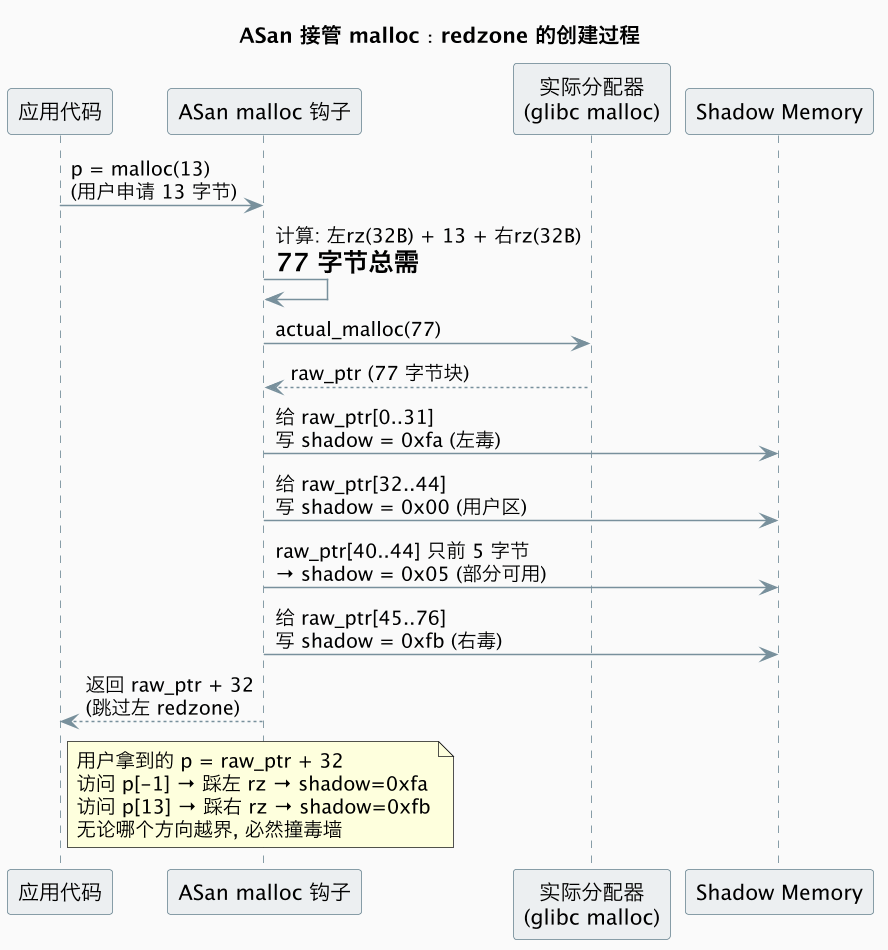
注意:用户
malloc(13),shadow 里用户区的前 8 字节标0x00(全可用),后 8 字节标0x05(前 5 字节可用,后 3 字节是 redzone 的起点)。这就是前面说的"部分可用"——非 8 对齐的尾部自然会留下部分可用的影子字节。
quarantine —— free 的内存先关禁闭,不马上复用
普通 free 会立刻把内存还给分配器,很可能马上被下一次 malloc 复用——这样 use-after-free 访问到的就是"别人的合法内存",抓不到。ASan 改成:
free(p)时,把这块内存在 shadow 里染成0xfd(freed);- 把它丢进 quarantine 隔离区(一个 FIFO 队列),暂不归还分配器;
- 之后 use-after-free 访问它,shadow 一查是
0xfd→ 报 heap-use-after-free;double-free 时也会发现它已在隔离区 → 报 double-free; - 隔离区总量超过阈值(
ASAN_OPTIONS里的quarantine_size_mb)时,才把最老的块真正释放回分配器。
下面是 free 被 ASan 接管后的完整交互——注意关键区别:普通 free 是"还回去",ASan 的 free 是"标记有毒 + 关禁闭 + 扣着不还":
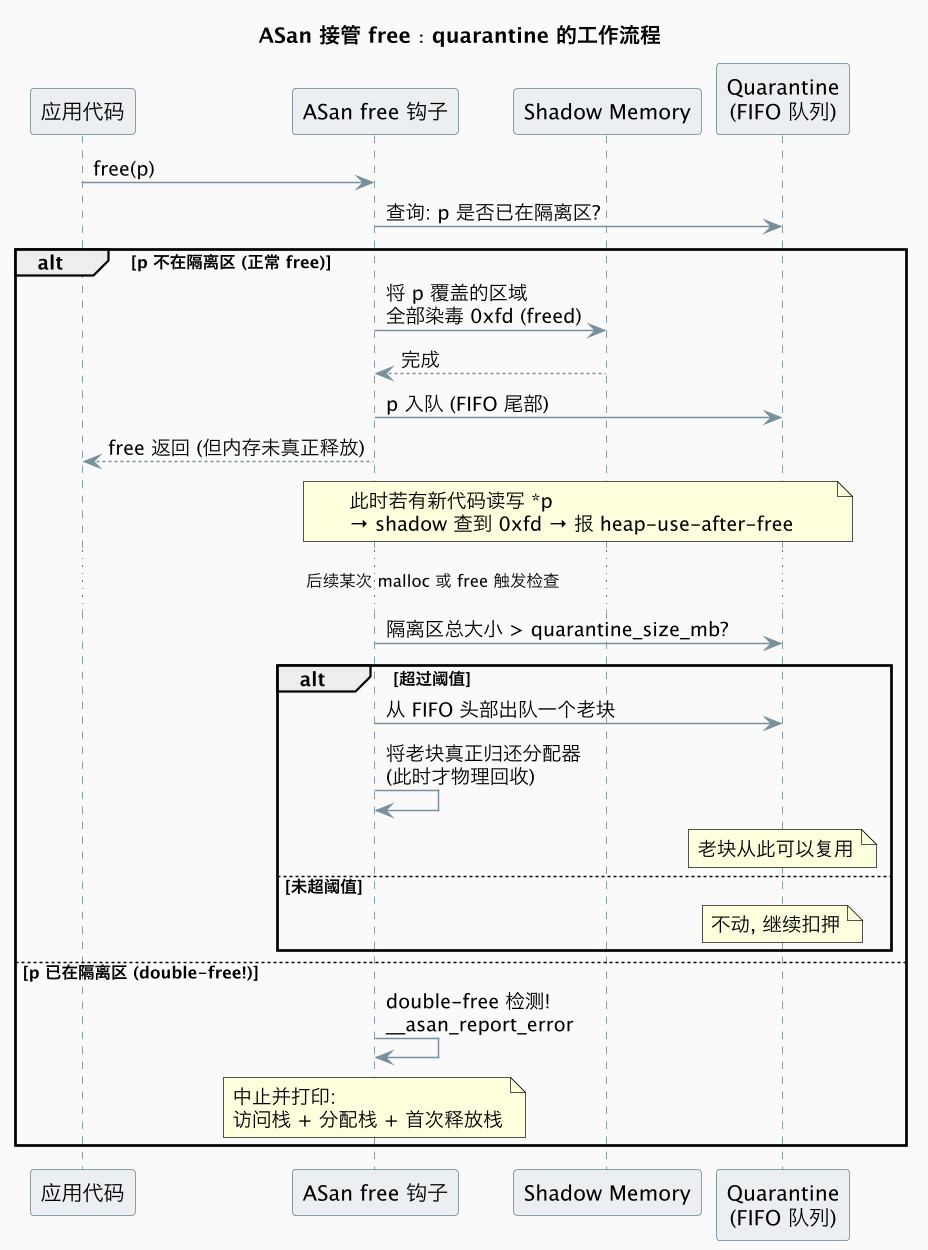
代价:隔离区把已释放内存"扣押"一段时间,这也是 ASan 内存开销偏高的原因之一。隔离区越大,抓 UAF 的窗口越长,但吃内存越多。
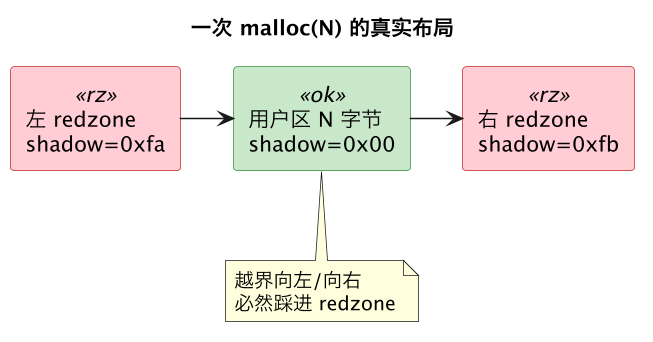
一句话:redzone 在每块内存四周砌毒墙让越界必踩雷;quarantine 把 free 掉的内存扣押染毒,让 use-after-free 无处遁形。
四、一次检测的完整流程——以 use-after-free 为例
前面分别讲了 shadow、redzone、quarantine,现在用一个具体场景把它们全部串起来。假设以下代码:
char *p = malloc(100);   // ASan 实际分配 [左rz + 100 + 右rz]
p[0] = 'A';              // 正常写入, shadow 检查通过
free(p);                 // ASan 接管: 染毒 + 入隔离区
p[0] = 'B';              // use-after-free! 这次写入触发 ASan
下面是这个场景的完整交互序列图——从上到下,从 分配 → 使用 → 释放 → 悬垂访问 → 报错,一条线走到底:
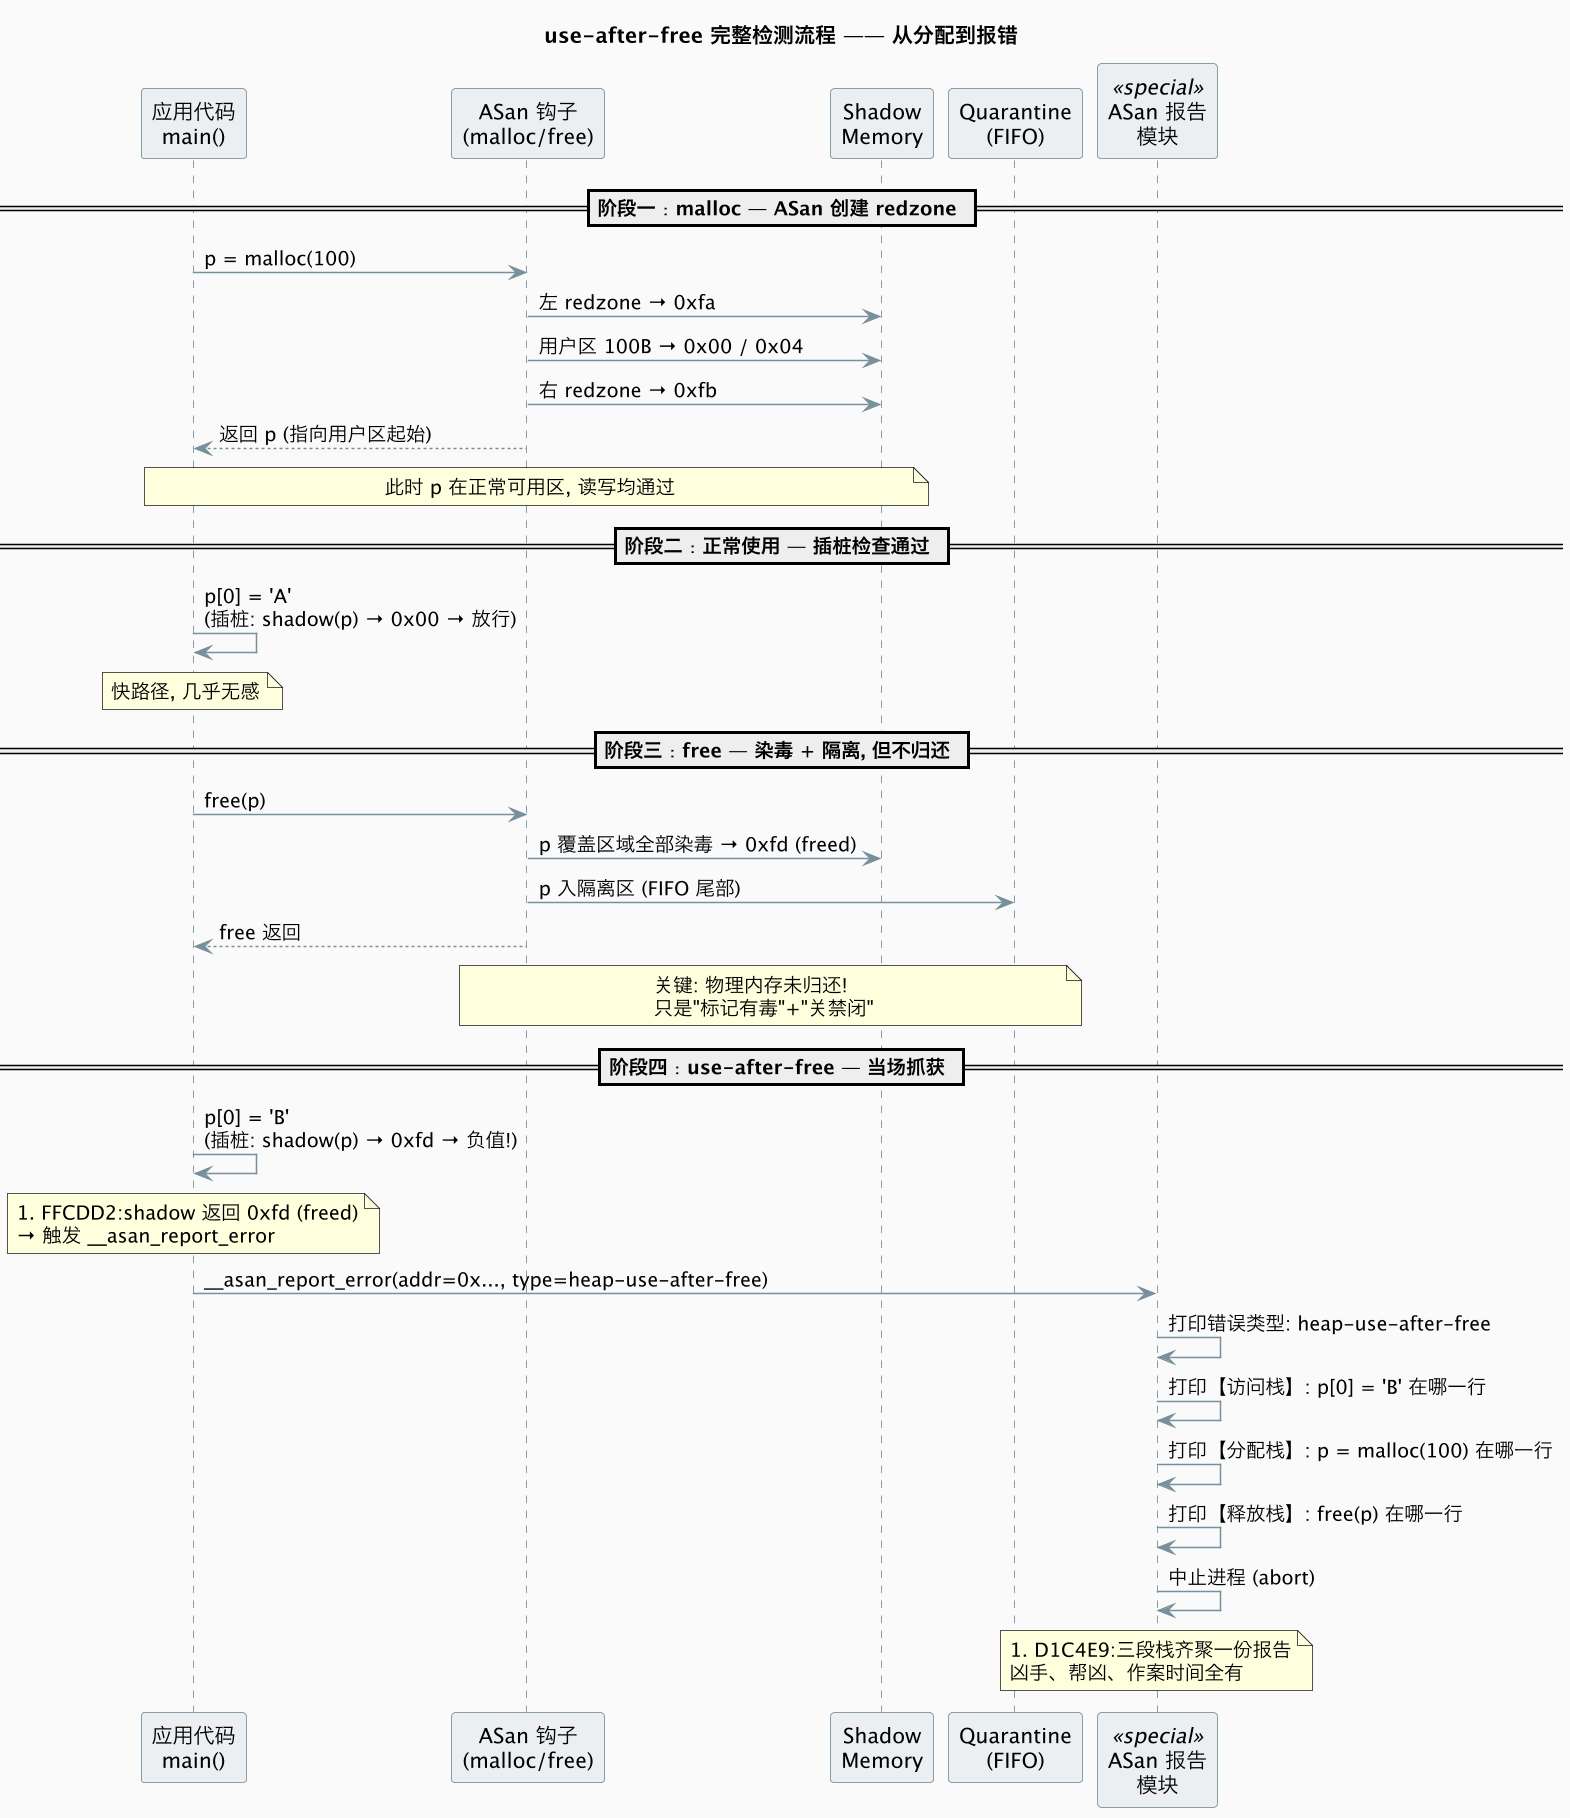
这就是"从分配到报错"的完整链路。三个阶段(分配 / 使用 / 释放)各自在 shadow memory 里留下不同的"账本印记",第四阶段的一次非法访问被插桩代码截获,然后 ASan 把三段调用栈全部还原出来——比 core dump 事后反推直观一个数量级。
报告里最有价值的就是三段栈——访问栈(现在谁在犯错)、分配栈(这块内存当初谁分配的)、释放栈(UAF 时谁提前释放的),一眼定位凶手,比在 core 里反推轻松得多。
其他错误类型(heap-buffer-overflow / double-free / stack-buffer-overflow)的流程与此类似,差异仅在于 shadow 命中的毒值不同(
0xfa/0xfb= redzone → overflow,0xfd= freed → UAF / double-free,0xf1/0xf2= 栈毒 → stack-overflow),三段栈的打印逻辑完全一致。
一句话:ASan 把 "分配 → 使用 → 释放" 三个事件串成一根链条,任一环节出错(越界 / 悬垂访问 / 重复释放),都被插桩代码在 shadow 中截获→三段栈齐聚→当场中止。
五、开销与取舍
插桩和影子内存不是免费的:
| 维度 | 大致开销 | 来源 |
|---|---|---|
| 内存 | 约 2~3x | shadow(1/8)+ 每块的 redzone + quarantine 扣押的内存 |
| 速度 | 约 2x(慢一倍) | 每次访问都多一次 shadow 查表与分支 |
| 二进制体积 | 明显变大 | 每个访问点都插了检查代码 |
结论:ASan 是测试 / CI 阶段用的,不上生产(生产环境跑 ASan 既慢又费内存,且 ASan 自身会改变内存布局)。在 CI 里跑一遍带 ASan 的测试,能在合并前就抓出越界和悬垂。
编译与运行
# 编译: 加 -fsanitize=address, 配 -g 才能在报告里看到源码行号
gcc -fsanitize=address -g -O1 main.c -o app        # GCC
clang -fsanitize=address -g -O1 main.c -o app      # Clang
# -O1 保留一定优化又不太影响可读性; 也可 -O0 保证行号最准
# 运行时用环境变量调参
ASAN_OPTIONS=detect_leaks=1:halt_on_error=1:quarantine_size_mb=256 ./app
常用 ASAN_OPTIONS:
| 选项 | 作用 |
|---|---|
detect_leaks=1 | 开启 LeakSanitizer 内存泄漏检测(Linux 上默认开) |
halt_on_error=0 | 报错后不中止,继续跑(一次跑出多个错误) |
quarantine_size_mb=N | 隔离区大小,越大越能抓到"隔很久"的 UAF |
detect_stack_use_after_return=1 | 开启 use-after-return 检测(有额外开销) |
abort_on_error=1 | 用 abort() 结束,从而顺便产生 core |
log_path=./asan.log | 把报告写到文件而非 stderr |
注意:链接时也要带
-fsanitize=address(它要链入 ASan 运行时库)。且 ASan 与 TSan 不能同时开。
一句话:拿约 2x 速度、2~3x 内存换"当场抓错",所以只在测试/CI 用;编译加 -fsanitize=address -g,运行用 ASAN_OPTIONS 调参。
六、和 core dump / 其他 sanitizer 的关系
| 工具 | 抓什么 | 手段 | 要重编译? | 速度 |
|---|---|---|---|---|
| ASan | 内存访问错误(越界、UAF、double-free、泄漏) | 编译期插桩 + shadow memory | 是(-fsanitize=address) | 慢约 2x |
| TSan | 数据竞争(多线程未加锁并发读写) | 编译期插桩 + 记录内存访问的"发生序" | 是(-fsanitize=thread) | 慢 5~15x |
| Valgrind(Memcheck) | 内存错误(和 ASan 重叠) | 运行期动态二进制翻译 | 否(直接跑现有二进制) | 慢 10~50x |
| core dump | 崩溃后的现场(事后) | 内核在致命信号时转储内存镜像 | 否 | 崩了才有 |
ASan vs Valgrind 的核心差异——两者都能抓越界和 UAF,但机制相反:
- ASan:编译期把检查逻辑"焊"进二进制,运行时几乎原生指令级检查 → 快,但必须重新编译源码;
- Valgrind(Memcheck):不改源码,运行时把程序指令翻译到虚拟 CPU 上逐条监控 → 不用重编、能测第三方二进制,但慢一个数量级。
选择:有源码、追求速度、想进 CI → ASan;只有二进制、或要抓 ASan 覆盖不到的未初始化读取等 → Valgrind。
和 core / 信号的时序关系:ASan 通常在 SIGSEGV / SIGABRT 之前就抓到——因为越界/UAF 访问的往往还是"合法映射但逻辑非法"的内存,硬件不会立刻发段错误,而 ASan 的 shadow 检查先一步命中并主动 abort。也就是说,开了 ASan,很多"过很久才崩"的问题会被提前到"第一次犯错"就报出。
七、一句话总结
AddressSanitizer 用 1/8 比例的 shadow memory 给每字节记账,靠 redzone 让越界必踩雷、靠 quarantine 让释放后的内存暂时染毒,再由编译期插桩在每次访问前查一眼 shadow——合法放行、非法当场打出错误类型和分配/访问/释放三段栈;以约 2x 速度、2~3x 内存的代价,把"隔很久才崩、core 里也难定位"的内存错误,变成"第一次犯错就抓现行",是测试/CI 阶段内存问题的首选利器。
最后更新:2026-08-10