NUMA 架构详解:从原理到 Linux 实战调优
本文由 paper 重新梳理而成——规范化 Markdown 结构、补齐 ASCII 示意图(原文微信配图有防盗链无法内嵌)、统一代码块与表格。
原作者:Linux 教程 | 原文链接:<https://mp.weixin.qq.com/s/eugWx_QOTdN8_DJ4FvmtvA>
简明版概念/工具速查见同目录 numa / numactl / numastat;缓存一致性(MESI)见 mesi。本文是系统性的长篇整理。
NUMA(Non-Uniform Memory Access,非一致性内存访问)是现代多处理器系统优化内存访问性能的关键技术。系统被划分为多个节点(Node),每个节点含一个或多个 CPU 核心 + 与之紧耦合的本地内存。CPU 访问本地内存的延迟远低于访问其他节点内存(远程内存)——这种访问时间的不一致性,正是 NUMA 的核心特征。
Linux 内核识别 NUMA 时,解析 ACPI 规范里的 SRAT(System Resource Affinity Table)和 SLIT(System Locality Information Table)获取硬件拓扑。本地内存由节点内的内存控制器直接管理;跨节点访问需经高速互联总线(Intel QPI/UPI、AMD Infinity Fabric)传输,引入额外延迟和带宽开销。
一、NUMA 与 UMA、SMP 架构对比
要理解 NUMA 的优势,先对比传统 UMA/SMP。UMA 是 SMP 的典型内存模式:所有 CPU 共享一个内存池和单一系统总线,任何 CPU 访问内存延迟都一致。早期够用,但 CPU 一多,总线就成了瓶颈,访问冲突加剧。
NUMA 打破"统一访问",采用分布式内存布局,每个节点有独立内存,从根源解决 SMP 的扩展瓶颈。32 核以上的大型服务器上,SMP 会因总线争用导致延迟飙升,NUMA 则让节点内 CPU 访问本地内存不受其他节点影响。代价是引入新挑战:如何优化跨节点访问、避免高延迟。
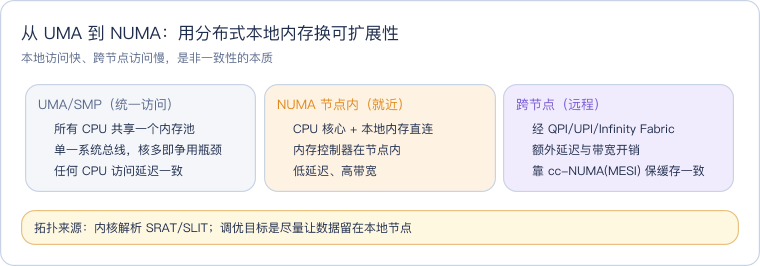
下面这张概念卡把三种内存架构的差异与 NUMA 的核心权衡一图收束:UMA 靠单一总线共享内存、核数一多就争用;NUMA 让每节点自带本地内存、就近访问,跨节点才走互联总线并付出额外延迟。
| 缩写 | 全称 | 含义 |
|---|---|---|
| SMP | Symmetric MultiProcessing / Shared-Memory MultiProcessors | 对称多处理机 / 共享存储型多处理机 |
| UMA | Uniform-Memory-Access | 均匀存储器存取(SMP 的典型内存模式) |
| NUMA | Non-Uniform-Memory-Access | 非均匀存储器存取 |
   UMA / SMP(统一访问,总线易成瓶颈)          NUMA(分布式内存,就近访问)
 ┌──────┬──────┬──────┬──────┐             ┌───── Node0 ─────┐   ┌───── Node1 ─────┐
 │CPU0  │CPU1  │CPU2  │CPU3  │             │ CPU0..3         │   │ CPU4..7         │
 └───┬──┴───┬──┴───┬──┴───┬──┘             │   ↕ 本地(快)    │◄─►│   ↕ 本地(快)    │
     └──────┴──┬───┴──────┘                │ Memory0(直连)   │QPI│ Memory1(直连)   │
          单一系统总线 ← 争用瓶颈            └─────────────────┘UPI└─────────────────┘
        ┌──────┴──────┐                       CPU0 访问 Memory0 快;访问 Memory1 需过互联(慢)
        │  共享内存池  │
        └─────────────┘
二、NUMA 系统架构详解
2.1 定义与关键特性
NUMA 将系统划分为多个相对独立的节点,每个节点是一个紧密耦合的计算单元(一组 CPU 核心 + 本地内存 + 内存控制器)。核心目标:最大化利用本地内存的高效性,减少共享总线的冲突和延迟。
两个核心特点:
- 本地内存优先访问:CPU 就近读写本地内存,低延迟、高带宽,大幅提升多线程与大数据业务(如数据库)性能。
- cc-NUMA 缓存一致性:依托 MESI 及其扩展(MESIF、MOESI)同步多节点缓存状态,保障跨节点数据一致与系统稳定(详见 mesi)。
2.2 系统组成
| 组成 | 说明 |
|---|---|
| 节点(Node) | 基本单元,通常对应一个物理 CPU 插槽,含多个核心,共享节点内 L3 缓存。如一颗 16 核 CPU + 其内存 = 一个节点 |
| 本地内存 | 直连节点内的内存控制器,与 CPU 紧耦合;其容量和速度直接决定节点的处理能力 |
| 互联模块 | 节点间的"桥梁",负责数据传输:Intel QPI/UPI、AMD Infinity Fabric,提供高带宽低延迟通道,并保障缓存一致性 |
numactl --hardware即可查看节点数量、CPU/内存配置及节点间距离。
2.3 工作原理:本地访问 vs 远程访问
  本地访问(快)                              远程访问(慢)
  CPU ──内部总线──► 本地内存                CPU ─► 互联模块 ─QPI/UPI─► 目标节点内存控制器 ─► 数据
几乎无额外开销 多环节,每环都引入延迟;带宽也更低- 本地访问:CPU 访问所在节点的本地内存,路径最短、延迟最低、带宽最高。
- 远程访问:CPU 访问其他节点内存,需经互联模块中转,延迟高、带宽低。分布式计算中若频繁互访对方内存,会因远程延迟拖慢整体。
为保证多节点数据一致,cc-NUMA 用缓存一致性协议。以 MESI 为例,缓存行有四态:Modified / Exclusive / Shared / Invalid。某 CPU 改了缓存数据 → 状态变 Modified → 通过互联模块通知其他节点把对应缓存行置为 Invalid → 其他 CPU 再访问时发现失效 → 从内存重读最新值,保证一致。
Linux 页面分配器优先从进程所在节点分配内存,只有本地不足才考虑其他节点——从内核层面优化了访问性能。
2.4 拓扑结构:节点间距离 (distance)
拓扑的核心指标是节点间距离(distance),numactl --hardware 的 node distances 可看。数值越小延迟越低:本地通常为 10,跨节点在 20 以上,直观体现本地/远程延迟差距。
$ numactl -H
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7
node 0 size: 32126 MB
node 0 free: 18568 MB
node 1 cpus: 8 9 10 11 12 13 14 15
node 1 size: 32128 MB
node 1 free: 19234 MB
node distances:
node   0   1
  0:  10  20      # 本地=10,到 node1=20 → 远程延迟约为本地的 2 倍
  1:  20  10
节点间带宽也差异明显:Intel UPI 单向带宽可达 25.6 GB/s,AMD Infinity Fabric 亦表现出色。分布式数据库同步等大量跨节点传输场景,高带宽能显著提效;反之低带宽成瓶颈。因此系统调优必须考虑拓扑差异,合理分配任务和内存,尽量减少跨节点访问。
三、Linux 内核中的 NUMA 实现机制
3.1 拓扑识别:SRAT / SLIT
内核启动时借助 ACPI 的两张表识别拓扑:
- SRAT(系统资源亲和性表):记录 CPU 核与内存的对应关系(每个节点含哪些逻辑核、关联哪些内存)。
- SLIT(系统局部性信息表):记录各节点之间的距离,用于判断访问延迟。
内核在启动阶段依次调用 x86_numa_init → numa_init → x86_acpi_numa_init → acpi_numa_init 解析 SRAT,把内存与节点的关联存进 numa_meminfo 结构——一本"内存地图",每项是 (起始地址, 结束地址, 节点编号) 三元组。
// 解析 SRAT 表,初始化 NUMA 节点内存映射
int __init acpi_numa_init(void) {
    struct acpi_table_srat *srat;
    acpi_status status;
    // 获取 SRAT 表
    status = acpi_get_table(ACPI_SIG_SRAT, 0,
                            (struct acpi_table_header **)&srat);
    if (ACPI_FAILURE(status)) {
        pr_warn("ACPI SRAT table not found, NUMA disabled\n");
        return -EINVAL;
    }
    // 解析 SRAT 表中的 CPU 与内存关联信息
    acpi_srat_parse_entries(srat);
    return 0;
}
3.2 内存管理:三种分配策略 (mempolicy)
内核通过 mempolicy 子系统实现三种核心 NUMA 分配策略:
| 策略 | 行为 | 适用场景 | 风险 |
|---|---|---|---|
MPOL_BIND | 强制绑定到指定节点 | 内存局部性要求极高(如实时数据库核心) | 指定节点内存不足 → 触发 OOM |
MPOL_INTERLEAVE | 跨节点轮询分配 | 大内存、对延迟不敏感、对带宽要求高(如批量数据中间结果) | 局部性差 |
MPOL_PREFERRED | 优先首选节点,不足则降级到其他节点 | 大多数普通应用 | 兼顾局部性与灵活性 |
内核默认本地分配:进程启动后优先从所在节点分配,对数据库等内存密集型应用尤为重要。
3.3 NUMA API 与工具(numactl、libnuma)
- numactl:管理核心工具。
numactl --hardware查拓扑;numactl --cpunodebind=0 --membind=0把进程绑到指定节点的 CPU 和内存。生效前提:BIOS 开启 SRAT/SLIT,内核未禁用 NUMA(无numa=off)。仅对新进程生效,无法改运行中进程的策略。 - libnuma:细粒度编程接口。
numa_alloc_local()直接申请本地内存,比malloc更高效(编译需-lnuma)。
3.4 进程调度中的 NUMA 亲和性
线程绑定能避免线程在 CPU 间频繁切换、提升缓存命中率:
taskset -p 0x1 1234:把 PID 1234 绑到 CPU0。- 多线程用
pthread_setaffinity_np()在代码层做线程级绑定。 - 关键:CPU 绑定必须配合内存绑定,否则会"线程在节点1、内存在节点0"的跨节点访问,反而更慢。绑定后可
cat /proc/PID/status查Cpus_allowed/Mems_allowed验证。
内核调度器自带 numa_balancing:实时统计进程的本地内存命中率,若远程访问过多,触发页面迁移或进程迁移,实现"计算靠近数据"。单节点系统无跨节点问题,该机制反而增加开销,可 kernel.numa_balancing=0 禁用。
3.5 系统调用与性能监控
- numastat:核心指标
numa_hit(本地命中)、numa_miss(远程访问)。numa_hit越高、numa_miss占比越低越好;numa_miss占比超 5% 就说明存在跨节点瓶颈。 - perf:
perf record -e mem:trace_mm_page_alloc -g记录内存分配事件,perf report分析,定位内存分配/页面迁移等耗时操作。 /proc/PID/numa_maps:查单进程访问统计;MPOL_PREFERRED下numa_miss不为 0 需排查内存碎片或 THP 干扰。
四、NUMA 感知的应用程序优化
4.1 内存分配优化
本地分配 API:
numa_alloc_local()/numa_alloc_onnode()从本地/指定节点分配(编译-lnuma;未启用 NUMA 时退化为普通分配)。CPU 与内存强绑定:
numactl --membind=0 ./app强制内存分配限定在节点 0。关闭透明大页(THP):THP 把小页合并成 2MB/1GB 大页减少页表开销,但在 NUMA 下可能因节点内存不足触发跨节点分配。建议关闭:
bashecho never > /sys/kernel/mm/transparent_hugepage/enabled内存预留:为关键进程提前预留本地内存,避免系统紧张时被迫跨节点。
4.2 线程绑定与 CPU 亲和性
taskset -c 0-3 ./app:绑到 CPU 0–3,减少核间迁移的上下文切换、提升缓存命中。- 多线程用
pthread_setaffinity_np()做细粒度绑定(如把网络 I/O 线程固定到特定核)。 - 遵循 "CPU 节点与内存节点一致" 原则,绑定后用
taskset -p+ numastat 验证。
深入:绑定了核心,线程是不是"只会在这个 CPU 上运行"?
这是亲和性最核心、也最容易误解的一点。答案分两半:
是——线程只会在你允许的那些核上运行,绝不会跑到集合之外的核(这是硬约束)。
不是——"只在这个 CPU 运行"不等于"这个 CPU 只给它运行"。
分开说清楚:
1) 亲和性是"允许集合(cpumask)",是对线程的单向约束
sched_setaffinity/taskset 给线程设的是一个允许运行的 CPU 掩码。调度器保证:这个线程永远只在掩码内的核上被调度,一步都不会踏出去。
- 绑到单核(
taskset -c 2)→ 该线程确实只可能在 CPU2 上跑,永远不会迁到别的核。 - 绑到多核(
taskset -c 0-3)→ 线程可在 0/1/2/3 之间,由调度器动态挑一个空闲的跑,仍可能在这 4 个核之间迁移(只是不出这个范围)。所以"绑定"不必然等于"钉死在一个核",取决于你给的集合多大。
2) 但这只是"线程 → 核"的单向限制,反过来不成立
绑定不会把那个核变成该线程独占。默认情况下:
- CPU2 上除了你绑的线程,照样会调度系统里其他没设亲和性的进程/线程、内核线程、中断下半部等——它们的默认亲和性是"所有核",包括 CPU2。
- 于是你以为"独占 CPU2",实际 CPU2 还在被别人抢时间片,你的线程照样会被抢占、发生上下文切换。
想要"这个核只给我这个线程用",需要额外手段(亲和性本身给不了):
| 手段 | 作用 |
|---|---|
isolcpus=2,3(内核启动参数) | 把这些核从调度器默认负载均衡里摘出去,普通任务不会被派到上面,只有显式绑上来的才跑 |
nohz_full= + rcu_nocbs= | 进一步减少时钟中断/RCU 回调对隔离核的打扰(低延迟场景) |
irqaffinity / 把中断绑到别的核 | 让中断处理不落在隔离核上 |
cgroup cpuset | 用 cpuset 把一组核划给特定进程组专用 |
isolcpus + 亲和性绑定配合,才能做到接近"独占一个核"——高频交易、DPDK、实时任务常这么干。
3) 亲和性 vs NUMA 内存:绑了核 ≠ 绑了内存
这是本文反复强调的坑:taskset 只管线程在哪个核跑,完全不管它的内存分配在哪个节点。绑了核但没绑内存,仍可能"线程在 node1 的核上跑、内存却在 node0"——远程访问照旧。所以:
taskset -c 8-15 ./app            # 只绑核(node1 的核),内存可能还在 node0 → 跨节点!
numactl --cpunodebind=1 --membind=1 ./app # 核 + 内存都绑 node1,才真正本地化结论:要 NUMA 本地性,用 numactl 同时绑核和内存;单用
taskset只解决核、不解决内存。
4) 代码层:pthread_setaffinity_np 精确到线程
进程级 taskset 对所有线程一视同仁;要"IO 线程绑 A 核、计算线程绑 B 核"这种,得在代码里逐线程设:
#define _GNU_SOURCE
#include <pthread.h>
cpu_set_t set;
CPU_ZERO(&set);
CPU_SET(2, &set);                 // 只允许 CPU2
pthread_setaffinity_np(pthread_self(), sizeof(set), &set);
// 之后本线程只会在 CPU2 上运行;CPU_SET 多个核则在这些核间浮动
5) 验证
taskset -cp <PID>                 # 看进程/线程当前的允许核集合
taskset -cp <TID>                 # 线程级(TID)
cat /proc/<PID>/status | grep Cpus_allowed_list   # 允许运行的核
# 实际正跑在哪个核:top 按 f 开 P 列,或 ps -o psr= -p <PID>实例:cat /proc/<pid>/status 逐字段解读
下面是 cpu_demo(PID 1052)在一台 4 核机器上的真实 status 节选,正好把上面几点全印证了:
Name:       cpu_demo
State:      S (sleeping)         # 睡眠态:此刻没跑满 CPU(多半停在菜单等输入,或选了场景3 idle)
Threads:    2                    # 主线程 + detach 的 work_thread,和 main.cpp 结构对上
VmSize:     88600 kB             # 虚拟内存(映射了 libstdc++ 等一堆库)
VmRSS:       1372 kB             # 真正占的物理内存 —— 极小;VmSize ≫ VmRSS = 映射多、触碰少
RssAnon:      196 kB             #   其中匿名(堆/栈)
RssFile:     1176 kB             #   其中文件映射(代码/库页),196+1176≈VmRSS
VmSwap:         0 kB             # 没被换出,内存充足
Cpus_allowed:        3           # 掩码 0x3 = 二进制 11
Cpus_allowed_list:   0-1         # → 只允许在 CPU0、CPU1 跑(机器有 4 核,说明被约束过)
Mems_allowed_list:   0           # 只允许从 NUMA 节点0 分配 → 单节点(或被限定 node0)
voluntary_ctxt_switches:    66   # 主动让出 66 次:等输入/IO 时挂起,sleeping 的特征
nonvoluntary_ctxt_switches:  1   # 几乎没被抢占 → 没在抢 CPU,和 State: S 一致
读这份数据的三个关键结论:
| 观察 | 说明 |
|---|---|
Cpus_allowed_list: 0-1(4 核机上) | 该进程被限制只能用 CPU0/1(taskset / cgroup cpuset / 容器 / 云配额),绝不会跑到 CPU2/3——"允许集合"的真实样本:它在 0、1 间浮动,但出不了这个圈 |
Mems_allowed_list: 0 | 内存只能从节点0 分配——单 NUMA 节点(云主机常见),此时 NUMA 优化无从谈起 |
VmSize 88600 ≫ VmRSS 1372 | 虚拟内存远大于物理内存:映射了大量库但没真正触碰那么多页——印证"看真实占用要看 RSS,不是 VIRT/VmSize" |
Cpus_allowed(掩码) 与Cpus_allowed_list(人类可读) 是同一信息两种写法:3=0x3=0-1。绑定生效后,这两行就是你 4.2 节所有操作的"验收单"。
一句话总结:绑定 = 给线程画了个"只能在这些核里跑"的圈(硬约束、单向);圈多大由你定(单核=钉死,多核=范围内浮动);但圈里的核并不因此归你独占,想独占得再加
isolcpus/cpuset;而且绑核不等于绑内存,NUMA 本地性要用 numactl 连内存一起绑。
4.3 数据局部性设计
- 数据库分表:把高频热点数据放在对应节点本地内存(如电商库把热门商品放节点0)。
- 并行计算按节点拆分数据:如图像识别按区域分片,每个节点只处理本地分片,减少跨节点传输。
4.4 性能调优方法论
定位瓶颈:
numastat                                    # 看 numa_hit / numa_miss 占比,miss>5% 即有问题
perf record -e mem:trace_mm_page_alloc -g   # 记录内存分配事件
perf report                                 # 分析热点:_alloc_pages_nodemask / migrate_pages 等
cat /sys/kernel/debug/numa/ # 排查内核 NUMA 初始化异常动态调优与验证:遵循"测试-优化-验证"循环。数据库多用 MPOL_BIND,批处理多用 MPOL_INTERLEAVE。内核不支持动态改进程内存策略,需动态调整时用 move_pages 系统调用做页面热迁移。每轮调优后用 sysbench / iperf 对比吞吐、延迟,验证效果。
4.5 什么时候该用 libnuma(而不是 numactl)
numactl 和 libnuma 是同一套能力的两个层次:numactl 是命令行工具,对整个进程施加统一策略;libnuma(#include <numa.h>,链接 -lnuma)是 C 库,让程序在代码里做"每块内存、每个线程"级别的精细控制。二者背后都是 set_mempolicy/mbind/sched_setaffinity 等系统调用。
先判断:你到底需不需要 libnuma
大多数情况不需要——能用 numactl 在启动时把进程绑到一个节点就够了。只有当"整个进程绑到单节点"这个粗粒度手段解决不了问题时,才上 libnuma。典型分水岭:
| 场景 | 够用的手段 |
|---|---|
| 进程内存能塞进单个节点,且不需要跨节点扩展 | numactl --cpunodebind + --membind,不必写代码 |
| 进程要用满多个节点的 CPU 和内存(单节点装不下),又想让每个线程访问本地内存 | 必须用 libnuma 在代码里按节点分配、按节点绑线程 |
该用 libnuma 的四类场景
① 内存需求 > 单节点容量,但仍要保证本地性
进程要用 100GB、而每个节点只有 64GB——绑单节点根本装不下。这时需要在代码里把数据结构按节点切分:node0 的线程处理的数据用 numa_alloc_onnode(size, 0) 分到 node0,node1 的分到 node1。numactl 给不了这种"一个进程内、不同数据放不同节点"的控制。
#include <numa.h>
// 大数组按节点分片:第 i 片分配在第 (i % n_nodes) 个节点
int n = numa_num_configured_nodes();
for (int i = 0; i < nshards; i++)
    shard[i] = numa_alloc_onnode(shard_bytes, i % n);
// 用完必须用 numa_free(不是 free),且要传回长度
numa_free(shard[i], shard_bytes);
② 线程池 / 工作线程要和它处理的数据"同节点"
服务器程序常有一个大线程池。想做到"跑在 node0 核上的线程,只碰 node0 内存里的数据",需要线程级绑定 + 该线程本地分配:
// 在工作线程启动时:先把自己绑到某节点的 CPU,再分配本地内存
numa_run_on_node(node_id);              // 线程只在该节点的核上跑
numa_set_localalloc();                  // 之后该线程的分配默认落在本地节点
char *buf = numa_alloc_local(buf_size); // 显式本地分配
单靠 numactl 只能把整个进程绑一个节点,做不到"进程用多节点、但每个线程各自本地化"。
③ first-touch 陷阱:谁初始化、内存就落在谁那
Linux 默认 first-touch——物理页由第一个写它的线程所在节点分配。经典 bug:主线程 malloc 一大块并 memset 初始化 → 全部落在主线程节点 → 后续多节点的工作线程访问它全是远程。libnuma 让你显式打破这个默认:要么 numa_alloc_onnode 直接指定,要么让"将来用这块内存的线程"去做首次触碰。
④ 运行期需要按负载动态迁移内存
numactl 只在启动时生效、且不能改运行中进程。若程序运行期数据热点会漂移,需要用 libnuma 的 numa_move_pages() / move_pages(2) 把页热迁移到当前访问它的节点。
libnuma 常用 API 速查
| API | 作用 |
|---|---|
numa_available() | 检测系统是否支持 NUMA(返回 -1 表示不支持,调用其他 API 前必须先查) |
numa_num_configured_nodes() | 节点数 |
numa_alloc_onnode(size, node) | 在指定节点分配 |
numa_alloc_local(size) | 在当前线程所在节点分配 |
numa_alloc_interleaved(size) | 跨所有节点交错分配(带宽型) |
numa_free(ptr, size) | 释放(必须配对,且要传长度,不能用 free) |
numa_run_on_node(node) | 把当前线程限制到某节点的 CPU 上跑 |
numa_set_localalloc() | 设当前线程后续分配默认本地 |
numa_set_preferred(node) / numa_set_membind(mask) | 设首选/强制绑定的内存节点 |
numa_move_pages(...) | 运行期把已分配的页迁移到指定节点 |
使用注意
- 编译链接:
gcc app.c -o app -lnuma;运行前用numa_available() >= 0判断,否则这些调用无意义(未启用 NUMA 时行为退化)。 - 分配粒度大:
numa_alloc_*按页(通常 4KB)对齐分配,不适合频繁分配小对象(那样浪费且慢)——它面向"大块、长生命周期、访问密集"的数据(缓冲池、矩阵、分片表),小对象仍用常规分配器。 - 释放要配对:
numa_alloc_*分配的必须numa_free(ptr, size)释放,且要记住长度,混用free()是 bug。 - 别过度工程:libnuma 把 NUMA 拓扑硬编进了代码逻辑,增加复杂度和可移植性负担。先用 numactl 量出确实有跨节点瓶颈(numastat 的
numa_miss高)、且单节点装不下,再考虑改代码。
一句话分工:numactl = 部署/运维层,一条命令绑整个进程,占 90% 场景;libnuma = 开发层,当程序必须"横跨多节点还要保持本地性"时才写代码精细控制。 排查手段(
numastat -p、perf)两者通用。
五、核心应用场景与优化实践
5.1 数据库(MySQL / Oracle)
InnoDB 缓冲池本地化:
numactl --cpunodebind=0 --membind=0 /usr/sbin/mysqld   # 进程+内存都绑节点0
echo never > /sys/kernel/mm/transparent_hugepage/enabled # 关 THPinnodb_buffer_pool_size不超过节点内存容量(常设为节点内存 70%),确保缓冲池分配在本地。innodb_log_group_home_dir指向本地磁盘,加快 redo 日志写入。
避免跨节点数据交互:
- 网卡中断亲和性绑到数据库所在节点(
irqbalance),减少数据包跨节点 DMA。 - 主从架构把主/从分置不同节点,避免资源竞争。
- 定期用 numastat 监控
numa_hit/numa_miss。
5.2 虚拟化与云计算
KVM/QEMU 的 vNUMA:把物理 NUMA 拓扑暴露给虚拟机。libvirt XML:
<domain type='kvm'>
  <numa>
    <cell id='0' cpus='0-7'  memory='8192' unit='MiB'/>
    <cell id='1' cpus='8-15' memory='8192' unit='MiB'/>
  </numa>
  <vcpu placement='static'>16</vcpu>
  <memory unit='MiB'>16384</memory>
</domain>
注意:vCPU 数不宜超过单个物理节点的核心数,否则部分 vCPU 无法绑本地节点,增加跨节点调度概率。
Kubernetes NUMA 亲和性调度(Volcano 插件):
apiVersion: v1
kind: Pod
metadata:
  name: numa-aware-pod
  annotations:
    volcano.sh/numa-policy: "preferred"   # 优先调度到满足 CPU/内存需求的 NUMA 节点
spec:
  containers:
  - name: my-container
    image: my-image
    resources:
      requests: { cpu: "2", memory: "1Gi" }
      limits:   { cpu: "2", memory: "1Gi" }
配合
cpuManagerPolicy: static,可把 Pod 的 CPU 核绑到指定 NUMA 节点。
5.3 高性能计算(HPC)
MPI 按节点分片绑定:
mpirun --bind-to socket --map-by socket:pe=4 -np 16 ./mpi_app
# 16 个进程每 4 个一组,分别绑到 4 个 NUMA 节点(每节点一个插槽)
OpenMP 线程亲和性:
export KMP_AFFINITY=granularity=fine,compact,1,0 # 线程紧凑绑到同一节点的核大规模集群:用 Slurm 收集各节点 CPU/内存/互联参数进拓扑数据库,调度器据此匹配最优节点组合,避开高延迟互联。
5.4 云原生与容器调度
节点亲和性调度 Pod:
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: numa-node
            operator: In
            values: ["0"]      # 调度到标签 numa-node=0 的节点
CPU 管理器 + 拓扑感知:kubelet 配 cpuManagerPolicy: static + topologyManagerPolicy: single-numa-node,实现"Pod CPU 与内存同节点"。仅对 Guaranteed QoS 的 Pod 生效(BestEffort / Burstable 无效)。
六、Linux 实战:配置与调优指南
6.1 查看拓扑
lscpu | grep -i numa                # 快速看节点数与每节点的核
numactl --hardware                  # 详细:节点 CPU/内存/空闲/距离矩阵;只显示 1 节点 = NUMA 未启用(查 BIOS / numa=off)
ls  /sys/devices/system/node/       # node0 node1 ... 每个节点一个目录
cat /sys/devices/system/node/node0/meminfo   # 节点内存明细
cat /sys/devices/system/node/node0/cpulist   # 节点的 CPU 核列表
6.2 监控性能
numastat                # 系统级 numa_hit / numa_miss / numa_foreign
numastat -p <PID>       # 单进程内存在各节点的分布
watch -n 1 numastat     # 每秒刷新,看趋势
perf top -e mem:trace_mm_page_alloc -g   # 实时热点,关注 _alloc_pages_nodemask / migrate_pages
6.3 配置亲和性
numactl --cpunodebind=0 --membind=0 ./app   # 新进程:CPU+内存都绑节点0
taskset -c 0-7 <PID>                         # 运行中进程:只能调 CPU 绑定
numactl --localalloc ./app                   # 内存就近分配到运行所在节点
numactl --interleave=all ./app               # 跨节点轮询(带宽型负载)
cat /proc/<PID>/numa_maps                    # 验证内存落在哪个节点
--localalloc/--membind在节点内存不足时无容错,会触发 OOM,生产环境需评估节点内存余量。
6.4 优化案例:MySQL 调优
numactl --hardware确认拓扑(假设双节点)。numactl --cpunodebind=0 --membind=0 /usr/sbin/mysqld绑到节点0。echo never > /sys/kernel/mm/transparent_hugepage/enabled关 THP。innodb_buffer_pool_size设为节点内存的 70%,确保本地分配。sysbench压测验证。
效果:numa_miss 占比从较高水平降到 1% 以下,查询延迟提升 20%–30%。
七、常见问题与误区
7.1 性能瓶颈根源
跨节点访问延迟:本地访问几十纳秒,跨节点可达百纳秒以上。解法:CPU 与内存强绑定,
numactl --cpunodebind=0 --membind=0,做到"计算与数据同节点"。远程访问导致的 SWAP 陷阱:默认策略下本地节点内存耗尽时,进程不会 fallback 到其他节点,而是触发 SWAP(换盘)→ 性能急剧下降。解法:
bashnumactl --interleave=all ./app # 内存跨节点交错,避免单节点耗尽 sysctl -w vm.zone_reclaim_mode=0 # 允许节点间内存共享,本地不足时用其他节点而非 SWAP
7.2 虚拟化环境的 NUMA 陷阱
- 虚拟机跨 NUMA 调度:vCPU 跨物理节点调度导致内存访问延迟翻倍。解法:启用 vNUMA、把 vCPU 与内存绑同一物理节点、限制 vCPU 数不超过单节点核心数。
- CPU 热添加与 NUMA 不兼容:热添加 CPU 可能破坏原有拓扑,内核无法正确关联新 CPU 与内存节点。解法:关键系统避免运行时热添加;必须时操作后重启或重配 vNUMA。
7.3 禁用 NUMA 的误区
- 单节点系统:无跨节点访问,
numa_balancing反而增开销,可kernel.numa_balancing=0禁用。 - 多节点系统:禁用 NUMA 会让所有访问退回统一模式、丧失本地优势、延迟增大——除非特殊需求,不应禁用。
- 过度手动绑定:把多个进程绑到同一节点会使该节点资源耗尽、其他节点闲置。需结合 Kubernetes/Slurm 动态均衡,并用 numastat/perf 验证。
7.4 其他常见问题
- 内存碎片化:频繁分配/释放产生大量小空闲块,大块分配失败会被迫跨节点。解法:启用内存规整(
compact_memory)、关闭 THP。 - 硬件架构兼容性:
- AMD Zen:多 CCD 设计,每 CCD 对应一个 NUMA 节点,可用更细粒度的 CCD 绑定。
- Intel Sapphire Rapids:支持 UPI 2.0,更高带宽,需关注带宽利用。
八、总结
NUMA 是多核 Linux 性能调优的核心:本质是用"本地内存优先访问"突破 SMP 的总线瓶颈。从内核的拓扑识别(SRAT/SLIT)、调度策略(numa_balancing),到应用的亲和性配置(numactl/taskset/libnuma)、数据局部性设计,再到实战工具(numastat/perf)与案例优化,环环相扣。
一句话决策:延迟敏感 + 有局部性 → --cpunodebind + --membind 绑死一个节点;带宽型 + 访问遍布内存 → --interleave=all;单节点机器 → 关掉 numa_balancing,其余不用折腾。
配套:概念速查 numa、绑定工具 numactl、节点内存统计 numastat、缓存一致性 mesi、热点定位 perf。