TCP 流量控制、拥塞控制与高并发服务端可控项
核心问题:做高并发服务端时,TCP 协议栈哪些行为会影响吞吐和延迟?我们能通过 socket 选项和内核参数控制哪些东西?流量控制(rwnd)和拥塞控制(cwnd)如何决定你能"发多快",以及如何在延迟、吞吐、内存三者间做权衡?
本文是 kernel-tuning-net 的姊妹篇——那篇讲"连接进得来、fd 够不够、中断怎么散"的连接层面调优,本篇讲"连接建立之后,数据怎么发得快又稳"的传输层面控制。
零、先有个全局视角:一条数据要发出去,被谁限了速?
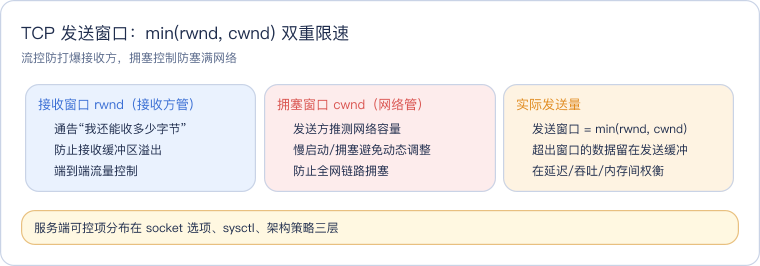
TCP 发送端每时每刻都被两个窗口掐着脖子:
实际可发送数据量 = min(接收窗口 rwnd, 拥塞窗口 cwnd)
rwnd(接收方管)                  cwnd(网络管)
─────────────────────────────────────────────────
接收方通告:"我还能收 X 字节"      发送方推测:"网络还能塞 X 字节"
防止接收方缓冲区溢出               防止网络链路拥塞
端到端的流控 全网视角的拥塞控制 应用层发送缓冲区
│
▼
┌─────────────────────┐
│ min(rwnd, cwnd) │ ◄── TCP 发送窗口
│ 实际可发送数据量 │
└─────────────────────┘
│
▼
网络链路 → 接收方做服务端时你的控制力分布在这三层:
下面这张概念卡先把「发送速度被谁限制」这件事一图收束:实际能发的数据永远取接收窗口与拥塞窗口的较小值,rwnd 是端到端的接收方流控、cwnd 是全网视角的拥塞推测,二者缺一不可。
| 层级 | 你能控制什么 | 本文章节 |
|---|---|---|
| socket 选项(代码级) | TCP_NODELAY / TCP_CORK / SO_RCVBUF / SO_SNDBUF / TCP_QUICKACK / TCP_CONGESTION / TCP_KEEP* / TCP_USER_TIMEOUT | 三 |
| 内核 sysctl(系统级) | tcp_congestion_control / tcp_rmem / tcp_wmem / tcp_slow_start_after_idle / tcp_notsent_lowat 等 | 四 |
| 架构设计(策略级) | 长连接 vs 短连接 / 连接池 / 应用层缓冲策略 / 算法选型 | 五 |
一、流量控制(Flow Control):接收方不被打爆
1.1 rwnd 怎么来的
接收方每发一个 ACK,都在 TCP 头里带一个 Window Size 字段(16 位),告诉发送方"我接收缓冲区还剩 X 字节"。
发送方                          接收方
  │                               │
  │──── DATA(seq=1~1000) ────────▶│  buf 剩 64KB
  │                               │
  │◄─── ACK(ack=1001, win=64512) ─│  通告:"我还能收 63KB"
  │                               │
  │  send_window = min(64512, cwnd)
│ 只能再发 ≤ 64512 字节- 发送方维护
snd_wnd(当前 rwnd),接收方每通告一次就更新 - 如果应用层
recv()太慢,接收缓冲区被积压 → rwnd 缩小 → 发送方被迫减速 - rwnd 降到 0 → 零窗口,发送方停止发数据,只发 零窗口探测(Persist Timer)
1.2 Window Scale Option(窗口缩放)
16 位的 Window Size 最大只能表示 64KB——这在现代网络上根本不够。TCP 在三次握手时协商 Window Scale Factor(即 rwnd 左移 N 位):
实际窗口 = Window Size << ScaleFactor
ScaleFactor = 7 → max rwnd = 65536 << 7 = 8MB
ScaleFactor = 14 → max rwnd = 65536 << 14 = 1GB(理论上限)
Windows (sysctl) 层面,接收缓冲区上限由 net.ipv4.tcp_rmem[2] 决定,内核 autotuning 会自动调大 scale factor。
1.3 Silly Window Syndrome & Nagle 算法
Silly Window Syndrome(SWS,糊涂窗口综合征):接收方每次只读几个字节,通告的 rwnd 极小;发送方每次只发几个字节,TCP 头比数据还大——带宽严重浪费。
两端的对策:
- 接收方:David Clark 算法——rwnd 不够大(小于
min(MSS, buf/2))时直接通告 0,等缓冲区腾出足够空间再通 - 发送方:Nagle 算法——连接上只能有一个未确认的小包(小于 MSS),攒到 MSS 大小或收到之前包的 ACK 才发下一个
Nagle 规则:
  如果待发数据 < MSS 且前面还有未确认的包
    → 等到:① 累积满 MSS 或 ② 收到 ACK
  否则
→ 立即发送服务端关键选择:Nagle 在延迟敏感场景(HTTP 响应+ACK 被拖一个 RTT)会坏事——这就是
TCP_NODELAY的由来(见 §3.2)。
1.4 Delayed ACK
接收方不必每个包都立刻回 ACK,可以等 40~500ms(通常是 200ms),合并多个 ACK 成一个。但这会拖慢发送方的 cwnd 增长(因为 cwnd 依赖 ACK 来推进滑动窗口)。
Delayed ACK 副作用:
  - 和 Nagle 算法叠加 → "40ms 延迟问题"(ACK 等数据、数据等 ACK)
  - 慢启动阶段放大了延迟
对策见
TCP_QUICKACK(§3.4)。
1.5 你怎么控制 rwnd
最直接的手段:把接收缓冲区调够大。
# 系统级(每 socket 默认值 & autotuning 范围)
net.ipv4.tcp_rmem = "4096  131072  6291456"
#                   最小   默认    最大
net.core.rmem_max = 6291456    # 单 socket 上限
代码级:
int rcvbuf = 4 * 1024 * 1024;  // 4MB
setsockopt(fd, SOL_SOCKET, SO_RCVBUF, &rcvbuf, sizeof(rcvbuf));注意:
setsockopt(SO_RCVBUF)必须在listen()之前(对 accept 出来的 fd,继承自 listen fd),且内核会把值翻倍(给 sk_buff 等元数据留空间),所以 set 2MB 实际可能拿到 4MB。
权衡:rwnd 大 → 容许对端高速发送、不易因应用层读取延迟而回压;但每连接占更多内存。高并发下要在"让对端发得爽"和"内存总量可控"之间取平衡。
二、拥塞控制(Congestion Control):网络不被塞爆
2.1 拥塞窗口 cwnd 怎么算
rwnd 管端到端,cwnd 管全链路。发送方自己维护 cwnd,根据丢包(传统算法)或 RTT 变化(BBR)动态调整。
发送速率 ∝ cwnd / RTT
cwnd 大 → 发得快 → 可能塞爆网络
cwnd 小 → 发得慢 → 带宽利用率低
2.2 经典算法演进
| 算法 | 年代 | 核心思路 | 问题 |
|---|---|---|---|
| Tahoe | 1988 | 慢启动(cwnd 指数增长)→ 丢包时 cwnd 降到 1 MSS | 恢复太慢 |
| Reno | 1990 | Tahoe + Fast Retransmit + Fast Recovery(丢包不降到 1,降到一半再线性增长) | 多个丢包窗口缩多次 |
| NewReno | 1999 | Reno + 同一窗口多个丢包只缩一次 | 基本够用,但仍依赖丢包 |
经典算法都假设"丢包 = 拥塞",但在丢包率较高的网络(无线、数据中心浅缓冲区)上会误判。
2.3 CUBIC(Linux 默认,内核 2.6.19+)
CUBIC = Reno 的思路 + 三次函数做窗口增长曲线
核心公式:cwnd = C × (t - K)³ + W_max
  - W_max:上次丢包时的 cwnd
  - t:距离上次丢包的时间
  - K = ³√(W_max × β / C)(到达 W_max 所需时间)
  - β = 0.2(乘性减因子:丢包后 cwnd = 0.8 × W_max)
CUBIC 的关键洞察:接近 W_max 时增长放缓(凹区间),远低于 W_max 时快速增长、超过后加速探测(凸区间)。比 Reno 在大带宽长 RTT(LFN)上更能利用闲置带宽。
cwnd
  │
  │                    ╱
  │                  ╱   CUBIC 凸区间(加速探测新上限)
  │                ╱
  │        W_max ───────────────────────── 上次丢包位置
  │          ╲    ╱
  │            ╲╱     CUBIC 凹区间(接近 W_max 时放缓)
  │           ╱
  │         ╱
  │───────╱────────────────────────────▶ 时间
         ↑
       丢包时刻
2.4 BBR(Bottleneck Bandwidth and RTT,Google 2016)
BBR 的核心思想:不追丢包,追带宽和 RTT。
传统算法的根本问题是"把丢包当拥塞信号"——但在有 buffer 的路由器里,cwnd 要涨到缓冲区满才丢包,此时延迟已经爆表(bufferbloat)。BBR 换了个模型:
BBR 维护两个估计量:
  - RTprop(最小 RTT):网络物理延迟下限
  - BtlBw(瓶颈带宽):链路最大吞吐
BBR 状态机:
  Startup  → Drain    → ProbeBW    → ProbeRTT
(快速探测) (排空队列) (周期性探测) (更新 RTprop)| 阶段 | 做什么 | 持续 |
|---|---|---|
| Startup | cwnd 以 2/ln2 倍指数增长,类似慢启动但更快 | 带宽不再显著增长时退出 |
| Drain | 降低发送速率排空路由器缓冲区(消除排队延迟) | inflight 降到 BDP 以下 |
| ProbeBW | 在 BDP 附近周期波动(增益 [5/4, 3/4, 1, 1, 1, 1, 1, 1])探测额外带宽 | 主稳态 |
| ProbeRTT | 每隔 ~10s 缩 cwnd 到 4×MSS,测量真实 RTprop | 短暂 |
BBR 的优势:在 bufferbloat 环境(路由器缓冲区大且满)延迟极低;丢包不影响发送速率;适合长肥管道(LFN)和跨国链路。
BBR 的代价:Startup 阶段激进,可能挤占其他流的带宽;多流共存时公平性略差(BBRv2 改进了这点,内核 5.19+ 已合入)。
2.5 CUBIC vs BBR:怎么选
| 维度 | CUBIC | BBR |
|---|---|---|
| 核心信号 | 丢包(loss-based) | RTT + 带宽(model-based) |
| bufferbloat 下延迟 | 高(填满缓冲区才丢包) | 低(主动避让缓冲区) |
| 丢包率高(>1%)吞吐 | 暴跌(丢包 → cwnd/2) | 几乎不受影响 |
| 多流公平性 | 好 | BBRv1 略差、BBRv2 改善 |
| 适用场景 | 传统有线网络、丢包率低 | 无线/WiFi、跨境/高延迟、数据中心浅缓冲区、视频流 |
| CPU 开销 | 低 | 中等(更多计算) |
2.6 你怎么控制拥塞算法
系统级(改默认):
# 查看当前默认算法
sysctl net.ipv4.tcp_congestion_control
# 查可用算法
sysctl net.ipv4.tcp_available_congestion_control
# 切换到 BBR
echo "bbr" > /proc/sys/net/ipv4/tcp_congestion_control
# 持久化
echo "net.ipv4.tcp_congestion_control = bbr" >> /etc/sysctl.conf
代码级(per-socket 切换):
// C 语言
setsockopt(fd, IPPROTO_TCP, TCP_CONGESTION, "bbr", 3);
// Go 语言
rawConn, _ := tcpConn.SyscallConn()
rawConn.Control(func(fd uintptr) {
    syscall.SetsockoptString(int(fd), syscall.IPPROTO_TCP, syscall.TCP_CONGESTION, "bbr")
})注意:BBR 需要内核 ≥ 4.9 且模块已加载(
modprobe tcp_bbr)。per-socket切换意味着你可以在同一台机器上对不同连接用不同算法。
三、应用层可控项(setsockopt 旋钮大全)
这是你不会想改系统全局、只想在代码里针对特定连接调的东西。
3.1 SO_SNDBUF / SO_RCVBUF —— 收发缓冲区
int size = 256 * 1024;  // 256KB
setsockopt(fd, SOL_SOCKET, SO_SNDBUF, &size, sizeof(size));
setsockopt(fd, SOL_SOCKET, SO_RCVBUF, &size, sizeof(size));| 参数 | 影响 |
|---|---|
SO_RCVBUF ↑ | 对端 rwnd 更大 → 对端能发更快。高吞吐下载场景关键。 |
SO_SNDBUF ↑ | 本地应用写数据有更多缓冲空间,减少 write() 阻塞概率。 |
| 都调小 | 省内存,但限制吞吐,适用于大量低流量长连接。 |
规则:内核实际值 = max(min(你 set 的值 × 2, rmem_max/wmem_max), rmem_min/wmem_min)。高并发时注意
setsockopt要在listen()前设(accept 继承)。
3.2 TCP_NODELAY —— 关掉 Nagle(最重要、最常用)
int on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_NODELAY, &on, sizeof(on));
什么场景必须开:
- HTTP/RPC 服务端 响应(一个 write 就是完整响应,不需要攒包)
- 实时交互(SSH、游戏、聊天、websocket)
- 小请求-小响应模式(Redis、Memcached)
开了会怎样: 每次 write() 都立即发送(尽量),不等待 ACK 也不攒包。代价是可能产生更多的小包(降低网络效率),但在 ping-pong 模式下延迟大幅下降。
一句话:做任何交互式服务端,第一件事就是
TCP_NODELAY。
3.3 TCP_CORK —— 主动合并发送(Linux 特有)
int on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_CORK, &on, sizeof(on));
// ... 连续 write 多次 ...
on = 0;
setsockopt(fd, IPPROTO_TCP, TCP_CORK, &on, sizeof(on));  // 最后一枪发出
TCP_CORK 是 Nagle 的升级版——强制攒数据,直到:
- 你关掉 CORK,或
- 攒的数据超过 MSS
适用场景:
- HTTP 响应:header + body 分两次
write,CORK 让它们合并成一个 TCP 段发出 - 文件下载:一次读一块,攒满 MSS 再发
sendfile()之前想先写点自定义 header
区别于 TCP_NODELAY:NODELAY 是"别等",CORK 是"等我说了再发"。二者互斥,不能同时用。
3.4 TCP_QUICKACK —— 关掉 Delayed ACK
int on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_QUICKACK, &on, sizeof(on));让接收端每个包都立刻回 ACK,不再等 40~200ms。
适用场景:
- 发送方在慢启动阶段(ACK 越快,cwnd 涨得越快)
- 接收方已知对端在等 ACK 推进窗口
- 短连接交互(发完就关)
注意:这是个"一次性"选项——用完可能被内核重置。可以每次
recv()后都设一次,或者在 accept 出来的 fd 上设。
3.5 TCP_CONGESTION —— 换拥塞算法
setsockopt(fd, IPPROTO_TCP, TCP_CONGESTION, "bbr", 3);同一个进程可以给不同连接用不同算法:
- CDN 回源长连接 → BBR(跨国高延迟)
- 数据中心内短连接 → CUBIC(低延迟、丢包极低)
- 客户端 WiFi 连接 → BBR(无线丢包)
3.6 TCP_DEFER_ACCEPT —— 等应用端有数据才通知 accept
int timeout = 5;  // 最多等 5 秒
setsockopt(fd, IPPROTO_TCP, TCP_DEFER_ACCEPT, &timeout, sizeof(timeout));
正常情况下三次握手一完成就通知 accept()。开了这个 → 内核等到对端发了第一个数据包才通知 accept(),减少无意义的唤醒。
对 HTTP keep-alive 短请求场景有效:客户端 connect 后立即发请求,这时才唤醒 accept。
3.7 TCP_FASTOPEN —— 零 RTT 快速打开
int qlen = 5;
setsockopt(fd, IPPROTO_TCP, TCP_FASTOPEN, &qlen, sizeof(qlen));
传统 TCP 三次握手才能发数据(两个 RTT)。TFO 允许在 SYN 包里就带上数据,省一个 RTT。客户端用 sendto(fd, data, len, MSG_FASTOPEN, ...) 代替 connect() + write()。
适合:CDN、频繁重建连接的场景。需要内核开启
net.ipv4.tcp_fastopen=3。
3.8 TCP_KEEPALIVE 四件套
int keepalive = 1;
int idle = 60;      // 60 秒无数据后开始探测
int interval = 10;  // 每 10 秒发一次探测
int count = 3;      // 3 次探测无响应就认为断开
setsockopt(fd, SOL_SOCKET,    SO_KEEPALIVE,   &keepalive, sizeof(keepalive));
setsockopt(fd, IPPROTO_TCP,   TCP_KEEPIDLE,   &idle,      sizeof(idle));
setsockopt(fd, IPPROTO_TCP,   TCP_KEEPINTVL,  &interval,  sizeof(interval));
setsockopt(fd, IPPROTO_TCP, TCP_KEEPCNT, &count, sizeof(count));作用:长连接"假死"检测——对端崩溃/断网、没有发 FIN,不探测就永远挂在 ESTABLISHED。用于代理/网关/数据库连接池保持。
不调的危险:默认
TCP_KEEPIDLE=7200(2 小时),连接池里的死连接两小时才清理——你扛不住的。
3.9 TCP_USER_TIMEOUT —— 数据确认超时
unsigned int timeout = 30000;  // 30 秒
setsockopt(fd, IPPROTO_TCP, TCP_USER_TIMEOUT, &timeout, sizeof(timeout));
发送数据后多长时间没被 ACK 就断开连接(Linux 2.6.37+)。比 keepalive 更直接——这是发送端侧的死亡判定。和 keepalive 的区别:
| 特性 | Keepalive | TCP_USER_TIMEOUT |
|---|---|---|
| 触发条件 | 连接空闲 | 数据未被确认 |
| 粒度 | 至少几秒 | 毫秒级 |
| 用途 | 发现"静默断开" | 控制"重传多久后放弃" |
如果你希望"30 秒内发不过去就算了",设
TCP_USER_TIMEOUT=30000比调tcp_retries2更直观。
3.10 总表:socket 级旋钮一览
| 选项 | 作用 | 默认 | 典型值 | 场景 |
|---|---|---|---|---|
TCP_NODELAY | 关 Nagle | 关(Nagle 开) | 开 | 所有交互式服务端 |
TCP_CORK | 攒数据到满 MSS 或关掉 | 关 | 按需开关 | HTTP 响应合并 |
TCP_QUICKACK | 立即 ACK | 关(Delayed ACK) | 按需 | 慢启动加速 |
SO_RCVBUF | 接收缓冲区 | 131072 | 1MB~8MB | 大流量下载 |
SO_SNDBUF | 发送缓冲区 | 16384 | 256KB~4MB | 大流量上传 |
TCP_CONGESTION | 拥塞算法 | cubic | bbr / cubic | 按链路选 |
TCP_DEFER_ACCEPT | 有数据才 accept | 关 | 1~5 秒 | HTTP 服务 |
TCP_FASTOPEN | SYN 带数据 | 关 | 按需 | CDN/短连接 |
TCP_KEEPIDLE | 开始探测前空闲期 | 7200s | 60s | 所有长连接 |
TCP_KEEPINTVL | 探测间隔 | 75s | 10s | 同上 |
TCP_KEEPCNT | 探测次数 | 9 | 3 | 同上 |
TCP_USER_TIMEOUT | 未确认即断开 | ≈15min | 30s | 控制失败重试上限 |
四、系统级内核参数(sysctl)
这些参数影响所有连接的基础行为。调之前用 sysctl 看当前值,改完用观测工具验证效果。
4.1 拥塞控制全局参数
# 系统默认拥塞算法(所有新连接用这个)
net.ipv4.tcp_congestion_control = cubic
# 空闲后重设 cwnd(从慢启动开始)——高并发长连接建议关掉
net.ipv4.tcp_slow_start_after_idle = 1  # 默认 1,建议设 0
# 应用层已写但尚未确认的最小缓冲量(达到后内核通知 EPOLLOUT)
net.ipv4.tcp_notsent_lowat = -1 # 默认 -1(关),对异步发送有优化价值tcp_slow_start_after_idle:连接空闲一段时间(1 个 RTO)后,cwnd 被重置为 initcwnd(10×MSS),重新慢启动。对于间歇性流量的长连接(如 HTTP keep-alive 下一波请求间隔几分钟),这会严重影响吞吐——空下来再发,速度上不去。高并发代理/网关建议关掉。
4.2 收发缓冲区全局参数
# 读缓冲区范围 [min, default, max]
net.ipv4.tcp_rmem = "4096  131072  6291456"
# 写缓冲区范围
net.ipv4.tcp_wmem = "4096  16384   4194304"
# 单 socket 读写缓冲区的硬上限(setsockopt 不能超过这个)
net.core.rmem_max = 212992
net.core.wmem_max = 212992  # 对发送端很关键:默认 208KB 太小
对高并发最关键的是 tcp_rmem[2](最大读缓冲)和 wmem_max(写缓冲上限)。
- 如果客户端/下游在高延迟链路(跨国),
wmem_max太小 → cwnd 涨不大 → 带宽利用率低 rmem_max决定 rwnd 上限 = 对端发送上限
4.3 重传与超时
# 重试几次后报告网络层断连
net.ipv4.tcp_retries1 = 3   # 重试 3 次后触发 PMTU 发现/报告路由问题
net.ipv4.tcp_retries2 = 15  # 重试 15 次后放弃连接(≈13~30 分钟)
# TCP 重传最小超时(ms)——数据中心内可以降到 50ms 加快恢复
net.ipv4.tcp_rto_min = 200  # 默认 200ms
tcp_retries2 是 TCP 重传的死亡线。默认 15 → 实际超时约 15 分钟。如果要"30 秒连不上就断",别动这个全局参数,用 TCP_USER_TIMEOUT 逐连接控制。
4.4 其他对传输行为有影响的参数
# initcwnd:初始拥塞窗口大小(×MSS)。太低 → 慢启动慢、小文件传输慢
net.ipv4.tcp_init_cwnd = 10  # Google 建议 10(RFC 6928)
# TSO(TCP Segmentation Offload):把大的虚拟包分段卸载到网卡
# 对发送吞吐有益,通常不要关
ethtool -K eth0 tso on
# 时间戳:用于 RTTM 精确测量(BBR 依赖此功能)
net.ipv4.tcp_timestamps = 1
# 选择性确认(SACK):丢包后只需要重传丢失的部分,不用重传整个窗口
net.ipv4.tcp_sack = 1
五、高并发场景的决策指南
不同场景的瓶颈不同,选错了算法和选项会适得其反。
5.1 场景一:大量短连接(HTTP/1.0 直连,无连接池)
特征:连接数多但每个连接只有 1 个请求-响应周期,频繁建连、拆连。
| 问题 | 对策 |
|---|---|
| TIME_WAIT 堆积 → 端口耗尽 | tcp_tw_reuse=1 + 扩展 ip_local_port_range + 上连接池(根治) |
| 每次慢启动 → 小文件延迟高 | init_cwnd=10(已默认) |
| Delayed ACK 拖慢慢启动 | TCP_QUICKACK |
| 三次握手开销大 | TCP_FASTOPEN(省一个 RTT) |
| 拥塞算法 | CUBIC 即可(丢包率极低时够用) |
// 短连接模板
int fd = socket(...);
int on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_NODELAY, &on, sizeof(on));  // 别攒包
setsockopt(fd, IPPROTO_TCP, TCP_QUICKACK, &on, sizeof(on)); // 快 ACK
connect(fd, ...);
write(fd, ...);  // 单写,不 CORK
read(fd, ...);
close(fd);
5.2 场景二:长连接代理/网关(连接池复用、间歇性流量)
特征:连接数不过万但每条连接寿命长,可能在两次 RPC 之间空闲几秒甚至几分钟。
| 问题 | 对策 |
|---|---|
| 假死连接 | TCP_KEEPIDLE=60, TCP_KEEPINTVL=10, TCP_KEEPCNT=3 |
| 空闲后 cwnd 重置 → 恢复时吞吐暴跌 | tcp_slow_start_after_idle=0(关掉) |
| 连接池过期 | 应用层 idle timeout + TCP_USER_TIMEOUT |
| 跨国链路高延迟 | TCP_CONGESTION=bbr |
// 长连接模板
int fd = socket(...);
int on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_NODELAY, &on, sizeof(on));
// keepalive
setsockopt(fd, SOL_SOCKET, SO_KEEPALIVE, &on, sizeof(on));
int idle=60, intvl=10, cnt=3;
setsockopt(fd, IPPROTO_TCP, TCP_KEEPIDLE,  &idle,  sizeof(idle));
setsockopt(fd, IPPROTO_TCP, TCP_KEEPINTVL, &intvl, sizeof(intvl));
setsockopt(fd, IPPROTO_TCP, TCP_KEEPCNT,   &cnt,   sizeof(cnt));
// 30 秒发不出去就断
int timeout = 30000;
setsockopt(fd, IPPROTO_TCP, TCP_USER_TIMEOUT, &timeout, sizeof(timeout));
connect(fd, ...);
// 连接复用,多次 write/read ...
5.3 场景三:大文件/大响应传输(CDN 回源、文件分发、视频流)
特征:数据量大、单连接持续传输、对吞吐敏感。
| 问题 | 对策 |
|---|---|
| 发送缓冲区不够 → cwnd 涨不起来 | SO_SNDBUF 调大 + wmem_max 调大(BDP 级别) |
| 分多次 write 产生碎片 | TCP_CORK 合并写入 |
| 内核到用户的拷贝 | sendfile() 零拷贝(详见 zero-copy) |
| 长肥管道(高带宽 × 高延迟) | BBR(比 CUBIC 在长肥管道上吞吐高很多) |
// 大文件发送模板
int fd = socket(...);
int on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_NODELAY, &on, sizeof(on));  // 关 Nagle
// 大发送缓冲区
int sndbuf = 4 * 1024 * 1024;  // 4MB
setsockopt(fd, SOL_SOCKET, SO_SNDBUF, &sndbuf, sizeof(sndbuf));
// BBR
setsockopt(fd, IPPROTO_TCP, TCP_CONGESTION, "bbr", 3);
// 使用 TCP_CORK 合并 header + data
on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_CORK, &on, sizeof(on));
write(fd, header, hdr_len);    // header
write(fd, data, data_len);     // body——这两个在网络层合并成一个 segment
on = 0;
setsockopt(fd, IPPROTO_TCP, TCP_CORK, &on, sizeof(on));  // 发出
// 或直接用 sendfile()
sendfile(fd, file_fd, &offset, file_size);
5.4 场景四:低延迟直连(金融交易、游戏服务器)
特征:宁可牺牲吞吐也要保证延迟在毫秒级。
| 问题 | 对策 |
|---|---|
| Nagle + Delayed ACK 互锁 40ms | TCP_NODELAY + TCP_QUICKACK 同时开 |
| CUBIC 填满路由器缓冲区,延迟飙升 | 切换到 BBR(主动避让缓冲区) |
| CPU 调度延迟 | SO_INCOMING_CPU / SO_REUSEPORT 绑核 |
int fd = socket(...);
int on = 1;
setsockopt(fd, IPPROTO_TCP, TCP_NODELAY,  &on, sizeof(on));
setsockopt(fd, IPPROTO_TCP, TCP_QUICKACK, &on, sizeof(on));
setsockopt(fd, IPPROTO_TCP, TCP_CONGESTION, "bbr", 3);
5.5 场景五:大量低流量长连接(IoT/MQTT 保持在线)
特征:几十万连接,每条流量极小(每分钟几字节),memory-sensitive。
| 问题 | 对策 |
|---|---|
| 每连接缓冲区占内存 | SO_RCVBUF/SO_SNDBUF 调小(如 4KB) |
| 仅靠 keepalive 可能漏检 | 应用层心跳(MQTT PINGREQ/PINGRESP) |
| 大量连接 fd 压垮 epoll | 见 epoll 的 ET + 多 Reactor |
六、如何验证你的选择:观测与诊断
调完参数,你必须能证明确实生效了。
6.1 看拥塞算法和 cwnd
# 每条连接的拥塞算法和窗口详情
ss -ti
# 输出示例:
# cubic wscale:7,7 rto:200 rtt:0.5/0.2 mss:1448 cwnd:10 ssthresh:7 ...
#                      ↑RTT(ms)        ↑MSS       ↑cwnd(×MSS)
# 注意:ss -ti 显示的 cwnd 单位是 MSS!实际 cwnd = 10 × 1448 = 14480 字节
# 筛选特定连接
ss -ti state established dst 10.0.0.1
6.2 看发送/接收队列积压
ss -tnp
# Recv-Q(接收队列积压)  Send-Q(发送队列)
#      0                 0           ... 正常
#      0               128456        ... 发送被 cwnd 或 rwnd 卡住了
#   65536                 0          ... 应用层 recv() 太慢,接收缓冲区要满了
6.3 看 TCP 统计(全局)
# 看重传统计
netstat -s | grep -i retrans
# 看 BBR 特有的统计(如果用了 BBR)
cat /sys/kernel/debug/tcp_bbr
# 看当前拥塞算法和可用列表
sysctl net.ipv4.tcp_congestion_control
sysctl net.ipv4.tcp_available_congestion_control
6.4 看实际缓冲区大小
# 看内核实际分配的缓冲区大小(不是你 setsockopt 的值)
ss -timp
# 每连接的详细信息,包含:
#   skmem:(rX,rbY,tZ,tbW,fU,wV,oO)
#   rb = 实际接收缓冲区大小 = 对端可见的 rwnd 上限
#   tb = 实际发送缓冲区大小
七、和本仓库其他文档的关系
| 相关文档 | 内容 | 与本文的关系 |
|---|---|---|
| kernel-tuning-net | 连接队列、fd 上限、TIME_WAIT、网卡中断 | 那篇管"连接怎么进来",这篇管"进来的数据怎么发" |
| overview | 高并发导读:C10K→C10M | 本文是"瓶颈②(每次 IO 的 CPU 开销)"在 TCP 传输层的深入 |
| epoll | epoll 原理 | 本文的 socket 选项(NODELAY/CORK/QUICKACK)直接影响 epoll 事件处理的延迟 |
| thread-models | Reactor/Proactor 线程模型 | 线程模型决定谁调 setsockopt、何时调 |
| zero-copy | sendfile/splice/mmap | 本文 §5.3 引用零拷贝,是大流量传输场景的标配 |
| ss | ss 工具详解 | 本文 §6 观测命令的详细用法在那篇 |
八、一句话总结
做高并发服务端,TCP 能控制的核心就六个维度:关 Nagle(TCP_NODELAY)、调缓冲区(SO_SNDBUF/SO_RCVBUF)、选拥塞算法(CUBIC vs BBR)、定连接死线(keepalive + TCP_USER_TIMEOUT)、控制 ACK 节奏(QUICKACK/CORK)、别让空闲重置慢启动(tcp_slow_start_after_idle=0)。记住公式:实际发送速率 ≤ min(rwnd, cwnd) / RTT,调哪边取决于你的场景是"接收方慢"还是"链路堵"。