Linux 与 FPGA 通信的方式 —— 从 MMIO 到 DMA
FPGA 加速卡插在服务器的 PCIe 插槽上,主机 CPU 怎么跟它通信?这个问题本质上是"两个设备挂在同一条 PCIe 总线上,怎么交换数据"——跟 CPU 和网卡/NVMe/GPU 的通信是一回事,但 FPGA 更灵活:你可以在 FPGA 里实现任意接口。本篇系统化梳理 Linux 下与 FPGA 通信的所有方式,从最原始到最高级,讲清每种方式的原理、适用场景和性能对比。
相关:FPGA 为什么必须用 DMA 见 dma §五,PCIe 总线的物理传输通道(拓扑/BAR/MMIO)见 pcie,中断处理见 interrupts。
零、先看全景:一张图讲清所有方式
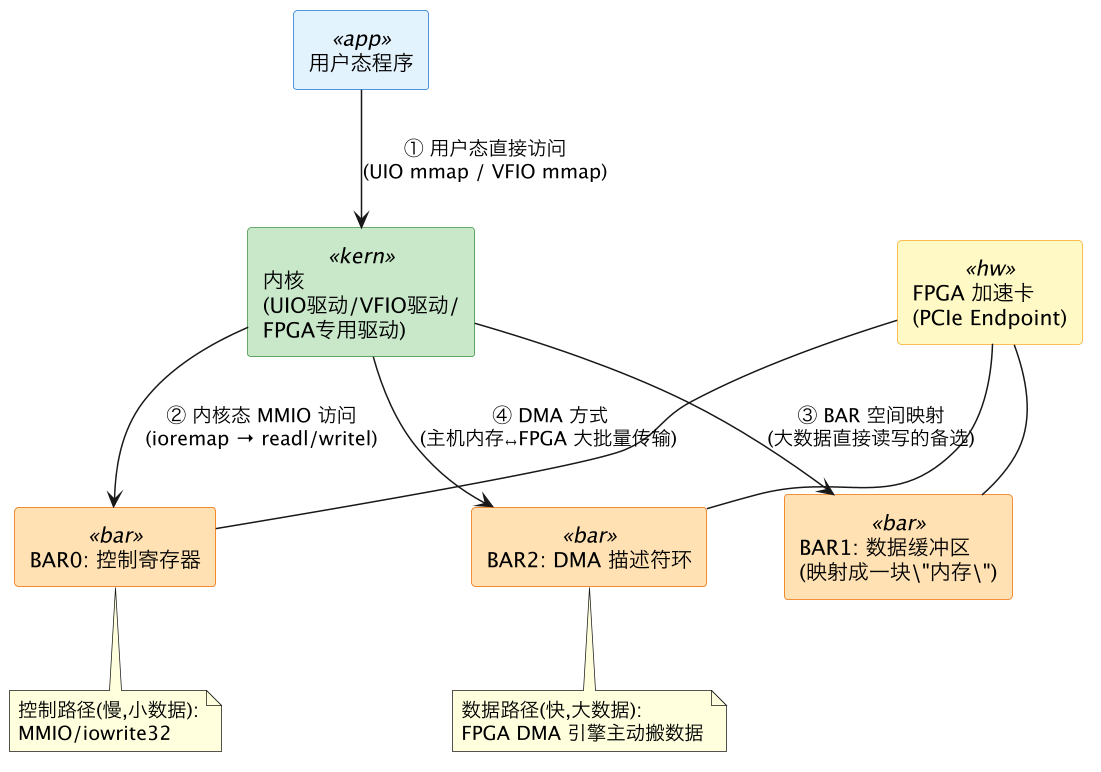
核心认知:FPGA 通信分两条路径——控制路径(MMIO,CPU 主动读写 FPGA 寄存器,慢但简单)和数据路径(DMA,FPGA 主动搬大批量数据,快但复杂)。选哪种方式取决于数据量和实时性要求。
一、方式 1:MMIO(Memory-Mapped I/O)—— CPU 主动读写 FPGA 寄存器
原理
FPGA 在 PCIe 枚举时通过 BAR 向系统声明一段地址空间。CPU 用普通访存指令就能读写这段空间——硬件上,CPU 的 load/store 落到这个地址范围时,Root Complex 把它翻译成 PCIe Memory Read/Write TLP,发到 FPGA。
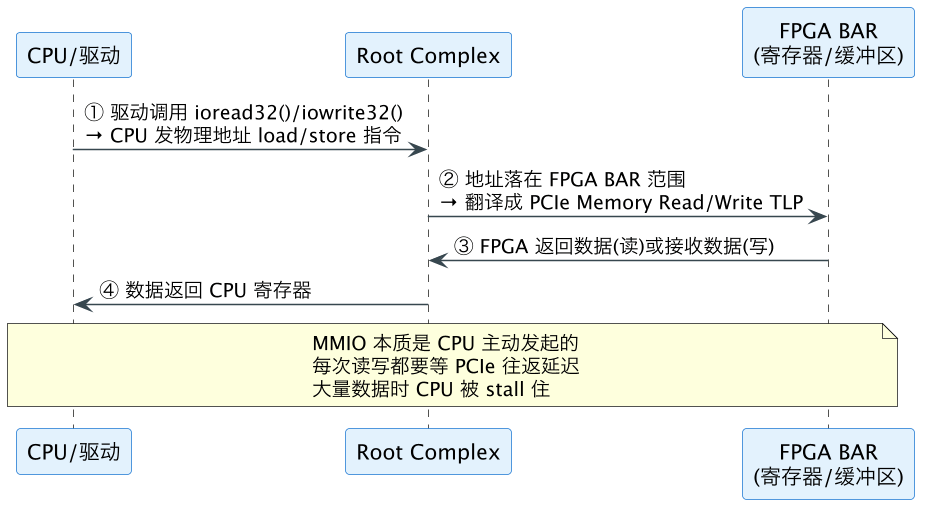
代码层面
// 内核驱动中
void __iomem *bar0 = ioremap(pci_resource_start(pdev, 0), pci_resource_len(pdev, 0));
u32 status = ioread32(bar0 + STATUS_REG_OFFSET);   // 读状态寄存器
iowrite32(CMD_START, bar0 + CMD_REG_OFFSET);        // 写命令寄存器
特点
| 维度 | 评价 |
|---|---|
| 带宽 | 低,每次 4/8 字节,受 PCIe 往返延迟限制(~几百 ns 一次) |
| CPU 占用 | 高,CPU 全程参与每次读写 |
| 延迟 | 低(单次访问),适合控制命令 |
| 适用数据量 | 少量控制数据(KB 级),如写命令寄存器、读状态、配置参数 |
| 实现复杂度 | 低,内核标准 API |
一句话:MMIO 是控制路径——用
ioread32/iowrite32读写 FPGA 寄存器,简单但只能传小量控制信息。想传 MB/GB 级数据?必须上 DMA。
二、方式 2:DMA —— FPGA 主动读写主机内存
原理
FPGA 内部实现一个 DMA 引擎 IP 核,让它成为 PCIe 总线主设备(Bus Master),能主动发起对主机内存的读写。CPU 只需告诉 FPGA"数据在主机内存的物理地址 0x...、长度 N"——FPGA 自己把活干完,完事发中断通知 CPU。
完整流程见 dma §五 的时序图,这里不再重复。重点讲 FPGA DMA 的三种实现方式:
2.1 三种 DMA 模式

描述符环 DMA(最常用):
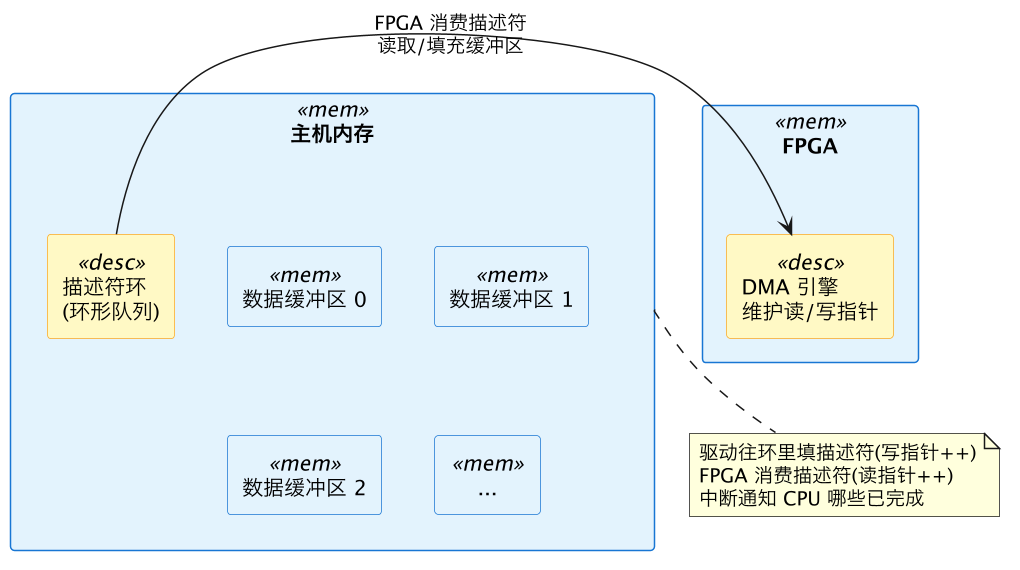
2.2 FPGA DMA 的内核驱动实现要点
// 1. 分配 DMA 缓冲区
dma_addr_t dma_handle;
void *cpu_addr = dma_alloc_coherent(&pdev->dev, BUF_SIZE, &dma_handle, GFP_KERNEL);
// 2. 把物理地址告诉 FPGA(通过 MMIO 写 FPGA 寄存器)
iowrite32(lower_32_bits(dma_handle), bar0 + DMA_SRC_ADDR_LO);
iowrite32(upper_32_bits(dma_handle), bar0 + DMA_SRC_ADDR_HI);
iowrite32(BUF_SIZE, bar0 + DMA_LEN);
iowrite32(DMA_START, bar0 + DMA_CTL);  // 启动
// 3. 等 FPGA 中断通知完成
wait_event_interruptible(fpga_dev->dma_wq, fpga_dev->dma_done);
// 4. 处理数据、回收缓冲区
process_data(cpu_addr);
特点
| 维度 | 评价 |
|---|---|
| 带宽 | 高,可达 PCIe 线速(Gen4 x16 ≈ 32GB/s) |
| CPU 占用 | 极低(只在启动和完成中断时参与) |
| 延迟 | 单次传输有启动开销(μs 级),持续流式传输延迟低 |
| 适用数据量 | MB~GB 级大数据 |
| 实现复杂度 | 高,需要 FPGA 端实现 DMA 引擎 + 驱动端管理描述符队列和中断 |
三、方式 3:UIO(Userspace I/O)—— 把 FPGA 寄存器暴露给用户态
原理
UIO(Userspace I/O) 是一个极简的内核驱动框架:内核只负责处理中断,把设备寄存器的物理地址通过 mmap 映射给用户态程序——用户态程序直接 mmap 后读写 FPGA 寄存器,完全绕过内核。
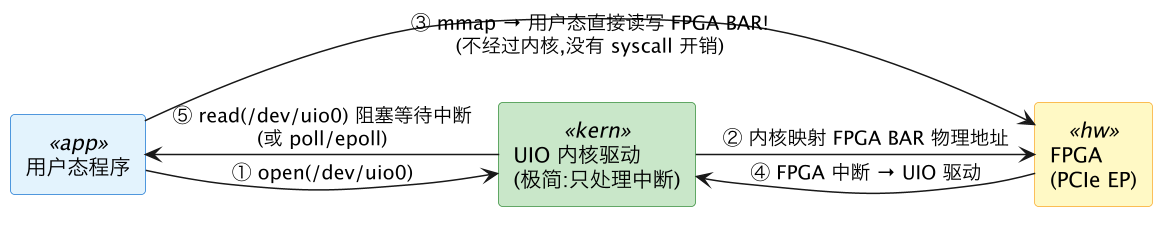
代码示例
// 用户态程序
int fd = open("/dev/uio0", O_RDWR);
// mmap FPGA 的 BAR 空间到用户态
void *bar0 = mmap(NULL, BAR0_SIZE, PROT_READ | PROT_WRITE,
                  MAP_SHARED, fd, 0);
// 直接读写 FPGA 寄存器!(没有系统调用)
volatile uint32_t *reg = (uint32_t *)(bar0 + REG_OFFSET);
*reg = CMD_START;                    // 写命令
uint32_t status = *reg;              // 读状态
// 等中断
uint32_t irq_count;
read(fd, &irq_count, sizeof(irq_count));  // 阻塞直到 FPGA 发中断
特点
| 维度 | 评价 |
|---|---|
| 延迟 | 极低(无系统调用、无内核往返) |
| 吞吐 | 同 MMIO(受限于 CPU 搬数据的速度) |
| 开发难度 | 低(用户态编程,不用写内核驱动) |
| 安全性 | 差(用户态直接访问硬件,没有权限控制) |
| DMA 支持 | UIO 本身不支持 DMA;需要配合 uio_dmem_genirq 等变体,或自己写混合驱动 |
| 适用场景 | 快速原型、实验室环境、对安全要求不高的场景 |
关键限制:UIO 只映射 BAR 空间(MMIO),不做 DMA 管理。如果 FPGA 需要 DMA,必须在用户态管理 DMA 缓冲区——这涉及到物理地址获取、cache 一致性等问题,用户态很难做对。
四、方式 4:VFIO —— 把整个 FPGA 设备直通给用户态
原理
VFIO(Virtual Function I/O) 比 UIO 更进一步:它利用 IOMMU(Intel VT-d / AMD-Vi),把整个 PCIe 设备的 BAR 空间、DMA 能力、MSI-X 中断全部安全地暴露给用户态程序。这是 DPDK/SPDK 等高性能用户态驱动的基础。
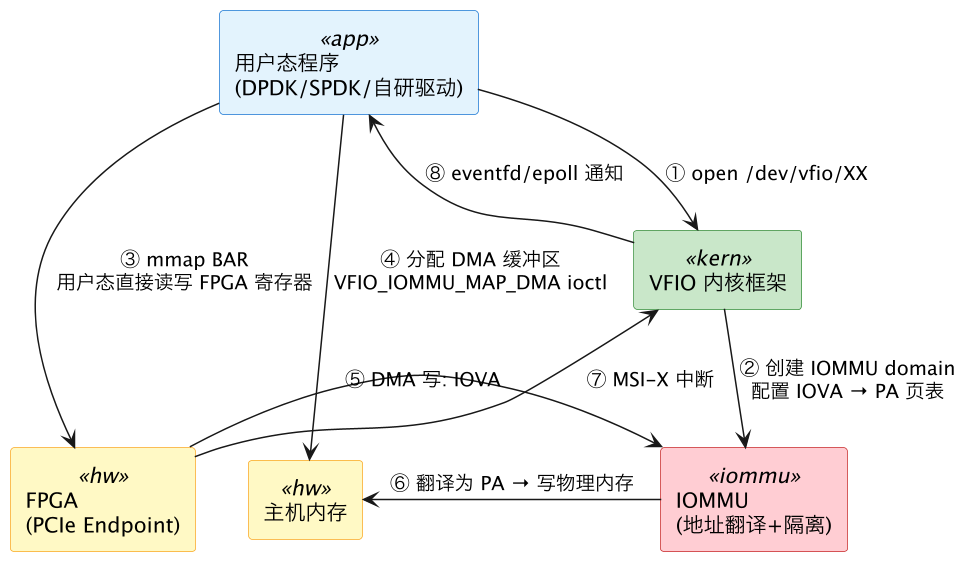
代码示例
// 用户态 VFIO 驱动的关键步骤
int container = open("/dev/vfio/vfio", O_RDWR);
int group = open("/dev/vfio/XX", O_RDWR);  // FPGA 所在的 IOMMU group
// 绑定 IOMMU
ioctl(group, VFIO_GROUP_SET_CONTAINER, &container);
ioctl(container, VFIO_SET_IOMMU, VFIO_TYPE1_IOMMU);
// 获取设备 fd
int device = ioctl(group, VFIO_GROUP_GET_DEVICE_FD, "0000:01:00.0");
// mmap BAR 到用户态
void *bar0 = mmap(NULL, bar_size, PROT_READ | PROT_WRITE,
                  MAP_SHARED, device, bar0_offset);
// 用户态分配 DMA 内存并注册到 IOMMU
void *dma_buf = mmap(NULL, DMA_BUF_SIZE, PROT_READ | PROT_WRITE,
                     MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
struct vfio_iommu_type1_dma_map dma_map = {
    .vaddr = (uint64_t)dma_buf,
    .iova  = 0x100000000,  // FPGA DMA 看到的地址
    .size  = DMA_BUF_SIZE,
    .flags = VFIO_DMA_MAP_FLAG_READ | VFIO_DMA_MAP_FLAG_WRITE,
};
ioctl(container, VFIO_IOMMU_MAP_DMA, &dma_map);
// 把 IOVA 告诉 FPGA(通过 MMIO 写寄存器)
iowrite32(0x100000000, bar0 + FPGA_DMA_ADDR_REG);
// 等中断(通过 eventfd)
struct vfio_irq_info irq = { .index = VFIO_PCI_MSIX_IRQ_INDEX };
int eventfd = eventfd(0, 0);
ioctl(device, VFIO_DEVICE_SET_IRQS, &irq_set);  // 绑定 eventfd
poll(&pfd, 1, -1);  // 阻塞等中断
VFIO vs UIO 对比
| 维度 | UIO | VFIO |
|---|---|---|
| DMA 支持 | 不支持(需自己 hack) | 原生支持(通过 IOMMU) |
| IOMMU 隔离 | 无 | 有(DMA 地址翻译 + 访问控制) |
| MSI-X 中断 | 有限支持 | 完整支持(多向量 + eventfd) |
| 安全 | 差(用户态随意访问物理地址) | 好(IOMMU 限制 DMA 只能访问映射过的内存) |
| 适用场景 | 快速原型、非生产环境 | 生产环境、需要 DMA 的高性能场景 |
| 复杂度 | 低 | 中等 |
五、方式 5:/dev/mem —— 最原始的方式(不推荐)
// 直接把 FPGA BAR 的物理地址通过 /dev/mem 映射到用户态
int fd = open("/dev/mem", O_RDWR | O_SYNC);
void *bar0 = mmap(NULL, BAR_SIZE, PROT_READ | PROT_WRITE,
MAP_SHARED, fd, FPGA_BAR_PHYS_ADDR);| 优点 | 缺点 |
|---|---|
| 零代码,不需要任何驱动 | 完全绕过内核,无任何保护 |
| 调试/验证阶段快速验证 | 无中断支持(只能轮询) |
| 无 DMA 管理、无 cache 一致性 | |
| 生产环境绝对不能用 |
六、方式 6:专用内核驱动 + 字符设备接口
这是最传统也是最灵活的方式——为 FPGA 写一个完整的内核驱动,通过 /dev/fpga0 等字符设备向上层暴露 read/write/mmap/ioctl 接口:
用户态程序
    │
    ├── open("/dev/fpga0")
    ├── ioctl(FPGA_IOC_SEND_CMD, &cmd)    // 控制命令
    ├── ioctl(FPGA_IOC_DMA_START, &dma)   // 启动 DMA 传输
    ├── mmap(...)                          // 映射 DMA 缓冲区到用户态
└── read(...) / poll(...) // 等待完成通知优点:最灵活,可以根据 FPGA 的具体功能定制接口(加密/压缩/网络处理各有各的接口语义)。
缺点:开发工作量大,需要写完整的内核驱动。
七、全方式对比总结
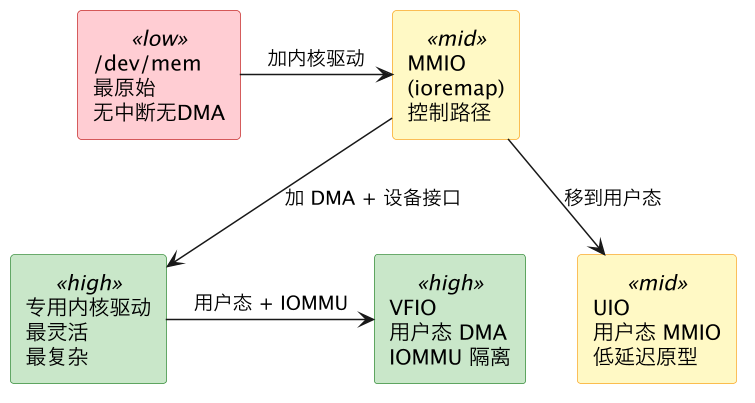
| 方式 | 数据路径 | 控制路径 | 中断 | DMA | IOMMU | 用户态编程 | 适用数据量 | 推荐度 |
|---|---|---|---|---|---|---|---|---|
/dev/mem | MMIO | MMIO | ❌ | ❌ | ❌ | ✅ | KB | ⛔ 仅调试 |
| MMIO (内核) | MMIO | MMIO | ✅ | ❌ | ❌ | ❌ | KB | ⭐⭐ |
| UIO | MMIO | MMIO | ✅ | ❌ | ❌ | ✅ | KB | ⭐⭐⭐ 原型 |
| 专用内核驱动 | DMA | MMIO | ✅ | ✅ | 可选 | ❌ | MB~GB | ⭐⭐⭐⭐ |
| VFIO | DMA | MMIO | ✅ | ✅ | ✅ | ✅ | MB~GB | ⭐⭐⭐⭐⭐ |
八、实际场景选型建议
| 场景 | 推荐方式 | 原因 |
|---|---|---|
| 调试/验证 FPGA 寄存器读写 | /dev/mem 或 UIO | 零代码启动,快速验证硬件 |
| 实验室原型、快速迭代 | UIO | 用户态编程,开发效率高 |
| 控制类应用(少量配置数据) | MMIO(内核驱动)或 UIO | 数据量小,DMA 的复杂度不划算 |
| 数据流处理(加密/压缩/网络处理) | VFIO 或专用内核驱动 + DMA | 数据量大(MB~GB/s),必须 DMA |
| 生产环境高性能 FPGA 应用 | VFIO | IOMMU 隔离 + 用户态 DMA + MSI-X,性能和安全兼得 |
| 需要集成进现有内核子系统 | 专用内核驱动 | 如把 FPGA 实现为网卡(netdev)、块设备(blkdev)、媒体设备(V4L2) |
九、观测与排查
# 查看 FPGA 的 PCIe 设备信息
lspci -vvv -s 01:00.0 | grep -E "Region|BAR|Bus Master"
# 查看 IOMMU 分组(VFIO 需要)
ls -la /sys/kernel/iommu_groups/*/devices/
# 查看 DMA 映射情况
cat /sys/kernel/debug/dma-api/dump
# 绑定设备到 vfio-pci 驱动
echo "vfio-pci" > /sys/bus/pci/devices/0000:01:00.0/driver_override
echo "0000:01:00.0" > /sys/bus/pci/drivers/xxxx/unbind
echo "0000:01:00.0" > /sys/bus/pci/drivers/vfio-pci/bind
# 查看中断情况
cat /proc/interrupts | grep -E "vfio|fpga|uio"
# DMA 性能测试
perf stat -e dma-engine,bus-cycles dd if=/dev/fpga0 of=/dev/null bs=1M count=1024
十、和本仓库其他文档的关系
- DMA 原理:dma——FPGA DMA 引擎的工作原理、为什么必须用 DMA
- PCIe 总线:pcie——FPGA 挂载的物理总线、BAR 空间分配、MMIO 原理
- 中断处理:interrupts——FPGA DMA 完成后通过 MSI-X 中断通知 CPU
- NUMA:numa——FPGA 插在哪个 NUMA 节点的 PCIe 槽上,DMA 缓冲区和 CPU 应在同一节点
十一、一句话总结
Linux 与 FPGA 通信分两条路——控制走 MMIO(CPU 主动读写 FPGA BAR,
ioread32/iowrite32,内核态或 UIO 用户态),数据走 DMA(FPGA 主动搬大批量数据进出主机内存,VFIO 或专用内核驱动管理描述符队列和 IOMMU 映射)。选型原则很简单:KB 级控制数据用 MMIO/UIO,MB~GB 级流式数据必须上 DMA+VFIO。