CPU 如何与 DMA 控制器交互 —— 从发起请求到数据传输完成的完整过程
前一篇 dma 讲了 DMA 是什么、解决了什么问题、有哪几种变体。本篇深入一步:CPU 怎么告诉 DMA 引擎"去干活"?DMA 引擎怎么处理这个请求?DMA 请求包长什么样?这个过程中 PCIe 总线扮演什么角色? 从 CPU 视角看整个 DMA 交互的软硬件全链路。
零、先破除误区:不是 CPU "发一个请求包"
很多人以为 DMA 是 CPU 发一个"DMA 请求包"给 DMA 控制器,DMA 控制器解析、执行、返回。实际情况完全不同:
- 没有"DMA 请求包"这个协议层的东西。
- CPU 和 DMA 引擎的交互方式是:CPU 写设备寄存器 → DMA 引擎读描述符 → DMA 引擎发起总线传输。
- 整个过程高度硬件化、内存化——通过共享内存(描述符队列)和 MMIO(寄存器)协作。
一句话定位:CPU 和 DMA 的交互不是"发包/响应"模型,而是**"共享内存 + 门铃"**模型。CPU 准备好描述符(放在共享内存里),然后写一下设备的"门铃寄存器"——DMA 引擎听到门铃就去读描述符、开始干活。
一、完整交互流程:以 NVMe SSD 读磁盘为例
我们以最常见的场景——应用想从 NVMe SSD 读 4KB 数据——来跟踪 CPU 与 NVMe 控制器的 DMA 引擎如何交互。
1.1 系统架构前提
┌─────────────────────────────────────────────────────┐
│                    主机内存 (DRAM)                      │
│  ┌──────────────────────────────────────────────┐    │
│  │          NVMe 提交队列 (Submission Queue)       │    │
│  │  ┌──────┬──────┬──────┬──────┬──────┐         │    │
│  │  │ cmd0 │ cmd1 │ cmd2 │ cmd3 │ ...  │         │    │
│  │  └──────┴──────┴──────┴──────┴──────┘         │    │
│  │  每个 command = 64 字节的 NVMe 命令描述          │    │
│  └──────────────────────────────────────────────┘    │
│  ┌──────────────────────────────────────────────┐    │
│  │          NVMe 完成队列 (Completion Queue)       │    │
│  │  ┌──────┬──────┬──────┬──────┬──────┐         │    │
│  │  │ cmp0 │ cmp1 │ cmp2 │ cmp3 │ ...  │         │    │
│  │  └──────┴──────┴──────┴──────┴──────┘         │    │
│  │  每个 completion = 16 字节                       │    │
│  └──────────────────────────────────────────────┘    │
│  ┌──────────────────────────────────────────────┐    │
│  │          PRP/SGL 列表(物理区域页列表)           │    │
│  │  指向数据所在的物理页                            │    │
│  └──────────────────────────────────────────────┘    │
└─────────────────────────────────────────────────────┘
         ▲                              │
         │        PCIe 总线              │
         │                              ▼
┌─────────────────────────────────────────────────────┐
│               NVMe SSD 控制器                         │
│  ┌──────────┐  ┌──────────────┐  ┌───────────┐     │
│  │ SQ Tail  │  │ DMA 引擎      │  │ NAND 控制器│    │
│  │ Doorbell │  │ (Bus Master) │  │           │     │
│  │ 寄存器   │  │              │  │           │     │
│  └──────────┘  └──────────────┘  └───────────┘     │
└─────────────────────────────────────────────────────┘关键数据结构全在主机内存中:
- 提交队列(SQ):CPU 往这里写命令,NVMe 控制器从这里读命令。
- 完成队列(CQ):NVMe 控制器往这里写完成通知,CPU 从这里读结果。
- PRP/SGL 列表:描述数据缓冲区在哪(物理地址列表),解决数据不连续的问题。
1.2 完整时序图
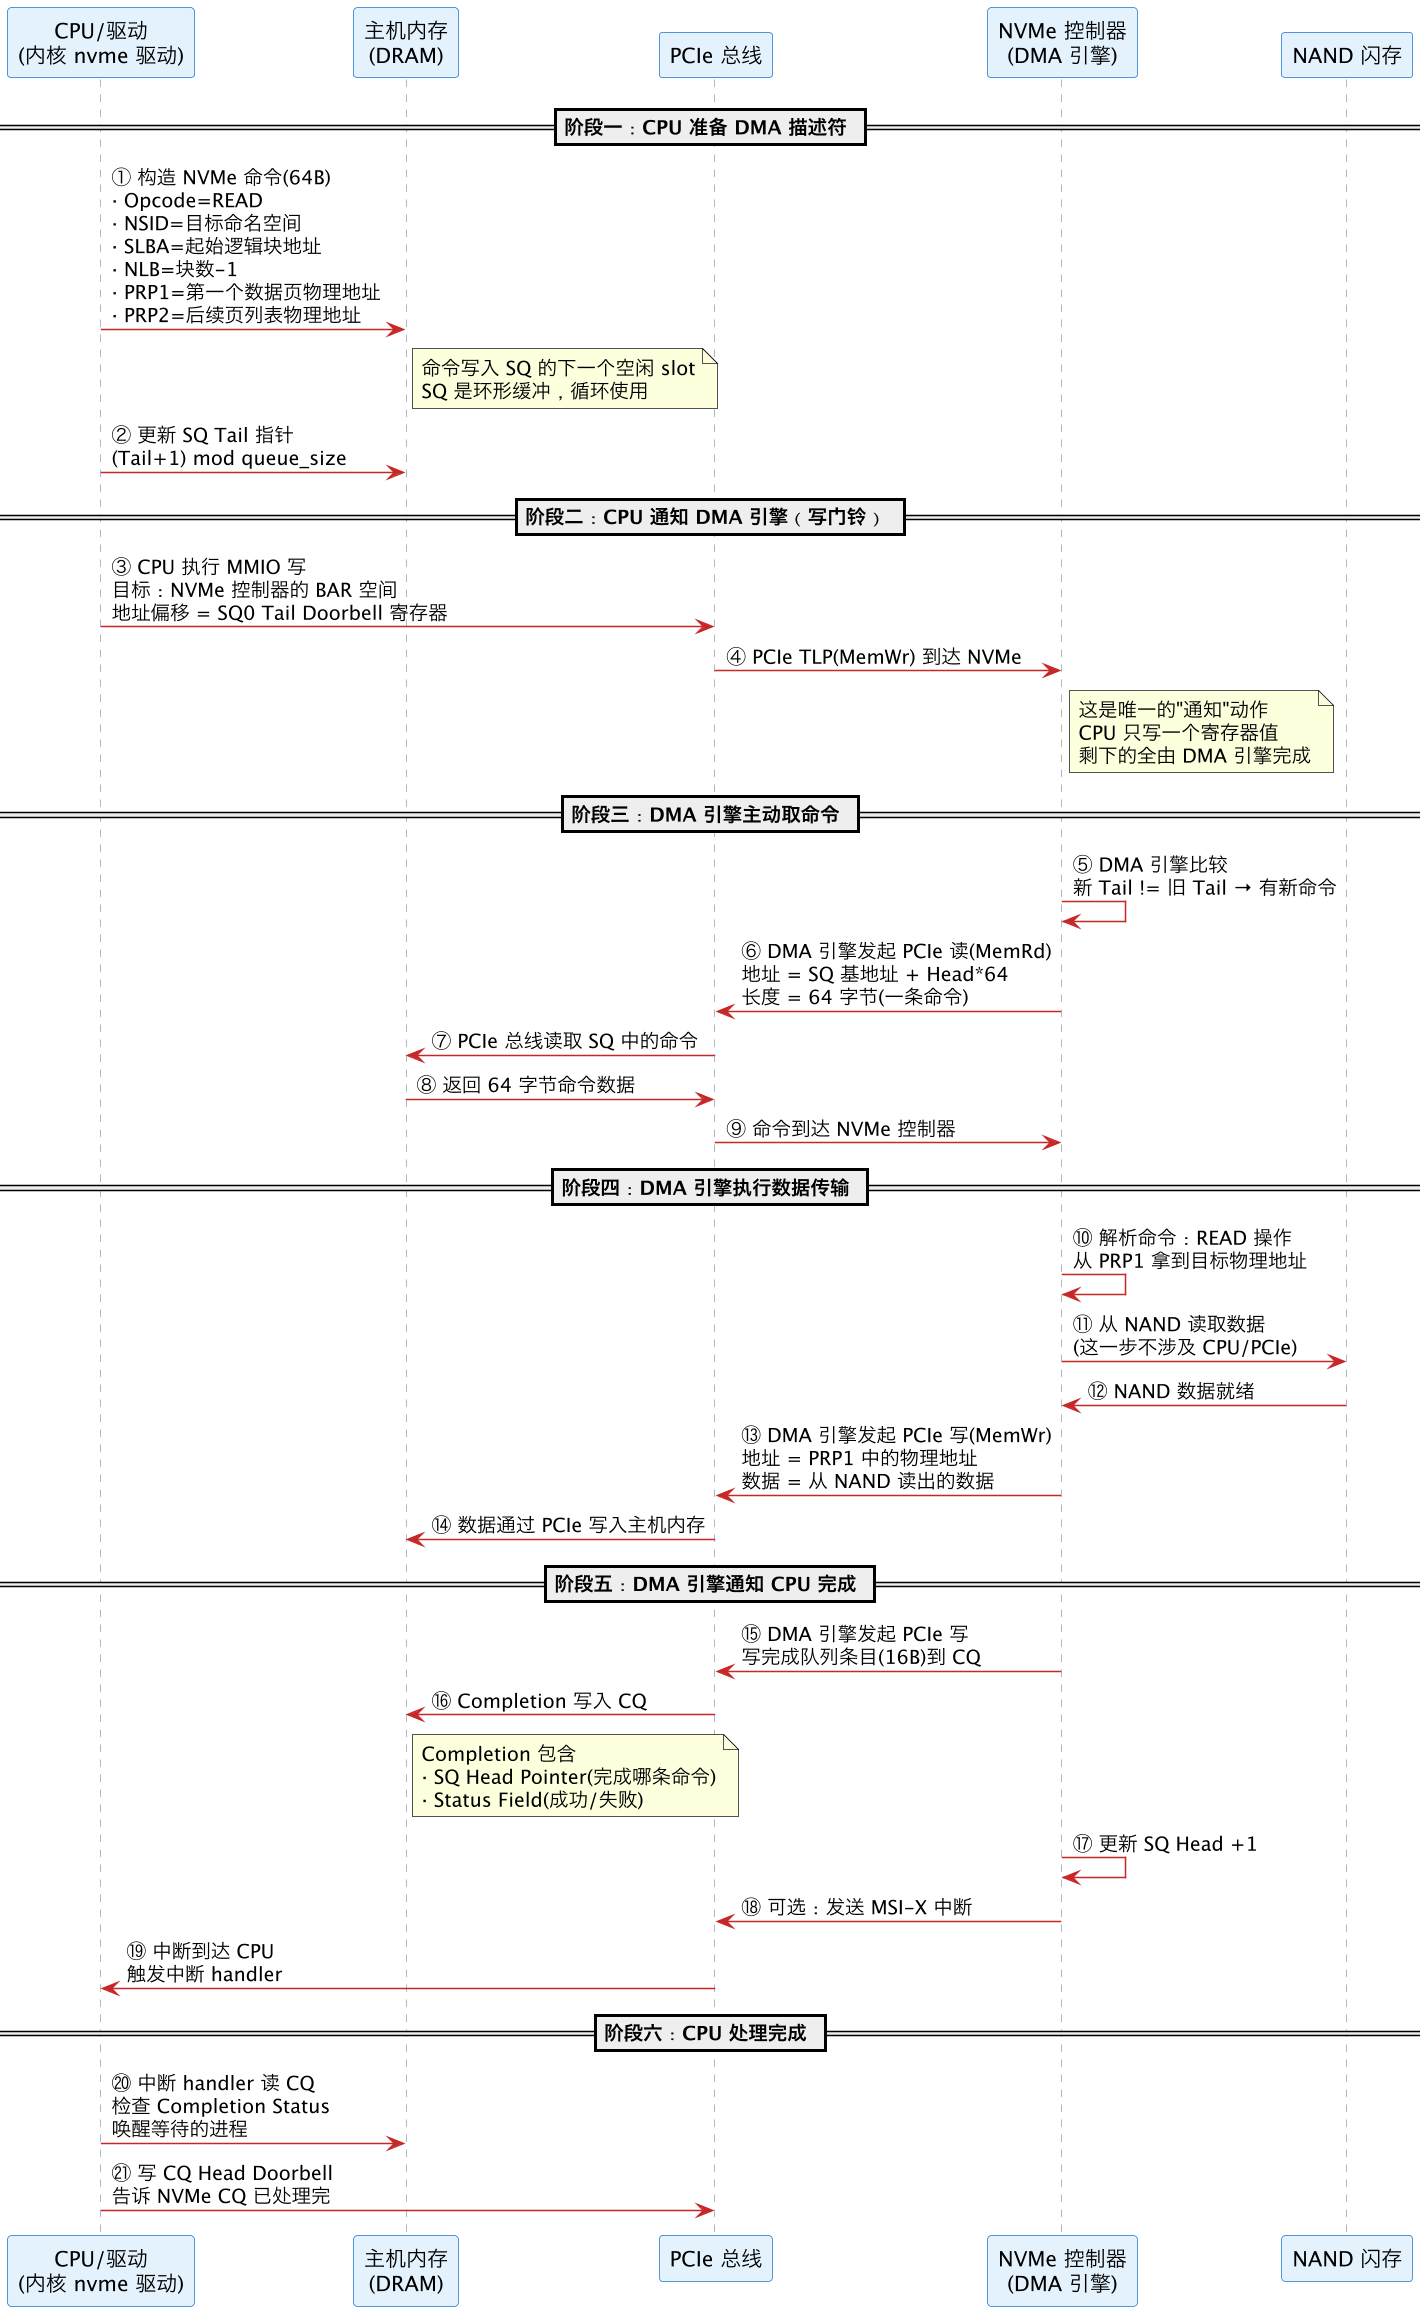
1.3 关键步骤拆解
步骤①-②:准备描述符(纯内存操作,不涉及 PCIe)
// 内核 NVMe 驱动中的典型代码路径(简化)
struct nvme_command cmd = {0};
cmd.read.opcode = nvme_cmd_read;
cmd.read.nsid = cpu_to_le32(ns->head->ns_id);
cmd.read.slba = cpu_to_le64(block_offset);   // 起始逻辑块
cmd.read.length = cpu_to_le16(nr_blocks - 1); // 块数-1
cmd.read.prp1 = cpu_to_le64(dma_addr);        // 第一个物理页地址
// 如果跨多个物理页,还要构造 PRP2 列表
// 把命令写入 SQ 的下一个空闲 slot
sq->cmds[sq->tail] = cmd;
sq->tail = (sq->tail + 1) % sq->qsize;
此时数据还在主机内存中,NVMe 控制器完全不知道有这回事。
步骤③-④:写门铃(MMIO 写,涉及 PCIe)
这是整个交互中 CPU 唯一一次主动通知 DMA 引擎:
// 写 SQ Tail Doorbell 寄存器
writel(sq->tail, nvmeq->q_db);  // q_db 是 PCIe BAR 映射的 MMIO 地址
CPU 执行的是一条普通的内存写指令(mov [addr], value),但因为目标地址是 MMIO 区域(映射到 PCIe BAR 空间),CPU 的硬件会自动将其转换为 PCIe 总线事务:
CPU 侧:                     PCIe 总线上:
mov [0xFB000000], 5    →    TLP(MemWr, addr=0xFB000000, data=5)
步骤⑥-⑨:DMA 引擎主动取命令(PCIe 读)
NVMe 控制器发现 Tail > Head,知道有新命令。DMA 引擎自己发起 PCIe 读:
NVMe DMA 引擎 → PCIe TLP(MemRd, addr=SQ基址+Head*64, len=64B)
             ← PCIe TLP(CplD, data=64字节命令)
这是 DMA 的核心能力:外设作为总线主设备,主动读主机内存。CPU 不需要参与——不需要把命令"拷贝"给 NVMe。
步骤⑬-⑭:DMA 引擎执行数据搬运(PCIe 写)
NVMe 从 NAND 拿到数据后,DMA 引擎直接写主机内存:
NVMe DMA 引擎 → PCIe TLP(MemWr, addr=PRP1, data=4096字节)如果数据跨多个物理页(PRP 列表),DMA 引擎会逐个处理每个条目。
步骤⑮-⑱:完成通知
DMA 引擎写完数据后,还要写完成通知:
NVMe DMA 引擎 → PCIe TLP(MemWr, addr=CQ基址+Head*16, data=Completion条目)
NVMe DMA 引擎 → MSI-X 中断注意:Completion 写入和中断是两个独立的动作。先写 CQ,再发中断——这样 CPU 在中断 handler 中一定能读到完整的 Completion。
二、DMA 请求"包"到底长什么样
前面说了没有"DMA 请求包"这种东西。但如果我们非要把整个交互抽象成"一个请求",它由以下部分组成:
2.1 逻辑层面的"DMA 请求"
| 组成部分 | 在哪 | 谁写 | 谁读 | 大小 |
|---|---|---|---|---|
| 命令描述符 | 主机内存的 SQ | CPU | NVMe DMA 引擎 | 64B(NVMe) |
| 数据缓冲区描述 | 主机内存的 PRP/SGL | CPU | NVMe DMA 引擎 | 8B/条目 |
| 门铃通知 | NVMe BAR 寄存器 | CPU | NVMe 控制器 | 4B |
| 完成条目 | 主机内存的 CQ | NVMe DMA 引擎 | CPU | 16B(NVMe) |
| 完成中断 | MSI-X 中断 | NVMe 控制器 | CPU APIC | N/A |
2.2 NVMe 命令描述符格式(64 字节)
Byte 0:   Opcode (1B)     ← 0x02 = READ
Byte 1:   Flags (1B)      ← PRP/SGL 等标志
Byte 2-3: Command ID (2B) ← 命令序号
Byte 4-7: NSID (4B)       ← 命名空间 ID
Byte 8-15: Reserved
Byte 16-23: Metadata Pointer
Byte 24-31: PRP Entry 1   ← 第一个数据物理地址
Byte 32-39: PRP Entry 2   ← PRP 列表物理地址(如果需要)
Byte 40-47: Starting LBA  ← 起始逻辑块地址
Byte 48-49: Number of Logical Blocks ← 块数-1
...
Byte 60-63: 校验/特性
2.3 不同设备类型的"描述符"差异
不同设备的 DMA 交互本质相同,但描述符格式不同:
| 设备类型 | 队列结构 | 描述符大小 | 通知方式 |
|---|---|---|---|
| NVMe | SQ/CQ(提交/完成队列) | 命令 64B,完成 16B | SQ Tail Doorbell |
| 网卡 | TX/RX Ring(环形描述符队列) | 描述符 16B | Tail 指针寄存器 |
| SATA AHCI | Command List + Command Table | 命令头 32B + 命令表 | PxCI 寄存器 |
| FPGA DMA IP | 自定义描述符队列 | 可变(通常 16-64B) | 控制寄存器 |
但它们遵循同样的"共享内存 + 门铃"模式。
三、与 PCIe 的关系
3.1 PCIe 是 DMA 的物理通道

3.2 CPU 如何"发起"一个 PCIe 事务
从 CPU 视角看,它做的只是一条普通的 store 指令:
mov dword ptr [rbx], 5 ; rbx = MMIO 地址(映射到 NVMe BAR)但在硬件层面,CPU 的内存控制器会:
- 检查目标物理地址的范围。
- 发现它落在 PCIe MMIO 地址空间内(不是 DRAM)。
- 构造一个 PCIe TLP(Transaction Layer Packet)。
- 通过 Root Complex 发送到 PCIe 总线上。
- TLP 经过 Switch 路由到目标设备(NVMe)。
CPU store 指令 → 内存控制器检查地址 → 发现是 MMIO →
构造 TLP(MemWr, addr=..., data=...) → Root Complex → PCIe → 设备
3.3 PCIe TLP 的类型与 DMA 的关系
DMA 交互中涉及的 TLP 类型:
| TLP 类型 | 谁发起 | 用途 | 对应 DMA 动作 |
|---|---|---|---|
| MemWr (Memory Write) | CPU → 设备 | CPU 写设备 BAR 寄存器(门铃) | 通知 DMA 引擎 |
| MemRd (Memory Read) | 设备 → 内存 | DMA 引擎读 SQ/描述符 | DMA 取命令 |
| CplD (Completion with Data) | 内存 → 设备 | 返回读取的数据 | DMA 取命令的响应 |
| MemWr (Memory Write) | 设备 → 内存 | DMA 引擎写数据/完成条目 | DMA 搬运数据 |
| Msg (Message) | 设备 → CPU | MSI/MSI-X 中断 | DMA 完成通知 |
核心:DMA 的本质就是外设发起的 PCIe MemRd 和 MemWr TLP。CPU 不再需要"帮外设读写内存"——外设自己就能发这些 TLP。
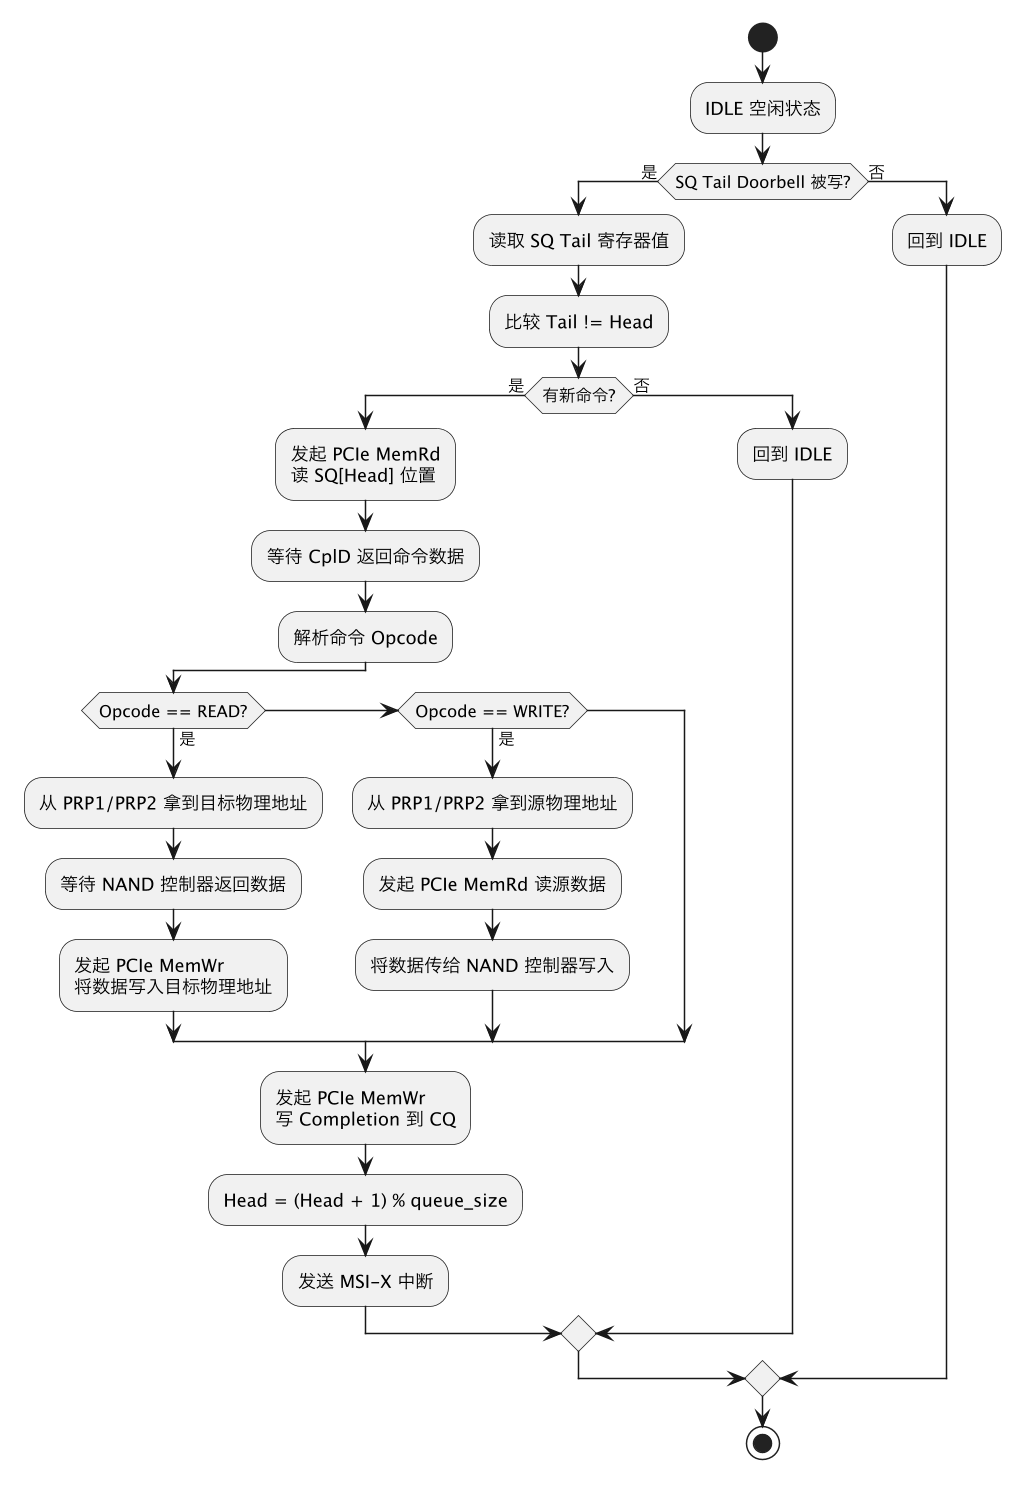
四、DMA 引擎内部怎么处理"请求"
4.1 DMA 引擎的状态机
以 NVMe 控制器中的 DMA 引擎为例:
4.2 队列管理:Head/Tail 指针的协作
这是 DMA 交互中最重要的并发控制机制:
SQ (环形缓冲,8 个 slot):
初始状态:                  CPU 写入 3 条命令后:
Head=0, Tail=0              Head=0, Tail=3
┌──┬──┬──┬──┬──┬──┬──┬──┐  ┌────┬────┬────┬──┬──┬──┬──┬──┐
│  │  │  │  │  │  │  │  │  │cmd0│cmd1│cmd2│  │  │  │  │  │
└──┴──┴──┴──┴──┴──┴──┴──┘  └────┴────┴────┴──┴──┴──┴──┴──┘
DMA 引擎处理 1 条后:        DMA 引擎处理 2 条后:
Head=1, Tail=3              Head=2, Tail=3
┌──┬────┬────┬──┬──┬──┬──┬──┐  ┌──┬──┬────┬──┬──┬──┬──┬──┐
│  │cmd1│cmd2│  │  │  │  │  │  │  │  │cmd2│  │  │  │  │  │
└──┴────┴────┴──┴──┴──┴──┴──┘ └──┴──┴────┴──┴──┴──┴──┴──┘- CPU 只写 Tail:每次添加命令后,Tail 前进。
- DMA 引擎只写 Head:每次处理完一条命令,Head 前进。
- Tail == Head 表示队列空。
- CPU 永远不会写 Head,DMA 引擎永远不会写 Tail——这是无锁并发的关键。
五、从 PCIe TLP 看一次完整的 DMA 读交互
以 NVMe READ 为例,PCIe 总线上的 TLP 序列:
时间线 →
CPU侧 TLP:
  [MemWr: SQ[0]=CMD0]          ← 步骤①:写命令到 SQ(普通内存写)
  [MemWr: SQ[1]=CMD1]          ← 再写一条
  [MemWr: NVMe_BAR+0x1000=2]   ← 步骤③:写门铃(Tail=2)
NVMe DMA引擎侧 TLP:
  [MemRd: SQ基址+0, len=64]    ← 步骤⑥:DMA 读 SQ[0]
  [CplD:  64B CMD0数据]        ← 步骤⑨:命令返回
  [MemRd: SQ基址+64, len=64]   ← DMA 读 SQ[1]
  [CplD:  64B CMD1数据]        ← 命令返回
  [MemWr: PRP1, data=4KB]      ← 步骤⑭:DMA 写数据(CMD0)
  [MemWr: CQ基址+0, len=16]    ← 步骤⑯:DMA 写完成条目(CMD0)
  [Msg: MSI-X Vector=X]        ← 步骤⑱:中断
  [MemWr: PRP2, data=4KB]      ← DMA 写数据(CMD1)
  [MemWr: CQ基址+16, len=16]   ← DMA 写完成条目(CMD1)
  [Msg: MSI-X Vector=X]        ← 中断
CPU侧 TLP(中断处理后):
  [MemWr: CQ_Head_Doorbell=2]  ← 步骤㉑:确认完成
可以看到,CPU 只发了 3 个 TLP(写命令、写门铃、确认完成),NVMe 的 DMA 引擎发了 10 个 TLP(读取命令、写数据、写完成、中断)。数据搬运的脏活累活全是 DMA 引擎干的。
六、IOMMU 的角色:虚拟化环境中的 DMA 地址翻译
在虚拟化环境中,还有一个重要的角色——IOMMU(Intel VT-d / AMD IOMMU):
物理地址视角:                  IOMMU 翻译视角:
DMA 引擎写 0x10000             DMA 引擎写 GPA 0x10000
       ↓                              ↓
   直接到物理内存               IOMMU 翻译 GPA→HPA
                                      ↓
实际写到 HPA 0x500000- 没有 IOMMU:DMA 引擎用物理地址,如果驱动有 bug,DMA 可能写到任何物理地址(安全风险)。
- 有 IOMMU:DMA 引擎用 GPA(Guest Physical Address),IOMMU 硬件翻译成 HPA(Host Physical Address),就像 CPU 的 MMU 翻译虚拟地址一样。
- 性能代价:每次 DMA 需要查 IOMMU 页表,增加延迟。IOMMU 有 TLB(IOTLB),命中则快。
七、不同场景的对比总结
| 场景 | CPU 动作 | DMA 引擎动作 | PCIe TLP 数量(CPU侧) |
|---|---|---|---|
| 磁盘读 (NVMe READ) | 写 SQ 命令 + 写门铃 + 处理完成 | 读 SQ → 读 NAND → 写数据到内存 → 写 CQ → 发中断 | 3-4 个 |
| 磁盘写 (NVMe WRITE) | 写 SQ 命令 + 写门铃 + 处理完成 | 读 SQ → 读内存数据 → 写 NAND → 写 CQ → 发中断 | 3-4 个 |
| 网卡收包 | 初始化 RX Ring + 处理完成 | 收到包 → 写数据到内存 → 写描述符 → 发中断 | 1-2 个(处理完成时) |
| 网卡发包 | 写 TX 描述符 + 写门铃 | 读 TX 描述符 → 读内存数据 → 发送 | 2 个 |
| FPGA 加速 | 准备数据 + 写控制寄存器 | 读内存数据 → 处理 → 写回内存 → 发中断 | 2-3 个 |
八、一句话总结
CPU 和 DMA 引擎的交互不是"发包/响应",而是"共享内存 + 门铃":CPU 在内存中准备好命令描述符(告诉 DMA 引擎从哪搬到哪、搬多少),然后通过一次 MMIO 写(门铃)通知 DMA 引擎;DMA 引擎自己通过 PCIe 总线发起 MemRd 读取描述符、执行数据搬运(MemWr)、写回完成通知、发 MSI-X 中断。整个过程中 CPU 只参与"准备描述符"和"响应中断"两步,数据搬运完全由 DMA 引擎作为 PCIe 总线主设备独立完成。PCIe 是 DMA 的物理通道——DMA 本质就是外设发起的 PCIe MemRd/MemWr TLP。Head/Tail 指针机制保证了 CPU 和 DMA 引擎的无锁并发协作。
九、与仓库其他文档的关系
- DMA 基础:dma — DMA 是什么、为什么需要、Bus Mastering 模型、SG-DMA、DDIO
- PCIe 总线:pcie — PCIe 三层协议、TLP 格式、BAR 空间、MMIO 映射
- FPGA 通信:fpga-communication — FPGA 为什么必须用 DMA
- 中断处理:interrupts — DMA 完成后的 MSI-X 中断处理
- IOMMU:performance — 容器/虚拟机中 DMA 的 IOMMU 开销