生产环境符号分离(Separate Debug Info)完整实践
生产环境的两难:线上二进制想小、想快、不泄露源码线索,但崩溃时又需要完整符号才能分析 core。符号分离(split debug info)就是解法:把调试符号从二进制里剥出来单独存,线上发布精简版,分析时再把符号"接"回去。这是 core-dump 里反复提到的"分离调试符号"的完整展开。
一、为什么要分离,而不是二选一
三种朴素做法都有明显缺陷:
| 做法 | 问题 |
|---|---|
线上直接带 -g 全量符号 | 二进制体积大(调试信息常是代码的几倍)、分发慢、暴露源码路径/变量名 |
线上 strip 掉所有符号 | 体积小了,但崩溃 core 用 gdb bt 全是问号,没法分析 |
| 只在测试环境带符号 | 生产崩溃的 core 拿回测试环境的二进制分析 → 二进制不匹配,符号错乱(见 FAQ) |
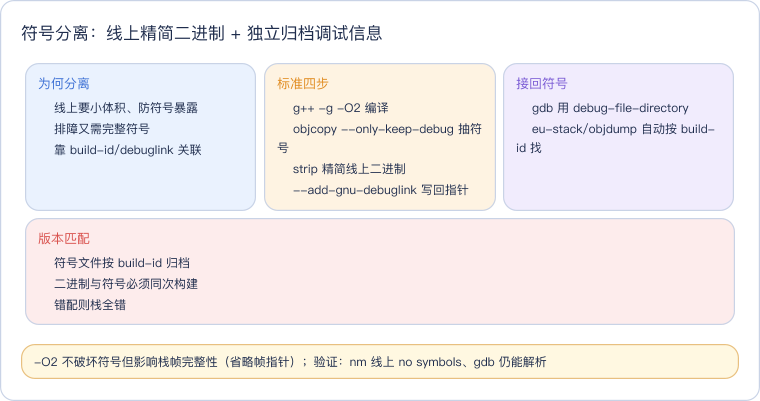
符号分离兼得:线上是 strip 后的小二进制,符号存在单独的 .debug 文件里(归档,不随程序分发);拿到生产 core 时,把匹配的 .debug 和二进制放一起,gdb 自动补全符号,完整还原。
二、原理:调试信息在哪、靠什么关联
- 调试信息主要在 ELF 的
.debug_*节(DWARF 格式)和.symtab(符号表),由-g生成(见 elf-format)。 - 分离 = 把这些节复制到单独文件,再从原二进制删除。
- 关联靠一个小节
.gnu_debuglink:里面记录.debug文件名 + CRC 校验。gdb 加载精简二进制时,读到这个节就去约定目录找对应.debug,并用 CRC 校验确保匹配(防止版本对不上)。 - 更现代的关联方式是 Build ID(
.note.gnu.build-id节,一串唯一哈希):符号文件按 build-id 存放,gdb/debuginfod 靠它精确匹配,比文件名更可靠。
三、标准四步(手动)
# 1. 带调试符号编译(-O2 不影响符号正确性,但会影响栈帧完整性,见第五节)
g++ -g -O2 app.cpp -o app
# 2. 把调试信息抽到单独文件
objcopy --only-keep-debug app app.debug
# 3. 剥离线上二进制(删 .symtab / .debug_*,体积大降)
strip app                 # 或 strip --strip-debug app 只删调试信息、保留普通符号表
# 4. 在精简二进制里写入 .gnu_debuglink,指向 app.debug
objcopy --add-gnu-debuglink=app.debug app
产物:
app—— 线上发布,体积小,nm app显示 no symbols;app.debug—— 归档到符号服务器/制品库,不随程序分发。
四、分析时如何"接回"符号
gdb 会按顺序自动找 .debug:与二进制同目录 → .debug/ 子目录 → 全局 /usr/lib/debug/...。最简单:
# 把 app.debug 和 app(生产那个)、core 放同一目录
gdb ./app /var/core/core-app-1234
# gdb 自动通过 .gnu_debuglink/build-id 找到 app.debug,bt 有完整函数名和行号
手动指定符号文件:
(gdb) symbol-file app.debug        # 显式加载分离的符号
(gdb) set debug-file-directory /path/to/debugsymbols   # 指定符号目录
系统库符号缺失(libc/libstdc++ 是问号)用 debuginfod 自动下载,无需手动装 debuginfo 包:
export DEBUGINFOD_URLS="https://debuginfod.ubuntu.com"   # CentOS: https://debuginfod.centos.org
gdb ./app core.file
五、编译选项:符号分离要配合的优化设置
分离只解决"符号存哪",栈能不能回溯完整取决于优化选项(呼应 core-dump 第七节):
| 选项 | 作用 | 建议 |
|---|---|---|
-g | 生成 DWARF 调试信息 | 必加(分离后不影响线上体积) |
-O2 | 优化 | 生产推荐;比 -O3 稳,栈帧更可预测 |
-O3 | 激进优化 | 慎用:指令重排/内联多,bt 可能不完整 |
-fno-omit-frame-pointer | 保留栈帧指针 | 强烈建议:即使开优化,也能保证 bt 完整;代价是占用一个寄存器、极小性能损失 |
-fomit-frame-pointer | 去掉栈帧指针(优化默认) | 避免:bt 容易全问号 |
-fstack-protector-strong | 栈保护 | 测试/预发建议开,栈溢出时直接报 stack smashing detected 并定位 |
推荐生产组合:g++ -g -O2 -fno-omit-frame-pointer ...
补充:较新工具链支持
-gsplit-dwarf(编译期就把 DWARF 拆到.dwo文件)+dwp打包,适合超大项目减少链接期内存和体积,是分离的"编译期版本"。
六、版本管理:归档与匹配(生产关键)
分离出的 .debug 必须和对应的二进制、代码版本一一对应并归档,否则崩溃时找不到匹配符号 = 白分离。
- 随构建产出符号:CI 里编译后立即执行分离四步,把
app打进发布包、app.debug连同 build-id、git commit、构建号一起上传到符号服务器/制品库。 - 用 Build ID 索引:
readelf -n app | grep 'Build ID'取哈希,符号库按 build-id 目录结构存放(/usr/lib/debug/.build-id/ab/cdef...debug),debuginfod/gdb 自动按 build-id 匹配,彻底避免"文件名对但内容不对"。 - 重大事故归档三件套:出事时把 生产二进制 + 匹配的 .debug + 对应 core + git 版本 一起封存,方便事后反复复盘。
七、验证分离是否成功
# 精简二进制:应无调试节、体积小
readelf -S app | grep -E 'debug|symtab'      # 应几乎没有(或只剩 .dynsym)
file app                                       # 显示 "stripped"
ls -lh app app.debug                           # app 明显变小,app.debug 承载符号
# 确认关联信息在
readelf -n app | grep 'Build ID'              # 有 build-id
objdump -s -j .gnu_debuglink app              # 有 .gnu_debuglink 指向 app.debug
# 端到端验证:用精简 app + app.debug 分析,bt 应有函数名和行号
gdb ./app core.file -batch -ex bt
八、结合本仓库演示
本仓库 make 默认 -O0 -g(为教学保留完整符号)。可手动走一遍分离流程体会:
make                                    # 生成 ./cpu_demo(带符号)
ls -lh cpu_demo                         # 记下原始大小
readelf -S cpu_demo | grep debug        # 有一堆 .debug_* 节
objcopy --only-keep-debug cpu_demo cpu_demo.debug
strip cpu_demo
objcopy --add-gnu-debuglink=cpu_demo.debug cpu_demo
ls -lh cpu_demo cpu_demo.debug          # cpu_demo 变小,符号进了 .debug
readelf -S cpu_demo | grep debug        # .debug_* 没了
nm cpu_demo                             # no symbols
nm cpu_demo.debug | grep busy           # 符号在 .debug 里
readelf -n cpu_demo | grep 'Build ID'   # 关联用的 build-id(若工具链默认开)
⚠️ 平台提醒:
objcopy/strip/readelf在 macOS 上可能是 LLVM 版、行为略异,.gnu_debuglink/build-id 这套是 Linux + GNU binutils 的机制。要完整体验请在 Linux 上做(和本仓库其他工具一致)。
九、一句话总结
-g 编译 → objcopy --only-keep-debug 抽符号 → strip 瘦身 → objcopy --add-gnu-debuglink 关联,配合 -fno-omit-frame-pointer 保证栈完整、用 build-id 精确匹配、把 .debug 随构建归档。这样线上二进制又小又不泄密,生产 core 又能完整分析——鱼和熊掌兼得。
相关:Core Dump 机制见 core-dump;生成 core 的性能开销见 core-dump-performance;ELF 符号/节的底层见 elf-format 与 nm。