RDMA 详解 —— 绕过 CPU 的远程内存直接访问(及它与 NUMA 的关系)
这篇文档是做什么的
一句话:RDMA(Remote Direct Memory Access) 让一台机器的网卡直接读写另一台机器的内存,绕过 CPU、内核协议栈和多次数据拷贝,把网络延迟从几十微秒压到 1~2 微秒。它是跨机技术;NUMA 是本机内存架构——两者不是一回事,但在高性能场景强相关(见第六节)。
可以回答什么问题
| 问题 | 答案在哪 |
|---|---|
| RDMA 和传统 TCP/IP 性能差距有多大?为什么? | §一——绕过 CPU、零拷贝、协议卸载,延迟从几十 us 降到 1~2 us |
| RDMA 有哪些实现方式?各有什么区别? | §三——InfiniBand/RoCE/iWARP 三种,RoCE v2 最通用 |
| 程序中怎么用 RDMA?需要改代码吗? | §四——QP/CQ/MR/PD 核心概念,libibverbs 编程 |
| RDMA 为什么和 NUMA 有关系? | §六——网卡 PCIe 绑在某 NUMA 节点,跨节点 DMA 吃掉低延迟优势 |
| 怎么观测 RDMA 性能? | §七——perftest、ib_read_bw、ib_write_bw 等工具 |
一、先看它解决什么:传统 TCP/IP 的开销
一次普通 socket 收发,数据要经过多层、CPU 全程参与:
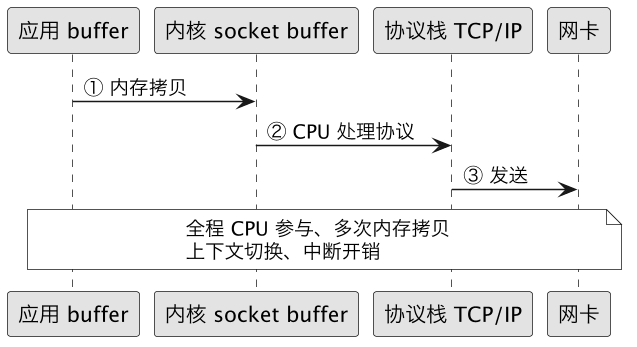
痛点:多次内存拷贝 + CPU 全程参与协议处理 + 系统调用/中断开销。在 40G/100G 网络下,CPU 光处理协议就可能打满,延迟也下不来。
RDMA 的思路是彻底绕开这套——网卡直接在两端应用内存间 DMA:
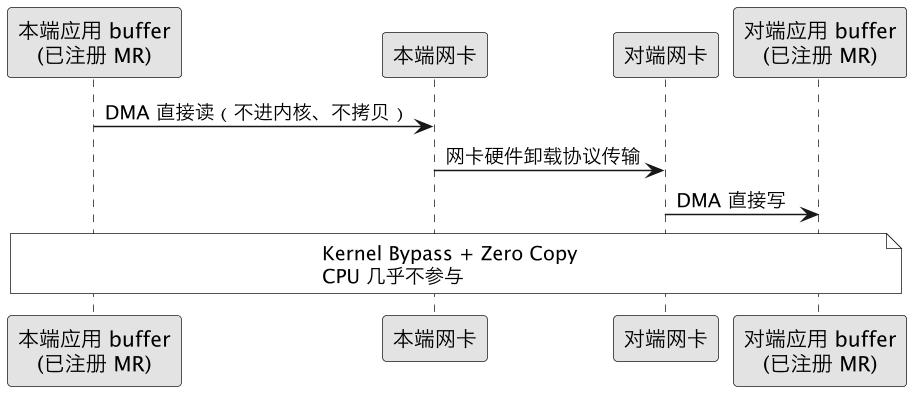
三个核心特征:
| 特征 | 含义 |
|---|---|
| Kernel Bypass | 数据路径不经过内核,用户态直接和网卡交互,省掉系统调用/上下文切换 |
| Zero Copy | 网卡 DMA 直接在应用注册的内存和网线间搬数据,没有内核↔用户态拷贝 |
| Protocol Offload | 传输协议在网卡硬件里跑,CPU 不参与拆包组包 |
结果:微秒级延迟、极高带宽、极低 CPU 占用。
二、三种 RDMA 实现(硬件路线)
| 实现 | 全称 | 说明 |
|---|---|---|
| InfiniBand (IB) | — | 专用网络(专用网卡+交换机),性能最强,HPC/超算首选;成本高、需独立组网 |
| RoCE | RDMA over Converged Ethernet | 在以太网上跑 RDMA,复用现有以太设备。v2 可路由(走 UDP/IP),数据中心主流;依赖无损网络(PFC/ECN 流控),配置是难点 |
| iWARP | internet Wide Area RDMA Protocol | 在 TCP 上跑 RDMA,能走普通以太网、可路由、对网络要求低;延迟不如前两者 |
选型速记:极致性能且能独立组网 → IB;数据中心复用以太网 → RoCE v2(主流);只想在普通 TCP 网络上用 → iWARP。
三、核心概念(编程模型)
RDMA 编程和 socket 差别很大,几个必懂概念:
| 概念 | 作用 |
|---|---|
| Verbs | RDMA 的编程接口(类比 socket API),库为 libibverbs;rdma-core 是用户态软件栈 |
| QP (Queue Pair) | 队列对 = 发送队列(SQ) + 接收队列(RQ),是通信的基本端点(类比连接) |
| CQ (Completion Queue) | 完成队列,操作完成后往这里放完成事件,应用去 poll(而非被中断打断) |
| MR (Memory Region) | 内存区域。RDMA 前必须把要用的内存"注册"给网卡(pin 住不让换出 + 建立虚拟地址↔物理地址映射,网卡 DMA 要用) |
| PD (Protection Domain) | 保护域,把 QP/MR 归组,做权限隔离 |
| lkey / rkey | 本地/远程访问 MR 的密钥,对端拿 rkey 才能直接读写你这块内存 |
两类操作语义:
- 双边操作 (SEND/RECV):像 socket,两端都要参与(发方 SEND、收方先挂好 RECV)。
- 单边操作 (RDMA READ/WRITE):只有发起方参与,直接读/写对端注册好的内存,对端 CPU 完全不知情——这是 RDMA 最强大也最独特的能力(如分布式 KV、远程内存池)。
四、数据来源 / 如何观测
RDMA 不走内核网络栈,所以 ss/netstat/tcpdump 那套基本看不到它。观测靠专用工具:
- 设备与端口状态:
/sys/class/infiniband/(内核暴露的 RDMA 设备信息),或ibv_devices/ibv_devinfo。 - 性能计数器:
/sys/class/infiniband/<dev>/ports/<n>/counters/(收发包、字节、错误);perfquery(IB)。 - 工具:
rdma(iproute2 的rdma命令,看链路/资源)、ibstat、ib_write_bw/ib_read_lat(官方带宽/延迟基准测试)。
rdma link                 # 看 RDMA 设备和端口状态(类似 ip link)
ibv_devinfo               # 网卡能力、端口 state(PORT_ACTIVE 才可用)、链路速率
ibstat                    # IB/RoCE 设备状态概览
ib_write_bw / ib_read_lat # 官方 perftest:测带宽 / 测延迟(一端 server 一端 client)
cat /sys/class/infiniband/mlx5_0/ports/1/counters/port_xmit_data   # 原始计数器
五、典型应用场景
- HPC / 超算:MPI 底层用 RDMA 做节点间通信(paper 第五节的 MPI 场景)。
- 分布式存储:Ceph、NVMe-oF(NVMe over Fabrics)用 RDMA 把远程盘做得像本地盘一样快。
- 分布式数据库 / KV:远程内存直读,绕过对端 CPU。
- AI 训练:GPU 集群多机多卡梯度同步(NCCL 走 RDMA / GPUDirect RDMA,网卡直接读写 GPU 显存)。
- 存算分离:远程内存池、内存扩展。
六、RDMA 与 NUMA 的关系(关键)
这就是它出现在本仓库的原因。 RDMA 追求极致低延迟,而 NUMA 的跨节点访问延迟足以吃掉 RDMA 省下的那几微秒,所以高性能 RDMA 部署必须做 NUMA 亲和。
为什么相关
RDMA 网卡插在某条 PCIe 通道上,而每条 PCIe 通道归属某个 NUMA 节点(由某颗 CPU 的 PCIe root complex 引出)。于是:
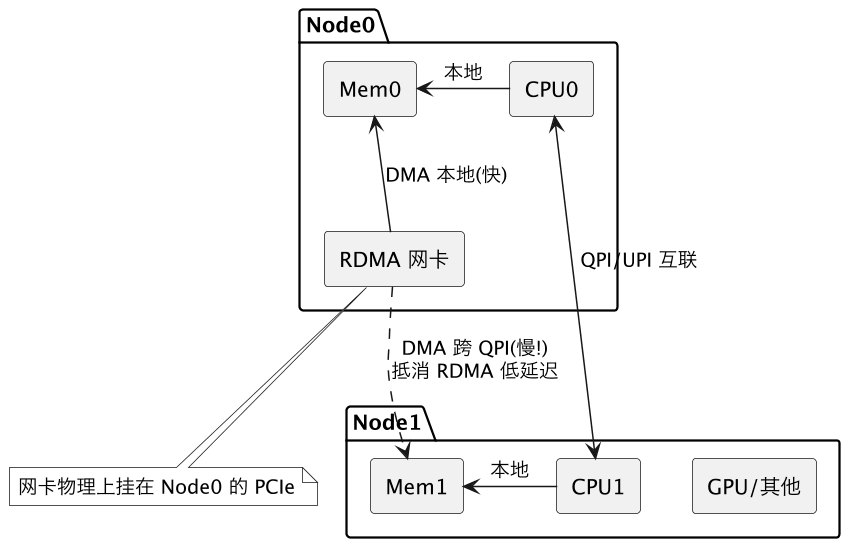
如果 RDMA 的内存区域(MR)、收发线程和网卡不在同一个 NUMA 节点:网卡 DMA 访问那块内存要跨 NUMA 节点走 QPI/UPI,多出的延迟和带宽损耗,正好抵消 RDMA 相对 TCP 的优势。
怎么做 NUMA 亲和优化
查网卡属于哪个 NUMA 节点:
bashcat /sys/class/infiniband/mlx5_0/device/numa_node # 输出 0 表示网卡在 node0 # 或 lspci 找到网卡 BDF 后: cat /sys/bus/pci/devices/0000:xx:00.0/numa_node把处理线程 + 内存绑到网卡所在节点(用 numactl / libnuma):
bash# 假设网卡在 node0:进程和内存都绑 node0 numactl --cpunodebind=0 --membind=0 ./rdma_appMR 注册的内存也要落在网卡所在节点——用
numa_alloc_onnode()在网卡节点分配再注册,别让主线程在别的节点 malloc 后注册。中断亲和:把 RDMA 网卡的中断也绑到同节点的核,减少跨节点。
一句话:RDMA 把"跨机"延迟降到微秒级后,"跨 NUMA 节点"这种本机内的纳秒级开销就变得显眼了——所以 RDMA 调优 = 传统网卡 offload 调优 + 严格的 NUMA 本地化。二者在"极致低延迟"这个目标上汇合。
七、关键指标速查
| 指标 | 缩写/英文 | 工具 | 正常值 | 异常信号 |
|---|---|---|---|---|
| 端口状态 | Port State | ibv_devinfo | PORT_ACTIVE | DOWN / INIT → 链路故障 |
| 链路速率 | Link Speed | ibv_devinfo | 网卡规格 | 降速 → 物理层问题 |
| 收发包计数 | Xmit/Rcv Data | /sys/class/infiniband/<dev>/ports/<n>/counters/ | 视业务 | 大量错误计数 → 物理层问题 |
| 完成队列溢出 | CQ Overrun | 同上 counters | 0 | > 0 → 应用处理跟不上 |
| 网卡 NUMA 节点 | NIC NUMA Node | cat /sys/class/.../numa_node | 与处理线程在同一节点 | 与处理线程跨节点 → 延迟翻倍 |
| 符号错误计数 | Symbol Errors | perfquery | 0 | > 0 → 物理链路质量差 |
| RDMA 带宽 | RDMA B/W | ib_write_bw | 接近线速 | 远低于线速 → 瓶颈在 PCIe/内存/NUMA |
八、常见排查方法与分析
8.1 RDMA 延迟高 → 检查 NUMA 亲和
# 基线:在同节点跑
numactl --cpunodebind=0 --membind=0 ./rdma_app
# 对比:跨节点跑
numactl --cpunodebind=1 --membind=1 ./rdma_app
# 网卡在 node0 时,跨节点延迟翻倍甚至更多
# 确认网卡归属
cat /sys/class/infiniband/mlx5_0/device/numa_node
# 确认进程内存实际落在哪
numastat -p <PID>
8.2 RDMA 链路不可用
ibv_devinfo → port_state 不是 PORT_ACTIVE
  → rdma link → 看物理链路状态
    → 检查网线/光模块 → 交换机端 port 配置
    → RoCE 场景:检查交换机 PFC/ECN 流控是否配置正确
8.3 RDMA 带宽远低于线速
ib_write_bw → 带宽只有线速的 30-50%
  → 检查 PCIe 带宽 → lspci -s <BDF> -vvv | grep -E "Width|Speed"
    → 是否插在了低带宽槽位
  → 检查 NUMA 亲和 → 同节点 vs 跨节点
  → 检查 MTU → 确认使用了最大 MTU(4096 或更大)
九、交叉引用
| 你想…… | 用什么 |
|---|---|
| 看普通 TCP/UDP 连接 | ss(RDMA 流量它看不到) |
| 看 RDMA 设备/计数器 | rdma、ibv_devinfo、/sys/class/infiniband/ |
| 确认网卡在哪个 NUMA 节点 | cat /sys/class/.../numa_node、numactl -H |
| 把 RDMA 进程绑到网卡节点 | numactl / libnuma |
| 理解跨节点为何变慢 | numa |
⚠️ 平台提醒:RDMA 需要专用硬件(IB 网卡,或支持 RoCE/iWARP 的以太网卡,如 Mellanox/NVIDIA ConnectX 系列)和
rdma-core软件栈。普通云主机、笔记本、macOS 没有 RDMA 设备,ibv_devinfo会报无设备。RoCE 还依赖交换机侧的无损网络(PFC/ECN)配置。本篇是概念与优化思路,实操需在配好 RDMA 的环境里进行。
总结
RDMA 靠 Kernel Bypass、Zero Copy 和网卡协议卸载,让网卡直接在两端已注册内存(MR)间 DMA,把跨机延迟从几十微秒压到 1~2 微秒;编程用 QP/CQ/MR/PD 和单边 READ/WRITE,选型上 IB 最强、RoCE v2 是数据中心主流(依赖无损网络)。关键易忽视点:网卡挂在固定 NUMA 节点,线程和 MR 跨节点会被 QPI 延迟抵消掉 RDMA 优势,必须严格本地化。