objdump —— 反汇编与查看 ELF 内容
objdump 侧重反汇编和内容查看,最懂机器指令,还能把源码和汇编混排。和 readelf 分工:查结构用 readelf,看代码用 objdump。属 binutils。
数据来源
- 来源对象:目标 ELF 文件的内容——从
.text等节读机器码;-S混排时额外读.debug_*(DWARF)里的源码行映射;-t/-T读符号表节。 - 采集方式:静态读文件,机器码经反汇编器(libopcodes)还原成汇编;不运行程序。
- 由此决定的特性:
-S混排源码需要二进制带-g;反汇编结果反映的是编译后的实际指令(含优化后的样子),和-O级别强相关——这也是拿它对比-O0/-O2的价值所在。
bash
yum install binutils / apt install binutils一、常用选项
bash
objdump -d <file>        # 反汇编所有可执行节(.text 等)
objdump -D <file>        # 反汇编所有节(含数据节,信息全但杂)
objdump -S <file>        # 反汇编 + 混排源码(需 -g 编译,最有用)
objdump -M intel -d <file>  # 用 Intel 汇编语法(默认 AT&T,习惯 Intel 的加这个)
objdump -t <file>        # 符号表(类似 nm)
objdump -T <file>        # 动态符号表
objdump -h <file>        # 节头概览(比 readelf -S 简略)
objdump -s -j .rodata <file>  # 十六进制 dump 指定节(-j 选节)
objdump -f <file>        # 文件头摘要(架构、入口)
objdump -d -l <file> # 反汇编 + 标注源码行号(-l)二、-S 源码/汇编混排(最常用)
前提:-g 编译。这是理解"某行 C++ 编成了什么指令"、以及配合 core 分析栈布局的利器。
bash
$ objdump -S ./cpu_demo
...
void busy_kernel_cpu() {
   1234:  push   %rbp
   1235:  mov    %rsp,%rbp
    std::ofstream f(tmp_file, std::ios::app);
   1240:  lea    -0x30(%rbp),%rax
   1247:  call   1050 <_ZNSt14basic_ofstream...>
    f.write("hello\n", 6);
   ...
对应 core-dump 里 gdb 的 disassemble /m——objdump 是离线静态版本,不用进 gdb 就能看某函数的栈帧布局(sub $0x20,%rsp 开了多大栈、局部数组在 rbp-N 哪个位置)。
三、-d 纯反汇编 + Intel 语法
bash
$ objdump -M intel -d ./cpu_demo | grep -A20 '<main>:'
0000000000001189 <main>:
    1189:  push   rbp
    118a:  mov    rbp,rsp
    118d:  sub    rsp,0x20
    ...
11b5: call 1080 <_ZNSt8ios_base4InitC1Ev@plt>- 左列是地址,中间是机器码(默认省略,
--show-raw-insn显示),右边是汇编。 call ... @plt说明调用的是动态库函数(通过 PLT 跳板),印证动态链接。
四、看符号名被 C++ 修饰(mangling)
C++ 函数名在符号表里是 mangled 的(如 _Z15busy_kernel_cpuv),objdump 加 -C(demangle)还原成人读的:
bash
objdump -C -d ./cpu_demo | grep -A5 busy_kernel_cpu # 显示 busy_kernel_cpu() 而非 _Z...(单独还原一个符号名用 c++filt,见 misc。)
五、结合本仓库
bash
make
objdump -S ./cpu_demo | less                 # 源码+汇编混排,找 busy_user_cpu 的累加循环
objdump -M intel -d ./cpu_demo | grep '<main>' -A30   # 看 main 的 Intel 汇编
objdump -C -t ./cpu_demo | grep busy         # demangle 后的符号地址
make release                                  # -O2
objdump -S ./cpu_demo                         # 对比:热循环 sum+=i 可能被优化没了/向量化
对比实验很直观:
-O0版busy_user_cpu里能看到老实的循环加法;-O2(make release)版那段可能整个消失或被向量化——这就是为什么 perf/gdb 分析要注意编译优化级别。
六、objdump vs readelf
| 需求 | 用 |
|---|---|
| 看 ELF 头、段/节结构、动态依赖、NOTE | readelf(更规整、更懂 ELF) |
| 反汇编、混排源码、看指令 | objdump(更懂机器码) |
| 看符号表 | 两者都行;专门列符号用 nm |
七、一句话总结
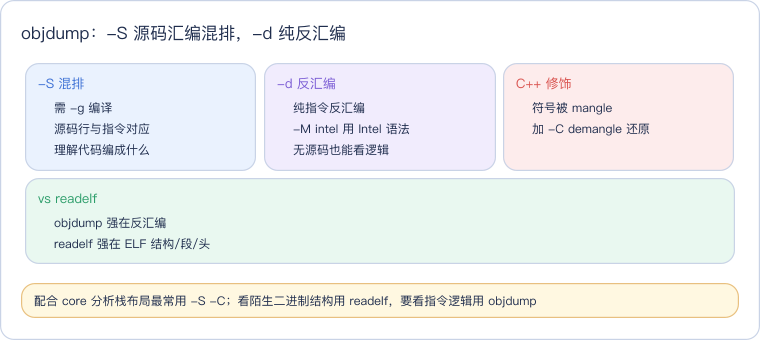
objdump 强在反汇编:-S 源码汇编混排(需 -g)、-d 纯反汇编、-C 还原 C++ 修饰名;看 ELF 结构用 readelf,看指令逻辑用 objdump。