io_context、seccomp、rseq 与更多可共享资源
这是 task-struct 的资源对象总览的补充篇。除了大家熟悉的 mm/files/signal/cred/nsproxy 之外,
task_struct还挂着一批容易被忽略但同样可共享的资源对象——异步 IO 上下文、系统调用过滤器、重启序列等。本篇逐项拆解。
零、总图:task_struct 挂着什么——完整版

一、io_context —— 异步 IO 的上下文
1.1 是什么
task->io_context 是进程级别的异步 IO(AIO)上下文,记录这个进程的所有异步 IO 操作的状态。每个使用 Linux AIO(libaio/io_submit/io_getevents)或 block layer 的 IO 优先级调度都需要它。

1.2 IO 调度优先级(ionice)
| Class | 值 | 说明 | 使用场景 |
|---|---|---|---|
IOPRIO_CLASS_RT | 1 | 实时 IO,先于所有人 (priority 0-7) | 绝对不能等的延迟敏感 IO |
IOPRIO_CLASS_BE | 2 | Best-effort,默认 (priority 0-7) | 绝大多数进程 |
IOPRIO_CLASS_IDLE | 3 | 只在没人用磁盘时才跑 | 后台批量任务(备份/日志压缩) |
# 查看/设置 IO 优先级
ionice -p <pid>          # 读
ionice -c 2 -n 0 ./app   # BE 最高优先级
ionice -c 3 ./backup.sh  # IDLE 级, 不抢前台 IO
CFQ/BFQ 调度器下才完全生效,
mq-deadline/kyber等多队列调度器下含义不完全等同。不过ionice命令设的值会被存到io_context里。
1.3 共享规则
- 线程共享
io_context(CLONE_IOflag) - fork 子进程继承父的 io_context(引用计数 +1)
execve不清除 io_context- 一个进程只有一个 io_context,所有线程的 AIO 合并统计
1.4 AIO 工作流程
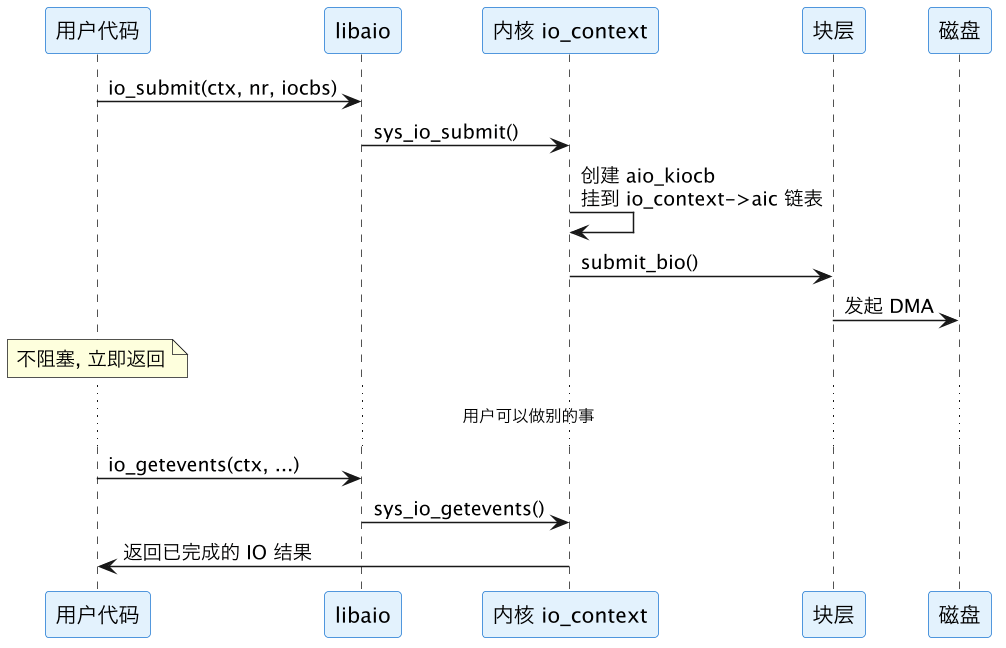
io_uring 不是用这套 io_context:io_uring (5.1+) 有自己的
io_ring_ctx结构,和传统 AIO 的io_context是两套体系。本文讲的是传统 AIO 那套。
二、seccomp —— 系统调用过滤器
2.1 是什么
seccomp(SECure COMPuting)允许进程限制自己能调用哪些系统调用——是 Linux 沙箱机制的基石。Chrome/Docker/Firejail/systemd 都在用。
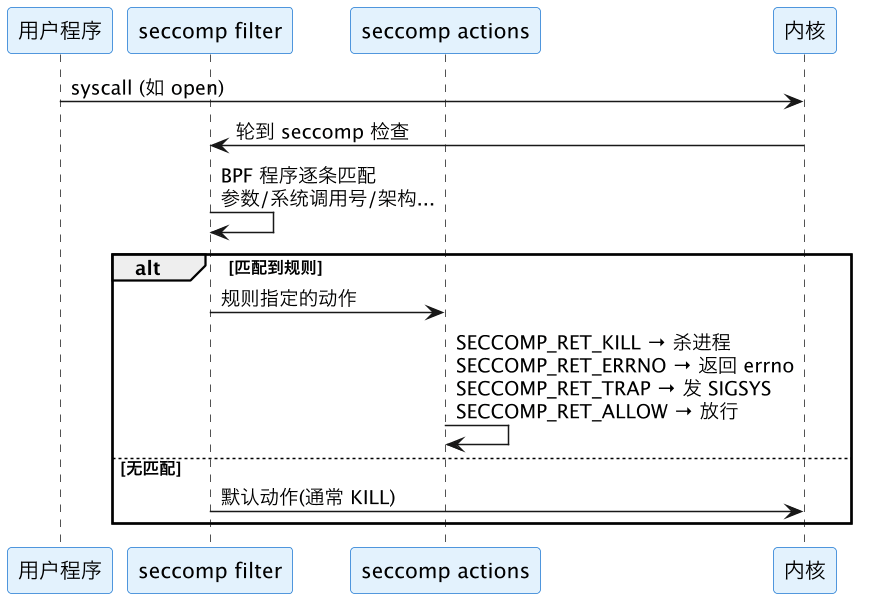
2.2 seccomp filter 即 BPF 程序
seccomp-bpf 用经典的 cBPF 字节码(不是 eBPF)写过滤规则——在用户态编译成 BPF 指令数组,用 prctl(PR_SET_SECCOMP, ...) 安装到内核:
#include <linux/seccomp.h>
#include <linux/filter.h>
#include <sys/prctl.h>
// BPF 程序:只允许 read/write/exit, 其余全杀
struct sock_filter filter[] = {
    // 检查架构(防止 32/64 位绕过)
    BPF_STMT(BPF_LD | BPF_W | BPF_ABS, offsetof(struct seccomp_data, arch)),
    BPF_JUMP(BPF_JMP | BPF_JEQ | BPF_K, AUDIT_ARCH_X86_64, 1, 0),
    BPF_STMT(BPF_RET | BPF_K, SECCOMP_RET_KILL),
    // 检查系统调用号
    BPF_STMT(BPF_LD | BPF_W | BPF_ABS, offsetof(struct seccomp_data, nr)),
    BPF_JUMP(BPF_JMP | BPF_JEQ | BPF_K, __NR_read, 0, 1),
    BPF_STMT(BPF_RET | BPF_K, SECCOMP_RET_ALLOW),
    BPF_JUMP(BPF_JMP | BPF_JEQ | BPF_K, __NR_write, 0, 1),
    BPF_STMT(BPF_RET | BPF_K, SECCOMP_RET_ALLOW),
    BPF_JUMP(BPF_JMP | BPF_JEQ | BPF_K, __NR_exit, 0, 1),
    BPF_STMT(BPF_RET | BPF_K, SECCOMP_RET_ALLOW),
    BPF_STMT(BPF_RET | BPF_K, SECCOMP_RET_KILL),  // 默认杀
};
struct sock_fprog prog = {
    .len = sizeof(filter) / sizeof(filter[0]),
    .filter = filter,
};
prctl(PR_SET_NO_NEW_PRIVS, 1, 0, 0, 0);  // 必须先设这个
prctl(PR_SET_SECCOMP, SECCOMP_MODE_FILTER, &prog);
2.3 两种模式
| 模式 | 设置方法 | 行为 |
|---|---|---|
SECCOMP_MODE_STRICT | prctl(PR_SET_SECCOMP, SECCOMP_MODE_STRICT) | 只允许 read/write/_exit/sigreturn——最简单最严格 |
SECCOMP_MODE_FILTER | prctl(PR_SET_SECCOMP, SECCOMP_MODE_FILTER, &prog) | 用 BPF 程序自定义规则 |
2.4 共享规则
- 线程共享 seccomp filter(
CLONE_SECCOMP),过滤器只能加严,不能放宽 PR_SET_NO_NEW_PRIVS必须先设——防止 setuid 程序绕过- 装了 filter 后,fork 的子进程也继承这些 filter
execve不消除 filter(这是安全关键——保证"沙箱牢不可破")
2.5 seccomp 在实际场景中的使用
# Docker 默认 seccomp profile 拦截约 44 个危险 syscall
# 容器中不生效的例子:
docker run --security-opt seccomp=unconfined ...  # 关掉 seccomp
# systemd 服务单元
[Service]
SystemCallFilter=~@mount @reboot     # 禁止 mount/reboot 相关调用
SystemCallArchitectures=native       # 禁止 32 位系统调用
# 观测某个进程的 seccomp 状态
cat /proc/<pid>/status | grep Seccomp
# Seccomp: 0=禁用 / 1=STRICT / 2=FILTER
三、rseq —— 可重启序列(Restartable Sequences)
3.1 是什么
rseq 是 Linux 4.18+ 引入的无锁快速 per-CPU 数据访问机制。它让用户态线程可以原子地读写 per-CPU 数据而不用系统调用。
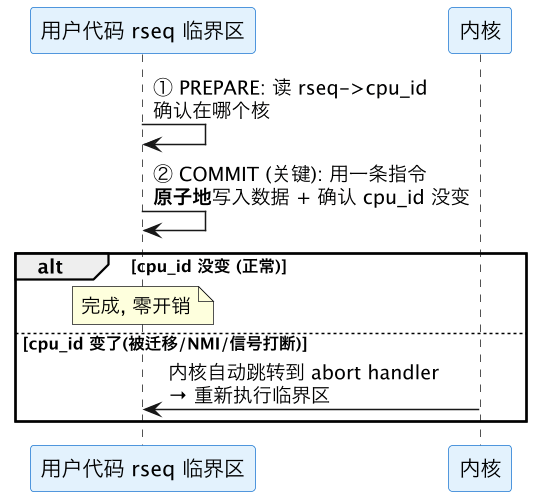
3.2 rseq 的核心价值
| 传统方案 | rseq |
|---|---|
| 需要系统调用(sched_getcpu) | 读一块共享内存,零 syscall |
| 需要锁保护 per-CPU 操作 | 无锁,COMMIT 指令本身就是原子保证 |
| 被迁移后需要全部重做 | 内核自动 abort+重启——用户只需写一个"重做循环" |
glibc 2.35+ 已内置 rseq 支持,
sched_getcpu()内部优先走 rseq 而不是 vsyscall。
3.3 共享规则
- rseq 每线程独立注册(
rseq系统调用 per-task) clone/fork不继承 rseq 注册——子进程需重新注册- 每个 task 只能在一个 CPU 上同时拥有 rseq 临界区
3.4 观测
# 检查内核是否支持
grep CONFIG_RSEQ /boot/config-$(uname -r)   # CONFIG_RSEQ=y
# glibc 是否初始化了 rseq(2.35+)
cat /proc/<pid>/maps | grep rseq            # 会在堆中看到 rseq 段
四、robust_list / compat_robust_list —— Futex 健壮列表
task->robust_list 记录这个线程持有的所有 robust futex(PI futex 的一种)。如果线程在没有释放 futex 的情况下去世(崩溃/被杀),内核会自动代为解锁:
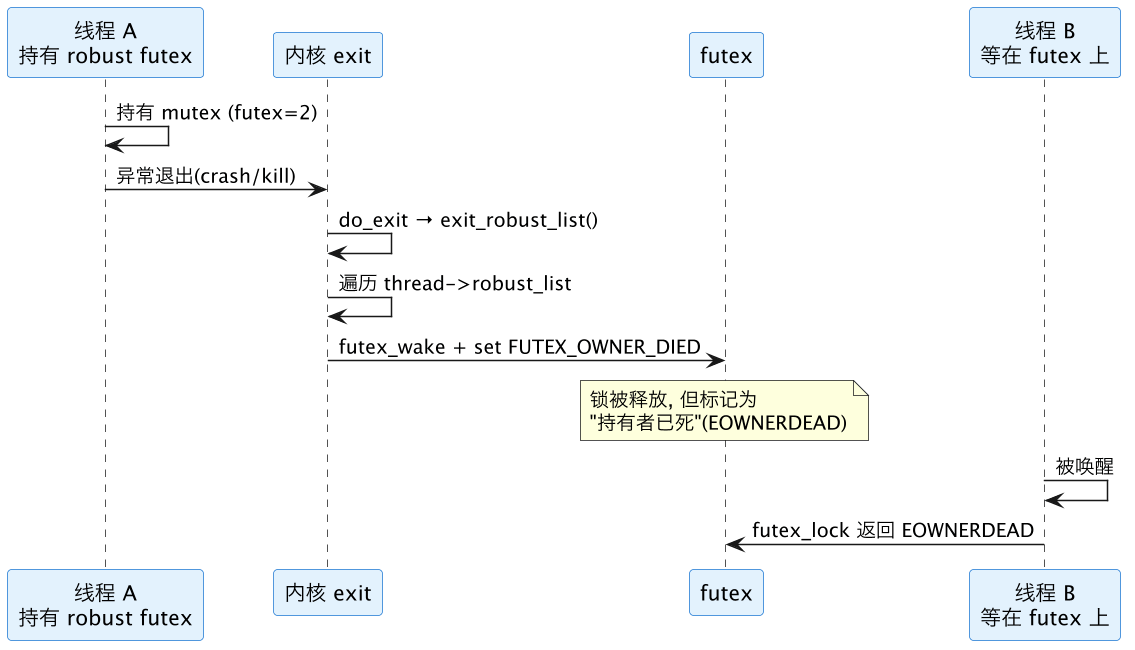
- pthread mutex 设为
PTHREAD_MUTEX_ROBUST就会自动注册到robust_list - fork 子进程清空 robust_list(子进程重新开始)——父子不共享
- 否则一个线程 crash 而 mutex 无人解锁 → 等待者永远阻塞
五、其他容易被忽略的相关结构
| task_struct 字段 | 类型 | 含义 | 共享 |
|---|---|---|---|
sched_entity / sched_rt_entity / sched_dl_entity | 内嵌结构 | 调度实体数据(vruntime/权重...) | 私有(每个 task 自己的调度数据) |
wake_q | struct wake_q_node | 唤醒链表节点,lazy 成批唤醒优化 | 私有 |
journal_info | void * | 文件系统日志事务上下文(ext4/xfs 用来追踪当前事务) | 私有(一个 task 同一时间只能在一个 FS 事务中) |
bio_list | struct bio_list | 当前 task 攒着待提交的 block IO(plug IO 批量合并) | 私有 |
plug | struct blk_plug | block layer 的"塞子",攒 IO 请求成批提交 | 私有 |
security | void * | LSM(SELinux/AppArmor)安全上下文 | 私有 |
memcg_in_oom | struct mem_cgroup * | 记录当前被 OOM 的 memcg(防止递归 OOM) | 私有 |
in_eventfd_ctx | bool | 正在处理 eventfd 通知(防死循环唤醒) | 私有 |
六、完整共享规则速查表(含新增项)
| 资源对象 | 内核结构 | fork 子进程 | 同进程线程 | clone flag |
|---|---|---|---|---|
| 地址空间 | mm_struct | 复制(CoW) | 共享 | CLONE_VM |
| 打开文件表 | files_struct | 复制 | 共享 | CLONE_FILES |
| 文件系统上下文 | fs_struct | 复制 | 共享 | CLONE_FS |
| 信号处理表 | sighand_struct | 复制 | 共享 | CLONE_SIGHAND |
| 线程组信号状态 | signal_struct | 复制 | 共享 | CLONE_THREAD |
| 凭证 | cred | 复制(继承) | 共享 | — |
| 命名空间 | nsproxy | 默认继承 | 共享 | CLONE_NEW* |
| IO 上下文 | io_context | 继承(引用+1) | 共享 | CLONE_IO |
| seccomp filter | seccomp | 继承(只加严) | 共享 | CLONE_SECCOMP |
| rseq | rseq | 不继承 | 每线程独立注册 | — |
| robust_list | robust_list_head | 清空 | 每线程独立 | — |
| 调度实体 | sched_entity | 复制 | 私有(不同 task 各自调度) | — |
| 统计/计时 | utime/stime/... | 清零 | 私有 | — |
七、一句话总结
task_struct 挂着的远不止五个常见资源对象。
io_context(AIO 上下文和 IO 调度优先级,线程共享)、seccomp(BPF 系统调用过滤器,只能加严不能放宽,Chrome/Docker 都用它做沙箱)、rseq(per-CPU 无锁操作,每线程独立注册)、robust_list(线程死后内核代解锁的 mutex 列表)——每一类都有自己的共享规则和 clone flag。对照共享规则速查表,看清 fork 是复制还是共享、clone flag 是谁在控制。