mm_struct —— 进程的地址空间描述符
这是 task-struct 里
task->mm那一项的展开。mm_struct是内核对"一个进程看到的整个虚拟地址空间"的完整刻画:有哪些内存段(VMA)、页表在哪、堆栈边界在哪、多少人在用它。本篇讲mm_struct结构本身、VMA 组织方式与演进、页表层级、内存统计、生命周期、上下文切换时的行为;映射的具体玩法转 mmap,段的地址布局转 memory-layout,页表翻译转 tlb 和 page-table-translation。
零、一句话认知:mm_struct = "这个进程内存长什么样"的总账本
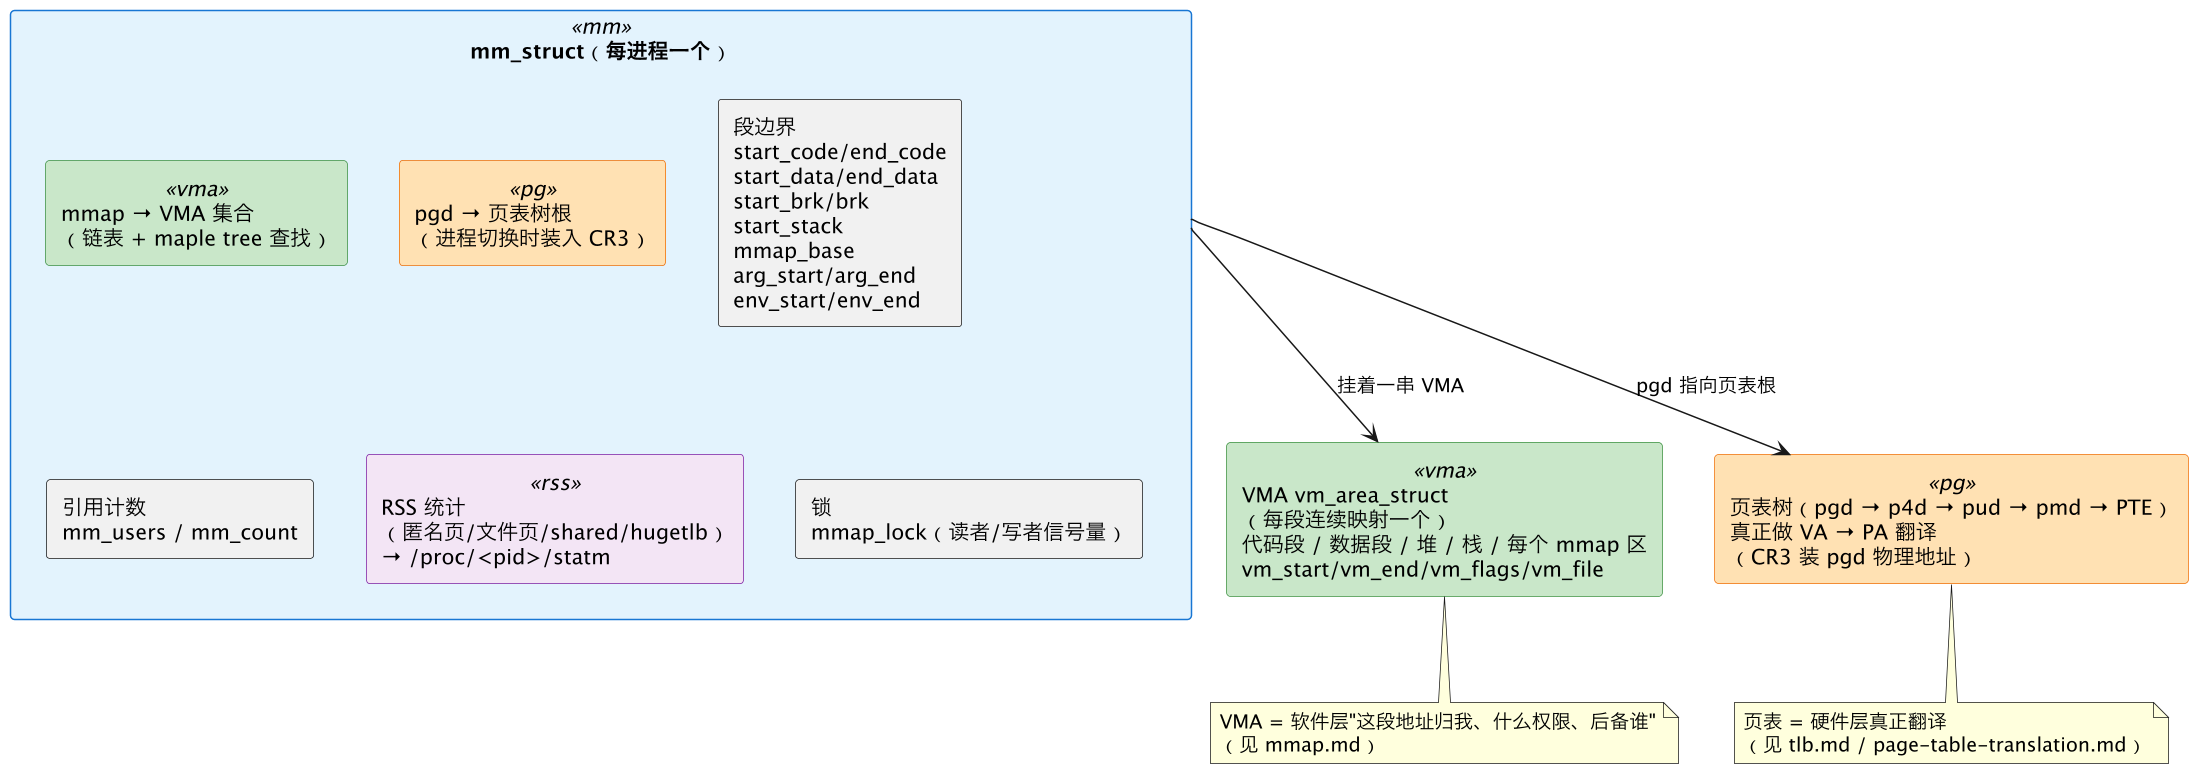
每个有用户地址空间的进程,task_struct 里的 mm 指针都指向一个 mm_struct。它把地址空间的三样核心资源攒在一起:一组 VMA(每段连续映射)、一个页表根 pgd(硬件翻译入口)、各段的边界与统计。
核心记忆:
mm_struct是软件层的地址空间账本(有哪些段、边界在哪、引用计数),它挂着两样东西——VMA 集合(逐段描述)和页表 pgd(硬件翻译)。VMA 是"计划"(我打算让这段内存做什么),页表是"落地"(硬件实际怎样翻译),缺页时把计划兑现成页表项(见 mmap)。
一、mm_struct 核心字段分组
mm_struct 字段众多,按功能分五组:
| 分组 | 字段(类) | 作用 | 深入篇 |
|---|---|---|---|
| VMA 集合 | mmap(链表头)、mm_rb/mm_mt(查找结构) | 所有 vm_area_struct 的组织与查找 | §1.1、mmap |
| 页表根 | pgd | 指向进程页全局目录——四级/五级页表的根 | §1.2、tlb |
| 段边界 | start_code/end_code、start_data/end_data、start_brk/brk、start_stack、mmap_base | 各段的起止虚拟地址 | §1.3、memory-layout |
| 内存统计 | rss_stat、total_vm、locked_vm、pinned_vm、hiwater_rss | 常驻/锁定/峰值内存 | §1.4 |
| 生命周期 | mm_users、mm_count、owner、exe_file | 谁在用、何时释放 | §1.5 |
| 锁 | mmap_lock(读者/写者信号量) | 保护 VMA 增删改查、缺页处理 | — |
1.1 VMA 组织方式:从链表到红黑树到 maple tree
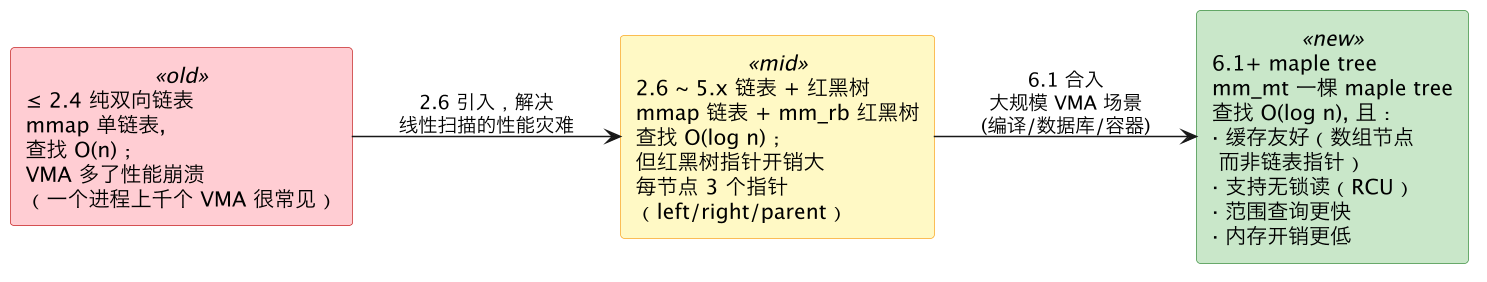
VMA 集合的查找结构经历了三次演进,这是现代内核中最精彩的"数据结构换性能"案例之一:
为什么 VMA 查找性能如此关键
一个进程的每次缺页(page fault),内核都要在 VMA 集合中查找"这个虚拟地址落在哪个 VMA 里",以确定该段的权限和映射类型。这发生在缺页的热路径上:
缺页 → find_vma(addr) → 在 VMA 集合中定位 → 检查权限 → 建立页表
                    ↑
O(1) ↓ O(n) 的天壤之别- 链表时代的痛:一个 JVM/Chrome 进程常有 5000~20000 个 VMA(每个 mmap 一个、每个 .so 映射几段),链表 O(n) 遍历一次缺页走 10000 步,CPU 全耗在链表中。
- 红黑树改善:O(log n),10000 个 VMA 约 14 次比较,解决大部分问题。
- maple tree 的质变:不仅查找 O(log n),还支持 RCU 无锁读——并发缺页时多个 CPU 可以同时查 VMA 而不抢
mmap_lock。对多线程内存密集型应用(数据库、编译、容器运行时)的提升是系统级的。
关键理解:
mmap链表从未被去掉——即使升级到 maple tree,链表仍然保留(用于遍历所有 VMA,如/proc/<pid>/maps的输出)。maple tree 替代的是mm_rb红黑树(查找功能),链表负责遍历功能,两者分工不同。
1.2 pgd —— 页表树的根
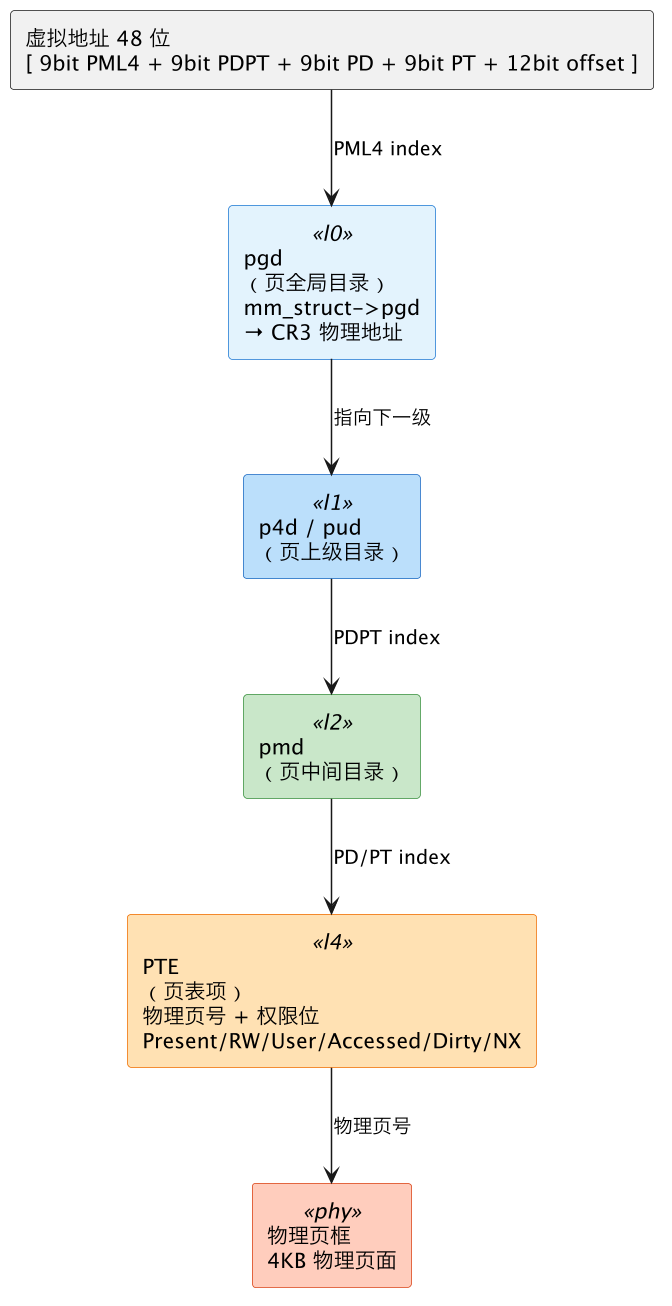
每个虚拟地址到物理地址的翻译,都从 pgd 出发,经历 4 级(或 5 级,La57)页表逐级查找到 PTE,取出物理页号 + offset 拼成物理地址。这个过程的每个细节见 page-table-translation 和 tlb。
pgd 与 mm_struct 的关系:
| 要点 | 说明 |
|---|---|
mm->pgd 存的是什么 | pgd 页的内核虚拟地址(不是物理地址,内核可以直接解引用) |
| CR3 装的是 | pgd 页的物理地址——__pa(mm->pgd) 在进程切换时写入 CR3 |
| 什么时候创建 | 进程创建时(fork → mm_init → pgd_alloc)分配一个物理页作为 pgd |
| 什么时候释放 | __mmdrop → pgd_free,进程死亡时最后一步 |
| 内核空间页表 | 所有进程的 pgd 中,内核地址部分的表项完全一样(共享内核映射,进程切换时只变用户空间部分) |
内核空间共享是 Linux 的古老设计:进程切换时不需要换内核页表,只需更新用户空间部分(或直接换 CR3 让 TLB 自动区分 PCID/ASID),避免了"切到内核线程先要装内核页表"的开销。详见 §四。
1.3 段边界字段——把虚拟地址分成若干区间
          高地址
     ┌─────────────────────┐ ← TASK_SIZE_MAX
     │  栈 stack            │ stack = mm->start_stack(初始栈顶)
     │  ↓ 向下生长          │
     ├─────────────────────┤
     │  ↕                   │
     │  mmap 区              │ mmap 区域从 mm->mmap_base 向下排
     │  (.so / 匿名映射)     │
     │  ↕                   │
     ├─────────────────────┤
     │  堆 heap             │ brk = mm->brk(堆顶可动)
     │  ↑ 向上生长          │ start_brk(堆起始)
     ├─────────────────────┤
     │  .bss / .data        │ end_data / start_data
     │  .text(代码)        │ end_code / start_code
     └─────────────────────┘
          低地址
六个关键边界字段的含义:
| 字段 | 含义 | 可增长? | 谁设的 |
|---|---|---|---|
start_code / end_code | 可执行代码段(.text)的虚拟地址范围 | 否(固定) | execve 时由 ELF 加载器填写 |
start_data / end_data | 已初始化数据段(.data)的虚拟地址范围 | 否(固定) | execve 时由 ELF 加载器填写 |
start_brk | 堆起始地址(.bss 段末尾) | 否(起点固定) | execve 时设定,后续不变 |
brk | 堆顶(可增长,sbrk()/brk() 系统调用移动它) | 是——brk() 调大 | brk 系统调用修改 |
start_stack | 初始栈顶(主线程的栈起点) | 是——栈自动向下增长(缺页触发) | execve 时设定 |
mmap_base | mmap 区域的起始地址(从高往低分配) | 否(分配基准不变) | execve 时由 arch_pick_mmap_layout() 选择 |
brk增长 vsmmap分配:malloc小内存(通常 < 128 KB)优先从堆(brk)扩,大块则用mmap从 mmap 区分配。mm->brk只反映前一类的上限。详细逻辑见 memory-layout。
1.4 RSS 统计——这个进程到底吃了多少物理内存
mm->rss_stat 是一个 struct mm_rss_stat,按页类型分组计数:
struct mm_rss_stat {
    atomic_long_t count[NR_MM_COUNTERS];
    // MM_FILEPAGES  —— 文件映射页(如 .so、mmap 文件)
    // MM_ANONPAGES  —— 匿名页(堆、栈、malloc mmap)
    // MM_SWAPENTS   —— 被换出到 swap 的页
    // MM_SHMEMPAGES —— 共享内存页
};
/proc/<pid>/statm 和 status 的 Vm 系列就是从这里来的:
cat /proc/<pid>/statm
# 输出: size resident shared text lib data dt
# size     = total_vm(总虚拟页数)        → VmSize
# resident = rss(常驻物理页数)           → VmRSS
# shared   = 共享页数                      → RssShmem + RssFile
# text     = 代码段常驻页数                → VmExe
# data     = 数据+堆常驻页数               → VmData
cat /proc/<pid>/status | grep -E 'Vm|Rss'
# VmSize / VmRSS / VmData / VmStk / VmExe / VmLib / VmPTE / VmSwap
# RssAnon / RssFile / RssShmem| 统计项 | 来源 | 含义 |
|---|---|---|
VmSize | mm->total_vm | 虚拟地址空间总大小(含未实际分配的) |
VmRSS | mm->rss_stat[file+anon+shmem] | 实际占用的物理页数(不含换出的) |
VmData | 堆段 VMA 的虚拟大小 | 堆的大小(brk - start_brk + mmap 匿名段) |
VmStk | 栈段 VMA 的虚拟大小 | 主线程栈大小 |
VmExe | 代码段 VMA 常驻页数 | 代码在内存里的实际占用量 |
RssAnon | rss_stat[MM_ANONPAGES] | 匿名页常驻(堆、栈、malloc 大块) |
RssFile | rss_stat[MM_FILEPAGES] | 文件映射页常驻(.so 代码、mmap 文件) |
RssShmem | rss_stat[MM_SHMEMPAGES] | 共享内存页 |
VmRSS ≠ 进程真实的"独占"物理内存:RSS 包含共享库(每个进程都算一遍 glibc 的页),所以同一个.so被 100 个进程映射时,RSS 总和远大于实际物理内存。PSS(Proportional Set Size,见/proc/<pid>/smaps)做了分摊——共享页按引用进程数等分,更接近真实开销。
1.5 两个引用计数为什么分开:mm_users vs mm_count
这是 mm_struct 最容易搞混的点:
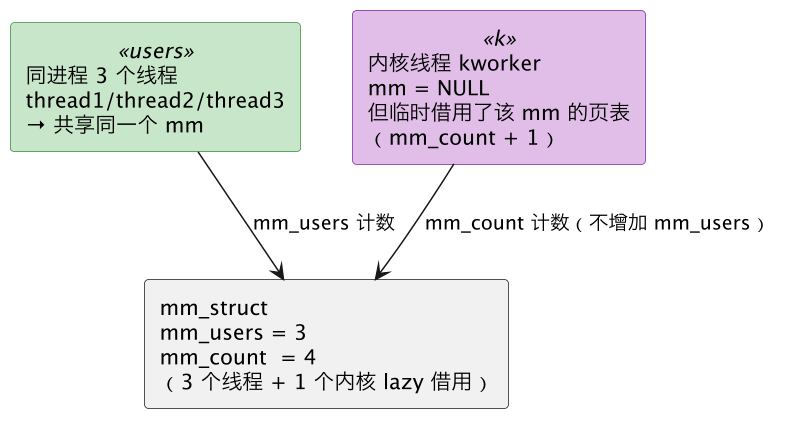
mm_users:多少**任务(线程)**把它当自己的地址空间在用。同进程 3 个线程 →mm_users = 3。归零表示"没有用户线程了",地址空间可以拆(VMA、页表可回收)。mm_count:多少引用(包括mm_users整体算 1 个引用,加上内核临时借用的 lazy 引用)。归零才 free 掉mm_struct结构体本身。- 为什么分两层:内核线程没有自己的地址空间(
mm == NULL),但运行时临时借用上一个进程的 mm 页表(lazy TLB,省一次 CR3 切换)。这种借用只加mm_count、不加mm_users——保证"用户都走光了就能拆地址空间",但mm_struct结构体本身要等借用也还了才释放。
| 操作 | mm_users 变化 | mm_count 变化 | 说明 |
|---|---|---|---|
pthread_create(同进程线程) | +1 | +1 | 线程共享 mm |
| 线程退出 | -1 | -1 | mm_users 归零 → 可拆地址空间 |
| 内核线程借用(lazy TLB) | 不变 | +1 | 只借页表,不算用户 |
| 内核线程归还 | 不变 | -1 | mm_count 归零 → 可 free 结构体 |
fork() 子进程 | 新 mm,初始 = 1 | 新 mm,初始 = 1 | 独立计数 |
execve() | 不变(换的是 mm 内容) | 不变 | 旧 mm 的 count 减,新 mm 独立 |
二、线程共享、进程复制
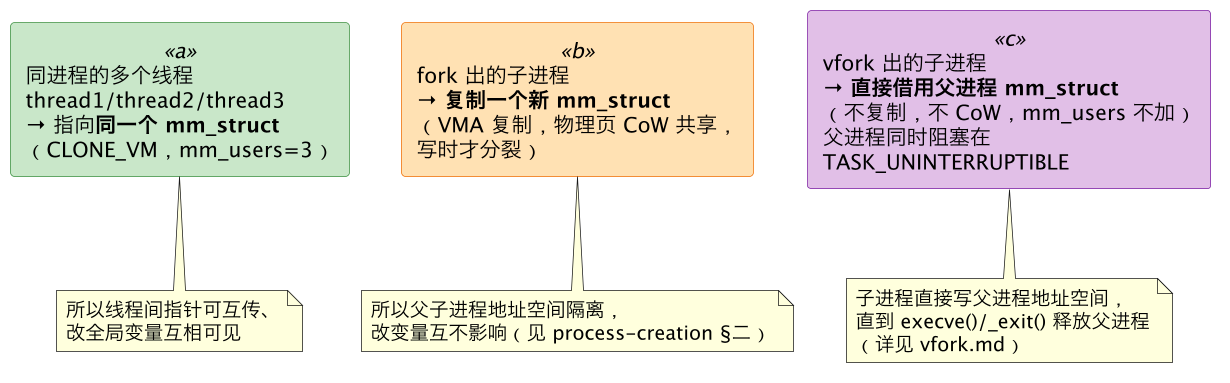
| 场景 | mm_struct | 后果 |
|---|---|---|
| 同进程线程 | 共享同一个(CLONE_VM) | 地址互通、全局变量共享、mm_users 累加 |
| fork 子进程 | 复制新的(VMA 复制、物理页 CoW) | 地址空间隔离,写时复制分裂(见 process-creation §二) |
| vfork 子进程 | 借用父进程 mm(不复制,不 CoW) | 子进程可直接读写父进程地址空间;父进程阻塞直到子进程 execve()/_exit()(详见 vfork) |
| 内核线程 | mm == NULL | 无用户地址空间,借用上个进程页表(lazy TLB) |
| execve | 换成全新 mm | 旧地址空间整个丢弃,装入新程序的段 |
2.1 fork 复制 mm——VMA 全量拷贝,物理页 CoW
fork() 时 mm_struct 的复制是真拷贝:VMA 列表逐段复制,每个 vm_area_struct 都要新建一份。但物理页不走真复制——走写时复制(Copy-on-Write):
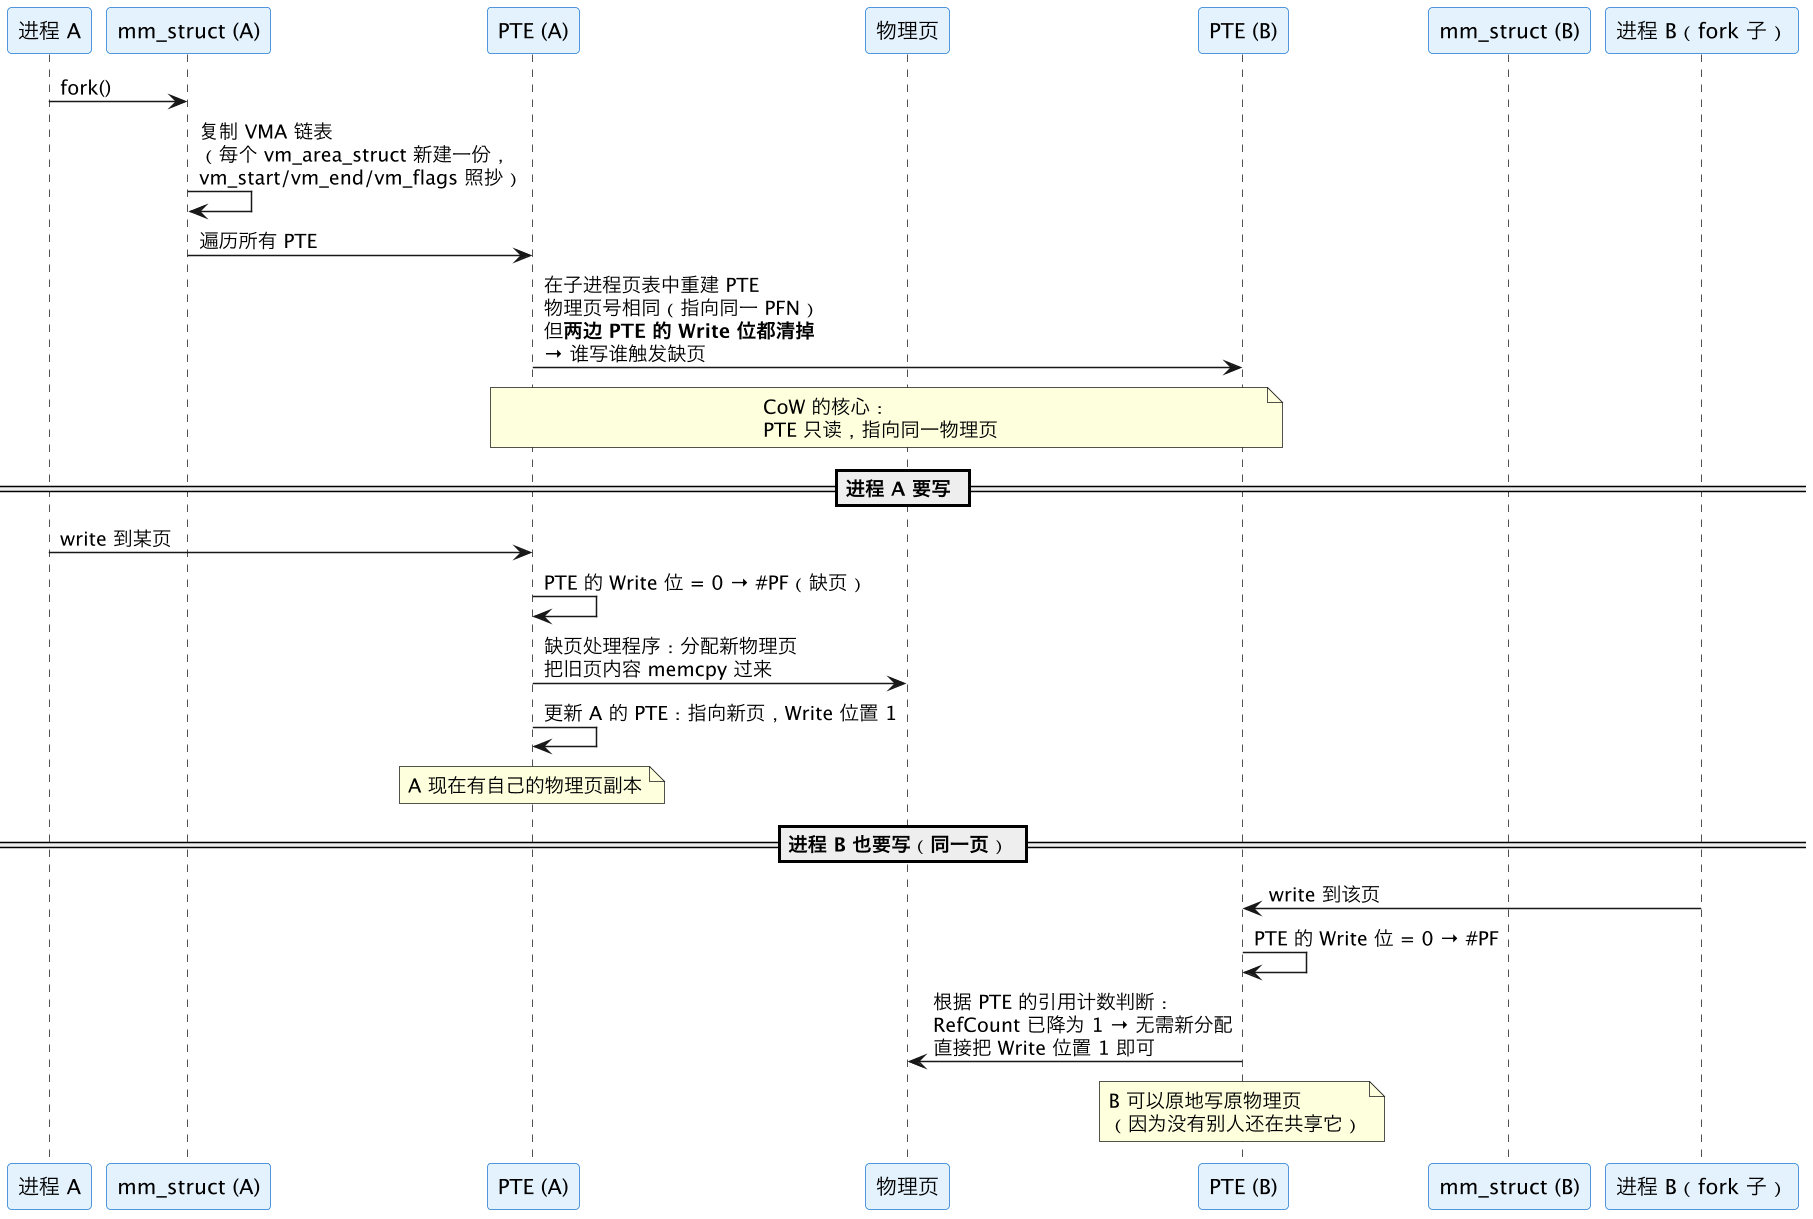
核心:
fork复制 VMA(软件层的"段描述"),但物理页不拷贝——PTE 指向同一 PFN 且都设只读。哪个进程先写,就在缺页处理中拷贝一份物理页。这个过程对用户态完全透明。详见 process-creation §二。
三、mm_struct 的生命周期
3.1 诞生——execve 时创建全新 mm
进程被 execve 换脑时,旧 mm_struct 被整个丢弃(mmput),新 mm_struct 由 bprm_mm_init 分配和初始化:
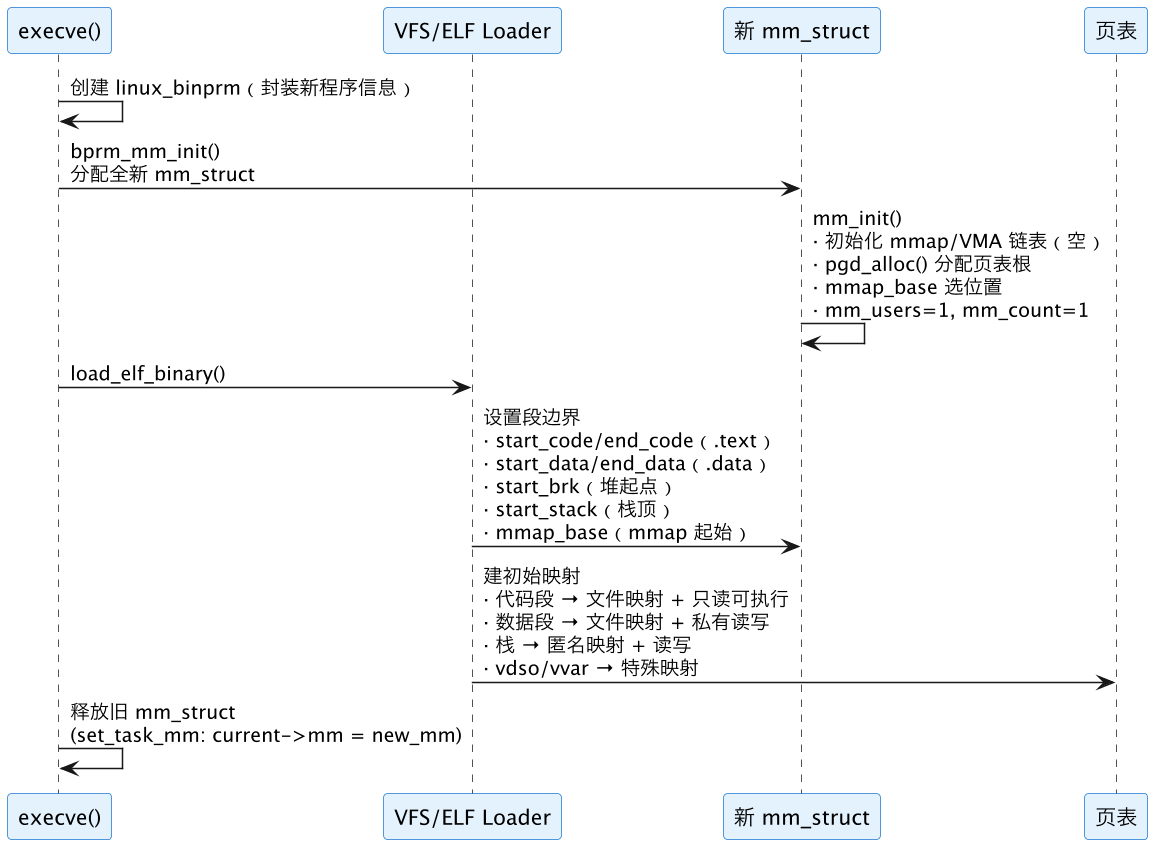
3.2 消亡——exit 时的逐步拆解
进程退出(do_exit)时 mm_struct 不是瞬间释放的,而是逐步拆:
do_exit()
  → mmput(mm)              // 减 mm_users,通常归零
    → if mm_users == 0:
        exit_mmap()        // ① 先拆 VMA:遍历释放所有 vm_area_struct
                            //    同时 zapping 页表(清空用户空间 PTE)
        set_task_mm(NULL)  // ② 切断 task->mm 指针
        mmdrop(mm)         // ③ 减 mm_count
          → if mm_count == 0:
              __mmdrop()
                → pgd_free(mm->pgd)   // ④ 释放页表根页
                → free_mm(mm)         // ⑤ 释放 mm_struct 本身
为什么要分 exit_mmap 和 mmdrop 两步?因为可能有内核线程还在借用页表(mm_count > mm_users):先拆 VMA 和页表内容(反正用户地址空间没人用了),但 pgd 页和 mm_struct 结构体要等所有借用者归还后才真正释放。
3.3 上下文切换时的 mm 行为
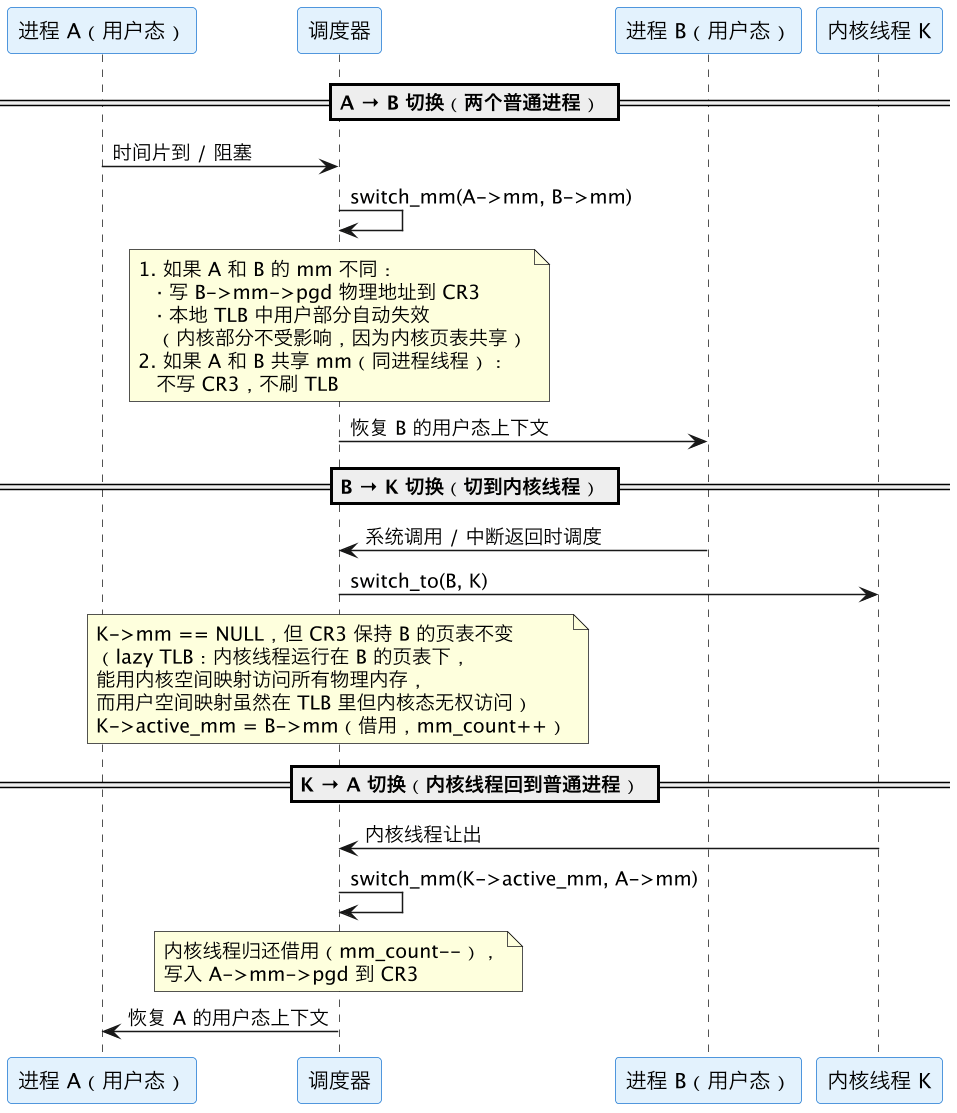
切换优化——两个不写 CR3 的场景:
| 场景 | CR3 是否写 | 是否刷 TLB | 条件 |
|---|---|---|---|
| 前后进程共享同一个 mm(同进程线程) | 否 | 否 | next->mm == prev->mm |
| 切到内核线程 | 否 | 否 | next->mm == NULL,沿用 prev 页表 |
| 前后进程不同 mm | 是 | 是(用户部分) | next->mm != prev->mm,需换地址空间 |
| PCID/ASID 启用时 | 是(但写的是 PCID) | 否(硬件按 PCID 区分) | 现代 x86/ARM 均有支持 |
PCID(Process Context Identifier):x86 的优化——CR3 低 12 位存一个 PCID 标签,TLB 按标签区分不同进程的条目。切换时只写新 PCID 到 CR3,TLB 里的旧条目不会立即失效,而是自然过期或被新条目挤出。这样避免了"一切换就全局刷 TLB"的性能灾难。ARM 对应的机制是 ASID。
四、观测
cat /proc/<pid>/maps       # 逐段列 VMA:地址范围/权限(rwxp)/后备文件——mm_struct 的 VMA 集合
cat /proc/<pid>/smaps      # 每段更细:RSS/PSS/脏页/是否 THP/匿名页 vs 文件页
cat /proc/<pid>/statm      # 页数统计(总/RSS/共享/代码/数据)——来自 rss_stat
cat /proc/<pid>/status | grep -E 'Vm|Rss'   # VmSize/VmRSS/VmData/VmStk... 人类可读
cat /proc/<pid>/numa_maps # NUMA 维度的内存分布maps的每一行就是一个 VMA;权限第 4 位p(private)/s(shared)对应映射类型(见 mmap)。smaps能看到每个 VMA 的 RSS/PSS/Swap/THP,是排查内存占用最实用的工具。PSS把共享页按引用进程数等分,比RSS更真实。- 地址落在哪段、怎么看地址判类型见 memory-layout。
进阶观测——pmap 与 perf trace:
pmap -x <pid>              # 进程内存全景:各段地址/大小/RSS/Dirty,比 maps 更直观
pmap -XX <pid>             # 比 smaps 更精简的汇总
# 缺页观测——看谁在触发缺页(CoW 分裂、按需加载)
perf stat -e page-faults,minor-faults,major-faults -p <pid> sleep 10
# 查看某个地址落在哪个 VMA 里
cat /proc/<pid>/maps | grep -w <hex_addr>
五、和其他文档的关系
- 父篇:task-struct(mm 是 task 的资源对象之一)。
- 映射玩法:mmap(VMA 怎么建、四象限映射分类、惰性缺页触发机制)。
- 段布局:memory-layout(各段地址范围、32/64 位布局差异、看地址秒判类型)。
- 页表翻译:tlb(TLB 结构与命中机制)、page-table-translation(完整的 VA→PA 四级页表转换流程)。
- 创建时:process-creation(fork 复制 mm + CoW 机制)、thread-creation(线程共享 mm 的 clone 标志)。
- 进程间共享:fork-and-threads(多线程程序 fork 的坑——锁状态残留、async-signal-safe 约束)。
- 内存统计:free(系统级 RSS/VIRT 统计解读)。
六、一句话总结
mm_struct是进程地址空间的软件总账本:攒着一组 VMA(逐段描述内存,从链表演进到红黑树再到 RCU 无锁 maple tree)、一个页表根 pgd(硬件翻译入口,进程切换时写入 CR3)、各段边界和两个引用计数(mm_users数用它的线程,mm_count数所有引用含内核 lazy 借用)。同进程线程共享一个 mm(地址互通),fork 复制新 mm(VMA 全量拷贝 + 物理页 CoW),内核线程无 mm(借页表),execve 完全换新 mm,exit 逐步拆解(先 VMA 后 pgd 最后结构体)。透过/proc/<pid>/maps/smaps/numa_maps/pmap就能看到它的 VMA 与内存统计的全貌。