内存带宽实测:STREAM 四内核在单核与同核 SMT 双线程下能跑多快
CPU 主频、核心数、缓存容量都写在规格书里,唯独「一个核持续从内存搬数据能跑多快」要靠实测。这个数字决定了大批量扫描、科学计算、列式分析这类受内存约束的程序的天花板——算法再优,每轮循环的数据也得先穿过缓存层级进到寄存器。本篇用经典的 STREAM 基准做一次内存带宽实测:在一台 2 vCPU 的云主机上跑 Copy、Scale、Add、Triad 四个内核,先量单核能打满多少带宽,再看第二个线程(本机是同一物理核的 SMT 兄弟线程,不是第二个核)能挤出多少增量。缓存层级的基础概念可先回顾缓存组织与访问路径,工作集与缓存容量的关系见工作集足迹与缓存命中。
本文要回答的问题
- STREAM 的四个内核各自做什么运算,为什么报告的 GB/s 不能直接等同于物理总线带宽?
- 工作集为什么要做到四倍大于末级缓存,做大了和做小了分别会测出什么?
- 这台机器上一个核能打满多少带宽,Copy 为什么明显快过另外三个内核?
- 两个 vCPU 同时跑,带宽为什么只涨了 7% 到 14%,perf 计数器怎样解释这个现象?
- 云主机上测出的数字,能不能和 STREAM 官方榜单上的裸机结果横比?
先用一张数据卡把本次实测的四个关键数字固定下来,后面的章节逐项交代它们怎么来、该怎么读。
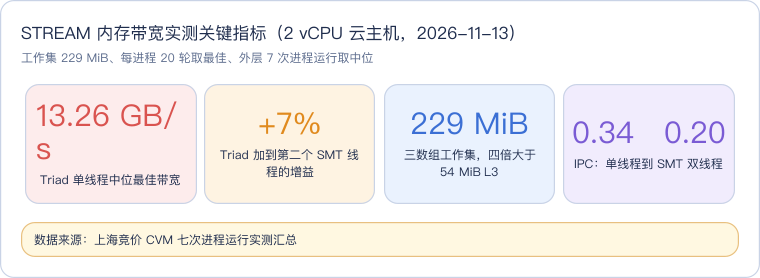
读这张卡先建立量级感:单核 Triad 13.26 GB/s 是后面所有讨论的基准线;SMT 双线程的个位数增益与 IPC 的明显下滑互为表里;229 MiB 工作集则保证测的是 DRAM 而不是缓存。
一、STREAM 是什么:四个内核与两套字节口径
STREAM 是 John McCalpin 提出的可持续内存带宽基准,主体只有四个极简循环,每个循环对三个长度相同的 double 数组做一种运算,简单到编译器和硬件没有任何取巧空间,压力全部落在缓存层级与内存控制器上。四个内核的标准形式如下:
copy:   c[j] = a[j];                              /* 1 读 1 写 */
scale:  b[j] = scalar * c[j];                     /* 1 读 1 写,带一次乘法 */
add:    c[j] = a[j] + b[j];                       /* 2 读 1 写,带一次加法 */
triad:  a[j] = b[j] + scalar * c[j];              /* 2 读 1 写,乘加各一次 */
带宽不是直接量出来的,而是用「搬运字节数除以耗时」算出来的,字节口径必须先讲清。每个 double 占 8 字节,Copy 和 Scale 每元素读一个数组、写一个数组,合计 16 字节;Add 和 Triad 每元素读两个数组、写一个数组,合计 24 字节。一次 Triad 扫过 1000 万元素,公式口径的搬运量就是 1000 万 × 24 = 2.4 亿字节,除以这一轮的耗时得到报告带宽。
| 内核 | 运算 | 每元素读 | 每元素写 | 公式字节数 |
|---|---|---|---|---|
| Copy | c = a | 8 B | 8 B | 16 B |
| Scale | b = k·c | 8 B | 8 B | 16 B |
| Add | c = a + b | 16 B | 8 B | 24 B |
| Triad | a = b + k·c | 16 B | 8 B | 24 B |
这套口径是 STREAM 的统一记账方式,价值在于不同机器、不同内核之间可以横向比较;但它不等于 DRAM 总线上的真实流量,第五节会展开这个差异。
二、内存层级与工作集落位:为什么必须四倍大于 L3
一次内存访问从寄存器出发,要依次穿过 L1d、L2、L3 三层缓存,未命中才下到 DRAM。越靠近核心的层越快、容量越小。本次机器的层级容量与工作集落位如下图。
读这张图抓住容量对比:三个数组合计 228.9 MiB,是 54 MiB L3 的四倍还多,任何一层缓存都装不下,数组元素被带进缓存后很快被后续元素挤出,下一轮扫描重新从 DRAM 取。这正是基准想要的状态——测的是可持续的 DRAM 带宽,而不是缓存复用制造的虚高数字。STREAM 官方建议工作集至少为末级缓存的四倍,留足余量防止部分数组驻留缓存干扰结果。反过来,如果把 N 调到几十万元素、工作集落进 L2,测出来的「带宽」会高数倍,但那只是缓存带宽,对评估内存子系统没有意义。
三、测试设计:数组规模、轮次与两层统计口径
工程用 OpenMP 并行,编译参数固定为 -O3 -std=c11 -fopenmp -march=native -DSTREAM_N=10000000 -DNTIMES=20。-march=native 让编译器按本机 Ice Lake 的指令集做向量化,STREAM_N 把数组长度钉在 1000 万元素,NTIMES 定 20 轮。
统计分两层,区分清楚才不会误读数字。进程内的 20 轮里,第 1 轮作为预热丢弃——这一轮还要承担首次缺页和缓存冷启动,耗时明显偏高;剩下 19 轮记录每轮带宽与耗时,报告每个内核的最佳值与中位值。外层再把整个进程独立运行 7 次,对 7 个「进程内最佳值」取中位,作为最终汇总数。最佳值代表这台机器在该负载下能稳定触及的上限,中位值代表常态水平;云主机存在邻居噪声,两层取数比单次跑分稳健得多。
并行度通过 OMP_NUM_THREADS 环境变量切换 1 和 2 两档。需要强调本机的拓扑:lscpu 显示 1 socket、1 core、2 thread,两个 vCPU 是同一个物理核上的 SMT 兄弟线程,共享 L1d/L2/L3 与核心的执行端口。因此这里的 1 到 2 是「同核加线程」,不是「单核对双核」,两者的扩展预期完全不同。
四、单线程带宽实测:单核 Triad 13.26 GB/s
单线程档七次运行的中位最佳带宽如下图,蓝柱是一个线程的结果,橙柱是同核 SMT 双线程,柱顶标注双线程相对单线程的增益。
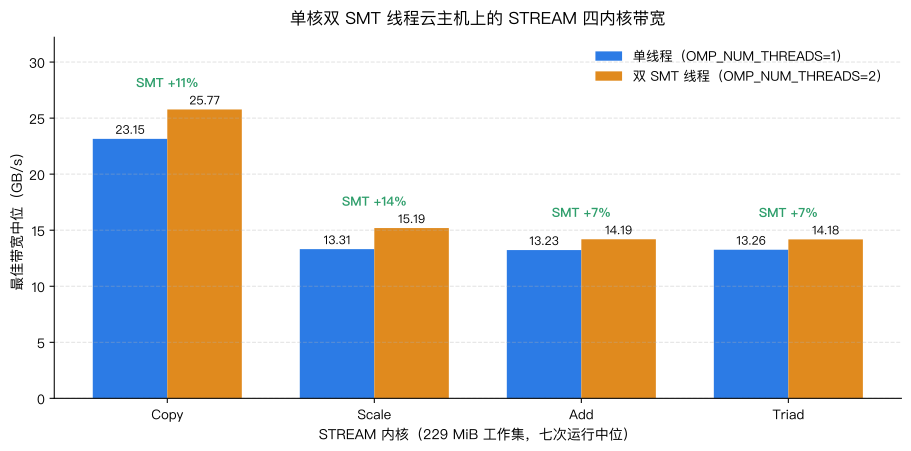
单线程档四个内核分成两组:Copy 23.15 GB/s 独自一档,Scale 13.31、Add 13.23、Triad 13.26 GB/s 挤在 13 GB/s 出头的窄带里。三个运算内核带宽高度接近,说明对这种流式负载,多一次乘法或加法并不改变吞吐量级——瓶颈在内存侧,不在运算侧。完整的两线程数据如下表。
| 内核 | 1 线程 (GB/s) | 2 线程 (GB/s) | SMT 增益 |
|---|---|---|---|
| Copy | 23.15 | 25.77 | +11% |
| Scale | 13.31 | 15.19 | +14% |
| Add | 13.23 | 14.19 | +7% |
| Triad | 13.26 | 14.18 | +7% |
七次运行的单线程汇总段原样如下,每个数字都能在完整日志里逐次核对。
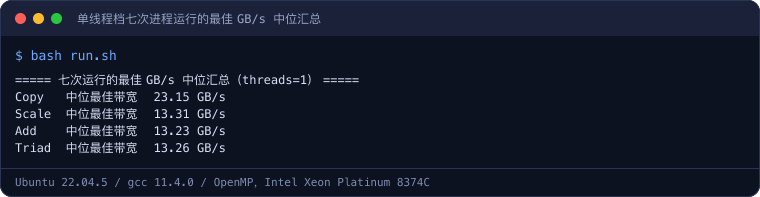
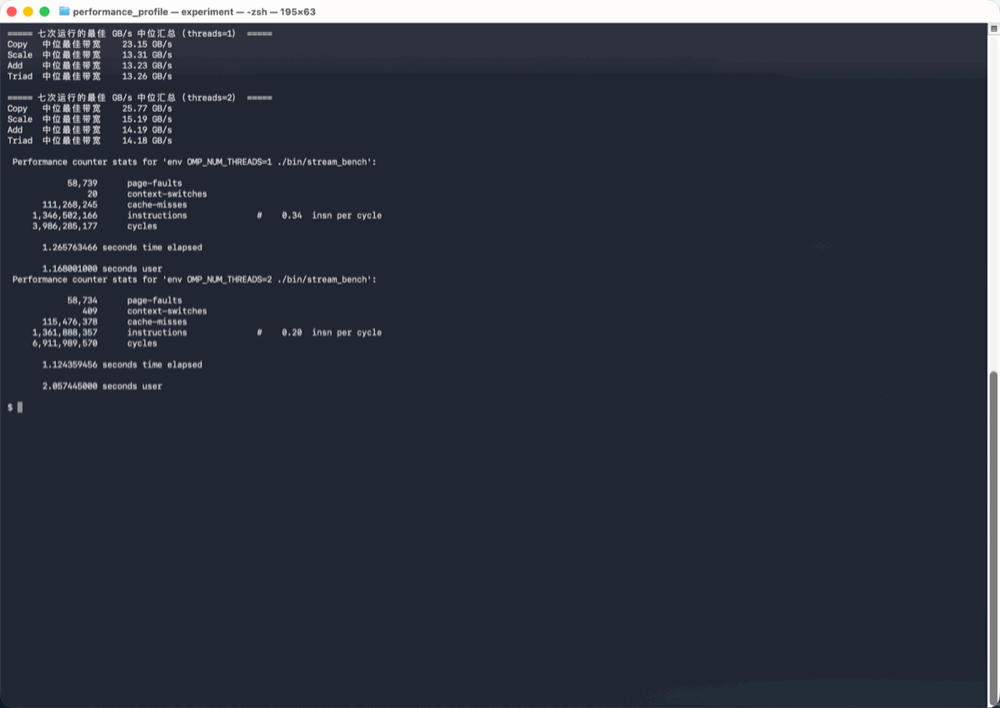
上图上半部分并列两组中位汇总:单线程四个内核 23.15、13.31、13.23、13.26 GB/s,双线程整体抬到 25.77、15.19、14.19、14.18 GB/s,但抬升幅度全在两位数百分比以内;下半部分是两档 perf stat 的计数器输出,第六节逐条解读。
耗时维度的对照同样成立。以日志里两档各自第一次进程运行为例,单线程 Triad 扫完 1000 万元素的最佳耗时是 18.454 毫秒,双线程为 16.670 毫秒,只快约 1.8 毫秒;Copy 则从 7.013 毫升降到 6.276 毫秒。七次运行之间零点几毫秒级的波动很常见,这也是为什么要用七次运行的中位而不是一次跑分下结论。
五、Copy 为什么快一截:端口压力、写分配与反汇编物证
Copy 的公式字节数只有另外三个运算内核的三分之二,但带宽高出约 75%,这个差距需要从微架构层面解释,而不能想当然。
先看指令层面的事实。对编译产物反汇编可见,四个内核都被 gcc 自动向量化为 AVX 指令,使用 ymm 寄存器(256 位,一次处理四个 double),加载用 vmovupd、乘法用 vmulpd、加法用 vaddpd;全程没有出现 movnt 系列非临时存储指令,也没有 rep movsb。这条事实排除了一个流行的想当然解释:Copy 快并不是因为它走了绕过缓存的非临时存储。非临时存储的适用场景与代价在非临时存储与缓存旁路里有完整讨论,本工程的普通存储指令全部走缓存层级。
真正的差别在加载/存储端口的压力配比。核心每周期能发射的加载和存储指令数量有固定上限。Copy 每处理一个向量是一次加载配一次存储,1:1 正好打满存储端口;Triad 是两次加载、一次乘法、一次加法再配一次存储,加载端口压力翻倍,运算指令还要占用发射槽位,单位时间内能推进的元素数自然下降。Scale 虽然也是 1 读 1 写,但乘法指令挤占了发射带宽,所以落在 Add/Triad 一组而不是 Copy 一组。
第二个差别藏在写分配(write-allocate,也叫 RFO,Read For Ownership)机制里。普通存储指令写入一段不在缓存里的数据时,硬件不能只写,得先把对应的缓存行从 DRAM 整行读进缓存、拿到该行的独占权,再在缓存里修改。也就是说,公式口径里每元素 8 字节的写,在总线上可能额外产生一次读流量。三个数组合计 228.9 MiB 的公式搬运量,对应的真实 DRAM 流量更高。STREAM 报告的 GB/s 因此是统一公式口径下的相对带宽,用来横比机器和内核很合适,但不要把它当成内存控制器的物理总线带宽。
六、SMT 双线程为什么只涨 7%:perf 计数器对账
双线程档的增益最大只有 Scale 的 14%,Add 和 Triad 仅 7%。对「加线程提吞吐」的直觉来说这个数字很低,原因要回到拓扑:两个线程本来就住在同一个核里。perf stat 在两档各采一次(系统 kernel.perf_event_paranoid=4,普通用户无权读硬件计数器,须用 sudo),事件计数如下。
| 事件 | 1 线程 | 2 线程 | 变化 |
|---|---|---|---|
| page-faults | 58,739 | 58,734 | 持平 |
| context-switches | 20 | 409 | 调度开销上升 |
| cache-misses | 111,268,245 | 115,476,378 | +3.8%,近乎持平 |
| instructions | 1,346,502,166 | 1,361,888,357 | 指令总量基本相同 |
| cycles | 3,986,285,177 | 6,911,989,570 | +73% |
| IPC | 0.34 | 0.20 | 下降 41% |
| time elapsed | 1.2658 s | 1.1244 s | 墙钟仅快 11% |
perf 的原始输出摘录如下,计数器与上表一一对应。
 Performance counter stats for 'env OMP_NUM_THREADS=1 ./bin/stream_bench':
            58,739      page-faults
                20      context-switches
       111,268,245      cache-misses
     1,346,502,166      instructions              #    0.34  insn per cycle
     3,986,285,177      cycles
       1.265763466 seconds time elapsed

 Performance counter stats for 'env OMP_NUM_THREADS=2 ./bin/stream_bench':
            58,734      page-faults
               409      context-switches
       115,476,378      cache-misses
     1,361,888,357      instructions              #    0.20  insn per cycle
     6,911,989,570      cycles
       1.124359456 seconds time elapsed
这组数字讲了一个完整的故事。两档的 cache-misses 都是 1.1 亿量级、几乎相等,说明双线程并没有打开新的内存通路——SMT 兄弟线程共享同一套缓存和同一条到内存控制器的路径,缺页数量持平也印证了工作量没有本质变化。指令总量同样基本相同,因为两个线程合起来处理的还是同样长度的三个数组。
变化集中在 cycles 和 IPC 上:cycles 从 39.9 亿涨到 69.1 亿,IPC 从 0.34 跌到 0.20。两个线程争抢同一个核的加载/存储端口、缓存行填充槽位与排队资源,每条指令平均要等更多周期才能退休。墙钟时间只快了 11%,而两档合计的 user 时间从 1.17 秒涨到 2.06 秒——多花的 CPU 时间大半消耗在等待里。这就是内存受限负载在 SMT 下的典型形态:SMT 擅长用一个线程的等待槽位填另一个线程的运算,对分支密集、延迟隐藏型负载常有明显收益;但当两个线程同时被同一个内存瓶颈卡住时,没有空闲资源可互相填充,只剩个位数增益。多物理核才各自拥有独立缓存和内存通路,那是另一条扩展曲线,本机 1 核的拓扑测不到。
七、云端数字的边界:虚拟化配额与横比纪律
本次机器是腾讯云上海的竞价型云主机(S6.MEDIUM8,2 vCPU/8 GiB),上面的数字必须放在虚拟化语境里读。云主机拿到的不是整台物理机,而是 Hypervisor 切出的 vCPU 配额与内存带宽配额:同一台宿主机上的多个租户共享内存控制器和互连总线,邻居的负载会挤占可用带宽,竞价实例还可能在资源紧张时被回收。七次运行取中位、两层统计的编排,目的就是压住这类波动,但压不平配额本身。
因此两条纪律要守住。其一,13.26 GB/s 的 Triad 是「这台实例、这个时段、这个配额下」的可持续带宽,不能与 STREAM 官方榜单上裸机的每核带宽直接横比——榜单数字来自对整台物理机内存子系统的独占测量,语境不同。其二,换一个实例规格、换一个可用区甚至换一个时段重跑,数字都可能漂移,容量评估应以自己业务规格上的反复实测为准,而不是引用别人的跑分。同属虚拟化环境的缓存效应还可参考虚拟化环境下的缓存行为。
实验环境
- 机器/系统:腾讯云上海竞价 CVM,型号 S6.MEDIUM8(2 vCPU/8 GiB),Ubuntu 22.04.5 LTS,内核 5.15.0-190-generic;CPU 为 Intel Xeon Platinum 8374C(Ice Lake)@2.70GHz,lscpu 显示 1 socket / 1 core / 2 thread,L1d 48 KiB、L2 1.3 MiB、L3 54 MiB、单 NUMA node
- 工具版本:gcc 11.4.0,编译参数
-O3 -std=c11 -fopenmp -march=native -DSTREAM_N=10000000 -DNTIMES=20;perf 受kernel.perf_event_paranoid=4限制,硬件计数器通过 sudo perf stat 采集 - 日期:2026-11-13
- 完整命令:
make编译生成bin/stream_bench→bash run.sh依次执行OMP_NUM_THREADS=1与=2各 7 次进程运行(每次 20 轮、首轮预热),输出逐次结果与中位汇总 →sudo perf stat env OMP_NUM_THREADS=1 ./bin/stream_bench与双线程同形态各采一次计数器 → 反汇编核对向量化指令与非临时存储使用情况;20 轮结果校验最大误差 0.000e+00
代码获取
完整可复现工程(STREAM 四内核 C 实现、OpenMP 扫档、20 轮加七次进程的两层统计、perf 采集脚本与结果记录)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/linux-memory-bandwidth-stream-bench
- 复现方式:克隆后进入该目录执行
make && bash run.sh,约三分钟输出两线程档各七次运行的中位汇总;perf 段在有权限的环境下用 sudo 重跑,其他实例规格与 CPU 架构上的数字需重新实测,不得直接引用本篇结果。
这一篇在知识体系里的位置
本篇是 Linux 性能实测系列的内存带宽专题,向上承接缓存原理:缓存层级与访问路径见缓存组织与访问路径,工作集与缓存容量的匹配关系见工作集足迹与缓存命中,第五节引用的非临时存储机制见非临时存储与缓存旁路,perf 硬件计数器的完整读法见用性能计数器度量缓存。方法论上,本篇与磁盘侧的 fio 磁盘 IO 压测同属「工作集绕过缓存、多层取数压波动」的基准设计;低延时工程中如何与带宽天花板共处,可回看低延时设计模式全景。
总结
内存带宽实测的核心是让工作集彻底跌出缓存、再用统一字节口径算可持续吞吐:本篇以各 76.3 MiB、合计 228.9 MiB 的三个 double 数组(四倍大于 54 MiB L3)跑 STREAM 四内核,单线程下 Copy 23.15 GB/s,Scale、Add、Triad 稳定在 13.2 到 13.3 GB/s,单核 Triad 带宽 13.26 GB/s。Copy 领先并非靠非临时存储——反汇编证实四个内核都是普通 AVX 加载存储、无 movnt——而是加载存储端口配比不同,加上写分配让真实 DRAM 流量高于公式口径,所以报告值是统一口径下的相对带宽而非物理总线带宽。加上第二个同核 SMT 线程后,cache-misses 近乎持平、cycles 反涨 73%、IPC 从 0.34 跌到 0.20,Triad 仅增益 7%,证明内存受限负载在共享执行资源与内存通路的 SMT 下拿不到线性扩展,多物理核才是另一条曲线。最后,云主机测的是虚拟化配额下的带宽,既不能与裸机榜单横比,也需要在自己的实例规格上反复实测取中位,才能作为容量规划的依据。