page fault 开销实测:minor 与 major 缺页单次成本差多少,prefault 能省掉什么
mmap 只是在进程地址空间里登记一段区间,并不立刻分配物理内存;真正的物理页要等线程第一次触碰地址时,由缺页异常(page fault)陷进内核补上。这层惰性分配省了内存,却把一笔不确定的开销挂到了首次访问上:低延时服务的尾延时毛刺、大批量初始化阶段的内核态占比,很多都能追到缺页上。本篇用一个 200 MiB 工作集的微基准,把匿名页与文件页、冷触碰与预热后触碰五种配置放到同一台机器上实测,给出 page fault 开销的单次成本量级。页表映射的硬件背景可先回顾页表遍历与多级地址翻译,进程地址空间的建立过程见进程地址空间与分段管理。
本文要回答的问题
- minor fault 和 major fault 在内核里走的路径差在哪,为什么一个是微秒级、一个是百微秒级?
- 同样是匿名页首次写,
MADV_DONTNEED归还后再触碰,成本和第一次有区别吗? - prefault 预热把缺页提前付掉之后,计时段里每页还剩多少成本,能省掉多大比例?
- 文件页热缓存和冷读盘两种情况下,为什么「每次缺页」和「每页」两个口径的数字会拉开十几倍?
- 云主机上
drop_caches之后第一轮仍然偏快,这个测量边界该怎么理解?
先把本次实测的四个关键数字固定下来,后面逐项交代它们怎么来、该怎么读。
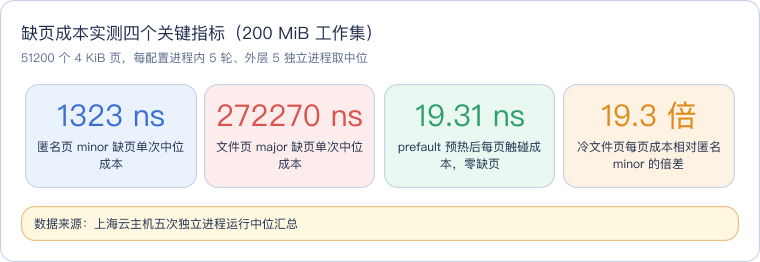
读这张卡先建立量级感:minor 缺页是千纳秒级,major 缺页是几十万纳秒级,两者相差两个数量级;而预热后纯触碰的成本只有十几纳秒,说明缺页路径本身就是首次访问慢的全部原因。
一、缺页异常的两条路径:minor 就地补页,major 等盘
线程访问一个虚拟地址时,MMU 按多级页表遍历找页表项(PTE)。如果 PTE 有效,访问直接走完缓存层级;如果 PTE 不存在或权限不符,硬件触发缺页异常,线程陷入内核,由内核的缺页处理函数决定怎么补。分叉点只有一个:补这一页需不需要磁盘 I/O。
读这张图抓住两条路径的本质差别。绿色的 minor 路径全程不碰磁盘:匿名页第一次写时,内核从伙伴系统拿一个物理页、清零、填好 PTE 即可;文件映射的页如果已经在页缓存里,内核只需把缓存页挂到进程页表上,同样是 minor。红色的 major 路径则要向块设备提交读请求,线程主动挂起睡眠,等中断通知数据落进页缓存后才被唤醒,耗时绑定存储设备的延迟。本篇的实测数字正是这两条路径差异的量化。
二、五配置实验设计:把「页从哪来」和「是否已映射」分开
基准程序对 200 MiB、共 51200 个 4 KiB 页的工作集做单线程顺序触碰,用单调时钟计时,并通过 perf stat -e page-faults,major-faults,minor-faults 对账事件计数。五个配置只改变两件事:页的来源(匿名页或文件页),以及触碰时页表是否已经映射。变量对照如下。
| 配置 | 页来源 | 触碰前状态 | 预期缺页类型 |
|---|---|---|---|
| anon_cold | 匿名页(mmap MAP_PRIVATE) | 新映射,从未触碰 | 全 minor,零 major |
| anon_refault | 匿名页 | MADV_DONTNEED 归还后再触碰 | 重新 minor |
| anon_prefault | 匿名页 | 计时段外已预热触碰一遍 | 零缺页 |
| file_warm | 文件映射(只读) | 页缓存热,新建映射 | 仅 minor 建页表 |
| file_cold | 文件映射(只读) | drop_caches 后冷读 | minor 加 major |
统计分两层:每个进程内跑 5 轮,外层把整个进程独立运行 5 次,对五个配置分别取五次进程结果的中位,避免单次调度抖动和云主机邻居噪声影响结论。触碰循环本身在所有配置里完全一样,保证差异只来自缺页路径而不是访问模式。
三、中位数据:四个量级的成本与两个记账口径
五次进程运行的中位汇总如下图,左面板按「每页成本」排列五个配置并取对数轴,右面板按「每次缺页成本」排列四个有缺页的配置,prefault 因零缺页在右图只作文字标注。
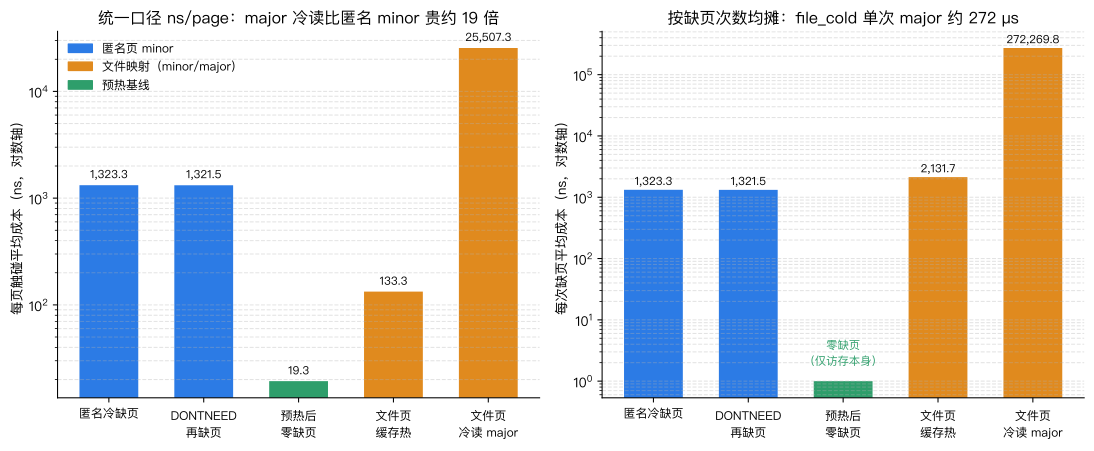
左面板上五个配置自然分成四档:anon_prefault 只有 19.31 ns/页,贴着普通内存访问的量级;anon_cold 与 anon_refault 几乎重合在 1320 ns/页上下;file_warm 摊到每页 133.27 ns;file_cold 以 25507 ns/页 远远甩开所有配置。右面板换「每次缺页」口径后,file_cold 的单次成本达 272270 ns,是匿名 minor 的约 205 倍。两个口径必须同时看,第五节会解释它们为什么在文件页上差出十几倍。完整中位行如下。
| 配置 | ns/次缺页(中位) | ns/页(中位) | 含义 |
|---|---|---|---|
| anon_cold | 1323.30 | 1323.30 | 匿名页首次写,一页一次 minor |
| anon_refault | 1321.46 | 1321.46 | 归还后重新分配零页,成本与首次持平 |
| anon_prefault | 0.00(无缺页,指标无定义) | 19.31 | 计时段零缺页,只剩纯触碰成本 |
| file_warm | 2131.67 | 133.27 | 热缓存建页表,一次 minor 覆盖多页 |
| file_cold | 272269.80 | 25507.34 | 冷读盘,major 主导 |
日志里的五次进程中位汇总原样如下,表中每个数字都能逐行核对。
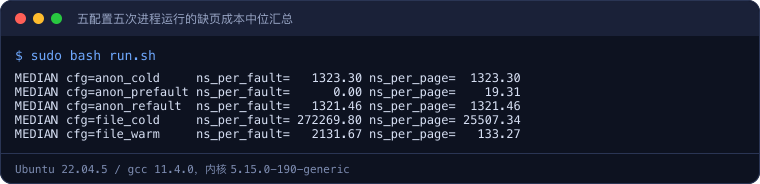
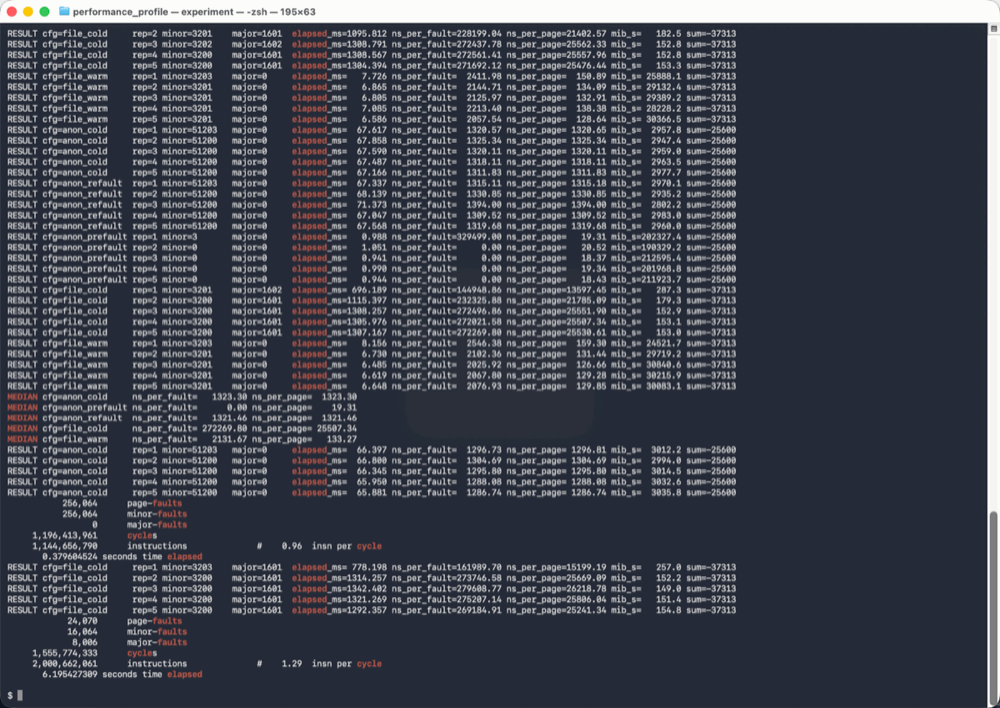
上图中段五行 MEDIAN 与上表一一对应;上半部分每个配置还留着五轮逐次 RESULT,可以看到匿名页各轮稳定在 67 毫秒上下,而 file_cold 各轮在 0.7 到 1.34 秒之间明显跳动,这个跳动第六节专门解释。
三组对照先读出三个结论。第一,anon_cold 与 anon_refault 的中位分别是 1323.30 和 1321.46 ns,差别落在噪声范围内——MADV_DONTNEED 归还物理页后,再触碰等于重新走一遍匿名页 minor 分配,内核不会因为这块页「以前属于本进程」就打折。第二,prefault 预热后计时段每页 19.31 ns,相对冷缺页的 1323.30 ns 省掉约 98.5%,51200 页整段触碰从约 67 毫秒压到约 1 毫秒。第三,file_cold 每页 25507.34 ns,是匿名 minor 每页成本的 19.3 倍,差距全部来自读盘等待。
四、perf 事件对账:minor 烧内核 CPU,major 烧墙钟时间
缺页处理发生在内核态,事件计数和 CPU 时间分布能验证计时结果。对两个代表配置各采一次 perf,匿名冷触碰段的原始输出如下。
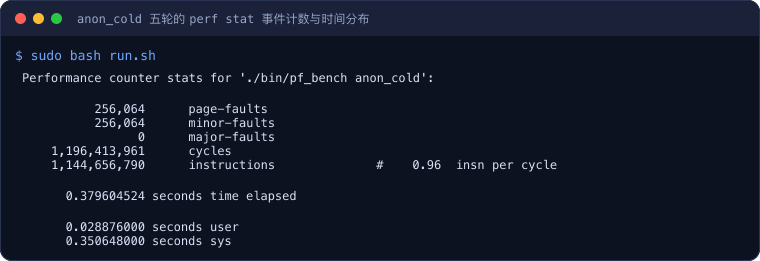
这一段里 page-faults 为 256064,与 minor-faults 完全相等、major-faults 为 0,对账无误(51200 页乘 5 轮再加进程启动期零星几页)。墙钟 elapsed 0.3796 秒中 sys 占了 0.3506 秒、user 只有 0.0289 秒,约 92% 的时间花在内核态——minor 缺页不睡眠,它的成本就是内核实打实烧掉的 CPU:分配页框、清零、补页表、刷 TLB,IPC 0.96 也符合内核路径分支多、缓存 locality 差的特征。
冷文件页段的输出形态完全不同。
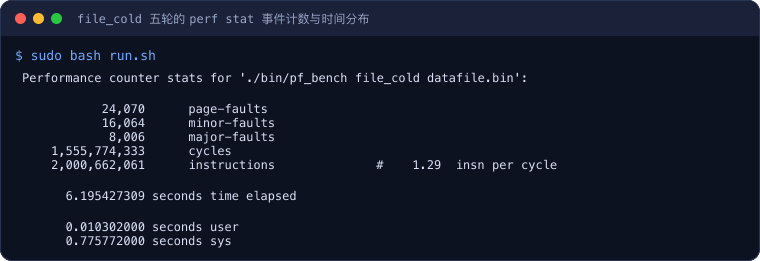
这里 page-faults 只有 24070(minor 16064 加 major 8006),墙钟却长达 6.1954 秒,而 sys 仅 0.7758 秒、user 0.0103 秒,两者相加不到墙钟的 13%。余下的时间线程不在任何 CPU 运行队列上,而是睡在块 I/O 等待里——major 缺页的成本主要不是 CPU,而是等待存储的墙钟时间。同时 instructions 高达 20.0 亿、IPC 1.29,比匿名段的 11.4 亿指令还多,说明文件系统与块设备层的 I/O 栈本身也是一条很深的内核指令路径。perf 各事件的完整读法可参考perf 全面使用指南。
五、readahead 与 fault-around:为什么文件页要同时报两个口径
匿名页一次 minor 只处理一个页,所以 anon_cold 的 ns/fault 与 ns/page 都是 1323.30。文件页不是这样。内核处理文件映射缺页时启用 fault-around(围绕缺页点的 readahead 预读簇):一次异常顺手把相邻的十几个页一起读入并建好映射,后续触碰这些页时不再缺页。file_cold 单轮的逐轮数据把这件事展示得很清楚。
RESULT cfg=file_cold     rep=1 minor=3203    major=1601  elapsed_ms= 778.198 ns_per_fault=161989.70 ns_per_page=15199.19 mib_s=   257.0 sum=-37313
RESULT cfg=file_cold     rep=2 minor=3200    major=1601  elapsed_ms=1314.257 ns_per_fault=273746.58 ns_per_page=25669.09 mib_s=   152.2 sum=-37313
RESULT cfg=file_cold     rep=3 minor=3200    major=1601  elapsed_ms=1342.402 ns_per_fault=279608.77 ns_per_page=26218.78 mib_s=   149.0 sum=-37313
RESULT cfg=file_cold     rep=4 minor=3200    major=1601  elapsed_ms=1321.269 ns_per_fault=275207.14 ns_per_page=25806.04 mib_s=   151.4 sum=-37313
RESULT cfg=file_cold     rep=5 minor=3200    major=1601  elapsed_ms=1292.357 ns_per_fault=269184.91 ns_per_page=25241.34 mib_s=   153.5 sum=-37313
每轮只有约 1601 次 major、3200 次 minor,合计约 4800 次缺页,却覆盖了 51200 个页的触碰——平均一次 major 按 16 页的簇读入,major 计数因此远小于页数。这就是两个口径并存的原因:ns/fault 衡量一次异常处理的代价(file_cold 中位 272270 ns,含整簇 I/O 的等待),ns/page 把这笔代价摊到簇内全部页上(25507 ns),后者才对应应用视角「顺序扫描每读一页的平均缺页摊销」。file_warm 同理:约 3201 次 minor 建完全部页表,单次 2131.67 ns,摊到每页仅 133.27 ns,甚至低于匿名页的 1323 ns/页——不是热文件页缺页更便宜,而是一次缺页干了十六页的活。
六、首轮偏快与测量边界:虚拟化存储的缓存分层
上表 file_cold 第一轮 778 毫秒、161990 ns/页,明显快于第二到五轮的约 1292 到 1342 毫秒、269184 到 279609 ns/页。基准每轮前都在虚拟机内执行 drop_caches 清空 guest 页缓存,但虚拟机看不到下层:云硬盘是虚拟化块存储,宿主机侧的存储缓存、分布式存储后端的缓存仍然残留着上一轮读过的数据,第一轮的读请求在宿主缓存层就命中了,没有真正落到物理介质。从第二轮开始宿主缓存也被绕过或淘汰,数字才进入稳态。因此取中位、而不是取首轮或最佳值,是这组数据可信的前提;解读 file_cold 时也应以 rep2 到 rep5 的稳态区间为准。
这条边界决定了本篇数字的适用范围。272270 ns 的 major 成本绑定的是该机当时的虚拟化块存储,不能与裸机本地 NVMe 的延迟横比——本地 NVMe 单页读可能低一个数量级,而普通云盘、机械盘后端可能更高。此外,基准是单线程顺序触碰,没有制造多线程并发缺页对伙伴系统锁和块层队列的冲击;页大小固定为 4 KiB 基础页,未涉及透明大页(THP)把 512 个小页合并成一次缺页的情形。换实例规格、换盘型、换并发模型后,数字都应重新实测。
七、工程含义:prefault、mlock 与 madvise 各自的位置
实测数字落到工程上,对应三个常用手段的取舍。
读这张图先分清三个手段解决的不是同一个问题。prefault 对付的是 minor:低延时服务在进入关键路径前,用一个初始化线程把工作池、环形缓冲、哈希表容量全部写触碰一遍,或者直接用 MAP_POPULATE 建映射,关键路径上就只剩 19.31 ns/页 的纯访问,尾延时不再被偶发缺页拉长。mlock 解决的是 major:常驻内存页被回收后再访问要等盘,锁内存可以杜绝这笔开销,代价是占用不可回收、用超了有 OOM 风险。MADV_DONTNEED 则是反向工具,主动归还确定废弃的大内存,但本篇 1321.46 ns 的 refault 数字就是它的价签——如果判断错误、页面还要用,重新 minor 的代价与首次分配完全相同,因此它只适合生命周期明确的大块临时内存。进程创建期这些页表与映射如何建立,可结合进程创建与写时复制一起看;同系列的内存子系统实测还有STREAM 内存带宽实测。
实验环境
- 机器/系统:上海云主机,1 个物理核、2 个 SMT 线程(Intel Xeon Platinum 8374C @2.70GHz,lscpu 显示 1 socket / 1 core / 2 thread),Ubuntu 22.04.5 LTS,内核 5.15.0-190-generic;云硬盘为虚拟化块存储,major 延迟绑定该存储,不与裸机 NVMe 横比
- 工具版本:gcc (Ubuntu 11.4.0-1ubuntu1~22.04.3) 11.4.0;perf 计数器通过 sudo perf stat 采集,事件为 page-faults、minor-faults、major-faults 加 cycles、instructions
- 工作集:200 MiB,51200 个 4 KiB 基础页,单线程顺序触碰;每配置进程内 5 轮、外层 5 个独立进程取中位
- 日期:2026-11-13
- 完整命令:
make编译生成bin/pf_bench与数据文件 →sudo bash run.sh依次跑五配置各五次进程并输出中位汇总,再对 anon_cold 与 file_cold 各采一段 perf stat;file_cold 每轮前执行 drop_caches
代码获取
完整可复现工程(五配置微基准 C 实现、madvise 与 drop_caches 控制、单调时钟计时、perf 采集脚本与原始结果记录)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/linux-page-fault-minor-major-cost
- 复现方式:克隆后进入该目录执行
make && sudo bash run.sh,约两分钟输出五配置五次进程的中位汇总与两段 perf 计数;drop_caches 与 perf 采集需要 root 权限,其他实例规格、盘型与内核版本上的数字需重新实测,不得直接引用本篇结果。
这一篇在知识体系里的位置
本篇是 Linux 性能实测系列的进程内存专题,向上承接地址翻译原理:多级页表与 PTE 遍历见页表遍历与多级地址翻译,进程地址空间的建立见进程地址空间与分段管理,fork 期间页表如何靠写时复制延迟建页见进程创建与写时复制。观测工具侧,perf 事件与内核态时间占比的完整读法见perf 全面使用指南;方法论上,本篇与 STREAM 内存带宽实测同属「固定工作集、多层取数压波动、云端数字标注边界」的基准设计,一个量缺页成本、一个量缓存之后的可持续带宽,合起来覆盖了内存访问的两类主要开销。
总结
page fault 开销的实测结论可以压成四组数字:匿名页 minor 缺页中位 1323.30 ns 每次,全程不碰磁盘、约 92% 时间烧在内核态 CPU 上;MADV_DONTNEED 归还后再触碰是 1321.46 ns,与首次分配同价;prefault 预热把缺页提前付清后,计时段零缺页、每页只剩 19.31 ns,相对冷缺页省掉约 98.5%;文件页冷读的 major 缺页单次达 272269.80 ns,每页摊销 25507.34 ns、是匿名 minor 的 19.3 倍,这笔开销主要是睡在块 I/O 上的墙钟时间而非 CPU。文件页必须同时看 ns/fault 与 ns/page 两个口径,因为 fault-around 一次 major 按 16 页簇读入,约 4800 次缺页就覆盖了 51200 页。工程上,prefault 把 minor 挪出关键路径、mlock 防止长驻页付出 major、madvise 归还内存但要记得 refault 价签;而云主机 drop_caches 后首轮仍受宿主存储缓存影响、major 数字绑定虚拟化块存储且只测了单线程顺序访问,这些边界决定了任何容量决策都应在自己的实例规格上重新实测。