variant 与虚函数:std::visit 和虚多态的性能与内存取舍实测
编译优化系列的第十二篇。前一篇开寻址哈希表的负载因子实测量的是连续内存与逐节点堆分配在哈希表上的差距,本篇把镜头对准 C++ 里两种最常见的多态写法:继承体系加虚函数的运行期多态,与 std::variant 加 std::visit 的闭合类型集分派。入门篇 std::variant:类型安全的联合体讲过 variant 的语义和三种访问方式,并把它称为继承多态的轻量替代;「轻量」到底体现在哪些数字上、什么情况下反而更重,光读规范得不到体感。本篇用同一组 shape 协议实现三条调用路径,把调用耗时、内存占用和二进制反汇编放在同一张账本里核对。
本文要回答的问题
- 同样一次
area()调用,虚函数、std::visit与手写get_if在 O2 下各花多少纳秒? - 调用对象全是同一种类型(单态)和四种类型轮转(混合)时,差距为什么会变化?
- 关掉优化的 O0 档,三条路径的排名会不会反转,反转说明什么?
- 一万个多态对象,虚函数方案与 variant 方案各自占多少内存、触发多少次堆分配?
- 反汇编层面,三种分派各自编译成了什么指令,工程上应该怎样选?
一、两种多态的机制分野
虚函数多态的核心是一张虚函数表(vtable)。每个含虚函数的类各有一张静态表,对象的开头藏一个指向表的指针(vptr);调用虚函数时,程序先从对象读出 vptr,再按槽位偏移从表里取出函数地址,最后一条间接 call 跳过去。调用目标在编译期是未知的,它取决于对象运行时的真实类型。这套机制的前提是对象拥有独立地址——实践中多态对象几乎都活在堆上,集合里存的是 unique_ptr<Base> 或裸指针。
variant 走的是另一条路。std::variant<Circle, Square, Rectangle, Triangle> 是一个定长值对象:大小取备选类型里最大的那个再加一个类型标记(discriminator),对象直接内嵌在数组槽位里,没有堆分配、没有 vptr。std::visit 把访问器(这里是泛型 lambda)按备选类型逐一实例化,编译期生成一套按 discriminator 索引的分派代码;手写 get_if 链则更直白——逐次比较类型标记,命中就返回指针。入门篇里「variant 是编译期多态」的说法,指的就是备选类型集在编译期闭合、分派表可以由编译器直接生成。
先用一张对比卡把三条路径的结构性差异摆在一起,后面的实验逐格验证。
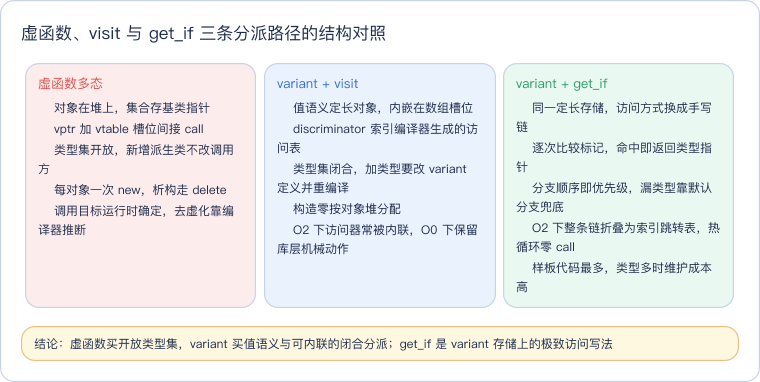
读这张卡抓住一条主线:两者不是简单的新旧替代,而是用不同的东西做交换——虚函数用堆间接和间接调用换类型集的开放性,variant 用定长存储和编译期闭合换 cache 友好与内联机会。
二、基准设计:同一 shape 协议的三条调用路径
要比较的是分派机制本身,业务逻辑必须完全同构。工程定义四个纯值类型 Circle、Square、Rectangle、Triangle,每个都提供 area() 与 perimeter() 两个成员。虚函数方案另写一套平行的 VShape 继承体系,公式与参数逐一对齐;variant 方案直接把四个值类型放进备选列表,不写任何继承。
struct VShape {
    virtual ~VShape() = default;
    virtual double area() const = 0;
    virtual double perimeter() const = 0;
};
using ShapeV = std::variant<Circle, Square, Rectangle, Triangle>;

static double area_visit(const ShapeV& v) {
    return std::visit([](const auto& s) { return s.area(); }, v);
}
static double area_manual(const ShapeV& v) {
    if (auto p = std::get_if<Circle>(&v)) return p->area();
    if (auto p = std::get_if<Square>(&v)) return p->area();
    if (auto p = std::get_if<Rectangle>(&v)) return p->area();
    return std::get<Triangle>(v).area();
}
六个测量单元由三种分派乘以两种场景组成:单态场景的 1024 元素数组全是 Circle,混合场景按 i % 4 轮转四种类型;热循环跑 1000 万次 area + perimeter,元素下标用 i & 1023 轮转,保证数据常驻 cache,量到的是分派而不是访存。每个 runner 标 noinline 固定函数边界,先预热一轮再计时,O2 与 O0 各跑 7 轮取中位。三个实现每轮的累加值作为 checksum 打印,同场景三条路径 checksum 必须完全一致,先证明语义等价再谈快慢。
下图把三条路径的一次调用过程并排画出,蓝色是数据入口、红色是分派判定点、橙色是真正的跳转动作。
读这张图对照两个判定点的性质:虚函数路径的红色节点是「读对象自己的 vptr」,判定结果随对象身份变化;variant 路径的红色节点是「读定长槽里的整数标记」,判定结果只占一个 compare。两条路径最后都落到橙色的间接跳转,但前者的表挂在每个堆对象上,后者的表是编译器为这个具体 variant 特化生成的、所有调用共享一份。
三、调用耗时:O2 下 variant 全线领先,混合场景差距拉大
先看部署构建实际使用的 O2 档,六格中位耗时如下。
| 分派方式 | 单态 O2 (ns/次) | 混合 O2 (ns/次) | 单态 O0 (ns/次) | 混合 O0 (ns/次) |
|---|---|---|---|---|
| virtual 虚函数 | 4.05 | 6.66 | 12.35 | 15.74 |
| visit | 3.69 | 4.79 | 95.98 | 119.59 |
| get_if 手写链 | 1.68 | 1.99 | 49.78 | 92.49 |
O2 下单态场景三者同处一个量级:visit 比虚函数快约 9%,get_if 比虚函数快约 58%。单态意味着每次间接跳转的目标都一样,现代 CPU 的间接分支预测器对这种固定目标预测极准,虚调用的额外成本主要剩一次指针解引用和 vtable 槽位读取,因此三条路径差距没有拉开。
混合场景才是机制差异真正显形的地方。四种对象轮转时,虚调用的目标在四个函数地址间来回跳,分支预测器不断失配,虚函数从 4.05 ns 恶化到 6.66 ns,涨幅约 64%;visit 同样面对四种目标,但它的分派表是按数组槽位里顺序轮转的 discriminator 索引的,访问模式高度规律,预测器很容易跟上,只从 3.69 ns 涨到 4.79 ns;get_if 几乎不受场景影响(1.68 到 1.99 ns),因为它的热循环里根本没有 call 指令,具体证据留到第五节。
下图把 O2、O0 耗时与一万对象的内存构成画成三面板,中间面板改用对数轴,否则 O2 的几根柱子在 O0 柱面前会矮到看不清。
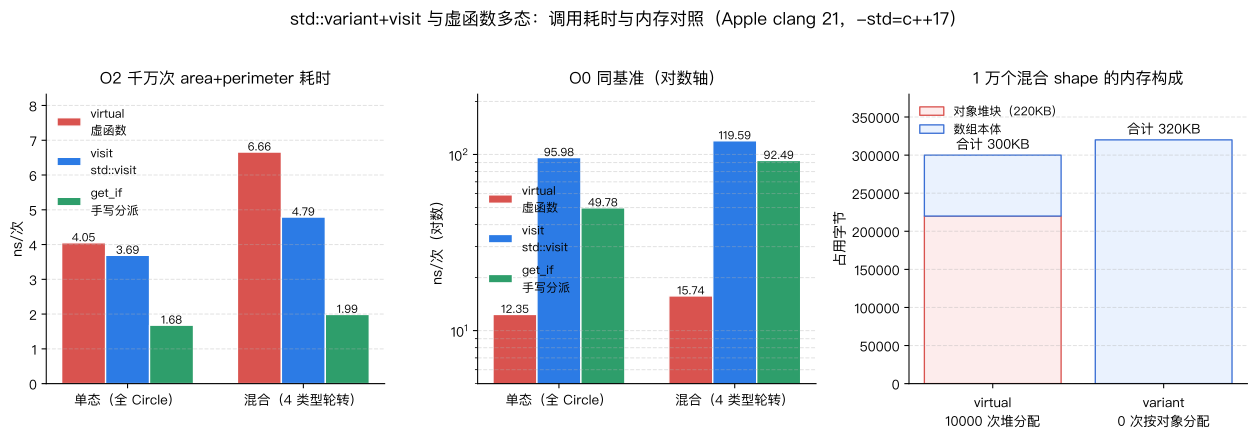
读图先对比左右两个时间面板的量级:O2 下三柱齐平、只差两三倍,O0 下 visit 与 get_if 反而比虚函数慢一个数量级。这不是 variant 的结构性缺陷,而是内联的遮羞布被掀开后的样子——没有优化时,std::visit 要老老实实走完标准库的访问器机械动作,get_if 链要逐次函数调用比较标记,而虚函数本来就只有一次间接 call,没有可被优化掉的层。部署构建普遍开 O2,这个反转不会原样出现在线上,但它提醒一件事:variant 分派的便宜很大程度上是优化器施舍的,评估性能必须用真实发布的优化档位。
完整实测记录如下,sizeof、分配计数、六格七轮中位与二进制证据在同一份记录里。
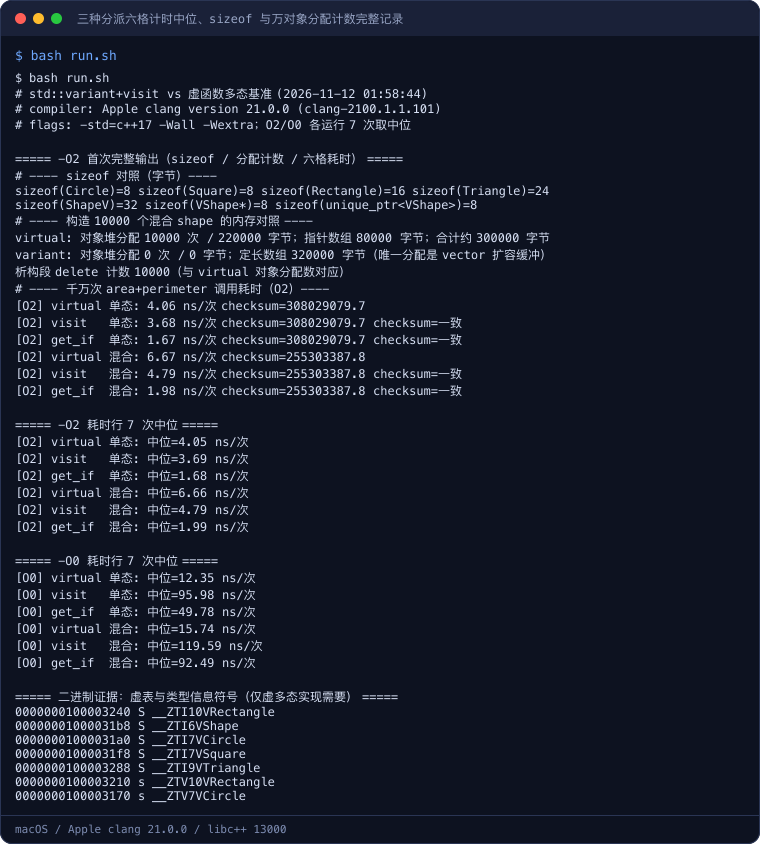
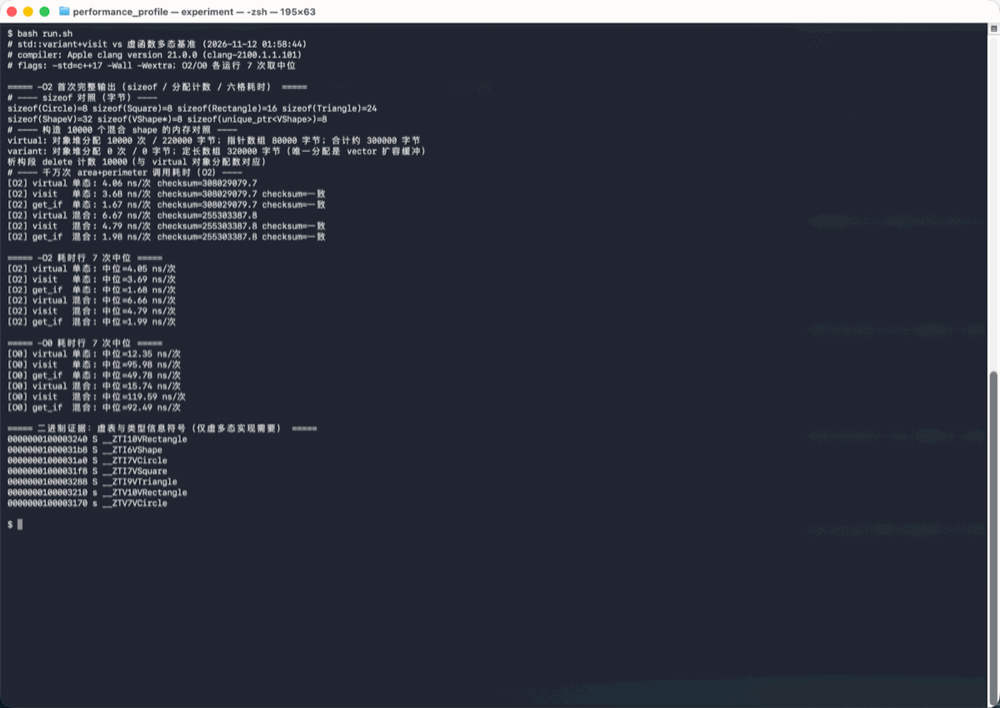
图中六个 checksum 在同场景内完全一致(单态 308029079.7、混合 255303387.8),说明三条路径跑完了同样的计算量,耗时差异可以干净地归因到分派机制本身,而不是公式实现的差别。
四、内存对照:定长数组一次分配,对指针数组加万块堆对象
计时之外,两种多态的存储形态差异更具决定性。先看 sizeof:四个值类型分别是 8、8、16、24 字节(一到三个 double),ShapeV 统一为 32 字节——最大的 Triangle 24 字节,加上 8 字节里容纳的 discriminator 与对齐填充;一个基类指针只有 8 字节。
光看单对象大小会得出「指针更省」的错误结论,把一万个混合对象的完整占用算出来才是全貌。
| 维度 | virtual 方案 | variant 方案 |
|---|---|---|
| 单元素 sizeof | 指针 8 字节(对象另算) | 定长 32 字节 |
| 构造 1 万对象的堆分配次数 | 10000 次 | 0 次(唯一分配是 vector 扩容) |
| 对象堆块申请总量 | 220000 字节 | 0 字节 |
| 集合数组本体 | 80000 字节指针数组 | 320000 字节定长数组 |
| 合计占用 | 约 300000 字节 | 320000 字节 |
| 析构 delete 次数 | 10000 次 | 0 次 |
总量上两者其实接近(300 KB 对 320 KB),variant 甚至略多 7%,因为每个槽位都按最大的 Triangle 对齐,Circle 槽位里有闲置字节。但字节数不是这个故事的重点,分配形态才是。
下图把两种布局画出来:虚函数方案是一段连续指针数组指向一万块分散的堆内存,variant 方案是一次分配出来的连续定长数组。
读图抓住红色与灰色的对比:红色堆块之间没有任何相邻保证,遍历一万个对象意味着一万次指针追踪,对象本身可能散落在堆的各个角落;灰色槽位就在数组内部,顺序遍历就是硬件预取器最喜欢的线性访问。分配次数的差距还会传导到构造速度、销毁速度与分配器锁竞争上——单线程里一万次 new 的代价不起眼,在多线程高频创建对象的服务里,按对象分配是实打实的争用源,这与 std::function 堆分配阈值里量过的小对象优化动机同出一辙。
variant 布局的代价也要认:第一,槽位按最大备选类型定长,类型大小悬殊时浪费明显,入门篇把「各类型大小悬殊」列为不适合 variant 的场景正是此理;第二,320 KB 总量略高于虚函数方案的 300 KB,省的不是字节而是间接。
五、反汇编证据:vtable 间接 call、访问函数表与零 call 跳转表
数据之外,再从机器码层面核对三种分派的预言。用 otool -tvV 展开 O2 二进制里三个混合场景 runner,只看调用与跳转指令,差异一目了然。
## 虚函数 runner(run_virtual_mixed):两条 vtable 槽位间接 call
0000000100000a6e	callq	*0x10(%rax)
0000000100000a7c	callq	*0x18(%rax)

## visit runner(run_visit_mixed):按 discriminant 索引的访问函数表,加无值兜底
0000000100000bd5	callq	*(%rax,%rcx,8)
0000000100000bf7	callq	*(%rcx,%rax,8)
0000000100000c27	callq	__ZNSt3__126__throw_bad_variant_accessEv

## get_if runner(run_manual_mixed):热循环零 call,索引跳转表加内联算术
0000000100000e00	cmpq	$0x3, %rdi
0000000100000e14	jmpq	*%rdi
第一处,虚函数 runner 里 callq *0x10(%rax) 与 callq *0x18(%rax) 对应 area 和 perimeter 两个槽位:rax 指向对象首字的 vtable,固定偏移处取出函数地址调用。编译器无法把它内联,因为同一个指针在不同迭代里可能指向四种不同对象,这正是 虚函数去虚化条件里讨论过的边界——类型信息无法静态确定时,间接 call 必须保留。
第二处,visit runner 的 callq *(%rax,%rcx,8) 是另一类间接调用:基址寄存器指向编译器为这个 variant 与这个访问器生成的函数表,rcx 是从对象偏移 0x18 读出的 discriminator,按 8 字节表项索引调用。它与 vtable 调用形似而神不同——表项集合在编译期就完全确定,且所有 variant 对象共享同一张表;旁边那条 __throw_bad_variant_access 是 discriminator 等于无效值(variant 处于 valueless_by_exception 状态)时的兜底路径,正常执行永远不进。
第三处也是解释 get_if 为什么能跑到 1.99 ns 的关键:它的热循环里没有任何 call 指令。cmpq $0x3 把标记与类型数比较,随后 jmpq *%rdi 跳进一张四目标跳转表,四个分支里的面积公式全部内联为 movsd、mulsd 这类标量运算。手写的 get_if 链在优化器手里被重新整理成了 switch 式跳转表,既没有函数调用开销,也没有库层机械动作。
把三处证据与第三节的数字并置,账本就闭合了:虚函数的成本是保留下来的间接 call 加分散对象的指针追踪;visit 用共享访问表把间接调用的可预测性拉高;get_if 干脆把调用消掉,代价是四条分支的代码体积与手写样板。
六、工程取舍:什么时候用哪一种
把前面的实测收敛成一张决策表,判断标准是类型集的开放性、对象数量与访问模式,而不是个人口味。
| 维度 | 适合虚函数多态 | 适合 variant 分派 |
|---|---|---|
| 类型集特征 | 开放、持续扩展,跨动态库边界加类型 | 闭合、数量稳定(经验上不超过六七种) |
| 对象生命周期 | 身份重要,需要共享、延长生命周期 | 纯值数据,随集合生灭 |
| 集合规模与创建频率 | 少量长生命周期对象 | 海量短生命周期对象,怕分配器争用 |
| 遍历模式 | 随机访问、单态为主时代价可接受 | 顺序遍历、类型轮转,cache 与预测器友好 |
| O2 单次调用 | 混合约 6.66 ns | visit 约 4.79 ns,get_if 约 1.99 ns |
| 扩展性代价 | 新增派生类不动调用方 | 加类型要改 variant 定义,全部 visit 重编译 |
| 典型场景 | 插件体系、依赖注入、GUI 控件 | 解析器 token、状态机事件、协议报文、AST 窄节点 |
实践中还有三条补充纪律。第一,选了 variant 就优先 std::visit 而不是散落各处的 get_if 链:访问器把「所有备选类型都要处理」交给编译器检查,新增类型时漏处理的分支会在编译期暴露;get_if 只适合热路径上证据充分的少数窄口,本篇测出的 1.99 ns 是用手写样板换的。第二,不要在大小悬殊的类型上硬套 variant,32 字节槽位装 8 字节 Circle 的浪费会随类型差距放大,这种布局可以先给大类型做一层间接(variant 里放智能指针),但那又重新引回了堆分配,需要重新算账。第三,所有数字都来自 Apple clang 21 加 libc++ 在 macOS 上的实测,libstdc++ 的 visit 实现、ARM 平台的间接分支预测器行为都可能改变量级,落地自己的服务前照本工程在生产工具链上复测一次,比引用任何外部数字可靠。
实验环境
- 机器/系统:Mac mini(6 性能核 + 6 能效核)/ macOS 26
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),libc++ 13000;编译参数
-std=c++17 -Wall -Wextra,O2/O0 双档 - 日期:2026-11-12
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh两档各跑 7 次按标签取 ns/次 中位 → 同一脚本用重载的operator new统计万对象分配,用nm、otool -tvV固定 vtable 符号与三个 runner 的分派指令
代码获取
完整可复现工程(同协议三套实现、六个 noinline runner、operator new/delete 全套重载计数、O2/O0 双目标与反汇编采集脚本)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-variant-vs-virtual-dispatch
- 复现方式:克隆后进入该目录执行
bash run.sh,约一分钟输出六格七轮中位、万对象内存对照与三类分派指令证据;其他标准库与架构平台的耗时需重新实测,不要沿用本篇的纳秒数字。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的调用机制与值语义分组。虚函数去虚化条件讲编译器在什么前提下能把虚调用内联,本篇补上「内联不了时两种多态各花多少」的对照;std::function 堆分配阈值与 string SSO 实测共同构成小对象优化与值语义的成本基础,本篇的万对象分配计数与它们共用同一套 operator new 计数方法。语言语义层面,variant 的访问方式、valueless 状态与适用场景见入门篇,虚函数与继承体系的入门讲解见虚函数与多态。
总结
在同协议三实现、两场景、双优化档的基准上,variant 与虚函数的取舍得到了完整账本:O2 千万次调用中,单态时虚函数、visit、get_if 分别为 4.05、3.69、1.68 ns/次,差距尚小;混合轮转时虚函数因分支预测失配恶化到 6.66 ns,visit 靠规律的 discriminator 索引只涨到 4.79 ns,get_if 凭借热循环零 call 的跳转表稳定在 1.99 ns。内存上一万个对象总占用两者接近(300 KB 对 320 KB),但虚函数方案是一万次独立 new 加分散堆块,variant 是一次分配的连续定长数组、按对象堆分配为零。反汇编显示虚调用必然保留 vtable 槽位间接 call,visit 编译为共享访问函数表的索引调用,get_if 折叠为四目标内联跳转表;O0 下 visit 与 get_if 反而慢一个数量级,说明其优势依赖优化器。工程结论是按类型集开放性分流:开放扩展、对象身份重要用虚函数,闭合类型集、海量值对象与顺序遍历用 variant,热路径窄口再考虑手写 get_if,并用生产工具链自行复测量级。