vector、deque、list 遍历性能实测:缓存事件怎样解释三容器的数量级差距
编译优化系列的第九篇。上一篇用分配计数法量出了字符串 SSO 的边界,本篇把视角从单个对象扩大到容器整体:同样装 100 万个 int,std::vector、std::deque、std::list 的遍历耗时可以相差十几倍,头部插入更是相差上万倍。复杂度表只告诉你三者都是 O(n) 遍历,解释不了这个差距;真正的分水岭在内存布局与缓存行为,也就是缓存友好代码反复强调的那条主线。本篇用同一套元素量、同一套计时框架把三种容器跑在同一张基准上,再用堆占用记账、缺页与驻留内存证据,把「缓存事件」这件在 macOS 上无法直接用 perf stat 数出来的事,用可测量的旁证钉死。
本文要回答的问题
- 同样是 O(n) 顺序遍历,为什么 vector、deque、list 的实测耗时能拉出数量级差距?
- 三种容器的内存布局分别是什么形态,每条缓存行在遍历时被利用了多少?
- vector 头部插入为什么是百毫秒级,而 list 同一个操作只要几十微秒?
- deque 号称双端 O(1),它的中间插入为什么和 vector 一样慢?
- 没有硬件计数器时,能用哪些可测量的证据替代 cache-misses 来支撑缓存机理解释?
一、三种布局:连续数组、分块数组、散列节点
差距在遍历开始之前就已经决定了,决定因素是元素在堆上怎样排布。
vector<int> 只有一块连续堆内存,元素一个挨一个,64 字节的缓存行一次装 16 个 int。遍历方向与内存地址增长方向一致,硬件预取器可以顺着访问流提前把后续缓存行搬进缓存,循环里绝大多数访问命中在 L1/L2。deque<int> 是「分块的连续」:它维护一张块指针表,每个块是一段定长连续数组,本平台 libc++ 下每块放 1024 个 int(4 KB),块与块之间互不相邻。块内遍历享受连续布局的全部好处,但每跨过一个块就要经块表重新取一次地址,预取流在块边界断开。list<int> 则彻底没有连续性:每个元素是独立堆节点,节点里除了 payload 还挂着前驱、后继两个指针,遍历是一连串「取指针、跳到陌生地址、再取指针」的指针追踪,预取器无法从散乱的跳转目标里归纳出规律。
先用一张对比卡把三者的布局语义与成本轮廓摆在一起,后面的实验逐格验证。
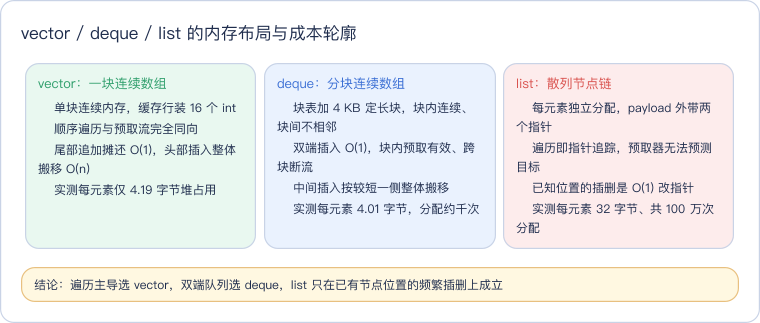
三种布局不是优劣排序,而是三种取舍:vector 用连续换遍历,list 用分散换插删,deque 是两者的折中。
下图把三种布局在缓存行视角下的形态画在一起,蓝色是有效 payload,灰色是指针与分配器元数据,红色标出遍历中必然发生的地址跳转。
读图抓住一条主线:绿色路径上地址是算出来的(基址加下标),红色路径上地址是 load 出来的(先访存取指针,才能知道下一次访存去哪)。前者让预取器跑在循环前面,后者让核心一次次停在等数据上。
二、基准设计:同元素量、五段测量、两套证据
固定元素量 N = 100 万个 int,插删次数 K = 1000,对三种容器跑完全相同的五段测量:存活期堆占用、顺序遍历、头部插入、中间(N/2 处)插入、中间删除。每档在独立进程里跑 7 次取耗时中位,避免单次调度噪声;编译采用 -std=c++17 -Wall -Wextra,O2 与 O0 各一套二进制,O0 用来掀开内联与向量化的盖子看结构差异。
堆占用沿用上一篇的记账法:重载全局 operator new/operator delete,按 malloc_size 返回的实际块大小累加,容器构建完成、析构触发前读一次「存活字节 = 累计分配 − 累计释放」,同时记录分配次数。这样每条目字节数是测出来的,不是按结构体大小推算的。
void* operator new(std::size_t n) {
    void* p = std::malloc(n);
    if (!p) throw std::bad_alloc();
    g_new_calls += 1;
    g_new_bytes += malloc_size(p);   // 按分配器实际块大小记账
    return p;
}
macOS 没有 Linux 的 perf stat,取不到 cache-misses、cache-references 这类硬件计数器原值。本篇不伪造任何 perf 输出,而是用三层可测证据替代:一是上面的每元素堆字节与分配次数,决定缓存行利用率与工作集大小;二是 /usr/bin/time -l 给出的最大驻留内存、page reclaims(次缺页)与上下文切换;三是 O2/O0 两档耗时对照,观察向量化失效后布局差异如何变化。Linux 上对应的硬件计数器读法见缓存性能计数器测量,同一套基准搬到 Linux 即可直接补数。
三、遍历实测:O2 下 16 倍差距,O0 下名次反转
七轮中位的完整对照如下,右图纵轴跨度超过四个数量级,统一用对数刻度。
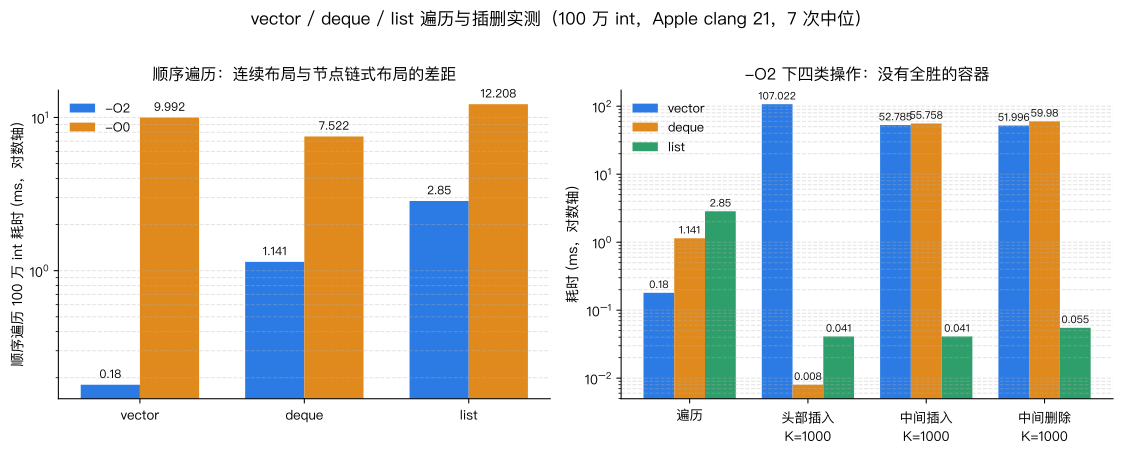
左面板先看 O2 三根蓝柱:vector 遍历 100 万 int 只要 0.180 ms,deque 1.141 ms,list 2.850 ms。以 vector 为 1,deque 约 6.3 倍、list 约 15.8 倍。三者做的加法次数完全相同,差距全部在访存:vector 的 4 MB 工作集贴着地址单调扫过,循环被编译器向量化后一条 SIMD 指令处理多个 int;deque 在约 977 个块之间各断一次流,块表查找与循环分支挡住了向量化;list 的 32 MB 工作集散在 100 万个独立块里,每步都依赖上一步 load 出来的指针,核心的乱序执行也填不上这个等待。硬件预取器能识别固定步长的访问流,却预测不了链表节点的跳转目标。
| 操作(7 次中位,ms) | vector | deque | list |
|---|---|---|---|
| 顺序遍历 100 万元(O2) | 0.180 | 1.141 | 2.850 |
| 顺序遍历 100 万元(O0) | 9.992 | 7.522 | 12.208 |
| 头部插入 1000 次(O2) | 107.022 | 0.008 | 0.041 |
| 中间插入 1000 次(O2) | 52.785 | 55.758 | 0.041 |
| 中间删除 1000 次(O2) | 51.996 | 59.980 | 0.055 |
O0 档出现一个反直觉的名次反转:deque 7.522 ms 反超 vector 的 9.992 ms。没有向量化之后,两者都是标量逐元素循环,deque 块内仍是连续访问,而 vector 版本的下标边界检查与统一循环骨架在 O0 下没有被优化掉,常数反而更大。这恰好说明 vector 在 O2 的领先有一部分来自优化器对单块连续内存的向量化红利,布局优势与编译器红利是叠加的;部署构建普遍开 O2,但读懂 O0 才知道哪部分优势是结构自带的、哪部分是优化器施舍的。
完整实测记录如下,含 sizeof、堆占用记账、两档七轮中位与 time 证据。
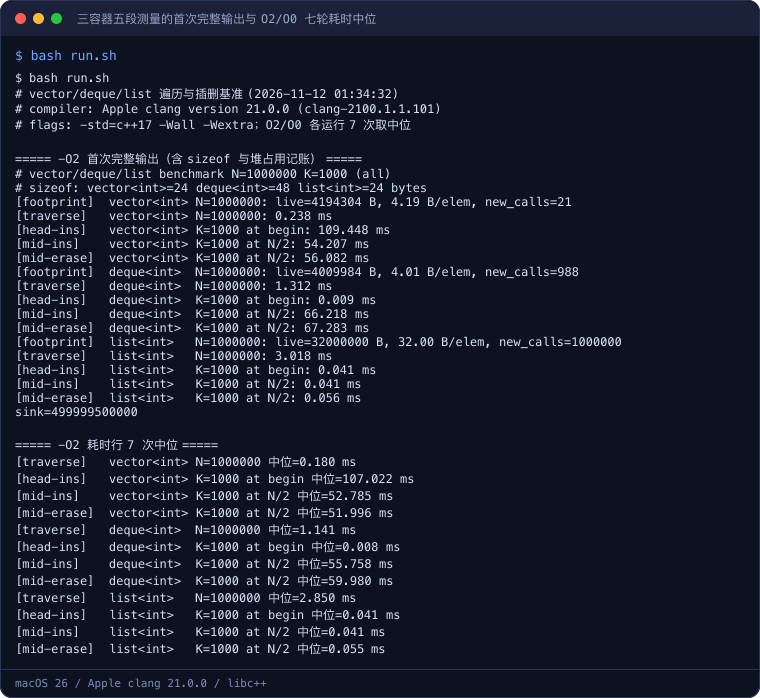
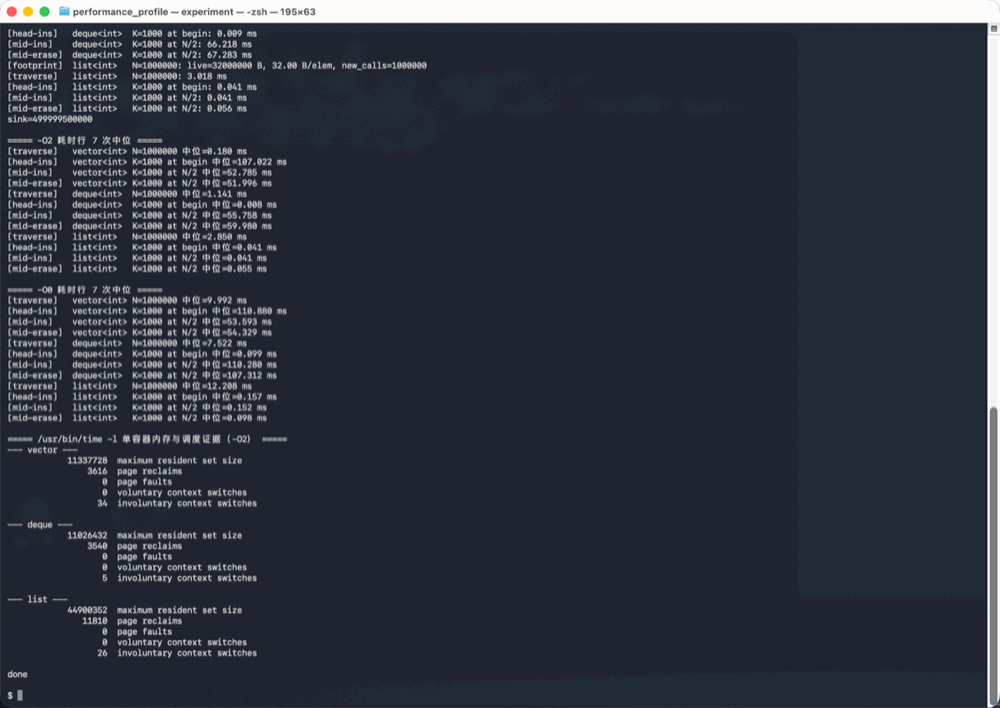
记录里三个 sink 值相同,证明三种容器遍历的是等价数据、求和结果一致,先对齐语义再比耗时。
四、头部与中间插删:复杂度相同,常数差四个数量级
插删部分的数字比遍历更夸张。头部插入 1000 次,vector 耗时 107.022 ms,deque 0.008 ms,list 0.041 ms,最大差距约 1.3 万倍。机制上,vector 每次 insert(begin()) 都要把现有全部元素向后挪一个位置,1000 次就是约 10 亿次 int 搬移;deque 在头部块里挪至多一块的数据、必要时新挂一个块;list 只 malloc 一个节点再改两个指针。
下图把头部插入的两种动作并排画出:红色是反复发生的整块搬移,绿色是常数次指针修改。
中间插删则是另一个故事。list 在 N/2 处的 1000 次插删只要 0.04–0.06 ms,因为基准里迭代器已经停在中部,每次只是改链;vector 与 deque 分别是 52–60 ms 量级,两者几乎一样慢。这里要戳破一个常见误解:deque 的 O(1) 只属于两端。它的中间插入语义是「计算插入点离哪端更近,把较短一侧的元素整体挪位」,在正中间就是搬动约 50 万元,和 vector 搬半个数组的常数相当。O0 下 deque 中间插删进一步劣化到 110 ms 上下,块边界让搬移路径多出块表跳转。还有一个必须说清的前提:list 的 O(1) 是「持有目标节点迭代器」时的成本,若从头找位置,std::advance 本身是 O(n) 指针追踪,省下的插删钱会赔进查找里。
五、缓存事件的旁证:占用、缺页与驻留内存
把记账器与 /usr/bin/time -l 的数字摊开,缓存机理就有了可溯源的支撑,而不是停留在「链表缓存不友好」的口号上。
| 证据(100 万 int,-O2) | vector | deque | list |
|---|---|---|---|
| 容器对象 sizeof(字节) | 24 | 48 | 24 |
| 存活堆占用(字节) | 4,194,304 | 4,009,984 | 32,000,000 |
| 每元素堆字节 | 4.19 | 4.01 | 32.00 |
| 构建期分配次数 | 21 | 988 | 1,000,000 |
| 最大驻留内存(字节) | 11,337,728 | 11,026,432 | 44,900,352 |
| page reclaims(次缺页) | 3,616 | 3,540 | 11,810 |
| 非自愿上下文切换 | 34 | 5 | 26 |
第一行旁证是缓存行利用率。一个 int 4 字节,vector 与 deque 的每元素堆占用都在 4 字节出头,64 字节缓存行里 16 个 payload 全是有效数据;list 实测每元素 32 字节——节点本身 24 字节(两个 8 字节指针加一个 int),经分配器对齐到 32 字节块——有效载荷只占八分之一,每搬一行缓存线,八分之七的带宽花在指针和填充上。这与结构体填充与打包是同一条「有效字节密度」线索。
第二行旁证是工作集与缺页。vector、deque 的数据本体约 4 MB,list 是 32 MB,正好八倍;进程最大驻留内存 11 MB 对 45 MB、次缺页 3600 对 11810,数量级关系完全吻合。更大的工作集意味着更多缓存行在多级缓存间颠簸,工作集与缓存占用给出的判据在这里直接适用:vector 的 4 MB 数据连 L3 都装得下,list 的 32 MB 在多数机器上只能靠主存兜底。100 万次独立分配还让节点散布在堆的各个角落,相邻逻辑节点在物理上不相邻,进一步打散了 TLB 与缓存的局部性。
第三行旁证是 O2/O0 对照里的预取与向量化特征。vector 的 O2/O0 遍历差距约 55 倍(0.180 对 9.992 ms),list 只有约 4.3 倍(2.850 对 12.208 ms):连续布局把编译器向量化、硬件预取、乱序执行三重机制全部喂饱,散列节点则让这三重机制大部分失效,优化空间天然受限。需要在 Linux 上把旁证升级成直接计数器时,perf stat -e cache-misses,cache-references,LLC-load-misses 跑同一二进制即可,计数器语义与测法见缓存性能计数器测量。
六、选型纪律与常见疑问
把五段测量收敛成四条可执行的纪律。
第一,默认选 vector,尤其是读多写少、遍历密集的场景。它的遍历最快、每元素字节最少、分配次数只有二十几次;担心扩容就先 reserve 已知容量,扩容成本即被摊平。缓存友好代码里「连续数组打败链表」的所有论据,本篇都给出了本机数字。
第二,需要双端进出才用 deque,不要把它当「更好的 vector」。它的双端插删是微秒级,但中间插删与 vector 同档、遍历慢约六倍;任务队列、滑动窗口、生产者消费者缓冲这类头尾操作模式才是它的主场。
第三,list 的使用门槛比教科书暗示的高得多。只有当你长期持有节点迭代器、并且在这些已知位置上频繁插删时,O(1) 改链才兑现;需要按值查找、按位置访问或顺序扫描的场景,list 的指针追踪成本会吞掉一切。元素本身很大(大对象搬移昂贵)时,也先比较 vector<unique_ptr<T>> 这类「连续句柄数组」方案再考虑链表。
第四,关注有效字节密度而不只是算法复杂度。O(n) 与 O(n) 可以差十几倍,差异来自缓存行里有效载荷的比例与访问流的可预取性;做结构体容器时同样要审视 padding,AoS 与 SoA 布局是这条纪律在结构体数组上的延伸。多线程场景下,分散节点还可能让不同核的写操作落在同一缓存行上制造伪共享,排查手法见伪共享实测。
常见疑问补三条。其一,「list 插删不搬数据,为什么头部插入还是比 deque 慢」:0.041 ms 对 0.008 ms 的差距来自每次插一个节点就要一次 malloc,分配器本身的锁与块管理远比改指针贵;deque 头部插入复用预分配的块,绝大多数情况不进分配器。其二,「deque 能随机访问,为什么不支持向量化」:标准只保证 O(1) 随机访问,实现上每次 operator[] 都要经块表换算地址,编译期无法证明整个循环落在单块内,向量化条件不成立。其三,「换更大的元素结论会反转吗」:元素变大后 vector 搬移的单元素成本上升,插删类操作的差距会收窄,但遍历的缓存行利用率劣势仍在——大对象场景应实测后再决策,本篇的 int 数字不外推。
实验环境
- 机器/系统:Mac mini(6 性能核 + 6 能效核)/ macOS 26.5.2
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),libc++;编译参数
-std=c++17 -Wall -Wextra,O2/O0 双档 - 日期:2026-11-12
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh两档各跑 7 次按标签取耗时中位 → 单容器模式/usr/bin/time -l ./bin/bench-O2 vector|deque|list取驻留内存、次缺页与上下文切换;macOS 无perf stat,缓存事件以堆占用记账、缺页与两档耗时对照作旁证,未使用任何模拟计数器数据。
代码获取
完整可复现工程(三容器五段测量、operator new 堆占用记账、O2/O0 双目标、7 轮中位编排与 /usr/bin/time -l 证据采集)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-vector-deque-list-traversal
- 复现方式:克隆后进入该目录执行
bash run.sh,约三分钟输出两档耗时中位与内存证据;Linux 机器上可对同一二进制补跑perf stat取硬件计数器原值,其他标准库的 deque 块大小与 list 节点对齐可能不同,字节类数字需重新实测。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的容器与内存布局分组。string SSO 与 string_view 实测解决单对象的分配边界,本篇解决容器整体的布局成本;机理上与缓存友好代码、硬件预取器、工作集与缓存占用构成同一条缓存主线,测量方法与缓存性能计数器测量互补。后续同组会展开 unordered_map 开链布局的缓存代价与自定义分配器对节点式容器的改善空间。
总结
在 100 万 int 的同元素量基准上,三种容器的差距由内存布局而非复杂度表决定:vector 凭单块连续内存取得 0.180 ms 的遍历成绩、每元素仅 4.19 字节,deque 分块连续遍历慢约 6.3 倍但双端插删只要 8 微秒,list 每元素 32 字节、100 万次独立分配使遍历慢约 15.8 倍、32 MB 工作集对应 11810 次次缺页,而持有迭代器时的中间插删仍守在 O(1) 的几十微秒。vector 头部插入的 107 ms 与 list 同操作的 0.041 ms 相差约 2600 倍,deque 中间插删与 vector 同档则说明它的 O(1) 只属于两端。没有硬件计数器的平台上,每元素堆字节、分配次数、驻留内存、次缺页与 O2/O0 耗时对照足以构成缓存机理的完整证据链:连续可预取的访问流赢在缓存行有效密度与预取、向量化红利,散列节点输在指针追踪与八倍工作集。默认 vector、双端场景 deque、list 仅限持有节点迭代器的频繁插删,是这组数据支持的选型纪律。