unordered_map 与排序 vector 查找选型:小数据量下谁更快的扫档实测
C++ 性能实测系列的第十篇。上一篇用遍历与插删基准量出了三种序列容器的布局成本,本篇把测量对象换成查找容器。教科书式的回答很干脆:哈希表均摊 O(1),红黑树和二分查找是 O(log N),选型似乎没有悬念。但复杂度只回答「N 趋向无穷时谁赢」,工程里的真实表常常只有几十、几百个条目——配置项、枚举映射、协议字段表、缓存路由表,大多在这个量级。本篇用同一组随机 int key,让 std::map、std::unordered_map 和排序后 std::vector 加 std::lower_bound 在 8 到 100 万元素的 13 个档位上正面对打,把交叉拐点从真实数据里找出来,再用每条目内存占用与预处理耗时解释曲线为什么长成这样。
本文要回答的问题
- 元素量只有几十、几百时,三种结构的随机查找耗时各是多少,谁最快?
- sorted vector 反超
unordered_map的拐点出现在哪个量级,O2 与 O0 下位置一样吗? - 同样是 O(log N),为什么排序 vector 在每个档位都比
std::map快,百万级仍快约 1.5 倍? - 三种结构每条目实际吃多少内存,构造期预处理成本差多少?
- 只读表、频繁更新表、超大表分别应该选什么结构?
一、三种结构的查找路径与内存布局
先把三者的底层动作摆清楚。std::map 是红黑树,每个条目独立成一个堆节点,节点里除了 key 和 value,还要放三个指针(父、左、右)加颜色位;一次查找从根节点出发,每比较一次就沿指针跳到另一个堆地址,跳多少次取决于树高。std::unordered_map 在 libc++ 上是开链哈希表:先对 key 算哈希、对桶数取模定位桶,再沿桶内链表逐个比较,理想情况下一次跳转就命中。排序 vector 则把所有 pair<int,int> 紧凑排在一块连续内存里,lower_bound 每次折半按下标访问,没有任何指针追踪。
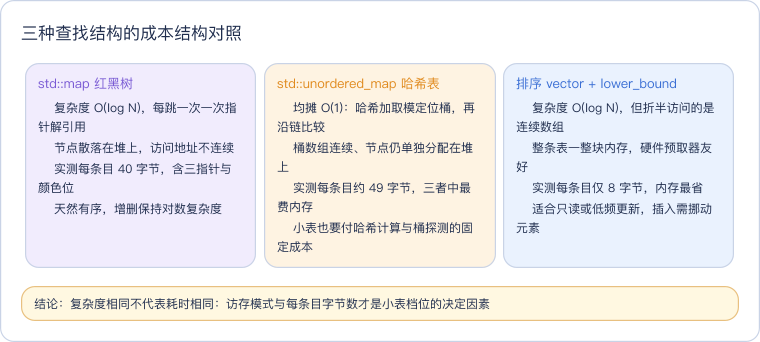
这张对照卡的核心判断是:红黑树和二分查找虽然同为 O(log N),但前者的 log 次访问落在互不相邻的堆节点上,后者的 log 次访问落在一块连续数组里。现代 CPU 的缓存与预取机制对这两种访存模式的定价完全不同,这正是后面曲线分化的根源。连续内存为什么便宜,可以配合缓存友好代码里的局部性原理一起看。
三种结构的内存形态如下图,紫色是红黑树的分散节点,橙色是哈希表的桶数组加链节点,蓝色是排序数组的整块连续存储。
读图抓住两条对比线:树的每条边都是一次指向陌生堆地址的跳转,预取器无法预测下一跳;排序数组的折半虽然也跳着访问,但落点始终在同一块缓存友好的连续区域内,且表越小,整块表越容易整体躺进 L1/L2 缓存。
二、实验设计:13 档扫档与计数方法
实验工程在每个档位生成 N 个互不相同的随机 int key(在 [0, 4N) 区间洗牌后取前 N 个),分别灌进三个结构。查找负载固定为每档 10 万次随机命中查找,查找下标由独立的均匀分布生成,保证三种结构面对完全相同的 key 序列;程序内部对每档测量重复 3 次取最短值,编排脚本再让 O2 与 O0 两个二进制各跑 7 次、按行标签取中位,两层降噪。计时用 std::chrono::steady_clock,查找结果累加进校验和,避免编译器把循环整体优化掉。
内存占用不靠估算,而是重载全局 operator new/operator delete(含对齐版与 sized delete 共十个函数),在每个结构的构造区间内统计存活堆字节,再除以条目数得到每条目实际字节;vector 额外记录 capacity() 换算的整块字节。这套计数手法与 std::function 堆分配阈值实测同源,区别是本篇按结构分别开关计数。
需要先说清两个口径:其一,所有查找都是命中查找,未测缺失 key,因为缺失路径的相对关系与命中一致而绝对耗时略低,不影响选型结论;其二,unordered_map 按默认方式逐个 emplace 构造,没有提前 reserve,重新哈希的成本计入预处理耗时——这对应最常见的随手写法,工程上已知条目数时 reserve 可以省掉这部分。
三、全量扫档曲线:拐点落在 128 元素附近
O2 七轮中位的完整曲线如下,左面板是 8 到 100 万的双对数全量扫档,右面板把 1024 以下的小量级区间单独放大。
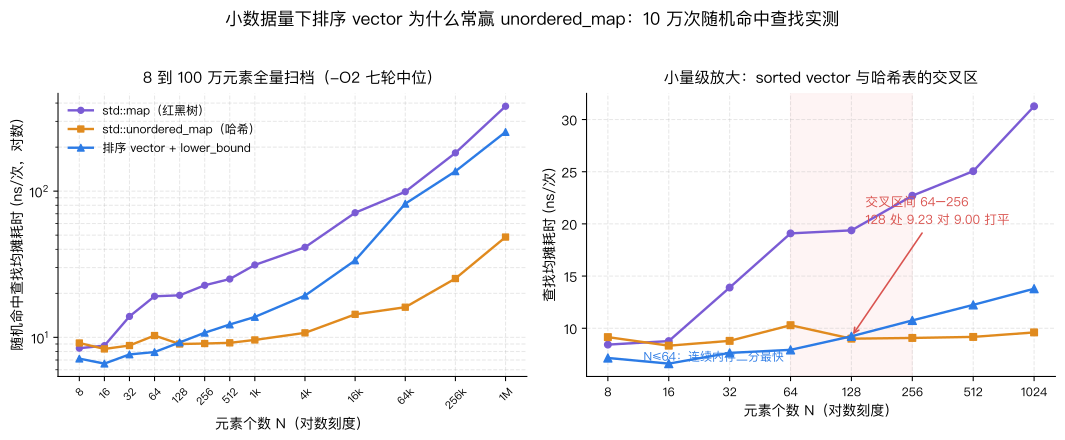
左面板读出三条曲线的总体形状。unordered_map 的橙色线几乎平着走:从 8 元素的 9.15 ns 到 4096 元素的 10.73 ns,耗时只涨了约 17%,百万级才升到 48.52 ns,这是 O(1) 应有的样子。std::map 的紫色线随树高稳步上扬,百万级达到 380.44 ns。排序 vector 的蓝色线在小量级段贴着图底,N 超过 1.6 万后随 log N 次折半的累计成本快速抬头,百万级为 253.80 ns——注意它在每个档位都低于红黑树,最大量级仍快约 1.5 倍。
右面板的红色阴影就是本篇要找的交叉区。N 不超过 64 时排序 vector 全程最快:64 元素档 7.93 ns,对哈希表 10.29 ns、红黑树 19.09 ns。到 128 元素档,vector 9.23 ns 与哈希表 9.00 ns 基本打平,差距落在测量噪声范围内。256 元素起哈希表明确反超并一路领先:256 档 9.07 对 10.75,1024 档 9.60 对 13.79。所以 sorted vector 对 unordered_map 的优势区间在本平台上是 N ≤ 64 稳定获胜、128 附近打平、256 以上让位,拐点区间可以精确报为 64 到 256 个元素。
13 档的 O2 中位数值如下,所有数字都能在实验记录里按 N= 定位。
| 元素量 N | map (ns/次) | unordered_map (ns/次) | sorted vector (ns/次) | 当档最快 |
|---|---|---|---|---|
| 8 | 8.43 | 9.15 | 7.15 | vector |
| 16 | 8.77 | 8.33 | 6.61 | vector |
| 32 | 13.90 | 8.79 | 7.64 | vector |
| 64 | 19.09 | 10.29 | 7.93 | vector |
| 128 | 19.38 | 9.00 | 9.23 | 打平 |
| 256 | 22.70 | 9.07 | 10.75 | unordered_map |
| 512 | 25.05 | 9.17 | 12.24 | unordered_map |
| 1024 | 31.27 | 9.60 | 13.79 | unordered_map |
| 4096 | 41.29 | 10.73 | 19.29 | unordered_map |
| 16384 | 71.14 | 14.36 | 33.60 | unordered_map |
| 65536 | 99.03 | 16.07 | 82.01 | unordered_map |
| 262144 | 182.58 | 25.25 | 136.72 | unordered_map |
| 1048576 | 380.44 | 48.52 | 253.80 | unordered_map |
还有两个反直觉点值得单独点出。第一,哈希表不是从头赢到尾:8 元素档它的 9.15 ns 反而慢于红黑树的 8.43 ns,因为再小的表也要付哈希计算、取模和桶探测的固定开销,而三四个节点的小树一次比较就落到相邻缓存行。第二,红黑树在整张表上没有赢过任何一档的排序 vector——同为 O(log N),访存连续性把理论上的平手拉开成稳定 1.5 倍以上的差距,工作集越小差距越夸张,64 元素档是 19.09 对 7.93,2.4 倍。
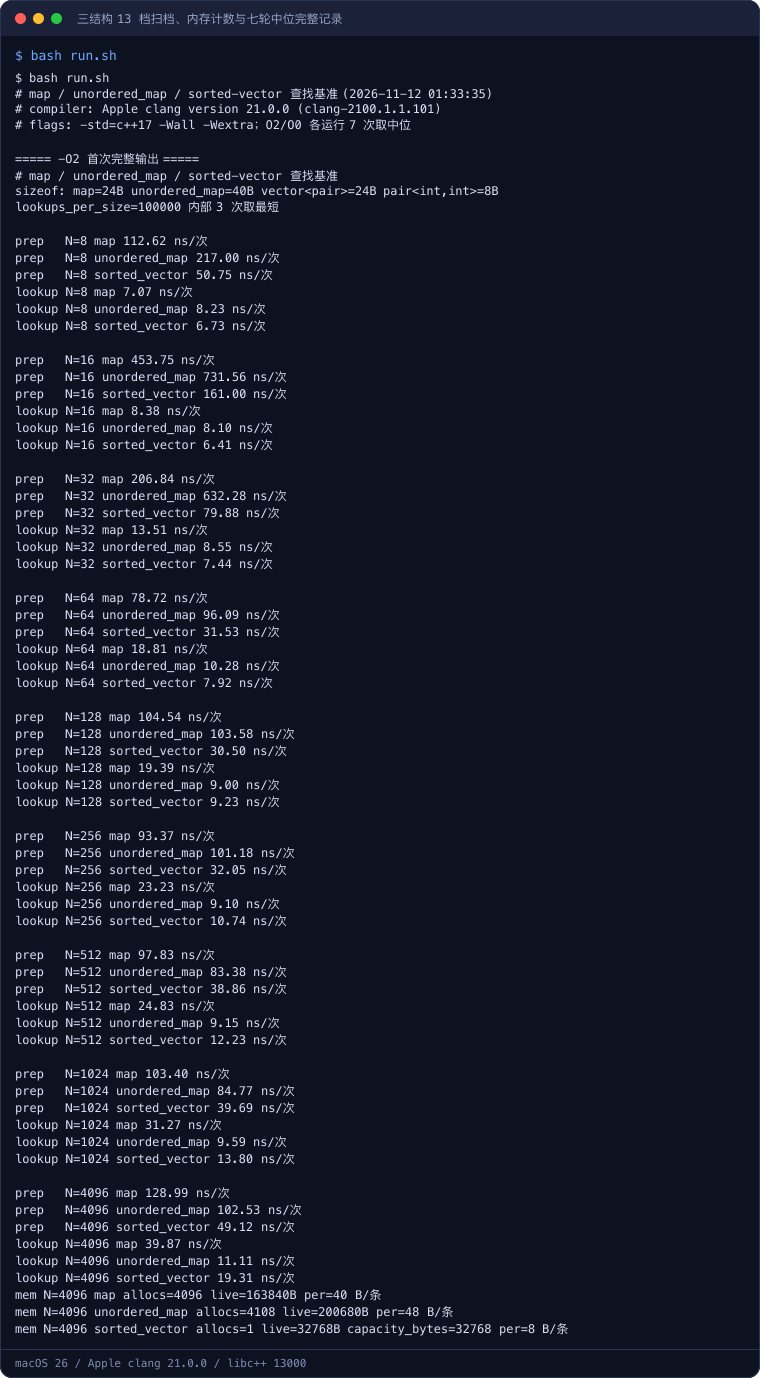
完整实测记录如下,含 13 档预处理与查找耗时、两档内存计数、O2/O0 各 7 轮中位和重载符号证据。
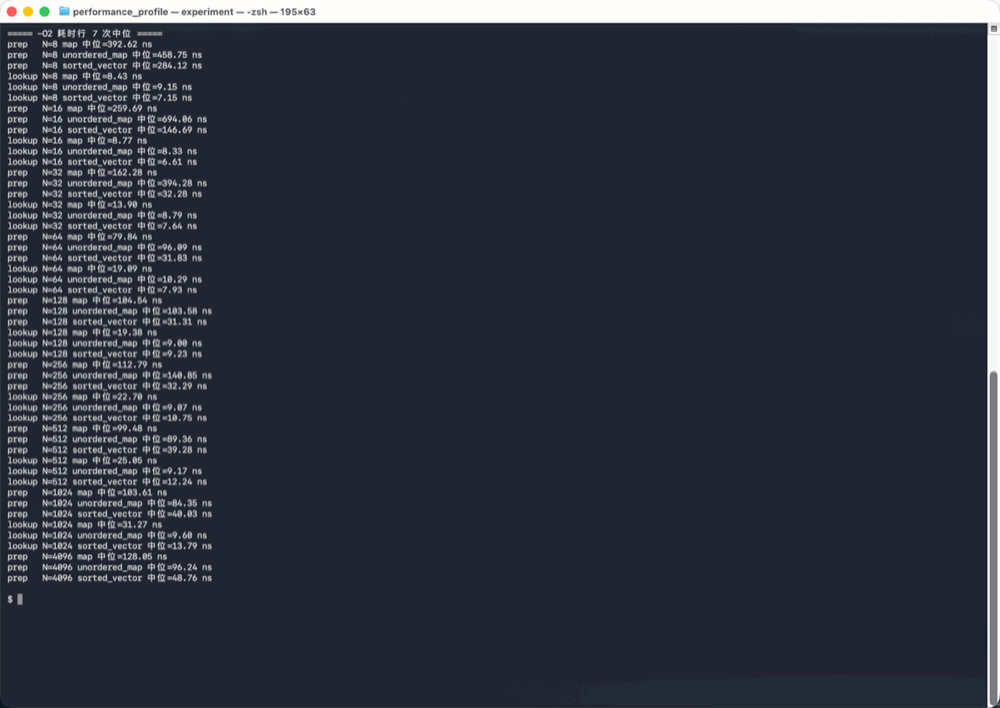
四、机理:小表赢在缓存,大表输在比较次数
曲线的分化可以拆成两个力的消长。排序 vector 的每次折半都是对连续数组的随机下标访问,当整张表能放进缓存时,这些访问几乎全部命中 L1/L2,代价是几次整数比较加下标计算;哈希表每次查找则要先算哈希、取模、访问桶数组,再跳到堆上的节点比较 key,步骤数和分支数都更多。表越小,vector 的整块数据越容易整体驻留缓存,固定开销的权重越高,于是 64 元素以内 vector 能压着哈希表打。工作集与缓存层级的量化关系可以对照工作集足迹一文。
越过拐点后,力量对比反转。vector 的折半次数是 log2(N) 级别的真实比较:100 万元素一次查找要做约 20 轮,每轮虽然便宜但轮次实打实;哈希表的耗时却几乎不随 N 增长,桶不紧张时始终是一两次跳转。当 N 从 128 涨到 100 万,vector 的比较轮次翻了约 13 倍,曲线自然抬头。内存账面上也能看到同一件事:百万条目的 vector 是 8 MB 连续块,已远超 L2 容量,折半落点开始落到 LLC 甚至内存;而哈希表靠 O(1) 的步数绕开了这个问题。
内存占用的实测差距比耗时更悬殊,下表是重载 operator new 数出来的存活字节。
| 结构 | 4096 条存活字节 | 每条目 | 100 万条存活字节 | 每条目 |
|---|---|---|---|---|
| std::map | 163,840 B | 40 B | 41,943,040 B | 40 B |
| std::unordered_map | 200,680 B | 48 B | 51,504,392 B | 49 B |
| sorted vector | 32,768 B | 8 B | 8,388,608 B | 8 B |
红黑树每个条目恒定 40 字节:8 字节 key/value 对,其余是三个指针和颜色位的节点头。哈希表最贵,百万条目约 49 字节一条,节点之外还要养桶数组(构造期分配次数 104 万次出头,比条目数多出的近 600 次正是历次桶扩容留下的分配记录)。排序 vector 每条目就是 pair<int,int> 的 8 字节,同样百万条目只占 8 MB,内存效率是哈希表的 6 倍。对嵌入式、缓存紧张或要把整张表锁进 L2/L3 的场景,这个差距本身就足以决定选型;数据组织方式对缓存行为的影响,AoS 与 SoA 布局有更系统的拆解。
五、预处理成本与 O0 对照
查找快不等于整体划算,排序 vector 的账要把预处理算进去。O2 中位下,百万条目构造期的每条目摊销:红黑树 533.79 ns、哈希表 289.28 ns、vector 灌入加排序仅 79.74 ns。连续内存的批量写入加一次 std::sort,比逐节点堆分配便宜一个数量级;4096 条目档三者分别是 128.05、96.24、48.76 ns,量级关系不变。结论是:对「一次构建、多次查找」的只读表,vector 的预处理不仅不是负担,反而是三项里最便宜的;只有在需要频繁随机插入删除的表里,挪动元素的成本才会兑现,那时才轮得到树和哈希表发言。
关掉优化重跑,拐点位置发生了耐人寻味的移动。O0 下哈希表的查找耗时几乎钉在 104 ns 上下(4096 条目以内),因为函数调用无法内联,固定开销被整体放大;vector 则从 8 元素的 107.15 ns 随比较轮次单调上涨,16 元素档 127.68 ns 已经落后哈希表的 103.75 ns。也就是说没有内联时,vector 的优势区间收缩到只剩个位数条目,交叉点退到 N 等于 8 附近。部署构建普遍开 O2,这个极端档位不会原样出现,但它提示了一点:vector 的小表优势有一部分来自编译器把 lower_bound 内联成紧凑的比较循环,调试构建下的性能印象不能用来指导发布选型。
| 元素量 N | O0 map | O0 unordered_map | O0 sorted vector |
|---|---|---|---|
| 8 | 136.46 | 103.89 | 107.15 |
| 64 | 196.67 | 107.11 | 170.07 |
| 1024 | 277.63 | 108.24 | 258.54 |
| 1048576 | 1096.36 | 399.77 | 648.08 |
O0 数据还顺手验证了另一件事:即便没有任何优化加持,排序 vector 在百万档(648.08 ns)依然显著快于红黑树(1096.36 ns),缓存局部性带来的优势是结构性的,不靠优化器施舍。
六、按量级与更新模式选容器的纪律
把三组数据收敛成四条可执行的选型纪律。
第一,条目数在几十到一两百、且以读为主的表,默认排序 vector 加 lower_bound。协议字段、错误码描述、配置映射这类天然短小的只读表,实测在 64 条目以内它同时是最快和最省内存的选项,8 字节一条还能整块塞进缓存;构造时一次排序的摊销成本只有哈希表的四分之一到三分之一。
第二,条目数确定会涨到几百以上、或需要运行期频繁随机增删,再上 unordered_map,并且已知规模时先 reserve。拐点在 128 附近,256 以上哈希表的领先迅速拉开;提前 reserve 还能省掉实测中观察到的逐次桶扩容,把每条目接近 49 字节的内存压力控制在设计范围内。
第三,不要在查找场景默认 std::map。它在本次扫档中没有赢过任何一档:比 vector 贵 1.5 到 2.4 倍,比哈希表贵一个数量级,内存还居中。红黑树的真正主场是需要有序遍历、范围查询或按 key 顺序增删且不能接受哈希重排的场景,单纯点查选它属于为用不到的有序性付税。
第四,选型要跟着本平台实测走,不要背结论。拐点 128 是 Apple clang、libc++ 与当前微架构上 int key 的数字;key 变成昂贵的字符串、哈希函数变慢、或 CPU 缓存结构不同,交叉点都会移动。换平台或换 key 类型后,用本篇工程改类型重新扫档,比沿用任何经验值可靠。
实验环境
- 机器/系统:Mac mini(6 性能核 + 6 能效核)/ macOS 26.5.2
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),libc++ 13000;编译参数
-std=c++17 -Wall -Wextra,O2/O0 双档 - 日期:2026-11-12
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh两档各跑 7 次按标签取中位,程序内部每档 3 次取最短;构造期通过重载operator new统计存活堆字节,nm固定重载符号证据
代码获取
完整可复现工程(13 档扫档、三结构查找与预处理计时、operator new 内存计数、O2/O0 双目标、7 轮中位编排)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-unordered-map-sorted-vector-lookup
- 复现方式:克隆后进入该目录执行
bash run.sh,结果写入results.txt;换平台、换标准库或换 key 类型后需要重新实测,不要直接沿用本篇的拐点数字。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的容器与内存分组。vector/deque/list 遍历实测是同系列上一篇,两篇共用「内存布局决定缓存行为」的视角,一个看序列遍历、一个看键值查找;string SSO 与 string_view 实测与std::function 堆分配阈值演示了本篇复用的 operator new 计数法。机理层面,缓存局部性的系统讲解见缓存友好代码,工作集与缓存层级的关系见工作集足迹,连续内存布局的进一步收益见AoS 与 SoA 数据布局。
总结
在 8 到 100 万元素的 13 档随机命中查找实测中,三种结构的真实分工与复杂度排序并不重合。排序 vector 加 lower_bound 在 N 不超过 64 时全程最快(64 档 7.93 ns,对哈希表 10.29 ns、红黑树 19.09 ns),128 元素档与 unordered_map 打平(9.23 对 9.00 ns),256 元素起哈希表明确反超并在大表档拉开一个数量级,交叉拐点区间为 64 到 256 个元素;O0 下因内联消失,拐点退到 8 元素附近。同为 O(log N) 的红黑树没有赢过任何一档,百万级仍比 vector 慢约 1.5 倍,差距来自分散堆节点对连续数组的访存模式之差。内存账同样一边倒:每条目 map 40 字节、unordered_map 约 49 字节、vector 仅 8 字节,百万条目相差约 6 倍,而 vector 的构造加排序摊销反而是三者中最低(79.74 ns/条)。几十到几百条目的只读表选排序 vector、几百以上或频繁增删选 reserve 过的 unordered_map、纯点查不要默认 std::map、换平台重新扫档,是这组数据支持的四条选型纪律。