开寻址哈希表:手写线性探测与 unordered_map 在负载因子下的实测对照
C++ 性能实测系列的第十一篇。上一篇把 std::unordered_map、红黑树与排序 vector 放在元素量级轴上对打,本篇固定元素量级,转动另一个更隐蔽的旋钮:负载因子。std::unordered_map 在 libc++ 里是开链实现,碰撞的条目挂到桶链表上;而工业界高性能哈希表(SwissTable、F14、各类 flat hash map)几乎清一色选择开寻址:数据直接存进一张连续数组,碰撞后按固定规则探测下一个槽。开寻址省掉了每节点的指针与堆分配,代价是查找成本对负载因子极度敏感。本篇手写一张线性探测表,在 0.3 到 0.9 共七档负载因子下与 std::unordered_map 正面对打,把「表装到多满会出事」从教科书公式变成本机可复现的数字。
本文要回答的问题
- 开寻址哈希表的线性探测到底怎样工作,碰撞后查找和插入沿着什么路径走?
- 负载因子从 0.3 抬到 0.9,成功查找与不成功查找的平均探测长度各涨多少,爆炸点在哪?
- 同样的随机操作序列,手写开寻址表与
std::unordered_map在查找、插入上谁快,快多少? - 开寻址表删掉元素为什么不能只置空,墓碑标记与 backward-shift 回挪两种删除怎样取舍?
- 连续数组省下的内存在不同负载因子下怎样折算,工程上负载因子红线应该画在哪?
一、两种哈希表的内存布局与碰撞处理
先把两种实现的物理形态摆清楚。开链哈希表(libc++ 的 std::unordered_map)由一张桶数组加一堆独立堆节点组成:桶里存的是指向节点的指针,每个节点除了 key/value 还要带上链表 next 指针,一次插入伴随一次堆分配。碰撞的条目挂在同一个桶的链表上,桶有多满链表就有多长。开寻址哈希表则只有一张连续的槽数组,每个槽固定放 key、value 和一个占用标记,没有任何指针:哈希定位到家槽(home slot)后发现被占,就按既定规则去看下一个槽,线性探测的规则最简单——下标加一,走到数组末尾再绕回开头。
读图抓住两种访存模式的差别:橙色的开链路径每次碰撞都是一次跳到陌生堆地址的指针追踪,预取器帮不上忙;蓝色的开寻址路径始终在同一块连续数组里向前挪,相邻槽大概率躺在同一缓存行,这是它低负载因子下极快的根本原因。图中红色的家槽代表碰撞点,绿色空槽则是探测的终止条件——这点很关键,开寻址的不成功查找必须走到第一个空槽才能确认 key 不存在,所以空槽越稀缺,不成功查找越贵。连续内存为什么对缓存友好,缓存友好代码有系统的拆解。
两种结构还有一个成本结构上的对称性:开链表的内存几乎只随元素数增长,桶数组占比小;开寻址表的数组按容量一次性分配,元素越少、槽位浪费越多,内存效率反过来由负载因子决定。后面的内存账会把这笔账量化。
二、线性探测的工作流与删除的两难
把一次操作的完整判定路径画成流程卡:插入和查找共用同一条探测链,区别只在遇到空槽时的动作。
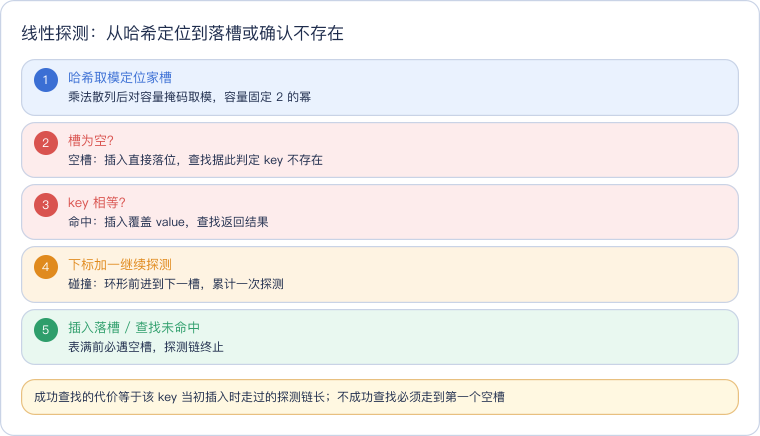
这张流程卡点出了线性探测的两个内在约束。其一,每个 key 的查找路径被它插入时的探测链锁死,只要链上任何一个槽被错误清空,后续 key 就会提前遇到空槽而误判不存在——所以删除不能简单置空。其二,探测有明显的聚集倾向:碰撞的条目在数组里堆成一段段连续的簇(primary clustering),簇越长越容易吸收新的碰撞,这正是负载因子逼近 1 时成本非线性爆炸的机理。
删除有两条主流路线。墓碑法(tombstone)在槽里放一个「已删除」标记,探测时把墓碑当作可越过的占位,插入时可以复用。实现简单,但墓碑会累积,簇只增不减,长时间运行后查找性能被墓碑拖垮,需要定期 rehash 清场。本篇选择 backward-shift 删除:删掉条目留下洞之后,沿探测簇向后扫描,把家槽落在洞之前的条目逐个回挪补洞,直到遇见真正的空槽。
读这张图抓住一个判定细节:回挪不是无脑搬移,只有当后继条目的家槽不在「洞到当前位置」这个环形区间内时才能搬,否则会把条目搬得离自己的家槽更远、破坏探测链。backward-shift 的代价是单次删除要沿簇走一遍,成本与探测链长同阶;换来的是表里没有墓碑、簇长度真实反映负载,查找性能不随删除历史劣化。对删除频繁且要求长期稳定延迟的表,这笔扫描钱值得花;删除罕见的表用墓碑加周期性 rehash 实现更省事。工程内建了一组自检:插入 40 个键、删掉前 20 个之后,存活键必须全部命中、已删键必须全部未命中,每次运行先跑这组自检才进入基准。
三、基准设计:固定容量七档扫档与计数口径
实验固定槽容量 CAP 为 262144(2 的 18 次方),七档负载因子 0.3 到 0.9 对应元素量 N 从 78643 到 235930,两种结构灌入完全相同的随机 key 序列与同一批缺失 key。这里有一个实测中踩到、值得专门记下的设计坑:key 最初取自 [0, CAP) 全集,结果成功探测长度恒为 1.000——奇数乘法散列对 2 的幂取模在完整剩余系上是双射,全集 key 的家槽两两不同,插入根本不碰撞。真实业务的 key 永远是稀疏的,最终把 key 池扩大到容量的 4 倍区间 [0, 4·CAP) 洗牌取样,家槽自然碰撞,数据才恢复成应有的形状。
每档采集四类指标。探测长度对开寻址表直接在代码里计数:成功查找对全部 N 个存活 key 统计平均探测步数,不成功查找对 20 万个保证不在表内的缺失 key 统计走到空槽的步数。耗时用 std::chrono::steady_clock,程序内每档重复 3 次取最短,编排脚本再让 O2 与 O0 两个二进制各跑 7 轮按行标签取中位,两层降噪。内存走两条口径:开寻址表按 sizeof(Slot) 乘容量实测,unordered_map 则重载全局 operator new(含对齐版共十个函数),在构造区间统计存活堆字节——这套计数法与 std::function 堆分配阈值实测同源。计时结果累加进 volatile 校验和,防止循环被整体优化掉。
四、实测数据:探测长度在 0.9 附近爆炸
七档的核心数据如下图,左面板是平均探测长度(纵轴对数刻度),右面板是 O2 七轮中位的查找耗时。
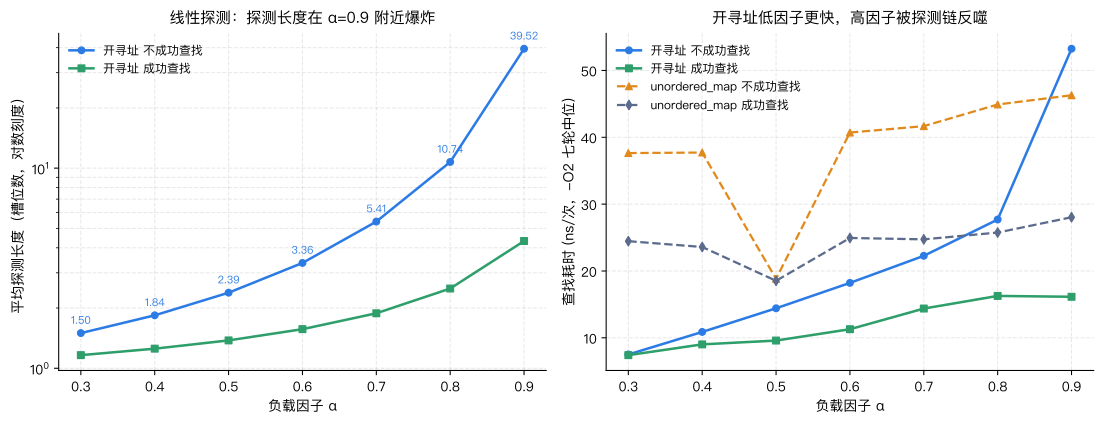
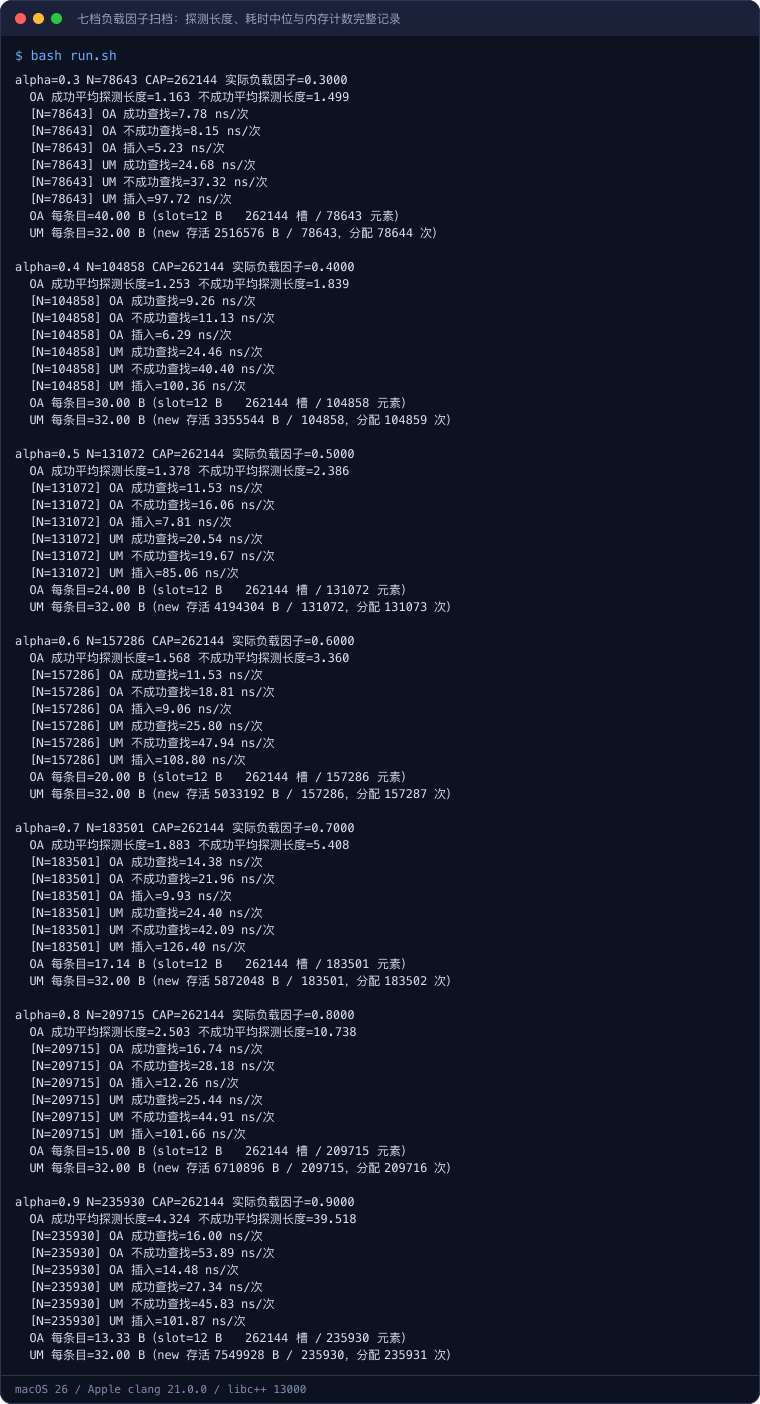
左面板读出线性探测最著名的形状。成功查找的平均探测长度从 0.3 档的 1.163 温和爬升到 0.8 档的 2.503,0.9 档跳到 4.324;不成功查找陡峭得多,从 1.499 一路涨到 0.8 档的 10.738,0.9 档直接爆到 39.518——是 0.3 档的 26 倍。原因在第一节已经埋下:不成功查找必须走到第一个空槽,而 0.9 负载下空槽只占 10%,又被聚集效应连成大簇,一次 miss 平均要穿过近 40 个槽。教科书给出的均匀散列近似公式(成功约 0.5·(1+1/(1−α))、不成功约 1/(1−α),0.9 档分别预测 5.5 与 10)甚至偏乐观,实测的聚集惩罚比理论值更重。
右面板把探测长度翻译成耗时。开寻址成功查找始终最快,从 7.41 ns 缓涨到 16.14 ns,约 2.2 倍;开寻址不成功查找从 7.51 ns 飙到 53.25 ns,约 7 倍。unordered_map 的两条虚线对负载因子基本不敏感,成功查找在 18 到 28 ns 间波动,不成功查找维持在 37 到 46 ns——开链的桶链表长度本就不随开寻址那张数组的拥挤度变化。两条不成功查找曲线在 0.8 到 0.9 之间交叉:0.8 档开寻址 27.70 ns 仍明显领先,0.9 档 53.25 ns 已反超开链的 46.29 ns。成功查找则到 0.9 档仍是开寻址赢(16.14 对 28.04 ns)。
| 负载因子 | OA 成功探测 | OA 不成功探测 | OA 成功(ns) | OA 不成功(ns) | UM 成功(ns) | UM 不成功(ns) |
|---|---|---|---|---|---|---|
| 0.3 | 1.163 | 1.499 | 7.41 | 7.51 | 24.46 | 37.64 |
| 0.4 | 1.253 | 1.839 | 9.02 | 10.88 | 23.59 | 37.72 |
| 0.5 | 1.378 | 2.386 | 9.59 | 14.42 | 18.53 | 18.82 |
| 0.6 | 1.568 | 3.360 | 11.29 | 18.22 | 24.94 | 40.71 |
| 0.7 | 1.883 | 5.408 | 14.38 | 22.27 | 24.73 | 41.67 |
| 0.8 | 2.503 | 10.738 | 16.27 | 27.70 | 25.75 | 44.91 |
| 0.9 | 4.324 | 39.518 | 16.14 | 53.25 | 28.04 | 46.29 |
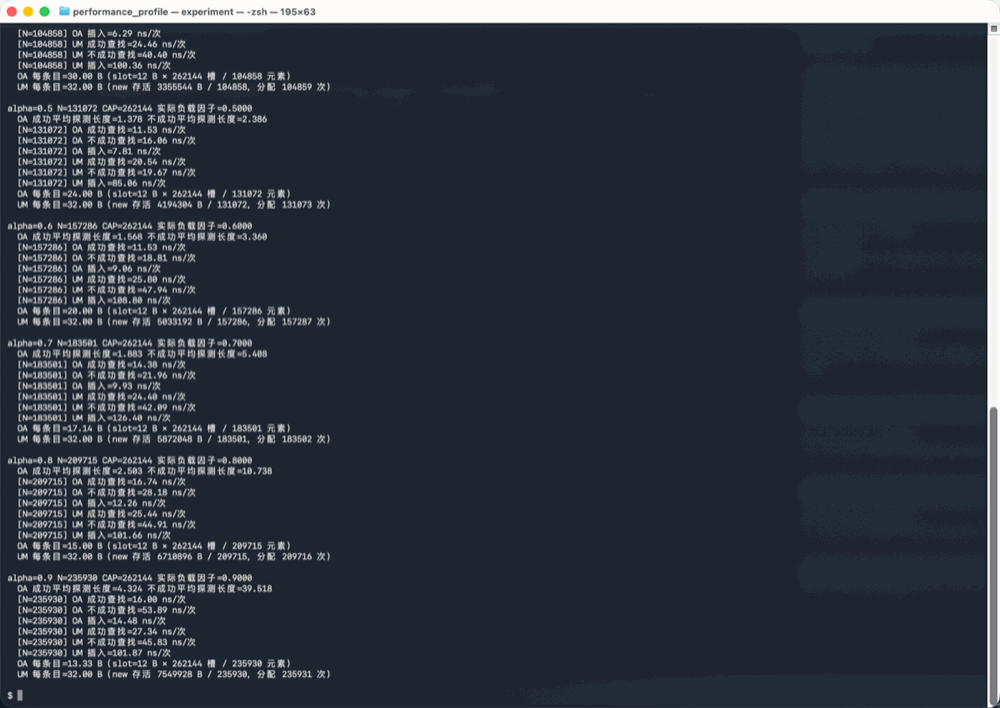
完整记录如下,含七档探测长度、六组耗时、每条目内存计数、O2/O0 各 7 轮中位与重载符号证据,所有数字都能按 alpha= 与 N= 标签在记录里定位。
五、插入成本、内存账与 O0 对照
插入环节的差距比查找更悬殊。O2 中位下,开寻址表的单元素插入从 0.3 档的 5.20 ns 随簇变长缓涨到 0.9 档的 14.56 ns;unordered_map 全程在 72 到 102 ns 之间,约为前者的 7 到 17 倍。差距来自两个结构性动作:开链表每个元素一次独立 operator new,日志里 0.9 档记录了 235931 次分配,而开寻址表整张数组只分配一次,插入只是写一个连续槽位。这个对比与上一篇里「连续内存的批量构造比逐节点堆分配便宜一个数量级」是同一条规律。
内存账则提醒我们开寻址不是免费午餐。槽结构是两个 int 加一个 bool,对齐后实测 sizeof(Slot) 为 12 字节;数组按容量而非元素数分配,折算到每条目后随负载因子下降快速恶化。
| 负载因子 | OA 每条目 | UM 每条目 | 谁省内存 |
|---|---|---|---|
| 0.3 | 40.00 B | 32 B | 开链 |
| 0.4 | 30.00 B | 32 B | 基本打平 |
| 0.5 | 24.00 B | 32 B | 开寻址 |
| 0.7 | 17.14 B | 32 B | 开寻址 |
| 0.9 | 13.33 B | 32 B | 开寻址(约 2.4 倍) |
开寻址的内存优势要到 0.4 以上才兑现,0.3 档反而比开链更费——稀疏的大数组里躺着 70% 的空槽。unordered_map 的 32 B/条目高度稳定,对应每个节点的 key/value/next 加分配器元数据,桶数组占比小到被均值吸收。换句话说,开寻址表用「按容量预分配」换无指针布局,负载因子同时是它的性能旋钮和内存旋钮,两个方向的拉力决定了合理工作区间。
关掉优化重跑,结论不仅没变反而更尖锐。O0 下开寻址不成功查找在 0.9 档达到 186.14 ns,是同档开链 169.66 ns 的约 1.1 倍,而 0.3 档只有 33.01 对 133.67 ns——探测链爆炸是真实的指令步数问题,不靠优化器施舍;同时开寻址在低负载档的领先优势在 O0 下扩大到 4 倍以上,因为连续数组访问省掉的间接跳转在无内联时权重更高。
六、工程纪律:把负载因子当成硬契约
把七档数据收敛成四条可执行的写法纪律。
第一,线性探测表的负载因子红线画在 0.7,极限不超过 0.8。0.7 是曲线上最后一个舒服点:不成功探测长度 5.4、不成功查找 22 ns 仍只有开链的一半左右,每条目内存 17 B。0.8 开始进入陡升段,0.9 的 miss 探测长度 39.5、耗时反超开链,已经没有开寻址的性价比。主流 flat hash map 的默认 max_load_factor 普遍设在 0.7 到 0.875 之间,与这组实测互相印证。
第二,插入前按预估元素数反推容量并一次性分配。开寻址表扩容意味着分配新数组加全量 rehash,成本远高于开链表的加桶;已知规模时按 N / 0.7 向上取 2 的幂预留容量,把扩容挡在热路径之外。这条与用 unordered_map 时先 reserve 是同一个纪律,只是开寻址违反它的代价更大。
第三,按删除模式选删除策略。删除罕见、能接受周期性重建的场景用墓碑法,实现简单;要求长期延迟稳定、删除持续发生的表选 backward-shift,用删除时的沿簇扫描换永不累积的墓碑。无论哪种策略,都要像本篇的自检那样,用「删除后存活键全命中、已删键全未命中」的回归测试锁住探测链完整性。
第四,不要把开寻址当成所有场景的默认答案。key 分布不可控、无法保证负载因子上限、或表极大而内存敏感到无法预留容量时,开链表对负载不敏感的特性反而是保护。选型前先用真实 key 分布在本机扫档——本篇所有数字都是 Apple clang、libc++ 与当前微架构上 int key 的结果,换 key 类型(尤其昂贵的字符串 key)、换散列函数后曲线需要重测,方法与工程都可以直接复用。
实验环境
- 机器/系统:Mac mini(6 性能核 + 6 能效核)/ macOS 26.5.2
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),libc++ 13000;编译参数
-std=c++17 -Wall -Wextra,O2/O0 双档 - 日期:2026-11-12
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh两档各跑 7 次按行标签取中位,程序内部每档 3 次取最短;探测长度在表实现内直接计数,unordered_map存活字节通过重载operator new统计,nm固定重载符号证据
代码获取
完整可复现工程(线性探测加 backward-shift 删除的开寻址表、删除正确性自检、七档负载因子扫档、探测长度计数、operator new 内存计数、O2/O0 双目标与七轮中位编排)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-open-addressing-hash-table
- 复现方式:克隆后进入该目录执行
bash run.sh,约两分钟输出七档探测长度、耗时中位与每条目内存;换平台、换标准库或换 key 类型后需要重新实测,不要直接沿用本篇的拐点数字。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的容器与内存分组。unordered_map 与排序 vector 查找选型是同系列上一篇,沿元素量级轴选容器,本篇沿负载因子轴深入哈希表内部机制;std::function 堆分配阈值实测提供了本篇复用的 operator new 计数法。机理层面,连续数组的缓存优势见缓存友好代码,工作集与缓存层级的关系见工作集足迹,结构体字段对齐如何把 9 字节撑成 12 字节则可对照AoS 与 SoA 数据布局。
总结
在固定 262144 槽、负载因子 0.3 到 0.9 七档扫档的实测中,手写线性探测开寻址哈希表与 libc++ 开链 std::unordered_map 的分工被数据清晰切开。开寻址的平均成功探测长度从 1.163 缓涨到 4.324,不成功探测长度从 1.499 爆炸到 39.518,聚集效应让 0.9 档的实测惩罚比均匀散列理论值更重;耗时上开寻址成功查找全程领先(7.41 到 16.14 ns),不成功查找在 0.8 到 0.9 之间被开链反超(53.25 对 46.29 ns),插入则因省掉逐节点堆分配便宜约 7 到 17 倍。内存是开寻址的另一张面孔:每条目字节从 0.3 档的 40 B 降到 0.9 档的 13.33 B,对开链稳定的 32 B,内存优势要到 0.4 档以上才兑现。工程上守住负载因子 0.7 红线、插入前按预估规模预留容量、按删除模式在墓碑与 backward-shift 间取舍、key 分布不可控时不默认开寻址这四条纪律,即可把开寻址表的连续内存红利吃满而避开探测链爆炸的陡升段。