string SSO、移动成本与 string_view:字符串传参的去拷贝边界实测
编译优化系列的第八篇。上一篇用分配计数法量出了 std::function 的小对象缓冲阈值,本篇把同一套方法搬到 std::string 身上。字符串是 C++ 程序里出现频率最高的动态对象,而现代标准库几乎都为短串内置了短字符串优化(Small String Optimization,下称 SSO):短到一定程度的字符串直接活在对象内部,构造、拷贝、移动都不碰堆。这条边界划在哪里、越过边界之后传值传引用差多少、string_view 到底省掉了什么,本篇用长度扫档、三接口对照与移动拆解三组实验逐一量化。入门篇 std::string_view:不拥有的字符串视图讲语义与悬垂陷阱,本篇补的是成本数字。
本文要回答的问题
- 本平台
std::string的 SSO 容量是多少字符,多长的字符串会触发第一次堆分配? - 按值、按 const 引用、按
string_view传字符串,分配次数和调用耗时各是多少? - 同样是移动构造,SSO 串和堆串的底层动作有什么本质差别?
string_view与 const 引用实测同速时,它不可替代的价值到底在哪里?- 工程里字符串参数与返回值应该怎样选传递方式?
一、SSO 的存储结构与判定方法
64 位平台上本平台的 std::string 对象本身只有 24 字节,与一个指针加两个长度字段相当。它内部是一个联合体:字符串够短时,字符直接存进这 24 字节里的内嵌缓冲;字符串变长,这块存储就让给堆指针,字符搬到 operator new 出来的内存里。判定标准对字符串对象是透明的,拷贝一个 SSO 串等价于 memcpy 一小段固定缓冲,拷贝一个堆串则要再申请一块内存、复制全部字符。
测量方法与上一篇完全同构:重载全局 operator new/operator delete(含对齐版六个函数),用开关只在测量段计数,先构造一串长度从 0 逐档递增到 32 的字符串,每档记录构造加析构期间的分配次数与字节数。阈值附近不做跳跃式取点,逐字符扫档才能把边界精确到某一个字符。
先用一张对比卡把三种传递方式的所有权语义与分配行为摆在一起,后面的实验逐格验证。
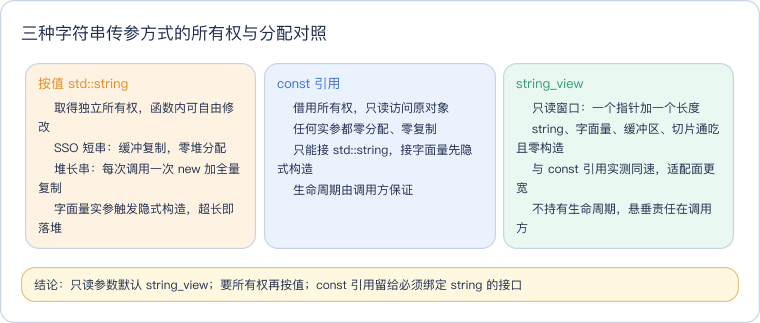
三种方式不是简单的优劣排序,而是所有权语义的取舍:按值买到独立生命周期,引用与视图用生命周期约束换来零拷贝。
二、长度扫档:22 字符是分水岭
扫档结果非常干净:长度 0 到 22 的字符串构造分配次数全程为零,长度 23 第一次出现一次 operator new,申请 26 字节;之后随着容量增长,堆块按 32、40 字节分级扩大。24 字节的对象里要放 22 个字符、一个结尾 NUL 和长度/标志位,这就是 22 这个数字的来源——它不是标准规定,而是 libc++ 在 64 位平台的具体布局,换一套标准库或 32 位平台可能是 15 或其他值。
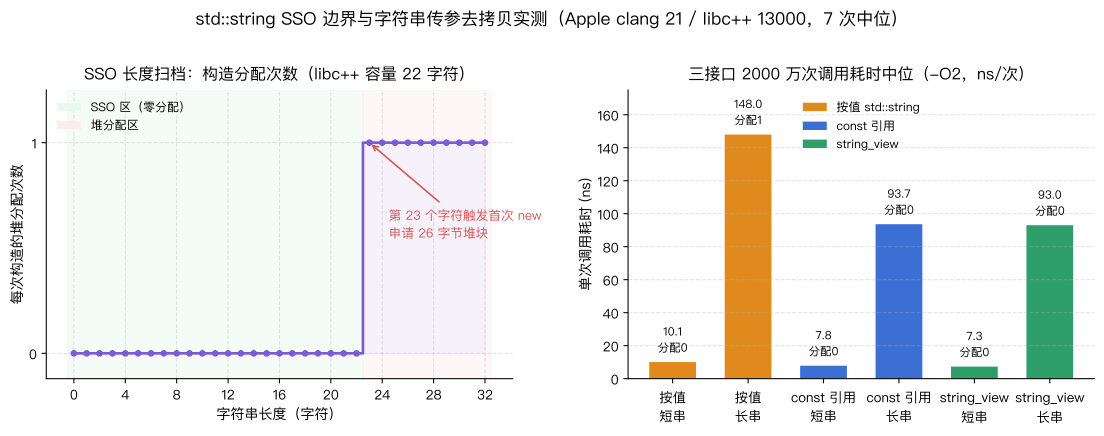
左面板的阶跃发生在第 23 个字符处,与上一篇里 std::function 的 24 字节阶跃形态一致:小对象优化的成本曲线不是渐变而是突变,边界两侧是两个完全不同的存储世界。这也解释了为什么日志级别、短 key、短标签这类天然短小的字符串在现代标准库上几乎没有分配压力——它们绝大多数终身待在 SSO 区。
三、三种接口的分配计数与调用耗时
同一个对字符串逐字符求哈希的处理逻辑,分别写成按值、按 const 引用、按 string_view 三个 noinline 函数,用三种实参调用:12 字符的 SSO 短串、120 字符的堆长串、36 字符的字符串字面量。先数 10 万次调用里的分配,再跑 2000 万次测耗时,实参在四个等价串间轮转以防结果被提到循环外。
| 接口与实参 | 10 万次调用分配 | 每次调用分配 | O2 耗时中位(ns/次) | O0 耗时中位(ns/次) |
|---|---|---|---|---|
| 按值传 SSO 短串 | 0 | 0 | 10.07 | 203.83 |
| 按值传堆长串 | 100000 | 1 | 148.55 | 1382.44 |
| const 引用传短串 | 0 | 0 | 7.80 | 196.13 |
| const 引用传长串 | 0 | 0 | 93.55 | 1282.57 |
| string_view 传短串 | 0 | 0 | 7.30 | 37.18 |
| string_view 传长串 | 0 | 0 | 93.03 | 282.82 |
按值传超长字面量的分配行为与按值传堆长串相同:10 万次调用 10 万次分配,字面量先隐式构造出堆上的 std::string,再进入按值形参。
这张表读出三层结论。第一层,按值传参的分配行为完全取决于实参落在哪个存储区:短串走 SSO,按值也不分配,O2 下 10.07 ns 与引用形态只差约两纳秒;长串按值等于强制一次深拷贝,148.55 ns 比 const 引用的 93.55 ns 贵出约 59%,差价正是一次 new 加 120 字节复制。「按值一定慢」是错误心智模型,「按值长串一定贵」才是。第二层,const 引用与 string_view 在实参本来就是 std::string 时 O2 实测同速(短串 7.80 对 7.30,长串 93.55 对 93.03)——两者都只是借一个只读窗口,差异不在性能而在能接什么。第三层正是 string_view 的独有价值:面对字符串字面量、字符数组缓冲区、子串切片这类「不是 string 的字符序列」,const 引用会触发一次隐式 std::string 构造(超长时还带堆分配),string_view 只装一个指针加长度,零构造零分配。
O0 档把内联的遮羞布掀开后,视图的结构性优势更明显:短串场景 string_view 37.18 ns 对 const 引用 196.13 ns、长串 282.82 对 1282.57 ns,长串差距约 4.5 倍、短串更拉到 5.3 倍。没有内联时,const 引用路径仍要走进 string 的成员函数与尺寸检查,而视图就是裸指针加长度上的直接循环。部署构建普遍开 O2,这个倍数不会原样出现,但它说明视图的便宜不是优化器施舍,而是类型设计本身带来的。
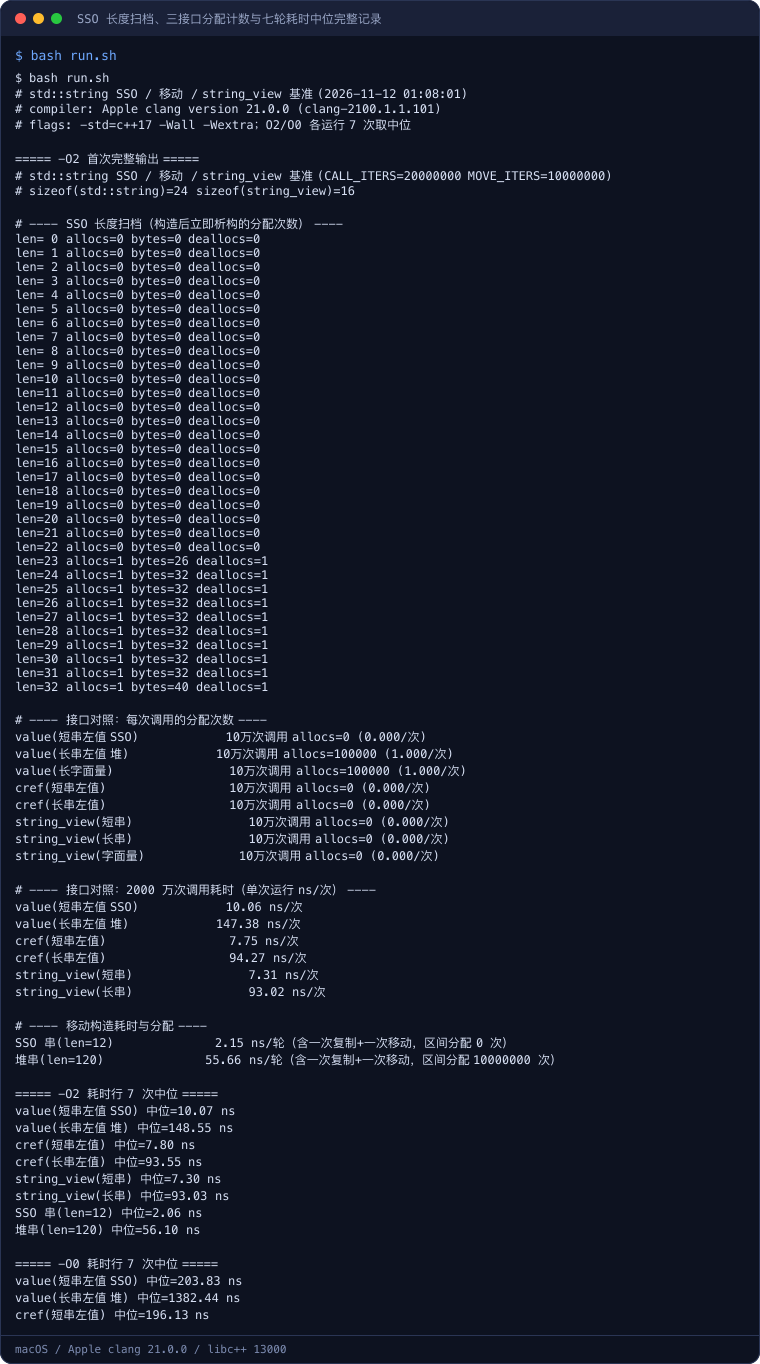
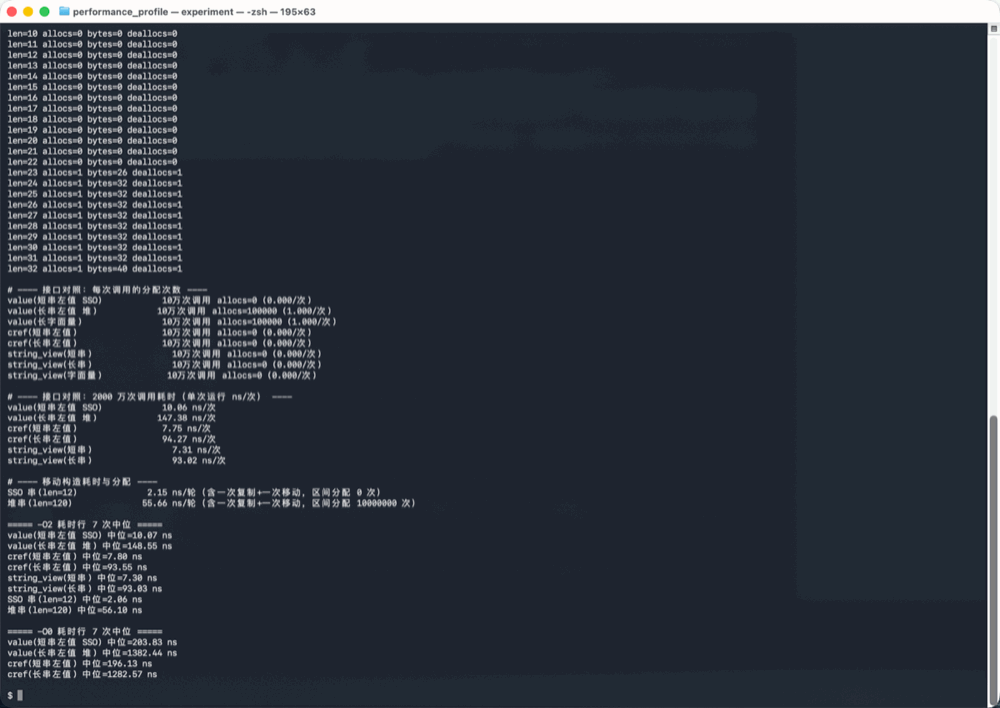
完整实测记录如下,含长度扫档、分配计数、七轮中位与二进制符号证据。
四、移动构造:堆串偷指针,SSO 串搬字节
移动语义的承诺是「廉价地转移资源」,但对字符串要分两种形态看。实验对 SSO 串与堆串各做千万轮「先复制一个独立对象、再移动构造新串」,计数区间内的分配。
堆串的移动名副其实:源对象持有堆指针,移动构造只是把指针、长度、容量三个字段抄给目标、源对象置空,没有新分配;区间内的全部分配都来自移动前那次复制,移动本身零成本。SSO 串没有堆指针可偷——字符就在对象自己的 24 字节里,移动构造只能把这段缓冲整体复制过去,动作上和一次小 memcpy 无异,同样零分配,但严格说它不是「偷」而是「搬」。
这带来一个反直觉的推论:对 SSO 串,移动并不比拷贝快多少,两者都是一次定长缓冲复制;移动的压倒性优势只在堆形态上兑现。写模板代码时假定「移动必然 O(1)」是危险的,字符串这类带 SBO 的类型,移动成本天然是有上下限的区间而不是一个点。
下图把两种形态的移动动作并排画出,蓝色是对象本身,橙色是移动构造这个动作,绿色与红色标出「复制出来的新数据」与「被共享的旧堆块」。
读图抓住一个对称:两条路径都零新增分配,但上路径复制的是数据本身、下路径复制的只是地址。堆串移动后源对象变空、堆块所有权移交,没有第二个对象同时持有字符,因此不需要引用计数,也没有共享可变状态。
# 移动构造区间分配计数与七轮中位(每轮含一次复制 + 一次移动)
SSO 串(len=12)  区间分配 0 次:复制与移动都在缓冲内完成;O2 中位 2.06 ns/轮,O0 30.44 ns/轮
堆串(len=120)  区间分配 10000000 次:全部来自复制,移动本身零分配;O2 中位 56.10 ns/轮,O0 86.98 ns/轮
注意堆串那 56 ns 的构成:复制 120 字符要申请堆块并搬运内容,移动只偷三个字段,千万轮里的 1000 万次分配全部记在复制头上。换句话说,一旦上游能把复制也消除掉(比如从右值直接构造、用移动语义传递函数返回值),剩下的移动动作与 SSO 形态一样廉价。
五、选型纪律与悬垂边界
把三组实验收敛成四条工程纪律。
第一,字符串只读参数默认 std::string_view,需要所有权或就地修改时才退回 const 引用与按值。string_view 能无差别接 string、字面量、缓冲区与切片,且零分配;但它不持有生命周期,存入成员变量、跨异步边界持有、返回局部串的视图都是悬垂高发区,这类场景必须取得所有权(按值 string)。语义边界与入门篇讲的悬垂陷阱同一条线。
第二,短串按值不必恐慌。日志、短 key、枚举名这类已知短小的字符串,按值传参在 SSO 区内零分配,还能换来说明所有权清晰、线程安全的接口;性能关键路径上的长串才需要严守引用或视图。
第三,返回字符串优先按值返回,依赖 RVO/NRVO 与移动,不要为了「避免拷贝」返回引用或视图指向局部对象。RVO 与移动语义实测已经量过,纯右值返回在 C++17 下保证复制消除;堆串返回最差也是一次指针搬运。
第四,需要大量拼接、切分的热路径考虑预留容量与结构化类型。反复拼接跨越 SSO 边界会触发多次重新分配,reserve 一次性给足容量;频繁切子串优先 string_view 切片,避免每个子串都构造独立 string。
实验环境
- 机器/系统:Mac mini(6 性能核 + 6 能效核)/ macOS 26
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),libc++ 13000;编译参数
-std=c++17 -Wall -Wextra,O2/O0 双档 - 日期:2026-11-12
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh两档各跑 7 次按标签取耗时中位 → 同一脚本用nm/otool -tvV固定 operator new 重载符号与 malloc 调用点
代码获取
完整可复现工程(长度扫档、三接口分配计数与千万轮计时、移动构造拆解、普通版与对齐版 operator new/delete 全套重载、O2/O0 双目标)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-string-sso-move-string-view
- 复现方式:克隆后进入该目录执行
bash run.sh;其他标准库平台的 SSO 容量与耗时需重新实测,不要沿用本篇的 22 字符结论。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的值语义与内存管理分组。std::function 堆分配阈值与本篇构成「小对象优化」姊妹篇,分别量类型擦除容器与字符串的缓冲边界;RVO 与移动语义实测给出返回值与移动的编译器行为,shared_ptr 引用计数争用覆盖共享所有权的多线程成本。语言语义层面的 string_view 用法与悬垂规则见入门篇。
总结
在重载 operator new 的三组基准上,本平台 libc++ 的 std::string SSO 边界被精确定位为 22 字符:24 字节对象内放下 22 个字符加 NUL 与元数据,0–22 字符构造零堆分配,第 23 个字符触发第一次 new(26 字节块)并随容量分级增长。接口对照表明按值传参的成本由实参存储区决定——SSO 短串按值也零分配,堆长串按值每次一次 new 加全量复制、实测约 149 ns,而 const 引用与 string_view 对任何实参都零分配且同速;string_view 不可替代的价值是无构造接字面量、缓冲区与切片,代价是生命周期责任留给调用方。移动构造在两种形态下都不产生新分配,但堆串移动是偷指针、SSO 串移动是搬缓冲字节,后者相对拷贝并无优势。只读参数默认视图、长串严守引用、按值返回依赖消除与移动、热路径预留容量,是这组数据支持的四条传参纪律。