PGO 剖面引导优化:插桩训练到二次编译的两阶段实测
编译优化系列的第二篇。上一篇 LTO 链接时优化的三档实测 里,编译器在链接期拿到了全程序视角,但它仍然不知道哪些分支会被频繁执行、哪些函数才是热函数。PGO(Profile-Guided Optimization,剖面引导优化)补上的正是这块运行期信息:先编译一个插桩版本跑训练负载,再把真实执行剖面喂回编译器做第二次构建。本篇用一个分支密集的决策树基准,量化两阶段流程到底带来多少增益,以及训练负载和真实流量错位时收益还剩多少。
本文要回答的问题
- PGO 的「插桩 → 训练 → 重建」两阶段流程,每个阶段具体产出什么?
- 没有运行剖面时,编译器对分支布局只能做什么假设?
- 训练负载与评估负载同分布、错位分布,两种情况下增益差距有多大?
- 反汇编里能看到 PGO 改变了哪些指令布局?
- Apple clang 的 PGO 代码生成有什么实测踩坑,怎样规避?
一、两阶段流程:同一份代码编译三次
普通优化只靠源码里的静态信息,PGO 则要求同一份代码经历三次编译、一次训练运行,流程如下图。
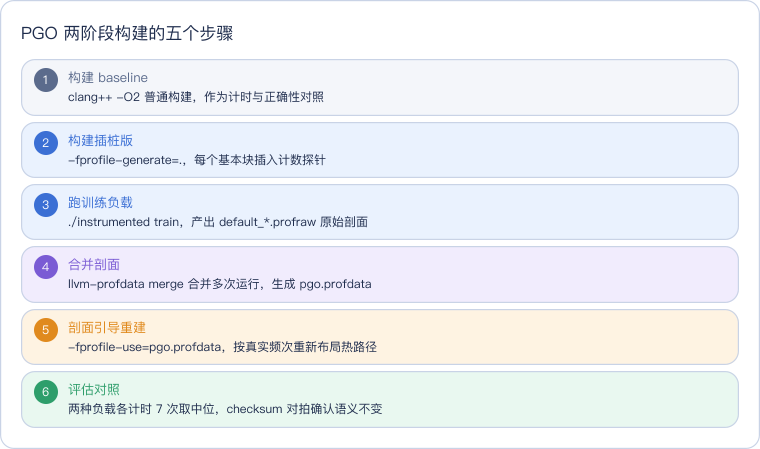
读这张卡抓住两条线:明线是三次编译的产物依次是普通二进制、插桩二进制、PGO 二进制;暗线是信息流向——训练负载的分支命中情况经 .profraw、.profdata 两个中间文件回流到编译器,第二次构建时编译器第一次知道「这个分支 90% 的时候走哪边」。
插桩二进制会在每个基本块入口埋计数探针,执行开销明显高于普通版本,因此它只用于采剖面、绝不能上线;llvm-profdata merge 负责把一次或多次训练运行的原始剖面合并、去重并做结构化摘要,得到编译器可直接消费的 .profdata。Clang 与 GCC 的流程完全同构,只是 GCC 的工具叫 gcov/profdata 配套链、文件后缀不同。
二、基准设计:分支密集决策树与两种评估负载
PGO 的主要用武之地是分支密集代码,所以基准核心是一个跨翻译单元的八级决策树 classify:输入 0..255 的键,经多层 if 判定返回 1..10 档分类,3000 万次调用构成稳定的计时负载。
int classify(long key) {
    int level = 0;
    if (key < 128) {
        if (key < 64) {
            level = 1;
            if (key < 32) level = 0;
        } else {
            level = 2;
            if (key < 96) level = 3;
        }
    } else {
        if (key < 192) {
            level = 4;
            if (key < 160) level = 5;
        } else {
            level = 6;
            if (key < 230) {
                level = 7;              // 热子树的最深档
                if (key < 210) level = 8;
            } else {
                level = 9;              // 冷尾档
            }
        }
    }
    return level + 1;
}
驱动程序用确定性 LCG(线性同余生成器)产生三种负载,三者共用同一条随机数序列、只改变映射方式,保证三版二进制输入逐次相同、checksum 可对拍:
train:偏斜分布,约 90% 的键落在热子树 192..229,是采剖面用的训练负载;matched:与训练同分布,量的是剖面贴合真实流量时的完整收益;uniform:键在 0..255 均匀分布,刻意制造训练/评估错位,量剖面失真后还剩多少收益。
没有剖面时,编译器只能按源码顺序排布基本块;PGO 重建后,热子树的判定链被布成 fall-through 直通(顺序执行、不跳转),冷尾路径挪到函数尾部。现代 CPU 的前端取指与静态预测器都 favor 顺序路径,分支方向上的布局差异会直接换算成流水线效率。下图对照两种布局。
图中红色是普通构建里冷热交错、热路径被迫反复跳转的布局,绿色是 PGO 后的热路径直通段,紫色冷块被集中挪走。判断 PGO 是否真的生效,看的就是热路径上条件跳转的方向与基本块的物理顺序,而不是只看编译日志。
三、两负载实测数据
实验在本机用 Apple clang 21.0.0 完成,统一 -O2 -std=c++17 -Wall,每种负载先预热 1 次、再计时 7 次取中位;同负载下 baseline 与 PGO 的 checksum 必须完全一致,先证明优化只改布局不改结果。
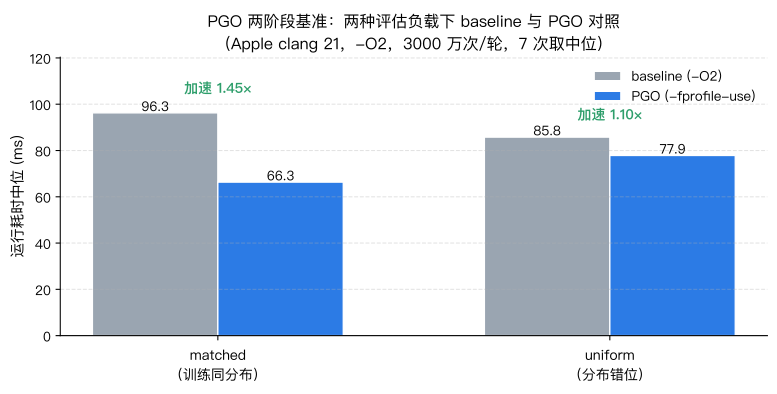
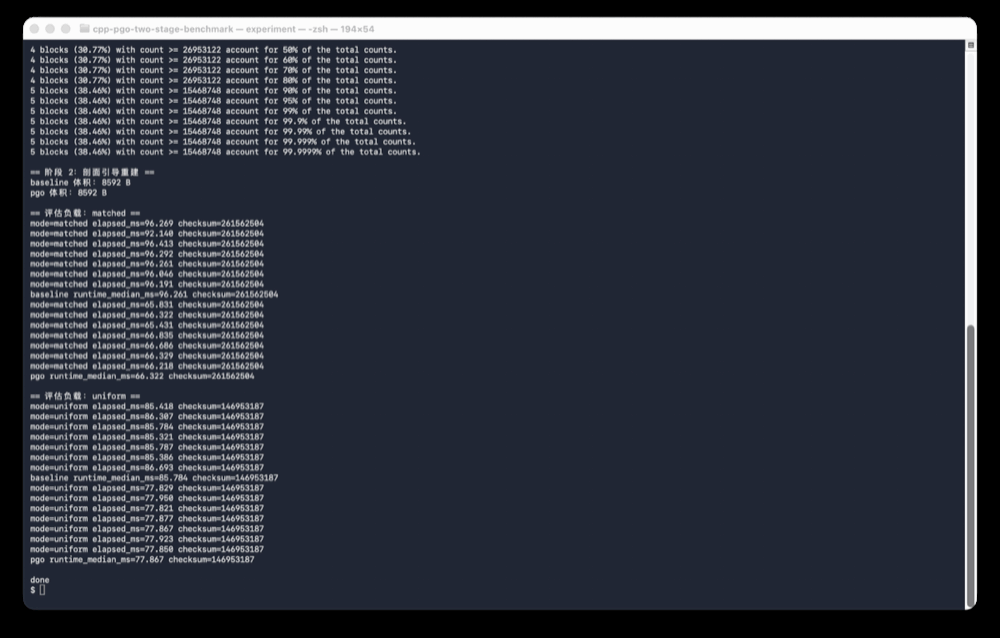
这张图的两组柱子要对照着读:matched 负载下 96.3 ms 对 66.3 ms,PGO 拿到约 1.45 倍加速;uniform 负载下差距收窄到 85.8 ms 对 77.9 ms,加速约 1.10 倍。两者体积都是 8592 B——本例 PGO 只重排基本块、调整分支方向,没有内联展开带来的体积膨胀。
| 评估负载 | baseline 中位 | PGO 中位 | 加速比 | checksum |
|---|---|---|---|---|
| matched(训练同分布) | 96.261 ms | 66.322 ms | 1.45× | 261562504(两版一致) |
| uniform(分布错位) | 85.784 ms | 77.867 ms | 1.10× | 146953187(两版一致) |
完整原始输出如下,含插桩训练、剖面摘要与两种负载各 7 个计时样本。
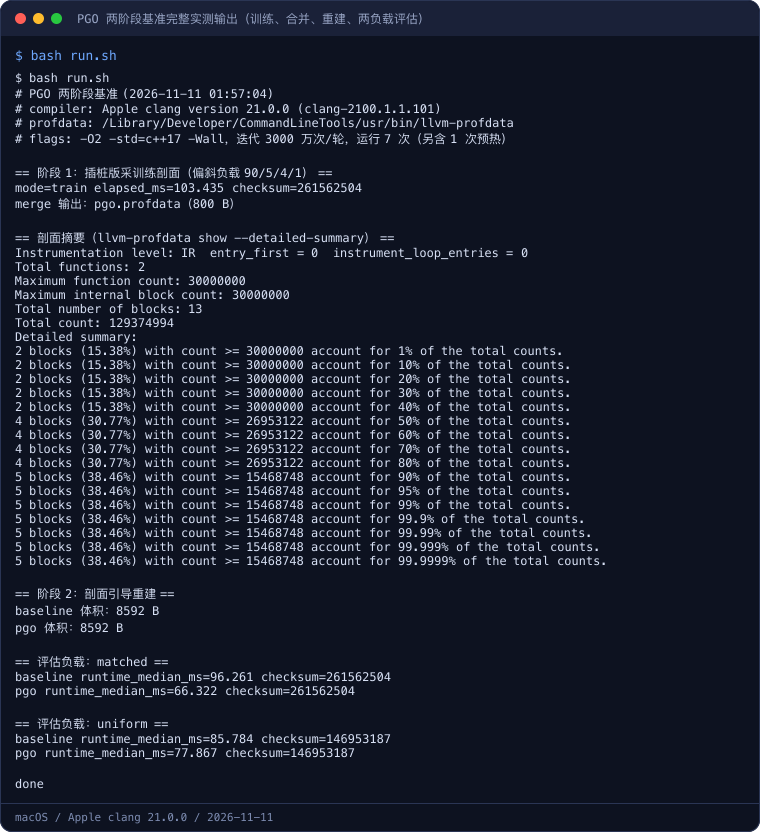
剖面摘要里有一个值得注意的数字:约 31% 的基本块承载了 80% 的执行计数,偏斜程度足够大,这是 PGO 能显著获益的前提——如果负载天然均匀、各分支五五开,编译器再怎么重排也没有「热路径」可布。uniform 下仍有 1.10 倍 residual 收益,是因为决策树前几级的大方向(键落在 0..127 还是 128..255)在两种分布下判断一致,这部分布局引导没有失效。
四、反汇编证据与一个真实的退化坑
数据回答「快了多少」,反汇编回答「为什么快」。对比两版 classify 的入口:baseline 第一条判定 cmpq $0x7f 后向高处跳(jg),热子树在远处;PGO 版同一条判定改成向低处跳(jle),高键位的热子树变成不跳转的顺序路径,函数入口地址也从 0x5e0 提前到 0x500,热函数在文本段内被整体前置。
===== baseline classify 入口(热路径在跳转目标处) =====
00000001000005e4  cmpq  $0x7f, %rdi
00000001000005e8  jg    0x1000005fb        # 热子树在远处,跳转才能到达

===== PGO classify 入口(热路径 fall-through 直通) =====
0000000100000504  cmpq  $0x7f, %rdi
0000000100000508  jle   0x100000533        # 冷分支跳走,热路径顺序执行
000000010000050a  cmpq  $0xbf, %rdi
排查过程中还踩到一个 Apple clang 21.0.0 的代码生成退化:基准早期版本在热循环里用非常数取模做桶位映射(seed % 100、seed % 38),PGO 版反而比 baseline 慢了五成。反汇编对照发现,同一处取模 baseline 编译成 magic 乘法序列(无除法),PGO 版却生成了硬件整数除法。
--- baseline 取模片段(magic 乘法,无 div) ---
00000001000004d9  shrq  $0x24, %rdi
00000001000004dd  imull $0x26, %edi, %edi
00000001000004e0  subl  %edi, %edx
--- pgo 取模片段(硬件 divl) ---
00000001000004d2  xorl  %edx, %edx
00000001000004d4  divl  %r8d
divl 在 x86-64 上是十几到几十个周期的长延迟指令,3000 万次循环足以吞掉全部布局收益。最终把热路径映射统一改成 2 的幂位运算(seed & 255、192 + (seed & 31)),两版热循环的整数除法计数都归零,才得到第三节的稳定数据。这个坑的工程含义是:PGO 不是无条件受益的黑盒,接入后必须保留反汇编或周期计数这一层核对手段,重点检查热循环里有没有新出现的长指令。本机没有 Linux perf 一类工具,分支频次证据由 llvm-profdata show --detailed-summary 的基本块计数承担,指令布局证据由 otool -tvV 承担。
五、工程接入建议
| 场景 | 建议 | 理由 |
|---|---|---|
| 分支密集的发布版二进制(解析器、路由、分类逻辑) | 接入 PGO | 本例同分布下 1.45 倍收益,且不增加产物体积 |
| 训练负载无法代表生产流量 | 暂缓或定期重采剖面 | 分布错位后收益降到 1.10 倍,失真严重时可能误导布局 |
| CI 资源紧张的小项目 | 先上 LTO/ThinLTO | PGO 要求三次编译与训练编排,工程成本高于单纯加 flag |
| 热循环含非常数取模 | 先改位掩码映射再开 PGO | 规避本系列实测到的 divl 退化 |
| 需要持续剖面的大型服务 | 用 AutoFDO/AutoPGO 采样式剖面 | 生产环境采样替代离线训练,无需插桩版上线 |
两点收尾。其一,剖面会随代码演进而过期,源码改动后旧 .profdata 仍能编译但引导质量会悄悄漂移,工程上应把训练与采剖面接进发布流水线、每个大版本重采,而不是一次生成长期复用。其二,PGO 与 LTO 正交且可叠加:LTO 扩大优化视野,PGO 提供频次信息,上一篇 LTO 实测结尾提到的「LTO 不敢去虚化的虚调用」,在剖面给出类型频次后也可能被击穿,这正是本系列下一篇虚函数去虚化条件实测要验证的内容。
实验环境
- 机器/系统:Mac mini(x86_64)/ macOS 26
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),
llvm-profdata经xcrun调用,编译参数-O2 -std=c++17 -Wall - 日期:2026-11-11
- 完整命令:
make bin/baseline bin/instrumented→./bin/instrumented train采剖面 →xcrun llvm-profdata merge -output=pgo.profdata default_*.profraw→make bin/pgo重建 →bash run.sh两负载各预热 1 次、计时 7 次取中位 →otool -tvV采集反汇编证据
代码获取
完整可复现工程(源码、Makefile、run.sh 编排脚本与实测 results.txt)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-pgo-two-stage-benchmark
- 复现方式:克隆后进入该目录执行
bash run.sh,约一分钟完成插桩、训练、剖面合并、PGO 重建与两负载对照计时;也可按 README 的分阶段命令手动执行每一步。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的编译优化分组,与 LTO 三档实测 构成构建期优化的上下篇:LTO 解决「看不清跨模块代码」,PGO 解决「不知道哪条路径热」。向上承接低延迟编程模式对热路径的讨论,后续同组会展开虚函数去虚化条件、异常机制开销的对照实测。
总结
PGO 用一次插桩训练把真实分支频次回流给编译器:在这个八级决策树基准上,训练同分布时运行耗时从 96.3 ms 降到 66.3 ms、约 1.45 倍加速,评估负载换成均匀分布、剖面错位后收益收窄到约 1.10 倍,两版 checksum 完全一致、体积不变;反汇编可见热路径从跳转到达改为 fall-through 直通,同时实测到 Apple clang 对热循环非常数取模退化为 divl 的坑,改用位掩码映射后规避——接入 PGO 的前提是训练负载长期代表生产流量,并保留反汇编层的核对手段。