虚函数去虚化条件:final、LTO 与 PGO 各自满足什么编译器才敢下手
编译优化系列的第三篇。LTO 三档实测留下一个悬案:8 个经基类指针发起的虚调用,在全量 LTO 与 ThinLTO 下一条都没被消除,间接调用指令原样保留。PGO 两阶段实测则展示了运行剖面怎样改变编译器的决策。本篇把问题收窄到一个具体机制——去虚化(devirtualization):把经虚表的间接调用改写成对具体函数的直接调用。常见说法是「加了 final 编译器就能去虚化」,本篇用五种信息量不同的调用形态和三档构建逐一验证,看这个说法在真实工具链上到底成不成立。
本文要回答的问题
- 一次虚调用在机器码层面贵在哪里,去虚化之后能省掉什么?
final类、可见的局部对象,为什么在-O2下仍然保留间接调用?- LTO 拥有全程序视角后,跨翻译单元工厂产生的对象会被去虚化吗?
- PGO 的「猜测性去虚化」在反汇编里长什么样,静态数间接调用条数为什么会漏判?
- 工程上想消除虚调用开销,有哪些按改造成本排序的手段?
一、虚调用的代价与去虚化的两个前提
经基类指针调用虚函数时,编译器不知道对象的真实类型,只能生成一套固定动作:从对象首地址加载虚表指针,按槽位偏移取出函数地址,再做间接跳转。下面是普通 -O2 构建里一个热循环的真实片段,每次迭代都要执行这套加载与间接调用。
===== none 版 heap_open 热循环(每轮一次虚表间接调用) =====
0000000100000640  movq  (%r14), %rcx          # 加载虚表指针
0000000100000643  movq  %r14, %rdi
0000000100000646  movq  %rax, %rsi
0000000100000649  callq *0x10(%rcx)           # 按虚表槽位间接调用
000000010000064f  jne   0x100000640           # 循环回边
间接调用的代价分两层。显性代价是两条额外加载和一次间接跳转本身;隐性代价更贵——现代 CPU 的间接分支预测器面对多变的目标地址会 mispredict,流水线冲刷一次就是十几个周期,而且编译器无法把一个看不清函数体的调用内联,循环展开、常量传播、指令调度全都到此为止。去虚化要成立,编译器必须拿到两类证据之一:要么静态证明对象的动态类型唯一(类型证明),要么运行剖面显示某个目标占绝对多数(频次证明)。
二、基准设计:五种形态 × 三档构建
基准核心是一个抽象基类和两个派生类:Derived 带 final、继承链封闭;OpenDerived 不加 final、理论上可在任意翻译单元继续派生。两者的虚函数体完全相同,都是一条乘加序列,保证差异只来自调用机制而非计算量。
struct Base {
    virtual ~Base() = default;
    virtual std::int64_t step(std::int64_t x) const = 0;
};

struct Derived final : Base {                    // 封闭类
    std::int64_t step(std::int64_t x) const override {
        return x * 1103515245LL + 12345LL;
    }
};

struct OpenDerived : Base {                     // 开放类
    std::int64_t step(std::int64_t x) const override {
        return x * 1103515245LL + 12345LL;
    }
};
五个形态各自独占一个 noinline 函数,各跑 1 亿次,函数间唯一的变量是编译器能观察到多少类型信息:
| 形态 | 代码要点 | 编译器可观察的类型信息 |
|---|---|---|
direct | 局部对象直接 d.step(x) | 静态分派,编译期已知,根本不经虚表 |
heap_open | new OpenDerived() 后经 Base* 调用 | 无 final,静态类型被指针擦除 |
heap_final | new Derived()(final)后经 Base* 调用 | 继承链封闭,理论上虚表唯一 |
visible_local | 局部 OpenDerived d; Base* p = &d; | 构造点就在本函数,动态类型可观察 |
cross_tu | 另一翻译单元的工厂返回 Base* | 单 TU 编译完全看不到真实构造点 |
三档构建分别是普通 -O2(none)、-O2 -flto(LTO)、LTO 加剖面引导(PGO,插桩训练后 -fprofile-use 重建)。每个形态在三档下输出的 checksum 完全一致,先保证语义等价再比较耗时。
基准设计有三个刻意之处。其一,五个形态函数都加 noinline,否则编译器可能把整个测量函数内联进 main 后与相邻代码联合优化,各形态的代码边界被打散,反汇编无从按函数核对;固定边界后,三档构建的差异才可以归因到调用机制本身。其二,虚函数体只放一条乘加且让结果在迭代间串行依赖,调用固定开销(虚表加载、间接跳转、阻止内联)在总耗时里占比才足够大;函数体一重,算术本身淹没调用差异,早期重函数版本各形态差距迅速缩到噪声内。其三,累积值最终作为 checksum 打印,给热循环一个可观测副作用,阻止编译器把整段判定为死代码删除——这也是所有计时基准都要遵守的纪律,否则可能测出一个被优化到空转的循环。
三、实测数据:三档构建各自改变了什么
实验在本机 Apple clang 21.0.0 完成,每档预热后计时 7 次取中位。纵轴用对数刻度,因为静态分派与虚调用之间差着两个数量级。
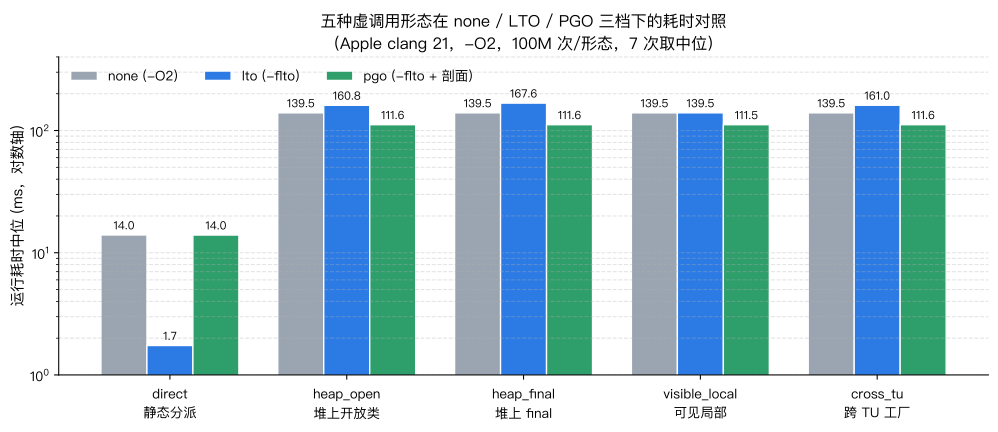
这张图先看最左一组:direct 在 none 与 PGO 档都是约 14 ms,LTO 档骤降到 1.74 ms——反汇编显示 LTO 把这个循环做了 64 倍展开,循环分支只剩 156 万次;PGO 的展开启发式反而只展开 8 倍,这是剖面引导并不保证每个函数都更快的真实例子,它优化的是剖面里的整体热点,不是单个紧循环的极限展开。
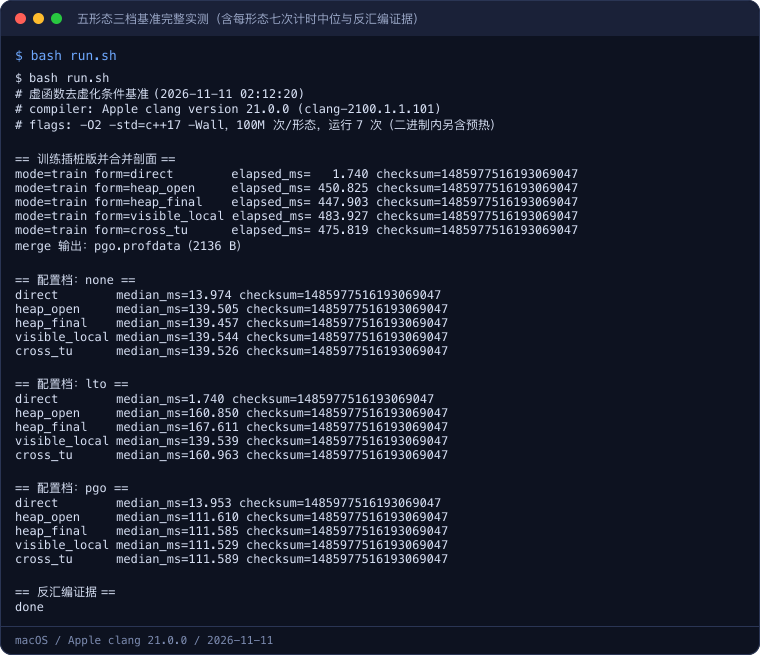
| 形态 | none (ms) | LTO (ms) | PGO (ms) | none 间接调用数 |
|---|---|---|---|---|
| direct | 13.974 | 1.740 | 13.953 | 0 |
| heap_open | 139.505 | 160.850 | 111.610 | 2 |
| heap_final | 139.457 | 167.611 | 111.585 | 2 |
| visible_local | 139.544 | 139.539 | 111.529 | 1 |
| cross_tu | 139.526 | 160.963 | 111.589 | 2 |
四个虚调用形态在 none 档齐刷刷约 140 ms,正好是 direct 的 10 倍,这就是「无法内联 + 每轮间接跳转」的综合税。LTO 档没有带来改善,部分形态还略慢;PGO 档四个形态统一降到约 111.6 ms,约 1.25 倍提升。完整原始输出如下。
四、反汇编证据:三个流行认知逐个核对
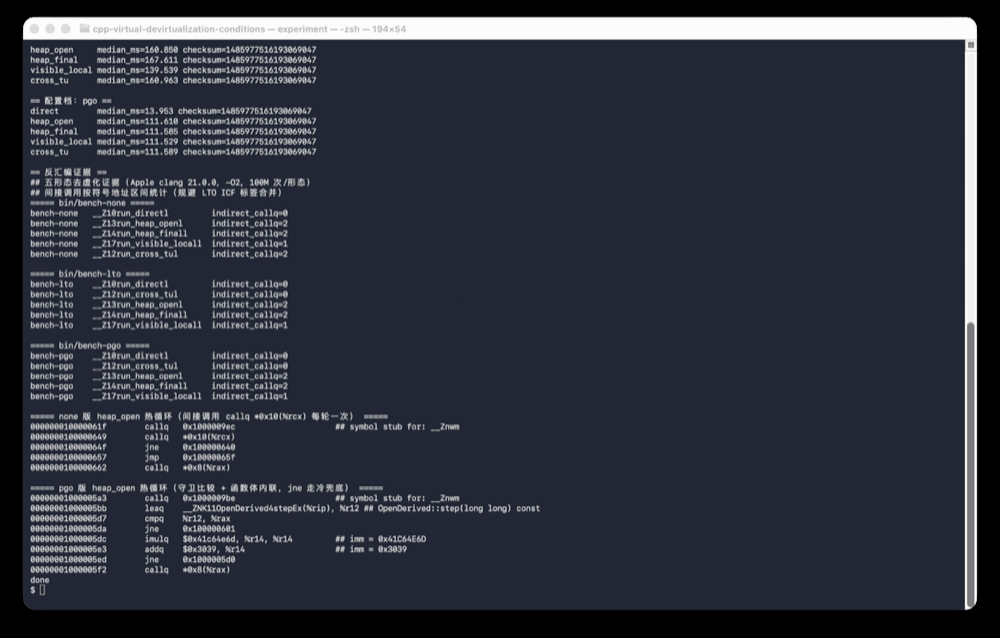
数据只能看到快慢,结论必须靠反汇编坐实。间接调用按 nm 给出的符号地址区间统计,而不是按符号标签截取——LTO 的相同代码折叠(ICF,Identical Code Folding)会把同构函数合并到同一地址、只保留一个标签,按标签统计会把别名函数误判成零间接调用,这是本次采集实际踩到的坑。
认知一:「加了 final 就会去虚化」——本例不成立。 none 档的统计里,heap_final 的间接调用数是 2,与开放类的 heap_open 完全相同;两个间接调用一个是热循环里的 step,另一个是 delete 时的 deleting destructor。final 在语言层面封闭了继承链,但 Apple clang 21 的 -O2 并没有仅凭这一点就把经指针的调用改写成直接调用。
===== none 档按符号地址区间统计的间接调用数 =====
bench-none  __Z10run_directl         indirect_callq=0
bench-none  __Z13run_heap_openl      indirect_callq=2
bench-none  __Z14run_heap_finall     indirect_callq=2
bench-none  __Z17run_visible_locall  indirect_callq=1
bench-none  __Z12run_cross_tul       indirect_callq=2
visible_local 是 1 而不是 2,差别在析构:局部对象的销毁点编译器看得见,析构调用被静态解析;但循环里的 step 仍然走虚表。可见「构造点可见」只解决了析构这一半,热路径上的调用没被击穿。
认知二:「LTO 全程序视角能去虚化」——本例只折叠、不击穿。 LTO 档的符号表里 run_cross_tu 与 run_heap_open 指向同一地址,两个函数被 ICF 折叠成同一函数体,证明链接器看清了两者生成代码完全相同;但函数体内部的 callq *0x10(%rcx) 原样保留,四个虚形态的耗时也没有改善。ICF 是链接期的体积优化:当两个函数的机器码逐字节相同,链接器只保留一份、让两个符号都指向它,它合并的是「副本」,不改变任何一份代码里的指令。全程序视角解决了「这个指针背后可能有哪些类型」的枚举问题,却没有在这套工具链上自动翻译成直接调用——跨 TU 工厂虽然只有一个返回类型,但语言层面仍允许未来新增别的派生类,链接器选择了保守处理。这也解释了为什么采集脚本必须按符号地址区间而不是标签统计:折叠后两个符号共享同一地址,按标签截取会得到一个函数正常、另一个函数零指令的假象。
认知三:「PGO 后间接调用就消失了」——静态数条数会漏判。 PGO 二进制里间接调用指令一条没少,统计数与 none 档相同;但热循环已经被换成另一种结构。
===== pgo 版 heap_open 热循环(猜测性去虚化) =====
00000001000005bb  leaq  OpenDerived::step(%rip), %r12   # 剖面记录的唯一目标
00000001000005d0  movq  (%rdi), %rax
00000001000005d3  movq  0x10(%rax), %rax                # 仍加载虚表槽位
00000001000005d7  cmpq  %r12, %rax                      # 与预期目标比较
00000001000005da  jne   0x100000601                     # 不符才走冷兜底
00000001000005dc  imulq $0x41c64e6d, %r14, %r14         # 相符:函数体直接内联
00000001000005e3  addq  $0x3039, %r14
00000001000005f2  callq *0x8(%rax)                      # 冷兜底:间接调用保留
这就是猜测性去虚化(speculative devirtualization)的标准形态:剖面显示该调用点 100% 命中 OpenDerived::step,编译器把这个目标地址提到循环外,每轮先做一次守卫比较,相等就执行内联后的函数体(不再有 call),不等才跳到保留的间接调用冷路径。指令条数没减少,但最贵的间接跳转与函数调用边界在热路径上消失了,这正是 140 ms 降到 111.6 ms 的来源。只数 callq * 条数会判定「没有优化」,必须读热循环本身。
五、去虚化的条件漏斗与工程手段
把三档实验的结论按「编译器需要拿到什么证据」收敛成一张漏斗:越往下证据越强,能击穿的调用形态越多。
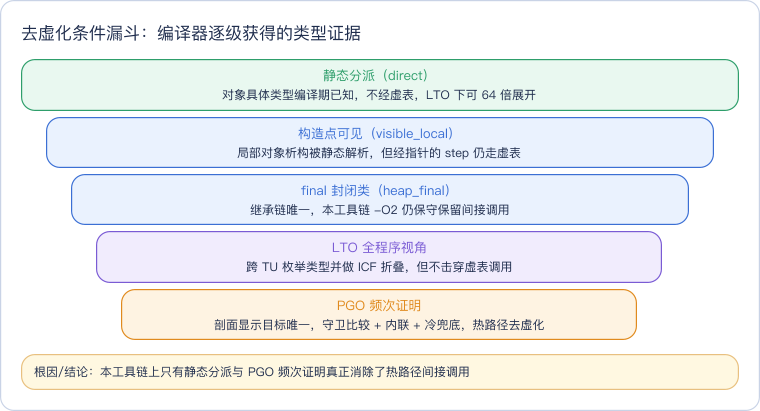
下图把编译器面对一次虚调用的判定路径画成流程,红色是证据不足、必须保留间接调用的分支,绿色是成功击穿的出口。
读图抓住两个绿色出口:左路静态分派零成本但要求放弃运行期多态;右路 PGO 保留多态灵活性,代价是维护两阶段构建与训练负载。红色判定节点说明 final、可见构造、LTO 在这套工具链上都只是必要不充分条件。
猜测性去虚化的效果有一个前提:剖面里该调用点的目标足够集中。如果训练负载下同一个调用点出现三四个并存的目标,编译器会生成一串守卫比较,每次调用顺序比对、全部落空再走间接兜底,分支 mispredict 反而比原来的单次间接跳转更糟;这与 PGO 两阶段实测的结论同源——训练负载必须长期代表真实流量,剖面失真时引导质量会一起退化。上线前应当用 llvm-profdata show 查看调用点的目标分布,多目标热点不要指望 PGO 兜底,直接改分派结构更可靠。
工程上按改造成本从低到高有四个选项。第一,先量化再动手,用反汇编或采样剖析确认虚调用真的在热路径上,百万级调用量以下、函数体本身较重时,这点开销可以忽略。第二,能接 PGO 就接,上一篇实测给出了完整两阶段流程,它对既有多态代码零侵入,本例 1.25 倍收益是白拿的。第三,类型集合编译期封闭时,用 CRTP 静态多态、std::variant 配合 std::visit、或类型擦除的 function_ref 替换虚表,把分派提前到编译期,代价是丢掉运行期动态加载的灵活性。第四,热循环外提:把虚调用挪到循环外解析一次、循环内只调具体函数,常常不改架构就能拿走大部分收益。
实验环境
- 机器/系统:Mac mini(x86_64)/ macOS 26
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),
llvm-profdata经xcrun调用,编译参数-O2 -std=c++17 -Wall,LTO/PGO 档叠加-flto - 日期:2026-11-11
- 完整命令:
make bin/bench-none bin/bench-lto bin/bench-instrumented→ 插桩版train采剖面 →llvm-profdata merge→make bin/bench-pgo→bash run.sh三档各计时 7 次取中位 →bash collect-evidence.sh按符号地址区间统计间接调用并摘录热循环
代码获取
完整可复现工程(五种形态源码、三档 Makefile、run.sh 编排与反汇编采集脚本、实测 results.txt)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-virtual-devirtualization-conditions
- 复现方式:克隆后进入该目录执行
bash run.sh,约三分钟输出三档十五组计时中位与完整反汇编证据;bash collect-evidence.sh可在不重新计时的情况下重跑证据采集。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的编译优化分组,与前两篇构成完整的构建期优化证据链:LTO 三档实测发现虚调用在 LTO 下未被消除,PGO 两阶段实测讲清剖面怎样回流编译器,本篇回答剖面具体怎样击穿虚调用。语言层面的虚函数机制与多态语法可回看 C++ 入门系列,后续同组会展开异常机制开销、RVO 与移动语义的对照实测。
总结
在这个五形态 × 三档的基准上,虚调用的去虚化条件比流行说法苛刻:普通 -O2 下连 final 类和构造点可见的局部对象都保留虚表间接调用,四个虚形态耗时约为静态分派的 10 倍;LTO 只通过 ICF 折叠同构函数、并不击穿调用;真正在热路径上消除间接跳转的是 PGO 的猜测性去虚化——守卫比较命中剖面记录的唯一目标后直接执行内联函数体、冷路径保留间接兜底,四个虚形态统一获得约 1.25 倍提升,而静态数间接调用条数完全看不到这个优化,必须读热循环反汇编。