C++ 异常开销:零成本异常在成功与抛出两条路径上各花多少
编译优化系列的第四篇。前面三篇分别实测了 LTO 三档构建、PGO 两阶段剖面引导与虚函数去虚化条件,都在讨论编译器怎样把正常路径压到更快。本篇转向一个长期充满争论的机制:C++ 异常。「异常是零成本的」这句话几乎人尽皆知,但「零成本」修饰的是哪条路径、抛出一次到底贵到什么程度、它和传统错误码、C++23 的 std::expected 之间该怎么选,光读规范得不到体感。本篇用同一份解析逻辑实现三种错误传递机制,把成功路径与错误路径分开计时,再用符号表和反汇编核对机制层面的证据。
本文要回答的问题
- 「零成本异常」里的零成本,准确含义是什么,哪条路径并不零成本?
- 同一份业务逻辑,异常、错误码、Expected 三种实现在全部成功时差距有多大?
- 全部失败时抛异常比返回错误码慢多少,折合单次抛接多少微秒?
- 二进制里的人格符号与异常表段怎样印证 Itanium ABI 的两阶段设计?
- 工程上什么场景该用异常,什么场景该让错误走普通返回值?
一、零成本异常:零的是正常路径,不是抛出路径
现代主流编译器(GCC、Clang)在类 UNIX 平台上实现异常遵循 Itanium C++ ABI 的零成本模型(zero-cost exception model)。它的核心取舍是:让不抛异常的正常执行路径不承担任何逐指令的显式开销,把处理异常所需的全部簿记挪到编译器生成的侧表里,只有异常真正抛出时才去查这些表。
具体来说,每个可能抛出异常的函数,编译器都会在 __TEXT 段旁生成一张异常处理表(Mach-O 上叫 __gcc_except_tab),记录函数里哪些调用点可能抛出、抛出后栈帧怎样展开、哪个 catch 子句能接住。正常执行时 CPU 根本不读这张表,函数体里也没有类似 setjmp 那样的注册动作;而 throw 一旦发生,运行时要调用人格 routine(personality routine,符号名 ___gxx_personality_v0)进入两阶段展开:第一阶段从抛出点沿调用栈向上回溯,查表确认有没有人能接住;第二阶段再次走栈,逐帧执行局部对象析构,最后把控制权交给匹配的 catch。这套表查询、栈回溯和析构调度,就是抛出路径昂贵的根源。
所以「零成本」是一句需要补全的话:正常路径零额外指令,异常路径按次支付高昂的展开成本。后面的基准会把这两条路径分开量,避免用一个平均数字掩盖结构性差异。
二、基准设计:同一逻辑的三种机制 × 两条路径
要比较的是错误传递机制本身,业务逻辑必须完全同构。基准选了一个最简单的解析任务:把 4 字符数字串转成整数,遇到任一字符不是数字就判失败。三个实现共享同一个纯函数核心,差异只在失败怎样通知调用方。
bool parseCore(const char* s, int len, int& result) {
    int acc = 0;
    for (int i = 0; i < len; ++i) {
        char c = s[i];
        if (c < '0' || c > '9') return false;
        acc = acc * 10 + (c - '0');
    }
    result = acc;
    return true;
}
三种机制各自的失败通道如下,成功时三者都返回同一个整数值。
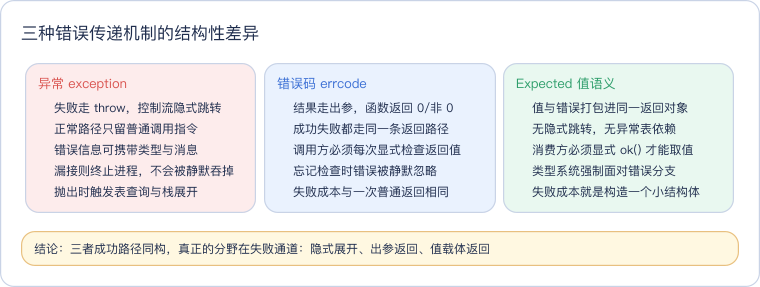
读这张卡抓住一条主线:异常把错误处理挪进侧表和隐式控制流,错误码与 Expected 都让错误走普通返回值通道,区别只在调用方被强制检查的力度。本机 Apple clang 21 自带的 libc++ 尚未提供 C++23 标准库 <expected>,工程里用一个同构的最小载体替代:ExpectedInt { int value; int error; bool ok(); },成功存值、失败存错误码、消费方必须显式检查,值/错误双载体的形态与 std::expected<int, int> 一致,因此成本结论可以直接迁移。
驱动层为 3 机制 × 2 路径各写一个独占的 noinline runner,共六个测量单元。成功路径每格跑 5000 万次全合法输入,错误路径每格跑 200 万次全非法输入——抛异常很慢,次数刻意小一档,让两格的墙钟时间都落在可测量区间。输入由同一个确定性 LCG 生成,三种机制拿到逐字节相同的 token 序列;每个 runner 的累积值或捕获次数作为 checksum 打印,同路径三机制的 checksum 必须完全一致,先证明语义等价再谈快慢。
__attribute__((noinline))
long run_except_fail(long n) {
    TokenGen gen;
    char tok[TOKEN_LEN + 1] = {0};
    long caught = 0;
    for (long i = 0; i < n; ++i) {
        gen.next(tok, false);
        try {
            (void)parseExcept(tok, TOKEN_LEN);
        } catch (const std::exception&) {
            ++caught;
        }
    }
    return caught;
}
noinline 的用意与系列前几篇相同:固定函数边界,让热循环反汇编可以按符号精确核对,也防止测量函数被内联进 main 后与相邻代码联合优化、打散各机制的对照关系。计时在二进制内先做百分之一规模的预热,正式测量用稳态时钟,整体跑 7 轮按格取中位。
三、成功路径:三者同量级,零成本名副其实
先看全部成功的 5000 万次调用。三种机制的中位耗时落在 268–349 ms 同一个量级,折合成单次调用约 5–7 纳秒,差异来自函数形态与分支布局,而不是异常机制本身。
| 机制 | 成功路径中位 (ms) | 折合单次 | 错误路径中位 (ms) | 折合单次 |
|---|---|---|---|---|
| exception | 268.518 | 约 5.4 ns | 11990.551 | 约 6.0 μs |
| errcode | 348.799 | 约 7.0 ns | 3.909 | 约 2.0 ns |
| expected | 278.769 | 约 5.6 ns | 3.621 | 约 1.8 ns |
成功路径上异常版本反而最快,但这没有神秘原因:错误码版本多一个出参和一处分支、Expected 版本多一次载体构造与 ok() 判断,而异常版本的函数体在不抛出时就是一次普通调用加返回,侧表完全不被触碰。三者两三百毫秒的差距在不同编译版本间会互换位置,应当作噪声看待,结论只有一个:只要异常不抛出,它不为错误处理机制支付可感知的运行时账单。
下图把两条路径画成双面板,左面板线性轴展示成功路径的同量级对照,右面板改用对数轴——否则错误码那两根柱子在异常柱面前会矮到看不见。
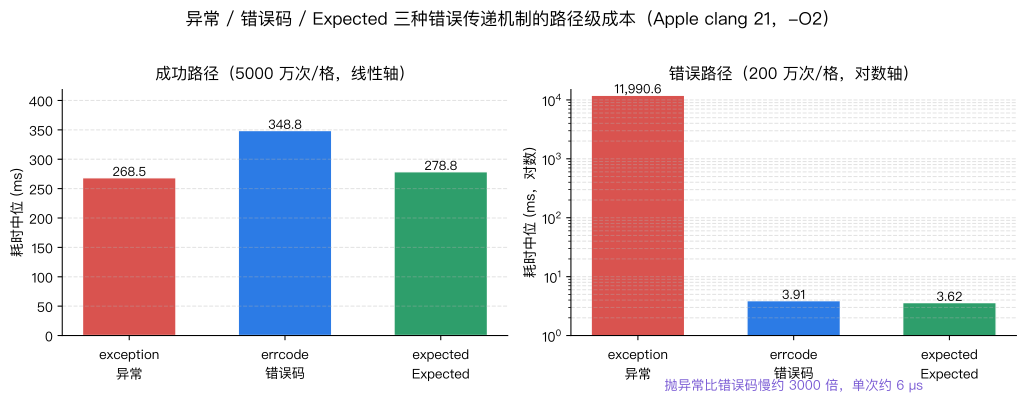
读这张图先对照两个纵轴的量级:左面板三柱齐平,右面板三柱差出三个数量级。同一套代码、同一份输入,仅仅因为每个 token 是否合法,成本结构就完全反转,这正是把两条路径分开测量的意义——任何把成功与失败混在一起求平均值的基准,都会同时低估异常的抛出代价、夸大它的常态成本。
四、错误路径:约 3000 倍差距,单次抛接约 6 微秒
切到全部失败的 200 万次调用,画面彻底反转。异常版本耗时 11990.551 ms,错误码与 Expected 分别只有 3.909 ms 和 3.621 ms,抛接异常比普通返回慢约 3000 倍,单次抛接折合约 6 微秒。
这 6 微秒花在哪里?对照第一节的两阶段展开:每次 throw 都要构造异常对象、调用人格 routine 从当前帧沿栈回溯查 __gcc_except_tab、确认本帧没有匹配的 catch 后继续上行、再第二遍走栈执行沿途局部对象的析构、最后跳到 catch 入口。错误码版本做的事则只是一次比较和一次函数返回,分支预测器对这种总是失败的固定分支预测准确率极高,单次约 2 纳秒基本就是调用本身的价格。
完整原始输出如下,六格中位、人格符号、异常表段与热循环反汇编在同一份记录里。
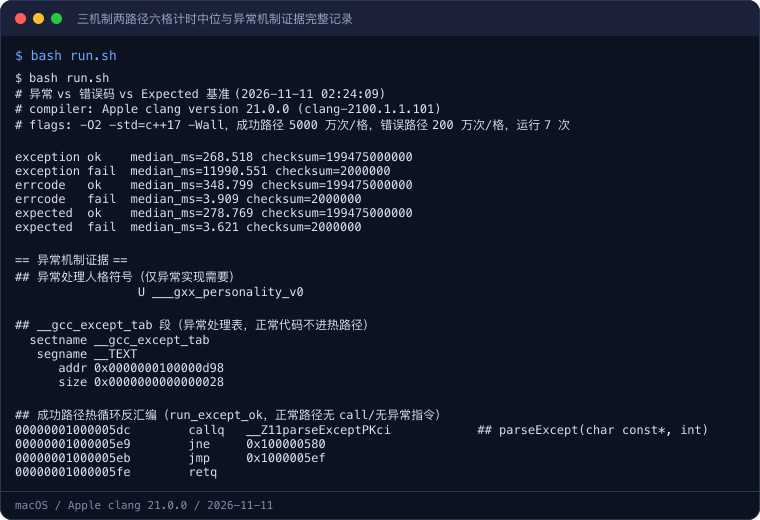
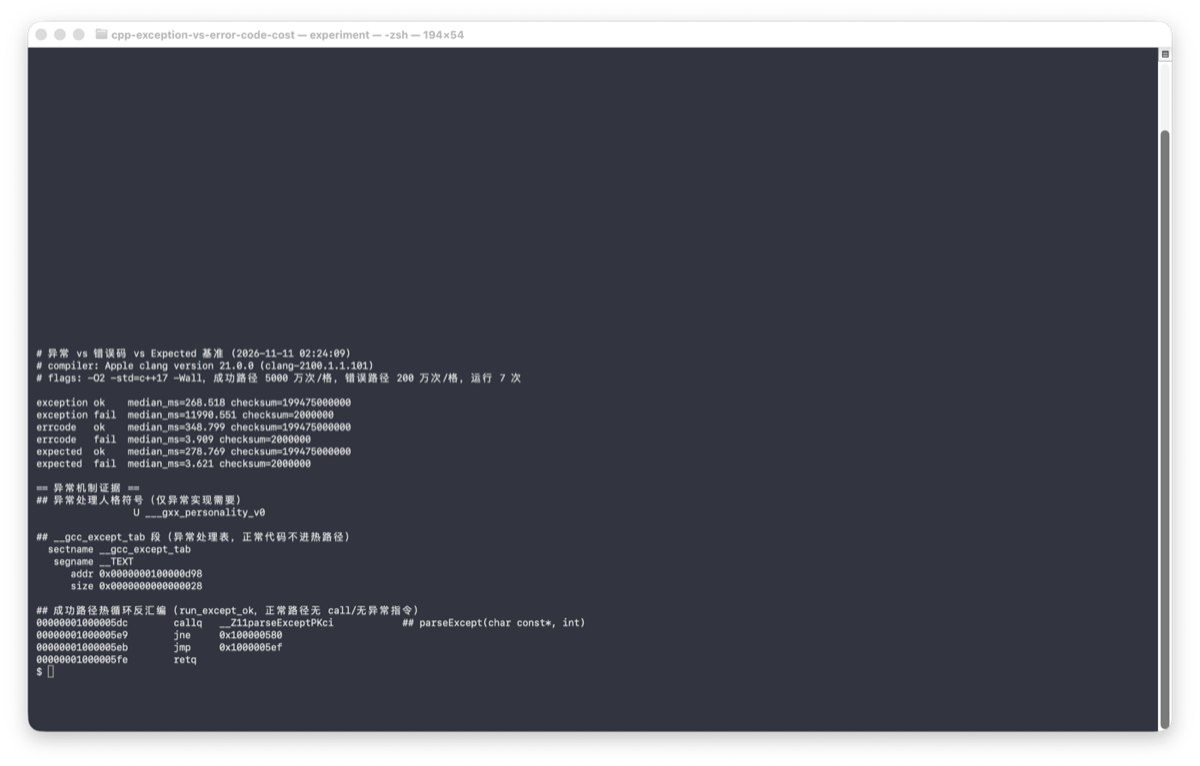
图中三个 checksum 在同路径上完全一致(成功格 199475000000、失败格 2000000),说明三种机制跑完了同样的计算量、捕获了同样多的失败,耗时差异可以干净地归因到错误通道本身。
五、二进制证据:侧表存在,但热循环里没有它的位置
数据之外,再从产物层面核对零成本模型的两个预言:异常相关的簿记确实存在于二进制中,但正常路径的机器码里找不到它们的执行痕迹。
## 异常处理人格符号(仅异常实现需要)
                 U ___gxx_personality_v0

## __gcc_except_tab 段(异常处理表,正常代码不进热路径)
  sectname __gcc_except_tab
   segname __TEXT
      addr 0x0000000100000d98
      size 0x0000000000000028

## 成功路径热循环反汇编(run_except_ok,正常路径无 call/无异常指令)
00000001000005dc	callq	__Z11parseExceptPKci
00000001000005e9	jne	0x100000580
00000001000005eb	jmp	0x1000005ef
00000001000005fe	retq
第一处证据是未定义符号 ___gxx_personality_v0:nm 显示它标记为 U,定义在语言运行时库里,只有包含异常处理的程序才会被链接进来;纯错误码版本没有这个依赖。第二处是 __gcc_except_tab 段,40 字节的表描述了函数内各调用点的展开规则,它静态地躺在 __TEXT 段里,正常执行时没有任何指令读它。第三处也是最关键的一处:成功路径 runner 的热循环反汇编里,对 parseExcept 只是一条普通的直接 callq,循环体内找不到查表、人格 routine 调用或 ud2 之类的异常指令——编译器为抛出路径准备的全部设施,在不抛出时对 CPU 都是不可见的数据,而非待执行的代码。
把三处证据与实测数字并置,零成本模型的账本就完整了:正常路径用「侧表占用一点二进制体积」换来了「零额外执行指令」,抛出路径则按次支付人格 routine 与栈展开的全额费用。
六、工程取舍:什么错误才配走异常
3000 倍不是让你禁用异常的理由,而是划分错误类型的依据。判断标准是频率与语义,不是个人口味。
| 维度 | 适合异常 | 适合错误码 / Expected |
|---|---|---|
| 发生频率 | 罕见、真正的例外情况 | 正常业务流的可预期分支 |
| 语义性质 | 不变量被破坏、无法继续 | 输入校验失败、资源暂不可用 |
| 调用栈深度 | 错误要穿越很多层才有人处理 | 邻近层就能决策恢复 |
| 典型例子 | 配置文件损坏、内存耗尽、编程契约违反 | 用户输入非法、查无此记录、重试可恢复 |
| 单次成本 | 约 6 μs,按次昂贵 | 约 2 ns,与普通返回同价 |
解析用户输入这类「失败是日常」的场景,每个非法 token 都可能触发一次抛出,6 微秒乘以高并发失败率会直接吃掉吞吐,应当让错误走返回值通道;而服务器启动时发现监听端口被占用、或深层代码发现一个理论上不可能为空的指针为空,这类失败要么立刻终止、要么要穿透十几层调用到最外层统一兜底,异常既省掉了逐层手工透传错误码的样板代码,又因频率极低而让单次 6 微秒变得无关紧要。C++23 的 std::expected 适合中间地带:错误是预期内的、但你希望类型系统强制调用方处理它,而不是靠纪律保证每个返回值都被检查。
还有一个常被忽略的约束:异常的实际代价与工具链、平台和异常对象类型相关,本篇数字是 Apple clang 21 在 macOS 上的实测,其他运行时(尤其是 32 位环境或禁用展开表的特殊工具链)量级可能不同。落地自己的服务前,用与本篇同构的方法在生产工具链上复测一次,比引用任何外部数字都可靠。
实验环境
- 机器/系统:Mac mini(x86_64)/ macOS 26
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),编译参数
-O2 -std=c++17 -Wall - 日期:2026-11-11
- 完整命令:
make构建bin/bench→bash run.sh干净重建后运行 7 轮,按机制 × 路径六格取中位 → 同一脚本内用nm、otool -l、otool -tvV采集人格符号、异常表段与热循环反汇编
代码获取
完整可复现工程(三种机制的同构实现、六个 runner、run.sh 编排与实测 results.txt)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-exception-vs-error-code-cost
- 复现方式:克隆后进入该目录执行
bash run.sh,约两分钟输出六格计时中位与异常机制证据;工程内的ExpectedInt是本机无标准库<expected>时的同构替代,头文件注释里写明了迁移到std::expected的对应关系。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的编译优化分组。LTO 三档实测、PGO 两阶段实测与虚函数去虚化条件关注编译器怎样优化正常路径上的调用与分支,本篇补上错误处理路径的成本账本,四篇共同构成「写 C++ 时每一种控制流机制各花多少」的实测基础。后续同组会展开 RVO、移动语义与 noexcept 怎样决定容器扩容走拷贝还是移动。
总结
在这份同构三机制 × 两路径的基准上,「零成本异常」得到了精确界定:成功路径 5000 万次调用中异常、错误码、Expected 同处 268–349 ms 一个量级,热循环反汇编里只有普通直接调用,异常表与人格 routine 作为静态侧表存在却不被执行,零成本名副其实;一旦真正抛出,200 万次失败耗时 11990 ms,对错误码的 3.9 ms 慢约 3000 倍、单次抛接约 6 微秒,成本来自人格 routine 主导的两阶段栈展开。工程结论是按频率与语义分流:罕见的不变量破坏用异常,可预期的业务失败用错误码或 Expected,并用生产工具链自己复测量级。