输入解析性能:iostream、scanf 与自定义快读的百万行吞吐实测
编译优化系列的第十三篇。前一篇variant 与虚函数多态分派实测量的是 CPU 内部一次调用的纳级差异,本篇把观测尺度放大到文件 IO:同一个程序读同一份 200 万行整数,换用不同的输入接口,耗时可以相差几百倍。入门篇 cin 与 cout:iostream 输入输出讲过 cin/scanf 的用法与输入缓冲的坑,也提到 sync_with_stdio(false) 能给 cin 提速;提多少、在哪个平台提、天花板在哪里,用法文档给不出数字。本篇用四条解析路径在同一份数据上的吞吐实测回答这些问题,所有数字都来自七个独立进程的中位记录,可照实验工程完整复现。
本文要回答的问题
- 读同样 200 万行整数,
scanf、默认cin、关同步的cin与手写快读各花多少毫秒? - 竞赛代码里常见的
sync_with_stdio(false)加tie(nullptr),在 macOS + libc++ 上到底能提速多少? - 关掉优化的 O0 档,四条路径的排名会不会变化,变化说明时间花在了哪一层?
- 把「读字节」和「格式化解析」拆开计时,20 MB 文件的真实读取成本占多少?
- 工程上什么规模的数据值得放弃 iostream 手写快读,取舍的边界怎么划?
一、四条解析路径与它们各自要过的层
四条路径读的是同一个文件,差别在字节从内核到用户变量之间要经过多少层机械动作。
scanf 走 libc 的格式化输入:fscanf(fp, "%d", &x) 每次调用先经过 FILE 流的缓冲与锁,再按格式串 %d 逐字符拼整数。它的实现是系统库预编译好的原生代码,编译选项对它几乎没有影响。
cin 路径分两组。cin-default 保持 sync_with_stdio(true) 的出厂状态,iostream 与 C 流共享缓冲,每次 operator>> 都要构造 sentry 哨兵对象、检查流状态、走 locale 相关的字符分类,再与底层 stdio 同步;cin-fast 在入口处关掉同步并解绑 cout,理论上省掉同步层,但提取动作本身一层不少。
自定义快读绕开所有格式化设施:一次 fread 把 64 KB 块读进静态缓冲,之后在用户内存里逐字符手写整数拼装,连函数调用都内联在热循环里。先用一张对比卡把四条路径的结构性差异摆在一起,后面的实测逐格验证。
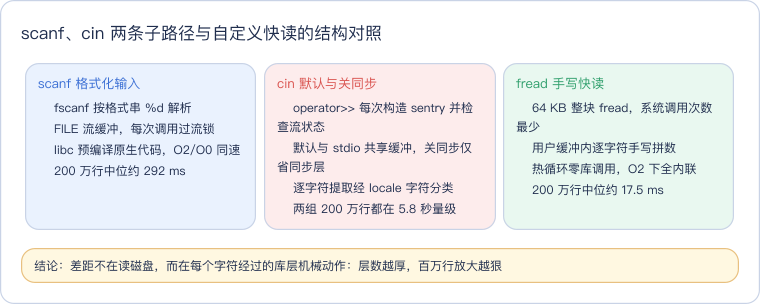
读这张卡抓住一条主线:四条路径面对的物理读取是同一个页缓存,真正的分野是每个字节被多少层抽象接管。库层越厚,单字符成本越高,而 200 万行、每行若干字符的规模会把单字符上的微小差距放大到几百倍。
二、基准设计:同一份数据,七个独立进程取中位
数据由确定性的线性同余生成器产生:200 万个整数,正负各半,每行一个,落盘成 20,000,000 字节的 data.txt。四组 runner 读完全相同的字节,每解析一个数累加进同一个 checksum,全部 56 轮(四组 × 双档 × 七轮)的 checksum 必须是同一个值,先证明语义等价再谈快慢。
计时方法上刻意避免在单进程内重复跑:每个进程只跑一轮完整解析,七轮由脚本拉起七个独立进程,再按毫秒取中位。这样流状态、缓冲预热不会在组间串味,进程级抖动也由中位数吸收。计时用 steady_clock 包住解析全程,同时输出百万行每秒与 MB 每秒两个口径的吞吐。
自定义快读的全部秘密就是下面这二十行:64 KB 静态缓冲加两个下标,缓冲耗尽才补一次 fread,拼数循环只做乘十加位。
namespace fastread {
static constexpr size_t BUFSZ = 1u << 16;
static char buf[BUFSZ];
static size_t buf_len = 0;
static size_t buf_pos = 0;

static inline int getc_fast() {
    if (buf_pos == buf_len) {
        buf_len = std::fread(buf, 1, BUFSZ, stdin);
        buf_pos = 0;
        if (buf_len == 0) return -1;
    }
    return static_cast<unsigned char>(buf[buf_pos++]);
}

static inline bool read_int(int& out) {
    int c = getc_fast();
    while (c != -1 && c != '-' && (c < '0' || c > '9')) c = getc_fast();
    if (c == -1) return false;
    int sign = 1;
    if (c == '-') { sign = -1; c = getc_fast(); }
    int x = 0;
    while (c >= '0' && c <= '9') {
        x = x * 10 + (c - '0');
        c = getc_fast();
    }
    out = x * sign;
    return true;
}
}  // namespace fastread
下图把四条路径的数据流并排画出:蓝色是数据入口,灰色是库内缓冲层,红色是每个字符都要经过的解析判定,绿色是自定义路径里唯一的系统调用补块动作。
读这张图对比两个红色与绿色节点:库函数路径里每个字符都要穿过红色的格式化判定,200 万行意味着上千万次库层动作;自定义路径的绿色补块只在 64 KB 缓冲耗尽时发生,20 MB 数据约 306 次 fread,其余时间 CPU 只在一块连续内存上做顺序算术——这正是 vector/deque/list 遍历实测里量过的、硬件预取器最友好的访问形态。
三、O2 吞吐:336 倍的差距是怎样拉开的
部署构建实际使用的 O2 档,四组七进程中位如下,吞吐由中位耗时与固定的 200 万行、20 MB 反算。
| 解析路径 | O2 中位耗时 (ms) | 吞吐 (Mlines/s) | 吞吐 (MB/s) | 对 scanf 倍数 |
|---|---|---|---|---|
| scanf | 292.177 | 6.845 | 68.452 | 1.00 |
| cin 默认(sync=true) | 5878.607 | 0.340 | 3.402 | 慢约 20.1 倍 |
| cin 关同步(sync=false) | 5781.929 | 0.346 | 3.459 | 慢约 19.8 倍 |
| 自定义快读 | 17.509 | 114.227 | 1142.270 | 快约 16.7 倍 |
第一档反差是 cin 对 scanf:默认 cin 读完 200 万行要 5.88 秒,scanf 只要 0.29 秒,整整 20 倍。第二个反差更反直觉——关掉 sync_with_stdio 只把 5878.6 ms 压到 5781.9 ms,提升 1.64%,吞吐从 0.340 进到 0.346 Mlines/s,几乎可以视为测量噪声。流行印象里「关同步 cin 就接近 scanf」在这个平台上不成立,原因留到第五节拆。
第三档反差来自自定义快读:17.509 ms、1142 MB/s,比 scanf 快 16.7 倍,比默认 cin 快约 336 倍。注意 1142 MB/s 已经超过普通 SATA 盘的顺序读带宽,说明数据全程驻留页缓存,量到的纯粹是 CPU 侧的解析成本而不是磁盘 IO。
下图左面板按对数轴画出四组 O2 耗时,右面板把 O2 与 O0 两档吞吐并排,同样用对数轴,否则 17.5 ms 的柱子在 5.8 秒的柱子面前会矮到看不见。
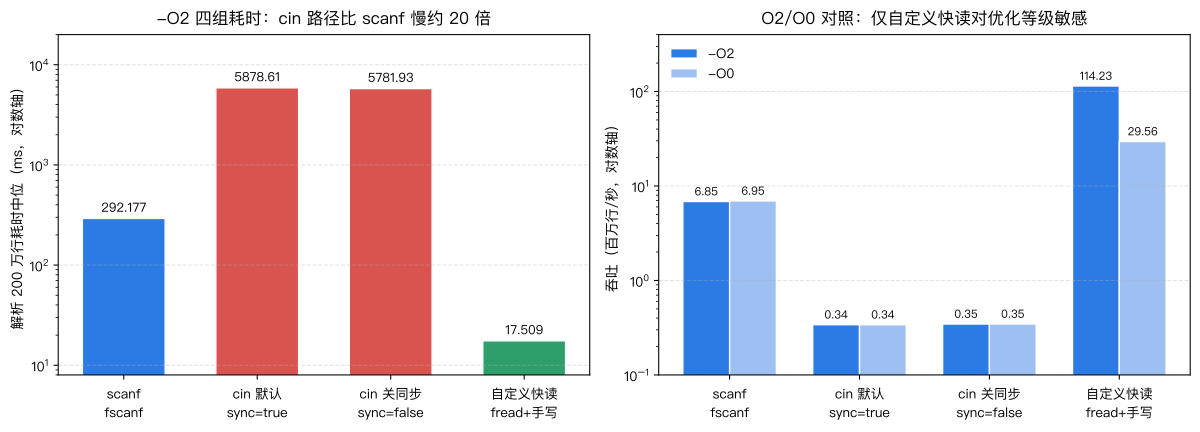
读图先看左面板两根红色柱:cin 两组都顶在 5.8 秒附近,肉眼几乎等高,关同步的收益在对数轴上都显不出来;蓝色 scanf 落在 300 ms 一档,绿色自定义快读贴在 17 ms 的底部。右面板回答优化等级的影响:scanf 与两组 cin 的 O2、O0 柱子完全重合,只有自定义快读从 114 Mlines/s 掉到 29.6 Mlines/s——依赖编译器内联的代码才会对优化档敏感,这个现象下一节细拆。
O2 档的跨进程中位汇总与 checksum 核验记录如下。
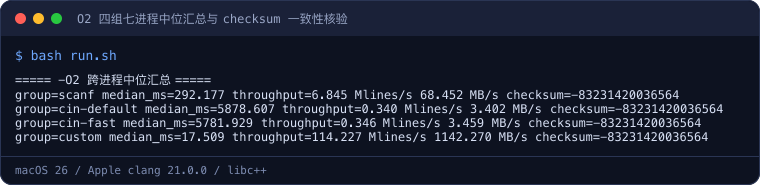
下图是同一轮基准在终端里的单进程滚动输出,上半段 O2、下半段 O0 各四行,每行末尾的 checksum 都是同一个值 -83231420036564。单轮数字围绕中位小幅波动:O2 自定义快读这一轮 15.297 ms、130.746 Mlines/s,O0 同组降到 71.690 ms,而 cin 两组无论哪一档都稳定在 5.3 到 5.5 秒之间,组间差距远大于轮间抖动。
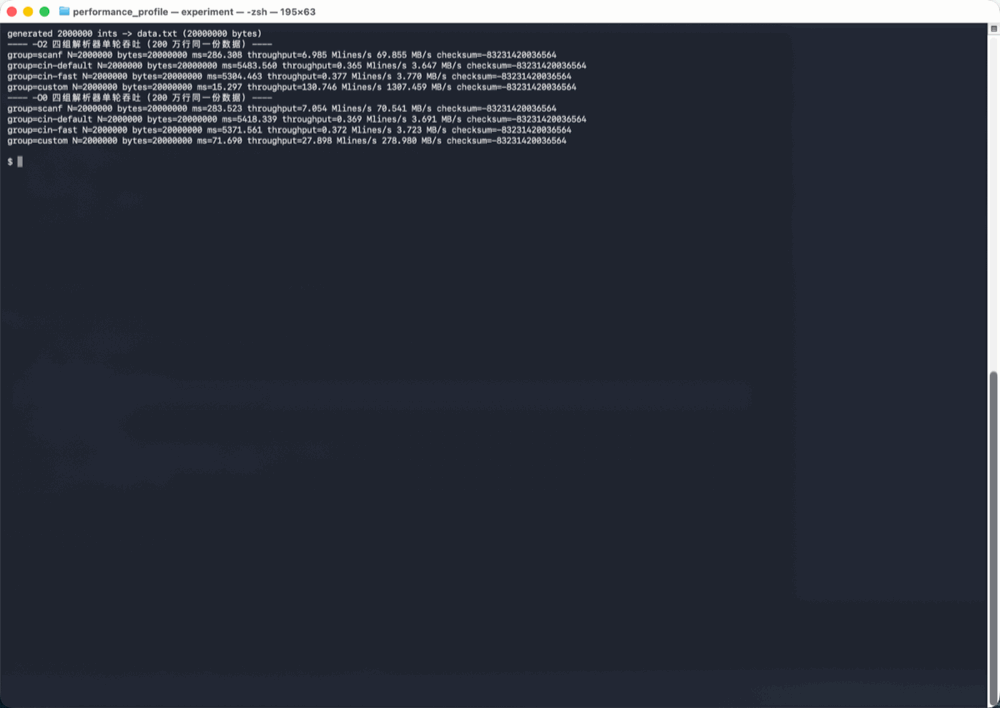
图中 O2 与 O0 两段里 scanf 都在 285 ms 附近、cin 都在 5.4 秒量级,说明这两条路径的耗时由预编译库代码决定,换优化档挪不动它们;唯一随档位明显跳动的是最后一行自定义快读,这与右面板的结论互相印证。
四、O0 对照与拆分探针:时间到底花在哪一层
O0 档七进程中位如下。scanf 与 cin 三组的数字与 O2 几乎完全相同,自定义快读从 17.509 ms 膨胀到 67.665 ms,慢了 3.86 倍,但仍是四组里最快的。
| 解析路径 | O0 中位耗时 (ms) | O0 吞吐 (Mlines/s) | O2/O0 耗时比 |
|---|---|---|---|
| scanf | 287.862 | 6.948 | 1.01 |
| cin 默认 | 5878.064 | 0.340 | 1.00 |
| cin 关同步 | 5780.862 | 0.346 | 1.00 |
| 自定义快读 | 67.665 | 29.557 | 0.26 |
O0 记录的完整汇总与去重后只剩一个值的 checksum 如下。
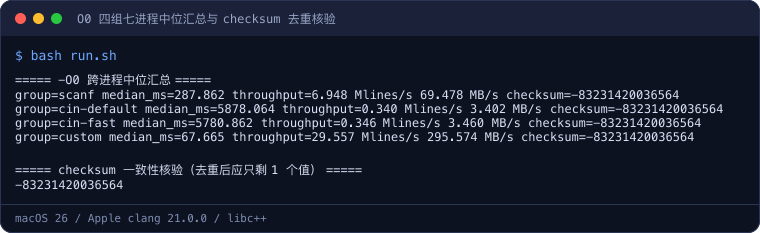
O0 这张表把机制差异照得很清楚。scanf 活在 libc 里,cin 的提取器活在 libc++ 的预编译库里,两者都不是本工程的编译产物,-O0 关不到它们头上;自定义快读的热循环本来要靠编译器把 getc_fast、read_int 内联展开,O0 下每次取字符都退化成真实函数调用,于是暴增近四倍。即便如此,67.7 ms 仍然只有 scanf 的四分之一——库层省掉之后,哪怕全是 call,机械动作的绝对数量也差着量级。
光有黑盒耗时还不够,工程里另带一个拆分探针,把「读字节」与「格式化解析」分开计时,四种测法各跑两遍。
| 探针测法 | 两轮耗时 (ms) | 测到的东西 |
|---|---|---|
| fread 裸读 20 MB | 2.4 / 2.4 | 仅内核到用户缓冲的字节搬运,约 8.3 GB/s |
| ifstream getline 分行 | 132.6 / 132.5 | 切行不拼数,200 万次行扫描 |
| fscanf %d | 289.1 / 289.9 | 切行加整数拼装,与主基准 292 ms 互证 |
ifstream >> int | 501.5 / 501.5 | iostream 完整提取链 |
这张探针表是全篇的机理钥匙。裸 fread 读完整个文件只要 2.4 ms,意味着 5.88 秒的 cin 耗时里,物理读取只占 0.04%,剩下 99.96% 全是 CPU 在库层里搬运字符、构造哨兵、查 locale。getline 只切行不拼数就要 132.6 ms,而 fscanf 连切带拼 289 ms,说明整数转换本身约占一半;iostream 的 501.5 ms(探针口径,与主基准的 cin 路径测量边界不同)又在切行之外叠加了 sentry 与流状态的固定开销。
系统侧的 /usr/bin/time -l 证据补上资源视角,四组驻留内存都在 650 到 740 KB 之间,自定义快读因 64 KB 静态缓冲略高约 70 KB,没有量级差异;真正拉开的是非自愿上下文切换次数。
| 路径 | 最大驻留内存 (KB) | 非自愿上下文切换 |
|---|---|---|
| scanf | 667648 | 22 |
| cin 默认 | 671744 | 330 |
| cin 关同步 | 659456 | 815 |
| 自定义快读 | 737280 | 4 |
cin 两组在 CPU 运行队列里被抢占数百次,自定义快读全程只有 4 次。17 ms 的活一瞬间就做完了,调度器几乎没有插手窗口;5.8 秒的慢活则被反复打断,慢本身又放大了被调度的概率,这与低延时设计模式里「缩短临界区、减少被抢占机会」的思路同向。
五、sync_with_stdio 开关为什么在本平台几乎无效
ios::sync_with_stdio(false) 的规范语义是解除 iostream 与 C 标准流的缓冲同步,允许 streambuf 独立缓冲;cin.tie(nullptr) 则解除每次输入前隐式 flush cout 的绑定。Linux + libstdc++ 的不少实测里,这两个开关能让 cin 提速数倍,原因是其实现默认走得很保守,关同步后整条提取路径换成独立的缓冲管线。
本篇的数字显示,macOS + libc++ 上开关前后是 5878.6 ms 对 5781.9 ms,仅 1.64%。机理上并不矛盾:同步层只是 cin 每次 operator>> 机械动作里的一环,而 sentry 构造、流状态检查、locale 字符分类、逐字符的虚分发与边界判断一层都没少。当瓶颈在提取器内部的 per-character 成本时,省掉外层同步自然只是零头。探针里 ifstream 提取(ifstream 本身不与 stdio 共享同步状态)仍要 501.5 ms,也从侧面证明同步开关不是主成本项。
这条结论的适用边界必须写清楚:它是 Apple clang 21、libc++、macOS 26 上的实测,不是 C++ 的普遍规律。Linux + libstdc++ 上关同步的收益可能完全不同,竞赛评测机、生产服务器换了工具链就要照本工程的方法重测,不能把 1.64% 或 336 倍任何一个数字跨平台照搬。实验工程的 README 也把这条口径写明了。
六、工程取舍:什么规模用哪一条路径
把实测收敛成决策表,判断标准是输入规模、平台可移植性与维护成本,而不是习惯写法。
| 维度 | scanf | cin 默认 | cin 关同步 | 自定义快读 |
|---|---|---|---|---|
| O2 吞吐(本平台) | 6.85 Mlines/s | 0.34 Mlines/s | 0.35 Mlines/s | 114 Mlines/s |
| 200 万行耗时 | 292 ms | 5.88 s | 5.78 s | 17.5 ms |
| 类型扩展能力 | 格式串,支持多种类型 | 运算符重载,类型最丰富 | 同左 | 只支持手写覆盖的类型 |
| 出错处理 | 返回值判定 EOF | 流状态与异常机制 | 同左 | 需自己定义协议与兜底 |
| 可移植性 | 各平台稳定 | 各平台都慢 | 收益随平台波动 | 纯标准库,各平台一致快 |
| 适用场景 | 中小规模结构化输入 | 交互程序、小输入 | 想保留 iostream 写法的折中 | 百万行级数据、竞赛、离线 ETL |
落地时有三条纪律。第一,不要在没有实测的平台上迷信任何开关:先按生产工具链跑一遍七轮中位,再决定要不要引入手写解析,1.64% 与数倍的开关收益在不同标准库上都真实存在。第二,自定义快读的适用面比看起来窄——它只认你写过的格式,遇到浮点、十六进制、分隔符多变的协议,维护成本会反噬收益,这类场景可以考虑带回调的流式解析器而不是无限扩写快读。第三,快读的价值随规模线性放大:万行级输入四条路径都在毫秒内,可读性优先,老老实实用 iostream;百万行级、且该读取处在热路径上时,17.5 ms 对 5.8 秒的差距才值得引入一个经过 checksum 对拍验证的快读模块。字符串与缓冲自身的取舍可参照 string SSO 与传参实测里量过的小对象拷贝成本。
实验环境
- 机器/系统:MacBook Pro(Intel Core i7-9750H,6 物理核 12 逻辑线程,16 GB)/ macOS 26.5.2
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),libc++;编译参数
-std=c++17 -Wall -Wextra,O2/O0 双档 - 日期:2026-11-12
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh生成 200 万行data.txt,四组各拉起 7 个独立进程取中位,并以/usr/bin/time -l采集驻留内存与上下文切换 → 拆分探针单独执行clang++ -O2 -std=c++17 probe.cpp -o probe-bin && ./probe-bin
代码获取
完整可复现工程(四组 runner、LCG 数据生成器、七进程中位编排、拆分探针与 O2/O0 双目标)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-iostream-scanf-custom-parser
- 复现方式:克隆后进入该目录执行
bash run.sh,数分钟内输出双档七轮中位、checksum 核验与系统侧资源证据;其他标准库与架构平台的吞吐需重新实测,不要沿用本篇的毫秒数字。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的标准库成本分组。variant 与虚函数多态分派实测是紧邻的上一篇,量 CPU 内的调用机制,本篇量跨库层的字符通路,两者共用「七进程中位 + checksum 对拍 + 双优化档」的方法。语言用法层面,cin、cout 与输入缓冲的入门讲解见 cin 与 cout:iostream 输入输出,本篇只回答吞吐问题、不重复用法;内存与值语义的成本基础由 string SSO 与传参去拷贝实测承担,顺序扫描为什么省 cache 的证据在 vector/deque/list 遍历实测。
总结
在同一份 200 万行、20 MB 整数数据上,四条输入解析路径的吞吐差距达到两个数量级:O2 七进程中位中,scanf 用时 292.177 ms(6.85 Mlines/s),默认 cin 长达 5878.607 ms、比 scanf 慢 20.1 倍,而 sync_with_stdio(false) 加 tie(nullptr) 在 macOS + libc++ 上只换来 1.64% 的提升,因为瓶颈在提取器内部的逐字符库层动作而非同步层;fread 整块缓冲加手写拼数的自定义快读仅 17.509 ms、1142 MB/s,比 scanf 快 16.7 倍、比 cin 快约 336 倍。拆分探针显示裸读 20 MB 只要 2.4 ms,cin 耗时的 99.96% 是解析而非 IO;O0 下 scanf 与 cin 纹丝不动、唯手写快读膨胀 3.86 倍,证明前者吃预编译库、后者吃编译器内联。工程结论是按规模分流:万行级保留可读性最好的 iostream,百万行级热路径在生产工具链实测后再上经过 checksum 验证的快读,且任何跨平台数字都必须重新实测,不能直接沿用本平台的倍率。