锁与临界区长度:自旋锁、std::mutex 与自适应锁的拐点实测
选锁的时候,经验法则常被说成一句话:临界区短用自旋,长了用互斥。但「短」是几纳秒,「长」又是几微秒?竞争线程数变化后这条法则还成不成立?本篇用同一个基准工程把三种锁放在一张卷子上:纯自旋的 atomic_flag、走 futex 休眠的 std::mutex、先自旋再休眠的 glibc 自适应锁,临界区从约 2.8 纳秒扫到 157 微秒,线程数从 1 扫到 8,把锁与临界区长度的关系记成可复现的量化曲线。C++ 标准库提供的 Mutex 类型详解给的是类型全景与语义 survey,没有实测数字;本篇正好补上这一块,两篇对照阅读。
本文要回答的问题
- 自旋锁、
std::mutex、自适应锁在抢不到锁时分别让线程做什么,代价落在哪里? - 几纳秒的极短临界区下,三种锁的单次 lock-unlock 成本差多少?
- 临界区拉长、竞争线程增多时,自旋锁的恶化曲线是什么形状,拐点大约在哪?
perf stat的上下文切换数、IPC 与墙钟时间怎样佐证「忙等烧 CPU」这个判断?- 工程上怎样根据临界区长度与竞争形态选锁,哪些边界条件不能外推?
先用一张流程卡固定一次 lock() 调用可能走过的全部路径,后面的实测逐段验证它。
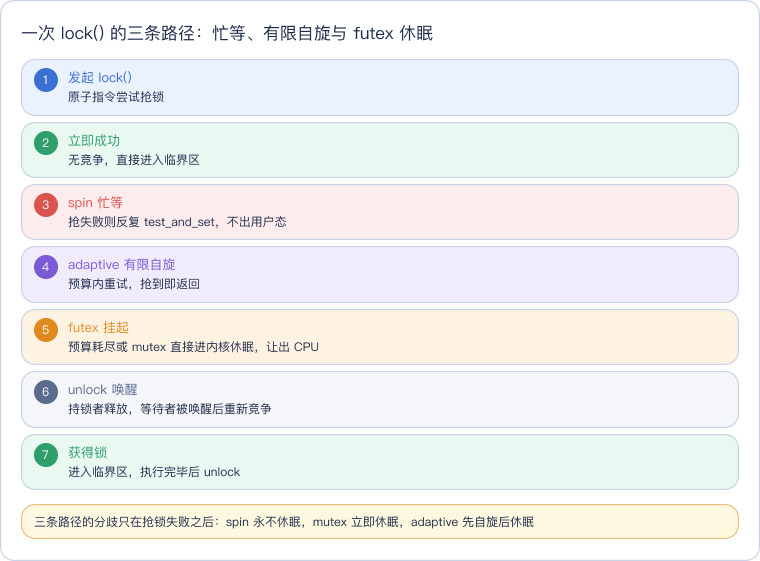
读这张卡抓住一个分叉点:三种锁在无竞争时路径完全相同,差别全部发生在抢锁失败之后。自旋锁把等待成本压在用户态的 CPU 周期上,休眠锁把成本压在内核调度与唤醒延迟上,自适应锁则是两者的折中。哪条路径更便宜,取决于等待会持续多久——而等待时长,正是由锁与临界区长度共同决定的。
一、抢不到锁时,三种锁各自做什么
自旋锁的全部机制就是一个 std::atomic_flag,抢不到就在循环里反复试探,线程始终处于运行态,不进内核、不让出 CPU:
struct SpinLock {
    std::atomic_flag flag = ATOMIC_FLAG_INIT;
    void lock() {
        while (flag.test_and_set(std::memory_order_acquire)) {
        }
    }
    void unlock() { flag.clear(std::memory_order_release); }
};
std::mutex 在 Linux/glibc 上封装的是 pthread 互斥量:无竞争时走用户态快速路径,竞争失败后通过 futex 系统调用把线程挂进内核等待队列,CPU 让给别的线程,持锁者 unlock 时再被唤醒。自适应锁用的是 glibc 的 PTHREAD_MUTEX_ADAPTIVE_NP 类型,先在用户态做有限次自旋,预算内抢到锁就避免了系统调用,预算耗尽才走 futex 休眠——相当于给「锁很快会被释放」这个猜测买一份保险。
图中红色是问题路径:抢锁失败本身与 spin 的忙等环同色,因为纯自旋在等待期间没有任何退路,持锁者多持一毫秒,等待者就空转一毫秒。蓝色的有限自旋是折中,橙色的直接休眠与灰色的 futex 队列代表让出 CPU 的一侧,绿色终点三条路径殊途同归。注意自适应锁是 glibc/Linux 专属接口,macOS 的 libpthread 没有 PTHREAD_MUTEX_ADAPTIVE_NP,这份基准本身也只能在 Linux 上编译运行。
二、实验设计:六档临界区与一次无锁校准
基准程序内置六档临界区。w1、w30、w300、w3000、w30000 是对共享变量的受控运算循环,迭代次数按十倍递增;sleep100us 档在临界区内调用一次 100 微秒的 nanosleep,模拟持锁等待 IO 或定时器的场景。程序启动后先做单线程无锁校准,测每档临界区本身的平均耗时,正文引用校准值而不是名义值:
| 临界区级 | 含义 | 校准平均耗时(首次进程) |
|---|---|---|
| w1 | 1 次运算 | 2.79 ns |
| w30 | 30 次运算 | 37.91 ns |
| w300 | 300 次运算 | 365.24 ns |
| w3000 | 3000 次运算 | 3.66 µs |
| w30000 | 30000 次运算 | 36.52 µs |
| sleep100us | 临界区内 nanosleep 100µs | 157.49 µs |
每个「锁 × 临界区级 × 线程数」格子跑五个独立进程取中位数,线程数固定扫 1/2/4/8。指标 ns/op 是总墙钟除以总 lock-unlock 操作数,包含临界区本身的运算时间,不是锁原语的孤立延迟——这正好对应工程里真实关心的口径:一次加锁保护的完整操作要花多久。
两个测量细节值得交代。临界区里的 LCG 式运算结果写入 volatile 全局汇点,编译器无法把整段循环优化掉,三锁面对的工作量因此严格一致;取中位数而不是平均值,是因为云主机上偶发的调度抖动或邻居噪声会把单次进程的某个格子拉高,中位对这类离群点不敏感,五个独立进程也比进程内重复五轮更能反映冷启动后的真实分布。操作数按临界区级递减配置(w1 每线程 40 万次、sleep 档每线程 1000 次),让最短档有足够样本摊薄计时误差,最长档不至于把整轮基准拖到分钟级。测试机是腾讯云上海竞价 CVM,S6.MEDIUM8 规格,1 个物理核、2 个 SMT 线程(Xeon Platinum 8374C),所以 4 线程和 8 线程都属于超额订阅,线程数超过 SMT 容量后必然触发调度抢占,这一点解读数据时要一直记着。
三、短临界区:spin 单线程最快,竞争中被 adaptive 反超
w1 档临界区本身只有 2.8 纳秒,锁机制的固定成本在这一档暴露得最充分。下图左面板是三锁在 w1 档随线程数扩展的线性轴曲线,右面板把视角换成固定 4 线程、临界区长度跨五个数量级的对数轴曲线。
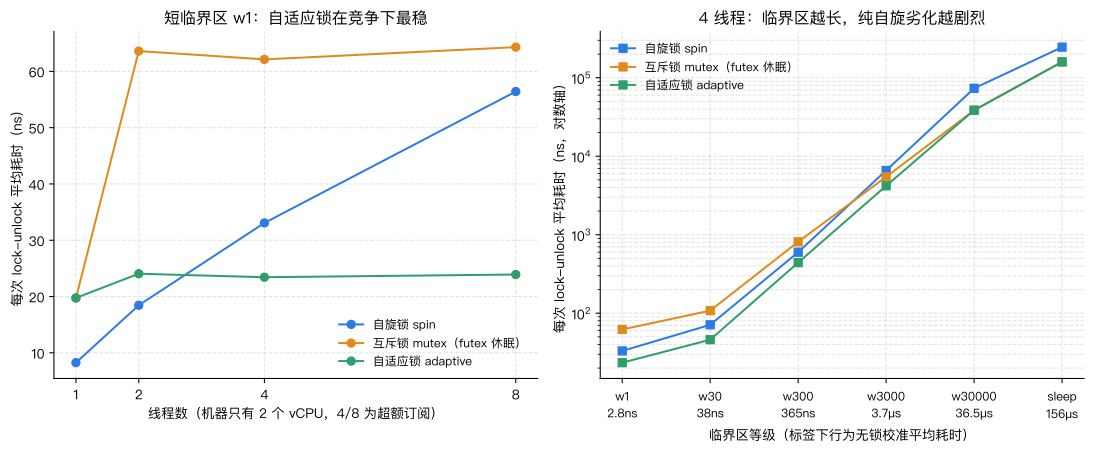
左面板三条线讲了三个不同的故事。spin 单线程只要 8.25 ns/op,全程不碰系统调用,是三锁里最低的;但它随竞争近似线性恶化,8 线程涨到 56.42 ns,是单线程的约 6.8 倍。mutex 单线程就背着 19.71 ns 的 futex 路径成本,2 线程跳到 63.61 ns 后基本不再随线程数变化,稳定在 62–64 ns 一线。adaptive 单线程与 mutex 几乎同价(19.76 ns),但竞争起来后反而最稳:4 线程 23.43 ns、8 线程 23.91 ns,因为短临界区下持锁者很快释放,等待者在自旋预算内就能抢到锁,绝大多数等待根本不需要进内核。
| w1 档 ns/op | 1 线程 | 2 线程 | 4 线程 | 8 线程 |
|---|---|---|---|---|
| spin | 8.25 | 18.45 | 33.08 | 56.42 |
| mutex | 19.71 | 63.61 | 62.13 | 64.31 |
| adaptive | 19.76 | 24.05 | 23.43 | 23.91 |
w30 档方向一致:spin 从 38.66 ns 恶化到 8 线程的 142.91 ns,adaptive 始终压在 38.81–46.54 ns 的窄带里。自旋锁的五次进程中位原始记录如下,24 行覆盖六个临界区级与四个线程档,可以顺着线程数列看它的恶化趋势:
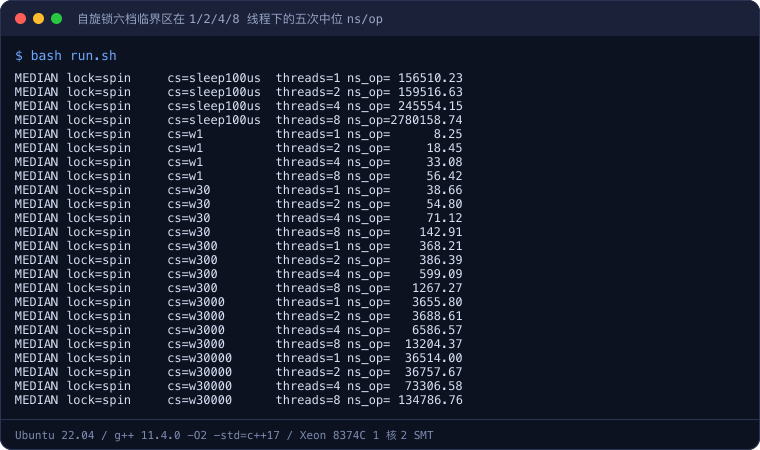
这张终端卡里最上面的 w1 四行就是上表第一行的出处;往下读到 w300、w3000,同一线程列的数字逐级跳升,而相邻线程列的倍差也在拉大。单看短临界区可以先得到第一条结论:无竞争或确定只有一个线程碰锁时,spin 最便宜;只要竞争存在且不可预测,adaptive 在几纳秒到几十纳秒的临界区上全面占优,4 线程下它对 mutex 的领先约为 2.65 倍(23.43 对 62.13 ns)。
四、临界区拉长:忙等的账单怎样到来
临界区一旦变长,故事的主角换成 spin。右面板对数轴上,三锁在 w300 以下还挤在一起,到 w3000、w30000 开始分道扬镳,sleep100us 档彻底拉开数量级。下面这张表取四档较长临界区在 4 线程与 8 线程下的中位数:
| 临界区级 | 线程 | spin (ns) | mutex (ns) | adaptive (ns) |
|---|---|---|---|---|
| w300(365 ns) | 4 | 599.09 | 812.40 | 441.69 |
| w300 | 8 | 1267.27 | 789.73 | 442.18 |
| w3000(3.66 µs) | 4 | 6586.57 | 5462.61 | 4197.13 |
| w3000 | 8 | 13204.37 | 4201.91 | 4022.88 |
| w30000(36.5 µs) | 4 | 73306.58 | 38532.08 | 38597.73 |
| w30000 | 8 | 134786.76 | 38885.44 | 38875.70 |
| sleep100us(157 µs) | 4 | 245554.15 | 159618.68 | 159074.79 |
| sleep100us | 8 | 2780158.74 | 160341.19 | 159704.61 |
先看休眠锁一侧。mutex 与 adaptive 在 w30000 档无论 4 线程还是 8 线程都稳定在 38–39 µs,相对 36.5 µs 的临界区本身,锁等待只贡献了约 5%–7%;sleep 档 8 线程约 160 µs/op,相对 157 µs 的临界区校准值,增量更小。原因是线程抢不到锁就挂起,不占 CPU,持锁者可以全速跑完临界区再放下一个线程进来,总时长近似「临界区时长 × 操作数」,几乎不随线程数恶化。
spin 一侧是另一条曲线。w30000 档 8 线程达到 134.79 µs/op,是单线程 36.51 µs 的约 3.7 倍;sleep 档更加极端,8 线程冲到 2780.16 µs/op,也就是单次操作 2.78 毫秒,相对单线程的 156.51 µs 膨胀约 17.8 倍,是同档 mutex 的 17.3 倍。机器只有两个 SMT 上下文,8 个线程里最多两个同时在跑,其余六个本应休眠;但 spin 不让线程休眠,所有线程都在忙等环里烧周期,真正持锁的线程反而被抢占、被稀释执行资源,临界区被拉得更长,等待者又因此空转更久,形成正反馈。临界区里含睡眠时这一点最致命:持锁者自己 nanosleep 让出 CPU,等待者却在另一个上下文里全速空转,账单一部分就是这样累积出来的。
五、perf stat 佐证:切换数、IPC 与墙钟
曲线给出的判断可以用硬件计数器复核。固定 4 线程,在最短的 w1 与最长的 sleep100us 两档分别对三锁跑 perf stat,下面摘录 spin 两组与 mutex 长临界区组的原始计数:
 Performance counter stats for 'env FILTER_LOCK=spin FILTER_CS=w1 FILTER_THREADS=4 ./bin/lock_bench':

             2,028      context-switches
       423,825,035      instructions              #    0.67  insn per cycle
       0.511751230 seconds time elapsed

 Performance counter stats for 'env FILTER_LOCK=spin FILTER_CS=sleep100us FILTER_THREADS=4 ./bin/lock_bench':

             9,569      context-switches
     1,736,131,627      instructions              #    0.14  insn per cycle
       2.487516901 seconds time elapsed

 Performance counter stats for 'env FILTER_LOCK=mutex FILTER_CS=sleep100us FILTER_THREADS=4 ./bin/lock_bench':

             9,215      context-switches
       400,461,299      instructions              #    1.13  insn per cycle
       1.221625792 seconds time elapsed
上下文切换数本身区分不了锁的好坏——sleep 档三锁都在 9200–9600 次之间,因为 100 微秒的睡眠本身就会触发调度;w1 档三锁也都在两千次出头。真正说话的是 IPC 与墙钟。spin 跑 sleep 档时执行了 17.36 亿条指令、IPC 只有 0.14,意味着绝大部分周期耗在缓存未命中和反复重试的原子指令上,用户态时间累计 3.86 秒,墙钟 2.488 秒;同样的负载 mutex 只执行 4.00 亿条指令、IPC 1.13,墙钟 1.222 秒,adaptive 为 1.219 秒。忙等锁用四倍多的指令、一半的 IPC,换来了两倍的墙钟——这就是「烧 CPU」在计数器上的样子。
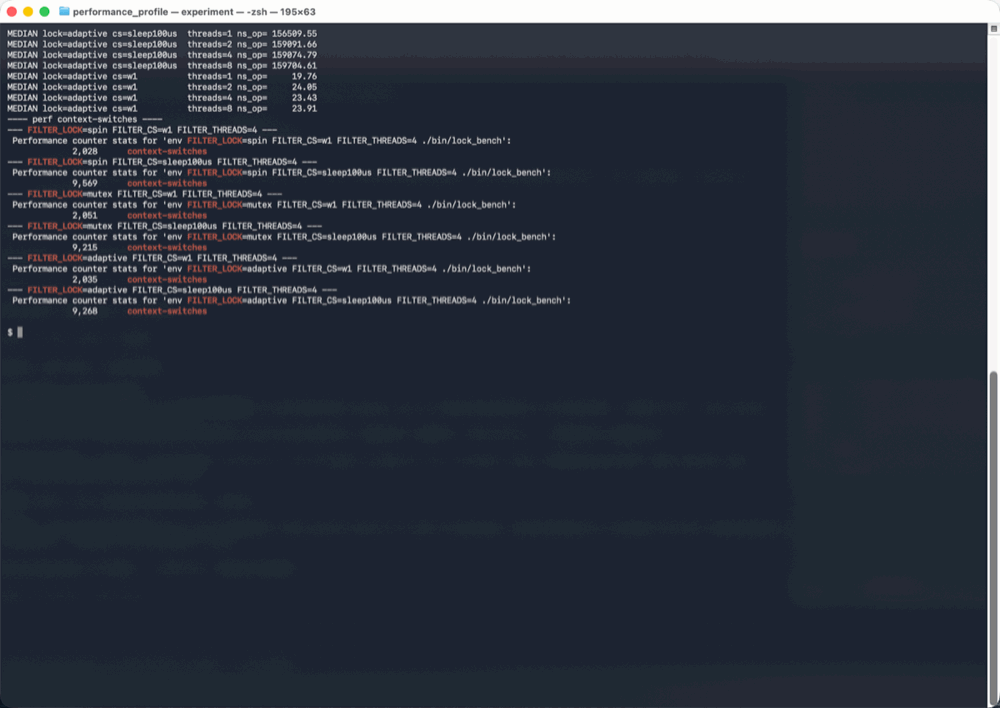
图中上半部分是 adaptive 锁在最短 w1 与最长 sleep100us 两档的 MEDIAN 行,每档四个线程数纵向读下来,数字始终贴在同一量级:w1 稳定在 20–24 ns,sleep 档稳定在 15.7–16.0 µs,印证休眠锁不随线程数恶化;下半部分六段 perf 输出里,spin-sleep 一段 9569 次切换与前面读到的 0.14 IPC、2.488 秒墙钟在三组对照中明显突兀,而 mutex 与 adaptive 的同档数字几乎重合,说明进入长临界区后自适应锁的自旋预算基本用不上,两者退化成同一条 futex 路径。
六、选型拐点与适用边界
把全部数据压缩成一张决策表,维度只保留工程上真正影响选择的三个:临界区长度、竞争形态、临界区内是否可能睡眠。
| 场景 | 推荐 | 数据依据 |
|---|---|---|
| 极短临界区(几 ns)、确定无竞争或单线程 | spin | w1 单线程 8.25 ns,比另两锁便宜一半以上 |
| 短临界区、竞争存在或线程数不确定 | adaptive | w1 四/八线程稳定 23–24 ns,竞争下最优 |
| 临界区百纳秒以上、追求跨平台可移植 | mutex | w30000 八线程 38.89 µs,增量仅约 7%,标准库接口 |
| 临界区内有睡眠、IO、定时器或可能变长 | 只能 mutex/adaptive | spin 的 sleep 档八线程 2.78 ms/op,禁用 |
| 临界区长度不可预测的通用业务锁 | adaptive 或 mutex | 短档不吃亏,长档自动退回 futex,风险单向 |
三条边界必须写明。第一,全部数字来自 1 物理核 2 SMT 的超额订阅拓扑,自旋锁的恶化程度与物理核数、SMT 占比强相关,多核物理机上 spin 的拐点位置会不同,不能把这里的倍差直接外推;第二,PTHREAD_MUTEX_ADAPTIVE_NP 是 glibc/Linux 专属,跨平台代码需要用条件编译或退回 std::mutex,而且自适应锁的自旋次数是 glibc 内部常量,不同 glibc 版本的预算可能调整,本篇的拐点绑定本机这个实现;第三,云主机存在邻居噪声与调度抖动,五次独立进程取中位就是为了压平单次异常,引用单个格子的数字时应连同中位口径一起理解,而不是当成普适常数。
还有一个常被忽略的反面场景:自旋锁并不只在长临界区里吃亏。即使临界区只有几纳秒,只要线程数长期超过可用硬件上下文,忙等环一样会和持锁者争抢执行资源,w1 档 spin 从单线程 8.25 ns 抬到 8 线程 56.42 ns 就是证据。反过来,在核数充裕、线程数不超过物理核且临界区确定极短的系统里,自旋锁避免系统调用的优势依然真实存在,低延时交易系统里的用户态运行到完成模型正是这个前提,只是这份基准的拓扑不具备验证它的条件。
实验环境
- 机器/系统:腾讯云上海竞价 CVM,S6.MEDIUM8,1 物理核 2 SMT 线程,Intel Xeon Platinum 8374C @2.70GHz,Ubuntu 22.04.5 LTS,内核 5.15.0-190-generic
- 工具版本:g++ 11.4.0,
-O2 -std=c++17 -pthread;perf 5.15 - 日期:2026-11-13
- 完整命令:
make && bash run.sh,每个「锁 × 临界区级 × 线程数」格子跑五个独立进程取中位,随后用perf stat加FILTER_LOCK/FILTER_CS/FILTER_THREADS环境变量定点采集 w1 与 sleep100us 两档的上下文切换、指令数与墙钟
代码获取
完整可复现工程(三种锁封装、六档临界区负载、无锁校准、五进程中位编排与 perf 采集脚本)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-spin-mutex-futex-critical-section
- 复现方式:克隆后进入该目录执行
make && bash run.sh,输出校准行、五次 RESULT 与 72 个 MEDIAN 行;perf 段需要 sudo,在 Linux/glibc 环境运行,macOS 因缺少自适应锁接口无法编译该目标。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的并发与同步分组。锁类型全景与选型语义看 C++ 标准库提供的 Mutex 类型详解,低延时工程的完整模式地图看低延时设计模式全景。原子操作在多核上的争用代价与本篇自旋环同源,实测见 shared_ptr 引用计数争用;多线程下「消除共享」比「优化锁」更彻底的例子,可对照 arena 内存池实测里每线程独立分配块的做法。
总结
锁与临界区长度的关系,可以用三句话概括。其一,极短临界区且无竞争时自旋锁最便宜,w1 单线程仅 8.25 ns/op,但它随竞争近似线性恶化,8 线程升到 56.42 ns,而自适应锁靠「先自旋、抢不到再休眠」在竞争下把 w1 稳定在 23–24 ns,是短临界区争用场景的最优解。其二,临界区拉长后账单反转:休眠锁在 36.5 µs 临界区下八线程仍只付约 7% 的等待增量,自旋锁却恶化到 3.7 倍,含睡眠的临界区更是冲到 2.78 ms/op、是互斥锁的 17.3 倍,perf 数据显示其 IPC 仅 0.14、墙钟两倍于休眠锁,忙等空转的代价有明确的计数器物证。其三,选型的核心判据是等待时长是否可预期:确定短、确定无竞争才用自旋;竞争不确定或临界区可能变长,自适应锁与互斥锁的风险是单向的;临界区内只要可能睡眠或阻塞,自旋锁一律禁用。以上数字绑定 1 核 2 SMT 的超额订阅环境与五次中位口径,换拓扑后拐点位置需要重新实测。