arena 内存池:百万级短生命周期对象,bump 分配加整批 reset 比 new/delete 快多少
解析器里的 AST 节点、协议栈里的一帧报文、编译器 IR 里的临时指令,都有一个共同特征:数量巨大、尺寸不一、同一批对象几乎同时出生、同时死亡。对这类负载,逐个 new/delete 等于让通用分配器为每个对象付一次簿记和加锁的钱。低延时设计模式全景把 arena(竞技场分配器,也叫 bump allocator、region allocator)列为消除热路径动态分配的核心模式之一。本篇用一个可复用 arena 正面对打:单线程三档尺寸、多线程 1/2/4/8 线程三种形态,把快多少、为什么快、代价是什么记成可复现的账。它与 placement new 对象池实测互补——那篇管同尺寸对象的单个 create/destroy,本篇管变长对象的整批生命周期。
本文要回答的问题
- bump 指针分配与整批 reset 怎样工作,为什么不需要逐个 free?
- 百万个短生命周期对象、三种尺寸下,arena 比裸
new/delete快多少,尺寸变大怎样影响倍差? - 多线程争用时,每线程独立 arena、共享带锁 arena、裸
new/delete三条路差距有多大? - 省下来的成本在分配计数账上长什么样,预付的内存与 RSS 代价是多少?
- 什么场景值得引入 arena,它和固定块对象池、分配器线程缓存之间怎么选?
先用一张对比卡把两种内存管理方式的关键差异固定下来,后面的实现与实测逐项验证这张卡。
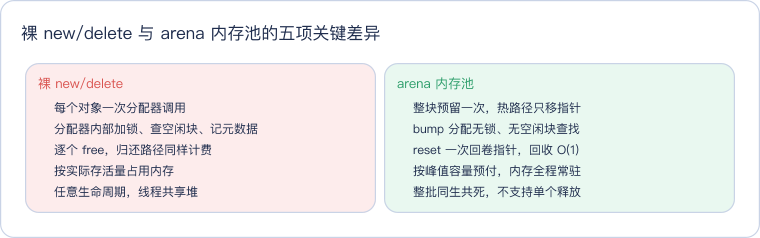
读这张卡抓住一条主线:通用分配器按对象计费,arena 按整批计费。能不能用 arena,本质是业务对象能不能接受「同生共死」。
一、arena 的工作方式:大块预留、指针碰撞、整批 reset
arena 的全部机制可以画在一块连续内存里。构造时一次性申请一大块预留存储,块内维护当前指针 cur_;每次分配把 cur_ 按对齐要求向上取整、前移请求字节数并返回旧地址,这就是指针碰撞(bump)分配——没有空闲链表、块合并与系统调用。整批对象用完后,reset() 只把 cur_ 回卷到块首,下一轮覆盖旧内容。
读图抓住三个位置:块内从左到右是时间顺序,cur_ 是已分配区与空闲区的边界;对齐规则作用在每次分配入口;reset() 一步回到块首。两个固有约束也在图里:arena 只分配原始存储,非平凡类型要调用方自己配对 placement new 与显式析构;没有单个释放,提前归还只能等 reset。
二、可复用实现:Arena 与带锁的 LockedArena
基准工程里的 Arena 只有三个指针成员,allocate 的全部工作是一次对齐取整加一次边界比较:
class Arena {
public:
    explicit Arena(std::size_t capacity)
        : base_(static_cast<unsigned char*>(::operator new(capacity))),
          cur_(base_), end_(base_ + capacity) {}
    ~Arena() { ::operator delete(base_); }

    void* allocate(std::size_t size, std::size_t alignment = 16) {
        std::uintptr_t p = reinterpret_cast<std::uintptr_t>(cur_);
        p = (p + alignment - 1) & ~(alignment - 1);  // 向上对齐
        if (p + size > reinterpret_cast<std::uintptr_t>(end_)) return nullptr;
        cur_ = reinterpret_cast<unsigned char*>(p + size);
        return reinterpret_cast<void*>(p);
    }
    void reset() noexcept { cur_ = base_; }  // 整批回收,不进分配器
private:
    unsigned char *base_, *cur_, *end_;
};
多线程实测需要两个变体。每线程独立 arena 由线程局部持有自己的块,线程间零共享,分配路径连原子指令都没有;共享带锁 arena 在 allocate 外包一层 std::mutex,量化争抢时锁的价格。
class LockedArena {
public:
    explicit LockedArena(std::size_t capacity) : arena_(capacity) {}
    void* allocate(std::size_t size, std::size_t alignment = 16) {
        std::lock_guard<std::mutex> lock(mu_);
        return arena_.allocate(size, alignment);
    }
private:
    std::mutex mu_;
    Arena arena_;
};
带锁版本的临界区极短;但正因为极短,锁开销在单次成本里占比反而显眼。
三、基准设计:两组生命周期模式与一道逃逸屏障
单线程组做批量建、批量毁:100 万个对象,尺寸取 32、128、256 字节三档。裸路径把指针存进 vector,全部建好并写入校验数据后统一 delete;arena 路径在 512 MiB 预留块里连续 bump 出 100 万个对象,随后一次 reset()。多线程组固定 32 字节、每线程 20 万个,线程数扫 1/2/4/8:裸路径每线程独立 new/delete,arena-thread 持 16 MiB 私有块,arena-shared 在 128 MiB 带锁块上碰撞。
计时统一用 std::chrono::steady_clock,进程内每格 5 轮取中位,外层脚本 7 次再取中位。两个防作弊措施:逃逸屏障 asm volatile("" : : "r"(p) : "memory") 强制分配结果被真实使用,否则编译器会消除不逃逸的 new/delete 对;每个对象按 16 字节步进写入校验字节,保证两条路径访存代价相同。系统侧资源由 /usr/bin/time -l 采集驻留集、缺页与上下文切换。
四、单线程实测:32 字节档快 4.8 倍,尺寸越大倍差越小
七轮中位汇总在下图左面板,橙柱是裸 new/delete,蓝柱是 arena,柱顶绿字是加速倍数。
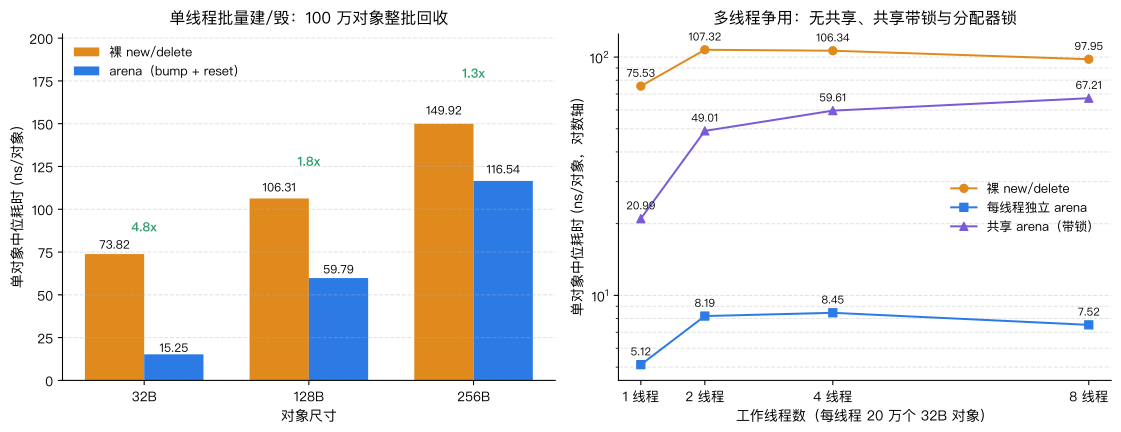
左面板的趋势比绝对数字更重要。32 字节档 arena 只要 15.25 ns/对象,裸分配 73.82 ns,加速 4.8 倍;128 字节档缩到 1.78 倍;256 字节档只剩 1.29 倍。倍差收窄不是 arena 变慢——它的分配动作始终是一次指针加法——而是每条路径都要写入校验数据,对象越大,访存成本占比越高,分配器的固定开销被稀释。arena 的红利集中在小对象洪流;对象逼近缓存行量级后,瓶颈转移到内存带宽。
| 对象尺寸 | 裸 new/delete (ns) | arena (ns) | 加速倍数 |
|---|---|---|---|
| 32 B | 73.82 | 15.25 | 4.84 |
| 128 B | 106.31 | 59.79 | 1.78 |
| 256 B | 149.92 | 116.54 | 1.29 |
O0 档方向一致,32 字节档 116.53 对 27.76 ns、仍有 4.2 倍;malloc 是预编译库函数、不受本工程优化档位影响,这与 placement new 对象池实测里 O0 倍差收窄同源,评估这类优化必须以发布档位为准。
五、多线程争用:每线程 arena 一骑绝尘,共享带锁被锁税拖垮
右面板三条对数曲线是三个不同的故事。裸 new/delete(橙线)从单线程 75.53 ns 抬到双线程 107.32 ns 后居高不下——线程各自独立 new/delete,看似无共享,实际争的是分配器内部的堆锁与线程缓存簿记。每线程独立 arena(蓝线)全程贴在 5–9 ns 窄带,8 线程下 7.52 ns/对象、聚合吞吐约 1.56 亿对象/秒,对裸路径 97.95 ns 加速约 13 倍。共享带锁 arena(紫线)随线程数单调恶化:单线程 20.99 ns,8 线程涨到 67.21 ns,分配被互斥锁完全串行化。
多线程首轮输出如下,汇总取七轮中位:
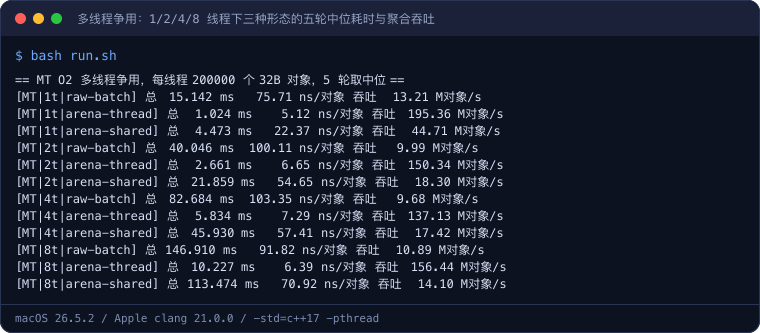
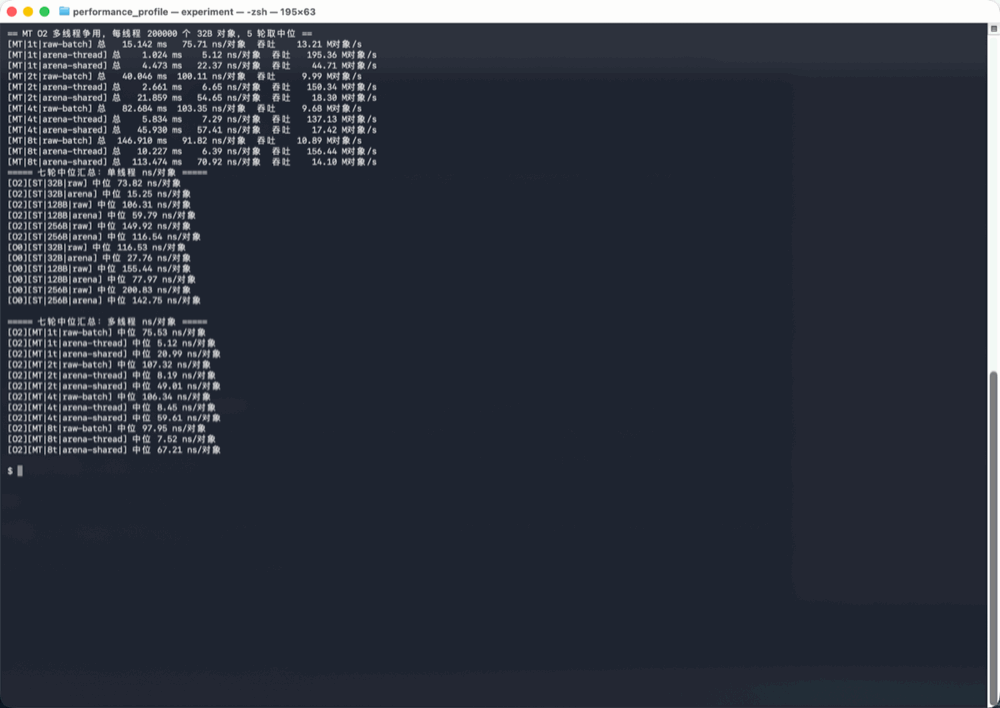
上图上半部分是多线程首轮的五轮中位与聚合吞吐,下半部分是 O2/O0 两档的七轮中位汇总。沿 1/2/4/8 线程横着读,arena-thread 一行始终压在 5–9 ns 窄带,arena-shared 从 20.99 ns 单调抬到 67.21 ns,raw-batch 则在百纳秒附近居高不下,三条路径的分化在八线程档拉到最大。
图中最有工程价值的一行是 8 线程对照:每线程 arena 总耗时 10.2 ms 就分发完 160 万个对象,共享带锁要用 113.5 ms,裸 new/delete 要 146.9 ms。结论很直接——多线程下应按线程切分 arena 实例,而不是给共享块加锁;其锁税与 shared_ptr 引用计数争用里的全局串行点同源。
分配计数账给出机制物证。单轮 32 字节档,裸路径是 100 万次 new 加 100 万次 delete、累计申请 4000 万字节;arena 路径只有 1 次 512 MiB 大块申请,reset 不产生分配器调用。四线程组裸路径发生 80 万次业务分配,两种 arena 形态的业务大块分配分别只有 4 次和 1 次(零头来自线程与 vector 簿记):
[count|ST-32B-raw]   new=1000001 次/40000000 字节  delete=1000001 次
[count|ST-32B-arena] new=1 次/536870912 字节  delete=1 次(reset 不进分配器)
[count|MT-4t-raw-batch] new=800020 次/166218136 字节  delete=800018 次
[count|MT-4t-arena-thread] new=20 次/201327000 字节  delete=18 次
[count|MT-4t-arena-shared] new=16 次/134218136 字节 delete=14 次系统侧数据同样有交代。/usr/bin/time -l 记录的最大驻留集约 744.8 MB,主体是预付的 512 MiB arena 加裸路径的百万指针数组;缺页仅 4 次、自愿上下文切换为 0。非自愿切换 35 万次是 8 线程组在 6 物理核上被抢占的痕迹。这份常驻是固定账单:哪怕一轮只活十个对象,512 MiB 也不会提前归还。
六、工程取舍:什么时候上 arena,和对象池怎么分工
适合 arena 的场景有三个共同条件:对象成批出生、成批死亡(请求级、帧级、编译单元级);尺寸不一或类型异构,固定块池装不下;峰值容量可预估,愿意按峰值预付内存。AST、序列化缓冲、网络帧工作区都是典型落点。生命周期交错、需要单独释放或峰值不可控的长期对象,整批语义不适用。
与相邻方案的分工:固定尺寸、需要单个 create/destroy 的同型对象交给 placement new 对象池;不想改业务代码时,jemalloc、tcmalloc 的线程缓存是渐进式替代;判断 new 是否真是瓶颈的手段与 std::function 堆分配阈值实测相同——先重载 operator new 计数。多线程部署记住:每线程独立 arena 远优于共享带锁 arena,后者 8 线程下已退化到裸分配量级。
实验环境
- 机器/系统:MacBook Pro(MacBookPro16,1),Intel Core i7-9750H @2.6GHz,6 物理核 12 逻辑线程,16 GB,x86_64 / macOS 26.5.2(Build 25F84)
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),
-std=c++17 -Wall -Wextra -pthread,O2/O0 双档各 7 轮取中位,进程内每格 5 轮取中位 - 日期:2026-11-13
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh跑完单线程三档尺寸、多线程 1/2/4/8 线程三形态与单轮分配计数 delta → 重载operator new/operator delete(含对齐版)统计分配次数与字节 →/usr/bin/time -l采集 RSS、缺页与上下文切换(macOS 无 perf 的平台替代口径)
代码获取
完整可复现工程(Arena 与 LockedArena、operator new/delete 全套重载计数、单线程三档与多线程扫档负载、O2/O0 双目标与七轮中位编排)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-arena-pool-allocator-benchmark
- 复现方式:克隆后进入该目录执行
bash run.sh,约两分钟输出两档七轮中位、分配计数 delta 与系统侧资源数据;其他平台与分配器(glibc malloc、jemalloc、tcmalloc)下的数字需重新实测。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的对象模型与内存管理分组。模式全景见低延时设计模式全景;同尺寸对象的单对象级池化看 placement new 对象池,分配计数方法与 std::function 堆分配阈值共用一套 operator new 重载口径,多线程锁争用与 shared_ptr 引用计数争用同源。
总结
在百万级短生命周期对象的正面对打中,arena 内存池把通用分配器的逐对象计费换成整批计费:大块预留一次付清,热路径只剩一次对齐加指针碰撞,回收靠 reset() 回卷指针、O(1) 且不进分配器。单线程下 32 字节档 15.25 对 73.82 ns、快 4.8 倍,倍差随尺寸增大收窄到 1.29 倍;多线程下每线程独立 arena 在 8 线程时保持 7.52 ns/对象、比裸 new/delete 快约 13 倍,共享带锁 arena 被锁税拖到 67.21 ns,证明无共享才是并行正道。分配账显示百万次 new/delete 被压缩成一次 512 MiB 大块申请,代价是 744.8 MB 峰值驻留与内存常驻。它适合成批同生共死、尺寸异构、峰值可预估的负载;需要逐个释放的同型对象交给 placement new 对象池,不想改代码则先评估带线程缓存的通用分配器,上线前先用分配计数器确认 new 真是瓶颈。