Sanitizer 运行时开销:ASan、TSan、UBSan 的 CPU 与内存代价实测
C++ 性能实测系列第十六篇。崩溃排查主线里的 ASan 原理篇、TSan 原理篇与 Valgrind 原理篇回答的是「出了问题怎么查」:ASan 在错误发生的那一刻抓内存越界,TSan 靠运行时追踪 happens-before 关系抓数据竞争,Valgrind 不用重编译但慢。本篇换一个工程视角,回答「为了获得这些检测能力,正常运行时要付多少账单」。同一个程序、同一份负载,分别用五种构建编译,把 CPU 耗时和峰值 RSS 的相对倍数量出来,再用一次可控的数据竞争把 TSan 的检测链路跑通,最后给出 CI 各环节的开启策略。
本文要回答的问题
- ASan、UBSan、TSan 在编译期和运行期各自往程序里加了什么,开销来源是什么?
- 同一份混合负载下,三种 Sanitizer 的 CPU 倍数和内存倍数分别是多少?
- 为什么 ASan 和 TSan 不能在同一次链接里混用,ASan+UBSan 组合的代价能不能接受?
- TSan 报数据竞争时输出长什么样,加锁或原子化修复后能否复跑到零报告?
- CI 的 PR 门禁、夜间定时集成测试、发布构建三个环节,分别应该开哪一档?
一、三种 Sanitizer 各自给程序加了什么
讨论倍数之前先看清钱花在了哪里。三个 Sanitizer 都属于编译期插桩方案:clang 在编译每个翻译单元时改写你的指令序列,并链接一个对应的运行时库;区别在于插桩点和运行时维护的数据结构完全不同。
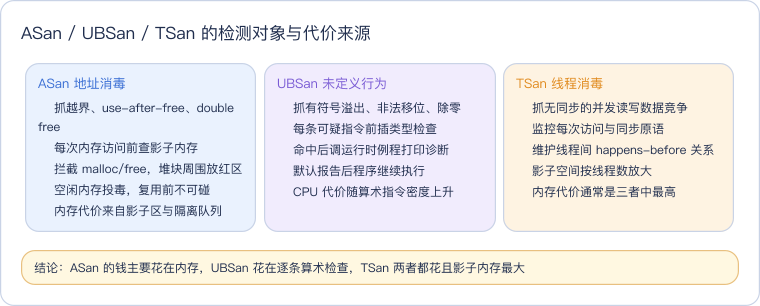
读这张卡抓住一条主线:三者的成本结构不同,不能用一个「Sanitizer 都很慢」的笼统印象替代。ASan 的核心设施是影子内存——程序地址空间按固定比例映射一片影子区,每个应用字节的可访问性存在影子字节里,每次 load/store 前多几条查表指令;分配器再给每个堆块加红区、把释放的块放进隔离队列延迟复用。UBSan 不维护大体积状态,它在有符号加法、移位、枚举转换等指令前插入条件检查,未触发时只是多几条比较和分支,触发时才调用诊断例程。TSan 最重,它要为每个内存位置记录多个线程的访问时间戳集合,还要拦截 mutex、atomic、线程创建等全部同步事件来构建 happens-before 边,影子空间随线程数量膨胀。
下图把三条插桩链路画在一张图里。灰色是不变的输入,蓝、紫、橙分别是三种插桩路径,红色是共同的诊断出口。
图中三条路径共享同一个出口,但中止策略不同:ASan 与 TSan 命中问题后默认中止进程(本篇 TSan 演示在退出时即以 Abort trap 收束),UBSan 默认打印诊断后继续执行,因为很多未定义行为在当前平台上仍能产出确定值,是否当致命错误处理交给工程自己决定。机制层面的完整展开可以对照 ASan 原理篇与 TSan 原理篇,本篇只量化它们的运行时价格。
二、基准设计:一个程序承载四类负载,五种构建同口径
要让五个二进制的数字可以直接相除,负载必须完全同构。基准程序 bench.cpp 内部串了四个阶段,每个阶段针对一类插桩点,最后把各阶段结果混合成一个 checksum 打印,五档构建的 checksum 必须完全相同,先证语义等价再谈快慢。
| 阶段 | 负载内容 | 规模 | 主要吃哪类插桩 |
|---|---|---|---|
| 分配释放 | 字符串构造拼接 + 链表头插销毁 | 2000 轮,约 9.6 万次 malloc/free | ASan 分配器拦截与红区 |
| 数组遍历 | 16 MB vector<int> 三趟读写 | 1200 万次访问 | ASan 影子内存查表 |
| 整数算术 | 有符号加乘,全程合法区间 | 4000 万次操作 | UBSan 逐操作检查 |
| 多线程 | 4 线程原子计数 + 线程内求和 | 400 万次 atomic 自增 | TSan happens-before 追踪 |
五个构建分别是:裸 -O2、-fsanitize=undefined、-fsanitize=address、-fsanitize=address,undefined 组合档、-fsanitize=thread,统一 -O2 -g -std=c++17,优化级别保持一致才能把差异干净地归因到插桩本身。计时在进程内用 steady_clock 包裹四个阶段,RSS 在进程外用 /usr/bin/time -l 的 maximum resident set size 采集;每档连跑 7 个独立进程取中位,偶发调度抖动由中位值吸收,这也是并发基准测量方法推荐的稳健口径。
有一个硬约束必须写明:ASan 与 TSan 的运行时互斥,不能在同一次链接中同时启用,clang 会直接拒绝。两者都要接管全部内存访问并各自维护影子结构,组合在工程上不成立;因此组合档只存在 ASan+UBSan,TSan 永远单独成档。
三、CPU 开销:最贵的不是 ASan,而是算术检查的密度
七轮中位汇总如下,倍数全部以裸档为分母。
| 构建 | 计时中位 (ms) | CPU 倍数 | 峰值 RSS (KiB) | 内存倍数 | checksum |
|---|---|---|---|---|---|
| 裸 -O2 | 142.938 | 1.00× | 16300 | 1.00× | 4970740138870488 |
| UBSan | 215.729 | 1.51× | 26052 | 1.60× | 4970740138870488 |
| ASan | 160.471 | 1.12× | 36804 | 2.26× | 4970740138870488 |
| ASan+UBSan | 254.994 | 1.78× | 36868 | 2.26× | 4970740138870488 |
| TSan | 230.005 | 1.61× | 79784 | 4.89× | 4970740138870488 |
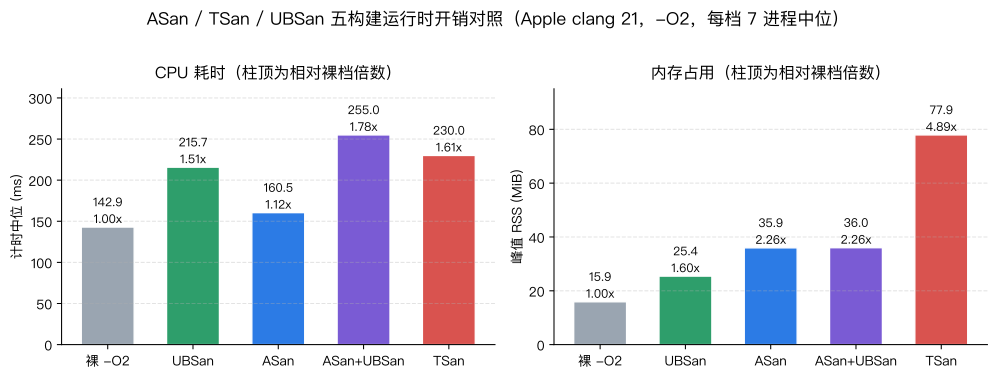
这张双面板图要对着成本结构读。左面板里最反直觉的是 ASan 只有 1.12×——它并没有传说中「慢两三倍」。原因在负载构成:4000 万次算术操作占了裸档相当大的耗时,而算术指令上 ASan 几乎不插手,影子查表只落在数组遍历和分配路径上;真正被 ASan 放大的是内存密集型代码,本程序这部分占比有限。反过来 UBSan 达到 1.51×,因为 4000 万次加乘每条前面都挂了溢出检查,检查指令数与算术指令数严格成正比。组合档 1.78× 大致是两者的叠加,没有出现协同恶化。TSan 的 1.61× 主要来自线程阶段对 atomic 操作和线程创建的拦截,本例线程生命周期短、同步点不多,倍数同样偏保守。
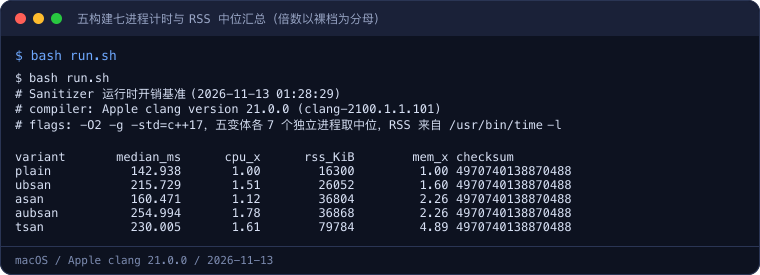
终端记录里每一档的 checksum 都是同一个值,证明五份二进制跑完了同样的计算量,耗时差异可以归因到插桩而非语义偏差。需要强调这组倍数的适用边界:它描述的是「分配密集加数组遍历加算术加短线程」这种混合形态。如果换成纯指针追踪、链表跳转的负载,ASan 的倍数会显著上升;换成几十个长驻线程的服务,TSan 的 CPU 和内存都会更高。引用任何 Sanitizer 开销数字时,都应该同时引用它的负载形态。
四、内存开销:影子内存决定 2.26× 与 4.89×
右面板的排序与 CPU 完全不同。ASan 把约 16 MiB 的裸档进程推到约 36 MiB,稳定的 2.26×;TSan 进一步推到约 78 MiB,4.89×;UBSan 最轻,1.60× 且主要是运行时库自身的驻留。
ASan 的 2.26× 可以拆成两部分理解。其一是影子内存映射,经典影子编码下应用地址与影子字节按 8:1 映射,光影子区就是应用内存的八分之一量级;其二是堆块红区与隔离队列,每个 malloc 块前后插入可检测的毒化字节,释放的块不立即归还分配器而是排队隔离,use-after-free 才能在释放后的窗口期被抓到,这使得同等申请量下实际驻留明显变大。double free 排查篇里那些释放后又被复用的场景,靠的就是隔离队列留出的取证窗口。
TSan 的 4.89× 是三者中最高的,且对线程数敏感。它要为每个被监控的应用地址保存多个线程的写读时间戳(Shadow 里每个机器字对应一组向量时钟分量),还要为每个线程维护独立栈与事件缓冲;4 线程的小例子已经接近五倍,真实服务里几十个线程时内存压力会进一步放大,这决定了 TSan 不适合跑进资源受限的容器,而应放进规格独立的夜间定时任务。UBSan 不维护按地址比例膨胀的状态,1.60× 里大部分是运行时库与诊断字符串的固定成本,进程再大这个倍数也会被摊薄。
五、TSan 数据竞争实跑:从真实报告到零报告对照
开销数字之外,检测能力必须真跑一遍才算数。单独的 race_demo.cpp 制造一个可控竞争:两个线程各对同一个普通全局 int 做一百万次无同步自增。TSan 构建下报告如实出现,两段写栈分别指向两个工作线程,位置段点名全局变量 shared_counter。
WARNING: ThreadSanitizer: data race (pid=63564)
  Write of size 4 at 0x00010b84f000 by thread T2:
    #0 bump() race_demo.cpp:16 (race:x86_64+0x1000007b5)

  Previous write of size 4 at 0x00010b84f000 by thread T1:
    #0 bump() race_demo.cpp:16 (race:x86_64+0x1000007b5)

  Location is global 'shared_counter' at 0x00010b84f000 (race+0x100003000)
SUMMARY: ThreadSanitizer: data race race_demo.cpp:16 in bump()
ThreadSanitizer: reported 1 warnings
racy build data-race warnings: 1
报告的读法在 TSan 数据竞争报告怎么读里有完整展开,这里只抓与本篇论证相关的三点:两行 Write 栈说明两个线程对同一地址各写了一次且中间没有 happens-before 边;Location 段确认目标是全局变量而非栈或堆,排查范围立刻收窄;计数为 1 表示整个运行只报了这一类问题。进程在报告输出后以 Abort trap 退出,这是 TSan 命中后的默认策略。
修复手段是把普通 int 换成 std::atomic<int>,自增改用 fetch_add,用同一份 TSan 构建重新编译运行。
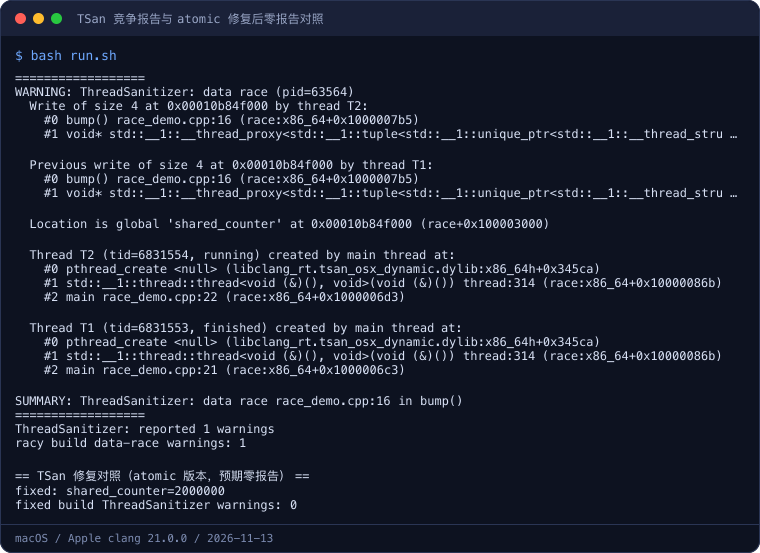
对照运行的 ThreadSanitizer warnings: 0 与最终计数 2000000 同时成立:修复没有改变业务结果,只是给两次自增补上了顺序保证,原症状在复跑中完全消失。这构成一次完整的闭环——根因由原始诊断的两段写栈支持,修复复跑覆盖原症状。同一场景如果用 ASan 排查会一无所获,数据竞争不属于内存错误,工具选型的边界在崩溃排查工具簇的分工里有更细的对比。
UBSan 的检测链路同样实跑验证:一个独立小程序在运行期触发有符号溢出与 32 位类型上的移位 32,两条 runtime error 诊断按预期打印,程序带着结果继续执行到结束,印证了第一节说的「默认不中止」策略。至于 ASan 报告本身的逐段解读(heap-use-after-free、影子内存转译、alloc/free 双栈对齐),是 ASan 报告怎么看的主题,本篇不重复。
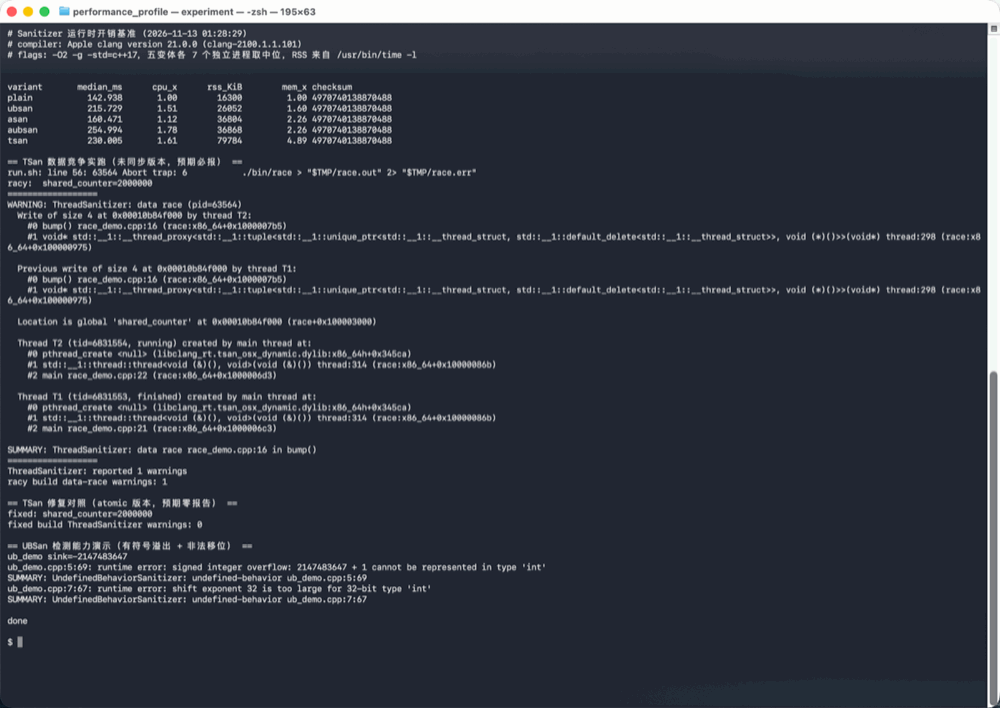
图中上半段是五档构建的计时与 RSS 中位表,下半段是 TSan 从报告到零警告的完整对照,两份输出来自同一次脚本运行,样本行与汇总行可以互相核对。
六、CI 应该怎么开:从倍数推导出的分档策略
把实测倍数翻译成流水线动作,关键不是追求「全开」,而是按环节的时间预算与内存预算匹配工具。
| CI 环节 | 建议档位 | 依据(本篇实测) | 注意事项 |
|---|---|---|---|
| PR 门禁单测 | ASan+UBSan 组合档 | 1.78× CPU、2.26× 内存,一次运行覆盖内存错误与未定义行为 | 单测套件通常能承受近一倍的拉长 |
| 夜间集成测试 | TSan 独立任务 | 4.89× 内存且随线程数放大,需要独立规格的执行机 | 与 ASan 互斥,只能单独构建单独跑 |
| 发布生产二进制 | 不带 Sanitizer | 插桩指令与运行时库永久留在产物里 | 检测是测试期手段,不随产物发布 |
| 无法重编译的现场二进制 | Valgrind 兜底 | 无需插桩,代价是更重的动态翻译 | 适合临时取证,不适合常态化门禁 |
PR 门禁选 ASan+UBSan 组合而不是只开 ASan,有两条数据支撑:组合档相对纯 ASan 只把 CPU 从 1.12× 推到 1.78×,内存几乎不变(同为 2.26×),却白捡了全部未定义行为覆盖;而 UBSan 单独抓出的有符号溢出、非法移位这类问题,ASan 在结构上就看不见。TSan 放进夜间定时而非 PR 门禁,首先因为 4.89× 的内存倍数在共享、受限的门禁容器里容易触发 OOM,其次因为数据竞争需要足够的线程交错密度才有命中率,更适合跑时长更长的集成测试;夜间定时任务还应把失败产物的完整 TSan 报告归档,报告里的两段栈是定位的唯一线索。
两个工程细节补在最后。一是 Sanitizer 构建要带 -g,否则诊断栈只有地址没有源码行,报告价值大打折扣,本篇所有构建都统一带了 -g。二是倍数会随负载漂移,落地自己的服务前,应当用与本篇同构的方法在生产工具链上复测——同系列异常开销实测与 LTO 三档实测都遵循这个口径,外部数字只能用来判断量级,不能替代自己 workload 下的测量。
实验环境
- 机器/系统:MacBook Pro(Intel Core i7-9750H,6 物理核 12 逻辑线程,16 GB,x86_64)/ macOS 26.5.2(Build 25F84)
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),统一编译参数
-O2 -g -std=c++17 -Wall,演示程序用-O1 -g - 日期:2026-11-13
- 完整命令:
make all构建五个 bench 变体与 race、race-fixed、ub-demo 共八个目标 →bash run.sh每档 7 个独立进程,进程内steady_clock计时、进程外/usr/bin/time -l采 maximum resident set size,取中位并计算相对裸档倍数 → 实跑 TSan 竞争版与 atomic 修复版对照、UBSan 双诊断演示 - 测量局限:单机单负载实测,倍数只对本程序的混合负载形态成立;算术密集会抬高 UBSan 倍数、内存密集会抬高 ASan 倍数、线程数增加会抬高 TSan 的内存倍数,不得外推为所有 workload 的固定常数
代码获取
完整可复现工程(四阶段负载、可控竞争演示、UBSan 演示、Makefile 与 run.sh 编排、实测 results.txt)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-asan-tsan-ubsan-overhead
- 复现方式:克隆后进入该目录执行
make all && bash run.sh,约一分钟输出五档计时与 RSS 中位、TSan 竞争报告及修复对照、UBSan 诊断演示;可用RUNS=11 bash run.sh提高样本数观察离散程度。
这一篇在知识体系里的位置
本篇是 C++ 性能实测系列与崩溃排查主线的交叉点。ASan 原理篇、TSan 原理篇、Valgrind 原理篇讲清三个工具的检测机制与报告读法,解决「怎么查错」;本篇补上同口径的运行时成本账本,解决「日常该怎么开」。性能系列内部,它与异常开销实测、LTO 三档实测方法学一致——同构负载、多进程中位、checksum 一致性校验、结论绑定负载形态;排查系列内部,TSan 报告解读与 ASan 报告解读承接本篇演示里两份报告的逐段分析。
总结
在同一份四阶段混合负载上,五种构建的 Sanitizer 运行时开销得到量化:ASan 的 CPU 代价仅 1.12× 但内存达 2.26×,钱花在影子内存与隔离队列;UBSan 因 4000 万次逐条算术检查达到 1.51× CPU、内存仅 1.60×;ASan+UBSan 组合档 1.78× CPU、2.26× 内存即可同时覆盖两类问题;TSan 为 happens-before 追踪付出 1.61× CPU 与最高的 4.89× 内存,且与 ASan 链接互斥。可控数据竞争在 TSan 下如实报出两段写栈,改 atomic 后同构建复跑零报告、业务计数不变,闭环成立。落到 CI:PR 门禁开 ASan+UBSan 组合档,TSan 放进独立规格的夜间定时集成任务,发布产物不带任何 Sanitizer,所有倍数在自己的 workload 上复测后再引用。