自动向量化:什么循环能被编译器向量化,restrict、对齐与 pragma 干预实测
编译优化系列的第十五篇。上一篇 placement new 对象池实测处理内存管理,本篇对准编译器手里最安静的一项优化:自动向量化(auto-vectorization)。同一个 for 循环不改一行代码,编译器可能把它编成一条指令处理两个 double 的 SSE 打包运算,也可能保留标量累加链,两者性能可以差出四倍。区别不在编译器心情,而在循环形态能否通过合法性检查与成本模型。SIMD 向量执行全景讲清了向量单元的硬件机制,本篇回答工程侧的问题:怎样知道自己的循环到底有没有被向量化,被挡住时报告怎么读,restrict、对齐承诺和 pragma 这三类常见干预各自值不值得加。
本文要回答的问题
- 编译器决定一个循环能否自动向量化,要依次过哪几关?
- clang 的向量化报告该开哪几个开关,报告里的 width、interleaved count 和 miss 原因分别是什么意思?
- 数据依赖、指针别名、浮点求和顺序、分散写这四类阻碍,各自对应报告里的什么原话?
__restrict、#pragma clang loop vectorize(enable)、对齐承诺、unroll_count四个干预手段,哪些有真实收益,哪些反而帮倒忙?- 同样的循环在 SSE2(向量宽 2)和 AVX2(向量宽 4)下差距多少,结论的适用边界在哪?
一、自动向量化的判定漏斗
自动向量化不是开关动作,而是一条层层收窄的判定链。编译器先做合法性分析:循环计数是否规整、迭代间有没有携带依赖、指针会不会别名、浮点能不能重排;过关后才进成本模型,估算向量版本能否赚回额外的拆分与合并指令;最后处理尾循环——元素总数不是向量宽度整数倍时,剩余元素走标量收尾。
下面这张漏斗把整个判定链按本篇 9 组循环的真实去向分层,绿色出口是最终拿到向量代码的形态,红色是被挡住的形态。
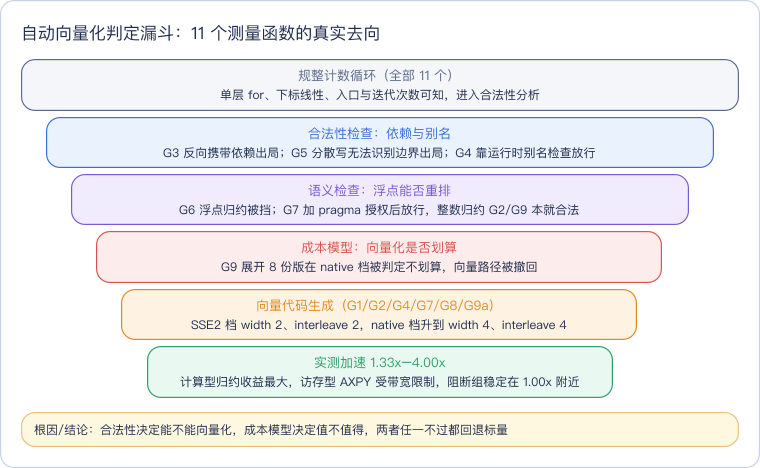
读这张漏斗抓住一个顺序:合法性问题是硬阻断,写什么选项都绕不过去,只能改循环形态;成本模型是软判断,换档位、换向量宽度后结论可能翻转。本篇每个被挡住的组,都能在编译器报告里找到对应原话。
二、基准设计:9 组循环与三档构建
工程放了 9 组共 11 个 noinline 测量函数,每组只改变一个变量,固定函数边界后报告、反汇编和计时才能逐一核对。数组统一 262144 个元素,每函数跑 200 遍,填充与清零在计时区外,每档构建跑 7 次取中位。
| 组 | 循环形态 | 设计意图 | 预期关卡 |
|---|---|---|---|
| G1 | restrict 双指针 AXPY | 可向量化基线 | 直通 |
| G2 | long 整数归约求和 | 整数结合律,归约可拆多路累加器 | 直通 |
| G3 | a[i]=a[i-1]*x+1 递推 | 反向循环携带依赖 | 合法性硬阻 |
| G4 | 裸双指针 AXPY(无 restrict) | 别名未知,看编译器是否版本化 | 运行时检查后放行 |
| G5 | v[idx[i]] += x[i] 分散写 | 下标运行时决定,边界不可识别 | 合法性硬阻 |
| G6 | double 归约,严格模式 | 浮点重排未授权 | 语义阻断 |
| G7 | 同 G6 加 vectorize(enable) | pragma 显式授权重排 | 授权后放行 |
| G8 | 64B 对齐承诺对照 8B 错位 | 对齐信息改变 load 指令选择 | 均放行,比指令与耗时 |
| G9 | 整数归约,朴素对照 unroll_count(8) | 展开干预的真实效果 | 成本模型分档 |
三档构建共用同一份源码:普通 -O2 是部署默认档;-O2 -fno-vectorize -fno-slp-vectorize 是标量对照档,优化级别不变只关向量化,加速比才能干净归因;-O2 -march=native 放开到本机 AVX2,观察宽度从 2 提到 4。判定流程与三档的关系画在下图,红色是硬阻断出口,绿色是向量代码出口。
读这张图注意红色节点的性质:前三个问「合不合法」,没有协商空间;最后一个成本模型问「划不划算」,同一循环在不同档位可以得到相反答案,G9 实测会给出例子。
三、报告怎么读:本工具链的三个 -Rpass 开关
GCC 用户熟悉的 -fopt-info-vec 在 Apple clang 上并不是合法参数,本机实测编译器直接拒绝:
$ clang++ -O2 -fopt-info-vec -std=c++17 -c src/g1_axpy_restrict.cpp
clang++: error: unknown argument: '-fopt-info-vec'
等价物是三个配套 remark 开关,本工程逐组编译时全部打开:
clang++ -O2 -Rpass=loop-vectorize \
        -Rpass-missed=loop-vectorize \
        -Rpass-analysis=loop-vectorize -c src/g1_axpy_restrict.cpp
-Rpass 只报告成功向量化的循环,输出 width(向量宽度,几个元素打包进一条向量指令)与 interleaved count(交织份数,编译器同时推进几个独立向量迭代);-Rpass-missed 报告放弃向量化的循环;-Rpass-analysis 给出放弃的具体原因,是三个开关里信息量最大的一个。下面是四组代表性循环的报告原文摘录。
## G1 基线:成功,SSE2 下两个 double 一组、两份交织
src/g1_axpy_restrict.cpp:8:5: remark: vectorized loop
  (vectorization width: 2, interleaved count: 2)

## G3 递推:反向循环携带依赖,硬阻断
src/g3_recurrence.cpp:8:14: remark: loop not vectorized: unsafe dependent
  memory operations in loop ... Backward loop carried data dependence.
src/g3_recurrence.cpp:7:5: remark: loop not vectorized

## G5 分散写:无法识别数组边界,硬阻断
src/g5_scatter.cpp:9:9: remark: loop not vectorized:
  cannot identify array bounds

## G6 浮点归约:不敢重排求和顺序,并给出解锁方法
src/g6_fpsum_strict.cpp:9:11: remark: loop not vectorized: cannot prove
  it is safe to reorder floating-point operations; allow reordering by
  specifying '#pragma clang loop vectorize(enable)' before the loop or
  by providing the compiler option '-ffast-math'
第四条报告还写出两条出路:循环级 pragma 或全局 -ffast-math。两者作用域差别很大,后者同时放松 NaN、有符号零、除法化简等一整套浮点语义,影响整个翻译单元;pragma 只作用于紧邻循环,是风险可控的局部授权。G7 走 pragma 路线,报告随即翻转为 vectorized loop (width: 2, interleaved count: 2)。
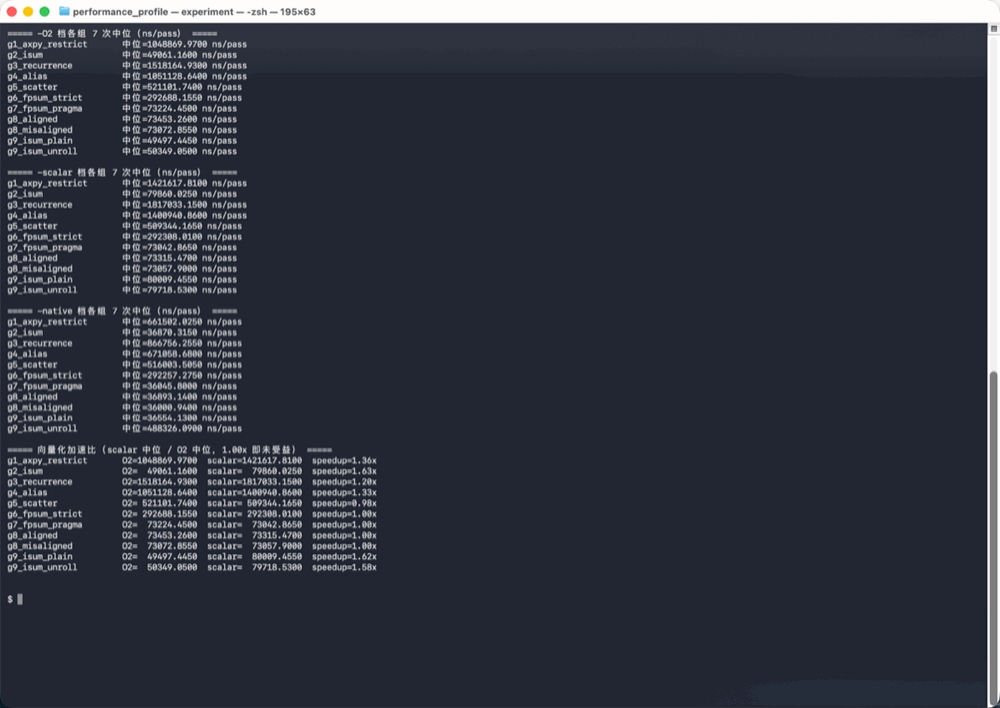
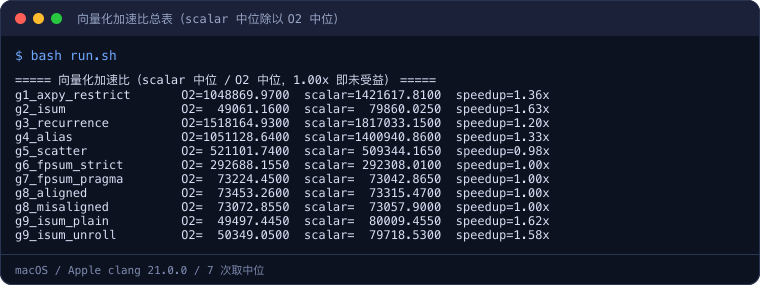
完整的三档十一组中位耗时如下,所有数字来自同一份七次测量的中位记录。
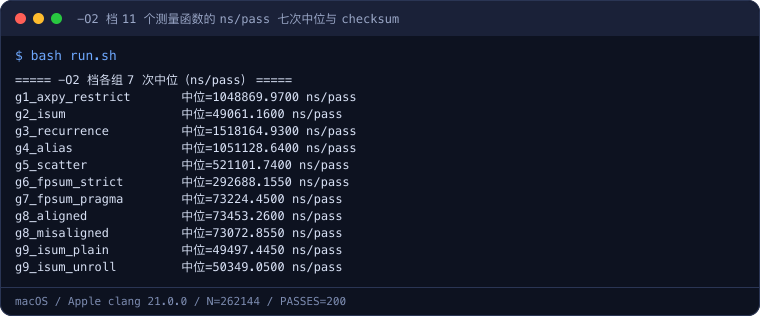
表中 G6 与 G7 的对比已经能看出量级:同样的浮点归约,严格模式 292688 ns/pass,pragma 授权后 73224 ns/pass,单这一处干预就是约 4.00 倍。checksum 两组仅相差 1(-6553974 对 -6553975),这正是求和顺序改变后浮点舍入的真实差异,说明 pragma 不是免费午餐,它用可接受的数值扰动换向量宽度。
四、实测加速比:谁受益,谁原地不动
以标量档为分母、普通 O2 档为分子算加速比,11 个函数的成绩分成清晰的三档。
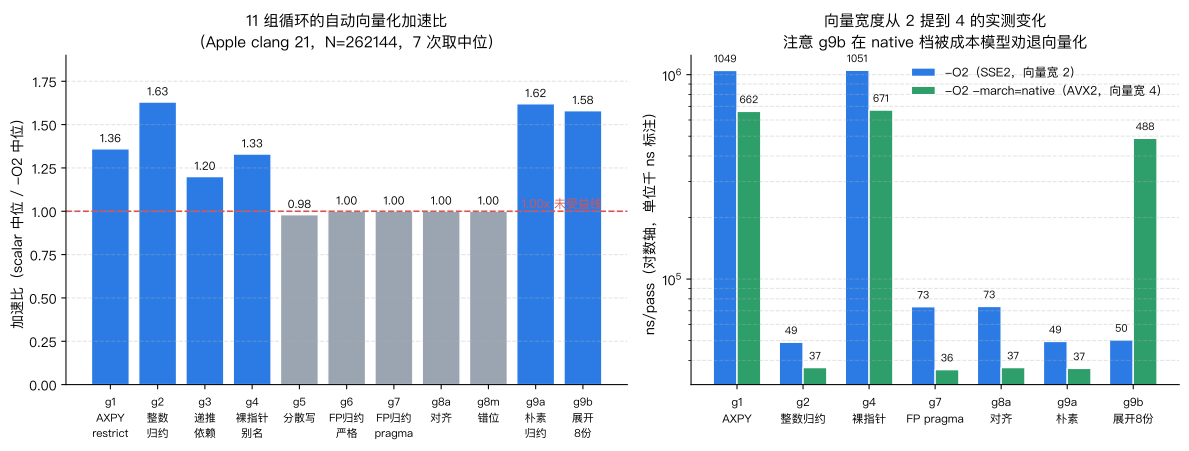
左面板蓝色柱是加速比超过 1.05 的组,灰色是未受益组。第一档是计算型归约:G2 整数归约 1.63x、G9 朴素归约 1.62x,G7 浮点归约相对 G6 严格标量版约 4.00x——归约算术密度高,加宽直接转化为吞吐。第二档是访存型 G1/G4,只有 1.36x 和 1.33x:AXPY 每轮读两个数组写一个数组,262144 个 double 约 4MB,数据在 L3 与内存间流动,向量单元再宽也要等数据,与缓存友好代码的访存瓶颈结论一致。第三档灰色柱:G5 分散写 0.98x、G6 严格归约 1.00x,阻断组在两档间没有系统性差异。
G3 的 1.20x 要单独说明:它在两档报告里都是 loop not vectorized,向量指令并未生成,差值来自函数代码布局与循环对齐的偶然变化,不具方向性。判断循环是否真的向量化,证据始终是报告加反汇编,而不是两档耗时之差。
右面板把视角换到向量宽度。-march=native 后报告里的 width 从 2 升到 4、interleave 从 2 升到 4:G7 从 73224 降到 36046 ns/pass,恰好 2.03 倍,与宽度翻倍基本吻合;G2 从 49061 降到 36870,约 1.33 倍;访存型的 G1 从 1048870 降到 661502,约 1.59 倍,再次受带宽限制。最扎眼的是最右一组 G9 展开版:native 档非但没加速,反而从 50349 恶化到 488326 ns/pass,慢了约 9.7 倍,下一节专门拆解。
反汇编层面的总量证据也对得上:普通 O2 二进制里打包向量指令 83 条,native 档 134 条(AVX2 的 vaddpd、vmovupd 等),标量档只剩 19 条,且主要来自初始化代码的 SLP 优化与 pragma 强制保留的 G7/G8。
五、四个干预手段逐个对账
5.1 __restrict:消灭的是运行时检查,不是向量化资格
一个流行说法是「不加 restrict 编译器就不敢向量化」。本篇 G4 的实测给出更精确的版本:裸指针循环在本工具链上照样向量化,报告同样是 width 2、interleave 2,但编译器在函数入口插入了运行时别名检查,生成向量与标量两套代码,按区间是否重叠二选一。反汇编里先出现的是标量序言(movsd/addsd),随后才是向量主体(movupd/addpd)。
读图抓住红色判定节点的位置:G4 的别名风险没有被静态消除,只是推迟到运行时回答。常规不重叠场景两者耗时接近(1.36x 对 1.33x),检查分支几乎免费,代价是两份代码体积与一个额外分支。restrict 的价值是把运行时问题变成编译期承诺,让 G1 直接进向量路径。能确认不重叠才加——它是程序员给编译器的保证,撒谎会得到别名场景下的错误代码,编译器不再做运行时兜底。
5.2 pragma 授权:4 倍收益与一个越权事实
G6 到 G7 是全篇最干净的对照:循环体一字不差,只多一行 #pragma clang loop vectorize(enable),严格标量链变成 width 2 的四路向量累加,292688 降到 73224 ns/pass。实验还暴露一个少有人核对的行为:标量档命令行带着 -fno-vectorize,G7 报告依然显示向量化成功,耗时与普通档一致(73043 对 73224)。循环级 pragma 的优先级高于命令行开关。因此用全局关向量化做 A/B 测量时,带 pragma 的循环不在对照范围内,必须另找同形态的无 pragma 版本当基线——这正是工程同时保留 G6 与 G7 的原因。
5.3 对齐承诺:指令变了,耗时没变
G8 用两个完全同构的浮点归约对照:一个接收 64 字节对齐缓冲并通过 __builtin_assume_aligned 告知编译器,另一个接收基址偏移 8 字节的错位指针。反汇编差异真实存在:对齐版的向量累加直接使用内存操作数折叠的对齐访问,错位版显式生成 movupd 非对齐 load。但七次中位耗时是 73453 对 73073 ns/pass,差异在噪声内,错位版甚至略快。
这个结果符合 Coffee Lake 的已知行为:非对齐 load 在数据实际对齐时与对齐 load 同吞吐,只有访问真正跨越缓存行边界才有额外惩罚,本基准几乎不触发跨行。对齐工程今天的价值主要在老微架构、非临时存储(movnt* 强制对齐)与手工 intrinsics 内核;对自动向量化的普通循环,它改的是指令形态而不是性能,内存对齐有完整拆解。
5.4 循环展开:pragma 是提示不是命令,native 档的 9.7 倍翻车
G9 的对照是全篇最大的反直觉点。普通 O2 档,朴素归约与 unroll_count(8) 版成绩几乎相同(49497 对 50349 ns/pass),报告显示展开版被成本模型判定为「vectorization is not beneficial,interleave count is set to 1」——展开 8 份后循环体变大,成本模型撤回了向量化交织,改走标量展开。真正的翻车发生在 native 档:朴素版 36554 ns/pass,展开版 488326 ns/pass,慢 13.4 倍。AVX2 宽向量本应让归约再快一倍,而展开版因为向量路径被撤回,只能用标量指令处理全部数据。
## G9 展开版的报告原话(O2 与 -funroll-loops 档相同)
src/g9_unroll.cpp:17:5: remark: the cost-model indicates that
  vectorization is not beneficial
src/g9_unroll.cpp:17:5: remark: the cost-model indicates that interleaving
  is not beneficial and is explicitly disabled or interleave count is set to 1
这条证据修正两个误解:pragma 是提示而非命令,编译器保留拒绝权,unroll_count 还会连锁改变向量化决策;展开不是免费并行,它增大代码体积、占用指令缓存。纪律是先跑报告确认已向量化再决定展开,展开后重测全档位——O2 下无害的 pragma,换 ISA 后可能变成十倍减速。分散写这类啃不动的访问模式,其硬件根因(gather/scatter 指令的吞吐成本)见向量 gather/scatter 成本实测。
六、工程决策清单
把九组实测收敛成可以直接照着做的四条纪律。
| 信号或场景 | 该做什么 | 不该做什么 |
|---|---|---|
| 热循环不知道是否向量化 | 开 -Rpass 三兄弟看报告,按 miss 原因分类处理 | 凭源码直觉判断,或只看耗时反推 |
| 报告称指针别名 / 运行时检查 | 能证明不重叠就加 __restrict,并反汇编确认检查消失 | 对生命周期不明的指针乱加 restrict |
| 报告称浮点不敢重排 | 评估数值误差后局部加 vectorize(enable),保留 checksum 对照 | 全工程一刀切 -ffast-math |
| 报告称依赖 / 边界不可识别 | 改循环形态:拆分递推、规整下标、外提不可向量化语句 | 叠 pragma 硬试,合法性问题绕不过去 |
| 想加对齐或展开干预 | 先测基线,干预后三档重测并核对报告与反汇编 | 把 pragma 当命令,假设干预必然加速 |
| 部署支持 AVX2 的机型 | 评估 -march=native 或分档发行,宽度翻倍对计算型归约约 2x | 追求可移植的单一二进制却期待 AVX2 性能 |
测量边界也要写清:本机没有 perf 与硬件计数器,向量化判定依据编译器报告与反汇编,性能依据 chrono 七次中位;数字全部来自 x86-64 上的 Apple clang 21 与 SSE2/AVX2 两档宽度。ARM NEON/SVE 的宽度、GCC 的成本模型阈值都不同,向量 SIMD 执行单元讲过微架构单元差异,落地前照本工程在自己的工具链上复跑。
实验环境
- 机器/系统:MacBook Pro(Intel Core i7-9750H,6 物理核 12 逻辑线程,16 GB)/ macOS 26.5.2(Build 25F84),x86_64
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101);编译参数
-std=c++17 -Wall -Wextra,三档分别为-O2、-O2 -fno-vectorize -fno-slp-vectorize、-O2 -march=native - 日期:2026-11-13
- 完整命令:
make产出三档二进制 →make reports逐组采集-Rpass三兄弟报告 →bash run.sh三档各跑 7 次取中位、计算加速比、用nm定符号区间后otool -tvV摘录标量序言、向量主体与对齐 load,完整记录落run1.log与results.txt
代码获取
完整可复现工程(9 组 11 个 noinline 测量函数、三档 Makefile、逐组报告采集与反汇编证据脚本、实测 results.txt)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-autovectorization-pragmas-alignment
- 复现方式:克隆后进入该目录执行
bash run.sh,约两分钟输出三档十一组中位耗时、加速比、逐组向量化报告与向量指令反汇编;GCC 环境把-Rpass三兄弟换成-fopt-info-vec即可,报告语义相同,耗时数字需重新实测。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的编译优化分组。硬件机制上,SIMD 向量执行全景与向量 SIMD 执行单元解释向量指令为什么能一条顶多条,本篇补上编译器在什么条件下才愿意生成它们;G5 的分散写与向量 gather/scatter 成本实测互为表里,一篇讲编译期阻断、一篇讲硬件期成本。同系列的虚函数去虚化条件与本篇方法同源:都用报告加反汇编核对优化是否真的发生。内存侧的缓存友好代码与内存对齐解释了访存型循环加速比受限、对齐干预无收益的底层原因;上一篇 placement new 对象池实测处理的是另一类热路径开销。
总结
在 9 组 11 个循环、三档构建的实测上,自动向量化的账本是:普通 -O2 下规整 AXPY 与整数归约分别拿到 1.36x 与 1.63x,浮点归约加一行 vectorize(enable) 后相对严格标量版提速约 4.00x,且该 pragma 会覆盖命令行的 -fno-vectorize;裸指针循环照样向量化,但被插入运行时别名检查与标量兜底,restrict 消掉的正是这份检查;递推依赖与分散写是合法性硬阻断,报告原话是反向携带依赖与无法识别数组边界,pragma 绕不过去;对齐承诺在本微架构只改 load 指令形态、不改耗时;unroll_count(8) 在 O2 下无收益,在 AVX2 native 档反被成本模型撤回向量路径、减速 13.4 倍。向量宽度从 2 提到 4 后,计算型归约近乎线性再快 2 倍,访存型循环继续受带宽约束。可靠的工作流只有一条:开 -Rpass 三兄弟读报告,按合法性与成本两类原因分别处理,干预后全档位重测并用反汇编验收。