placement new 对象池:把分配与构造解耦后,百万次创建销毁到底省多少
C++ 性能实测系列第十四篇。上一篇在输入解析路径上量了库函数与手写解析器的吞吐差距,本篇回到内存管理,回答一个高频小对象场景里的经典问题:每帧创建销毁几万个报文、事件、节点对象时,裸 new/delete 的代价到底有多大,能不能把它拆掉。低延时设计模式全景把对象池列为避免动态分配抖动的核心模式之一,那一篇讲模式与适用场景,本篇用一个 placement new 对象池的可运行基准,把「省了哪部分、没省哪部分、省多少」记成可复现的账本。
本文要回答的问题
- 一次普通的
new T到底做了哪两件事,placement new 为什么能把它们拆开? - placement new 对象池的槽位怎样管理,free list、构造、析构与归还各发生在什么时候?
- 百万次 create/destroy 正面对打,对象池比裸
new/delete快多少,O2 与 O0 下差距为什么不同? - 构造和析构一次都没少,那省下来的成本究竟是什么,分配计数账怎样对?
- 槽位耗尽时行为是什么,工程上什么场景才值得引入对象池,代价又有哪些?
一、placement new 对象池的前提:一次 new 做了两件事
理解对象池之前,先要把一次 new Widget(x) 拆开。它在语义上包含两个独立动作:第一步调用 operator new(底层走到 malloc 一族)申请一块足以容纳 Widget 的原始内存,第二步在这块内存上调用 Widget 的构造函数,把原始存储变成一个活着的对象。delete 同样是两步:先调析构函数结束对象生命,再把内存归还分配器。
两个动作在语言层面本来就可以分开做。placement new 就是只做第二步的语法:::new (ptr) T(args...) 不申请任何内存,只在调用方给定的地址上构造一个 T;与之配对,对象的结束也要手写显式析构 p->~T(),并且绝不能对这样的指针使用 delete——内存不来自分配器,归还动作必须由提供内存的一方自己定义。
placement new 对象池利用的正是这个切分。池在构造时一次性申请 Capacity * sizeof(T) 的大块原始存储,此后每个槽位的内存反复复用:alloc() 从空闲槽位链表里弹一个槽位,用 placement new 在上面构造对象;release() 先显式析构,再把槽位挂回链表。百万次创建销毁的过程中,malloc/free 只在池诞生和消亡时各出现一次,构造函数和析构函数则老老实实执行一百万次——这一点后面的计数账会反复印证。
先用一张流程卡把这条解耦链路的五个动作固定下来,后面的实现与实测逐格对应。
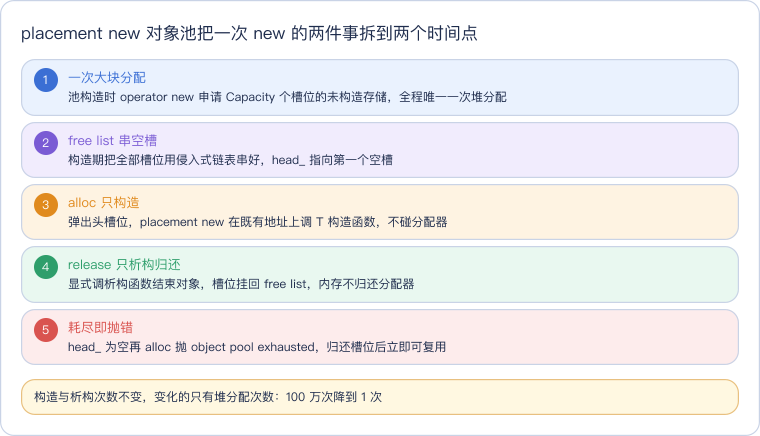
读这张卡抓住一条时间线:内存申请被提前到池构造的瞬间一次性付清,之后热路径上只剩链表弹入弹出与构造析构,分配器彻底离开循环。
二、实现拆解:大块存储、侵入式 free list 与 placement new
基准工程里的对象池是一个约四十行的模板,三个成员撑起全部机制:一块 char* 原始存储、一个 head_ 链表头、一个 used_ 存活计数。槽位空着的时候,其首字内存被借用来存下一个空槽的下标,这就是侵入式 free list——不需要额外的索引数组,空槽自己保存链表指针。
template <class T, std::size_t Capacity>
class ObjectPool {
public:
    ObjectPool() : head_(NONE), used_(0) {
        // 只分配未构造的原始存储,全程只有这一次堆分配
        storage_ = static_cast<char*>(::operator new(Capacity * sizeof(T)));
        for (std::size_t i = 0; i < Capacity; ++i) release_slot(i);
    }

    template <class... Args>
    T* alloc(Args&&... args) {
        if (head_ == NONE) throw PoolExhausted();
        std::size_t idx = head_;
        head_ = *slot_next(idx);
        ++used_;
        // 只构造、不分配:placement new 在既有槽位上调构造函数
        return ::new (static_cast<void*>(slot(idx))) T(std::forward<Args>(args)...);
    }

    void release(T* p) {
        std::ptrdiff_t off = static_cast<char*>(static_cast<void*>(p)) - storage_;
        std::size_t idx = static_cast<std::size_t>(off) / sizeof(T);
        p->~T();  // 显式析构,内存不归还分配器
        release_slot(idx);
        --used_;
    }
private:
    char* storage_;
    std::size_t head_;
    std::size_t used_;
    // slot_next 把空槽首字当作 std::size_t 链表指针用
};三个细节决定了它的性能画像。第一,alloc() 的全部簿记是两次下标读写:取出 head_、把该槽位里存着的下一个空槽下标回填给 head_,O(1) 且没有循环、没有系统调用;槽位地址由 storage_ + idx * sizeof(T) 直接算出。第二,release() 靠指针差值反算槽位下标,要求调用方归还的确实是本池发出的指针,传错地址没有任何运行期防护——这是性能换来的纪律。第三,槽位在空态借用首字存链表、在活态放置对象,两种用途时间上互斥,所以不需要额外内存,但也意味着 T 的大小至少要放得下一个 std::size_t。
耗尽路径是显式异常而不是静默扩容:
struct PoolExhausted : std::runtime_error {
    PoolExhausted() : std::runtime_error("object pool exhausted") {}
};
固定容量是对象池与通用分配器的根本区别——容量在编译期由模板参数定死,满了就抛错,把「何时限流、怎样背压」的决策交还给调用方。这个设计在交易系统、游戏帧循环这类容量可预估的场景里是优点:内存占用有硬上限,不会因为流量尖峰把堆撑碎。
三、槽位生命周期:一张图看懂复用循环
下图把一个槽位从空链表到构造、存活、析构、回链的完整循环画出,颜色区分五种角色:灰色是池持有的原始存储,蓝色是空槽链表,橙色是构造动作,绿色是存活对象,紫色是析构归还,红色是耗尽分支。
读图抓住主环与旁路。主环是蓝→橙→绿→紫→蓝的循环:一个槽位每被复用一次,就完整经历一次构造与析构,但脚下的物理内存始终是同一块。红色是唯一旁路——链表弹空之后 alloc() 不等待、不扩容,直接抛异常,调用方只要 release 任意一个存活对象,对应槽位立刻回到蓝色链表,下一次 alloc 立即成功。这也说明对象池抹平的只是分配器成本,对象生命周期管理的责任一点没有减少。
四、基准设计:两种轮换场景与一道逃逸屏障
被测对象 Widget 是 56 字节、带非平凡构造析构的类型(构造时填充 28 字节缓冲区并写标签,析构时清标签),刻意避开可被编译器整体优化掉的空类型。池容量固定 4096 槽,单块存储 229376 字节;每轮跑 100 万次 create/destroy,进程内重复 5 轮取中位,外层 O2、O0 两个二进制各跑 7 次再取中位。
两个负载场景模拟两种真实节奏:
| 场景 | 节奏 | 最大存活数 | 对应真实负载 |
|---|---|---|---|
| churn 即时轮换 | 每次迭代 alloc 后立刻 release | 1 | 临时报文、短生命周期事件 |
| steady 稳态轮换 | 保持 256 个存活对象,每迭代补一个销一个 | 256 | 连接上下文、帧内对象表 |
两条被测路径共享同一份业务代码,唯一差别是对象从哪来:池路径走 pool.alloc()/pool.release(),对照路径走裸 new Widget/delete。对照实验有一个必须堵上的漏洞——clang 的 heap-to-stack 优化会发现 new 出来的指针不逃逸,直接把它降成栈对象,那样裸 new 的百万次分配会被整体消除,测出虚假的每秒十亿次。工程对两条路径对称施加同一道逃逸屏障,强制指针被真实使用:
static inline void escape_barrier(const void* p) {
    asm volatile("" : : "r"(p) : "memory");
}
分配次数由重载的全局 operator new/operator delete 统计(普通版与对齐版全套重载,避免漏掉 aligned new 路径),构造析构次数由 Widget 的静态计数器统计。两套计数器分开记账,才能回答「省的到底是哪一步」。
五、耗时实测:O2 快约 6.5 倍,O0 差距收窄到 1.3 倍
七轮中位汇总如下图,蓝柱是 placement new 对象池,橙柱是裸 new/delete,柱顶绿色数字是同场景下的倍差。
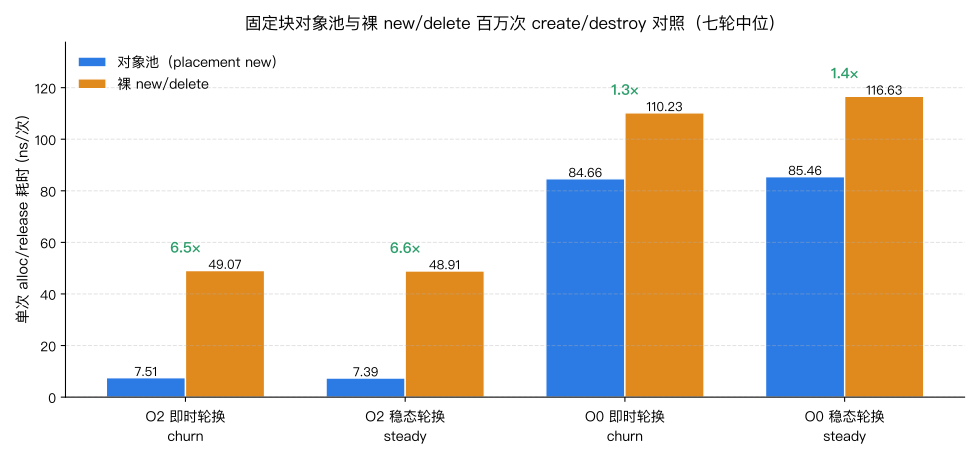
读图先看左两组 O2 柱子:池化路径稳定在 7.4–7.5 ns/次,裸分配路径在 49 ns/次上下,倍差 6.5 倍与 6.6 倍。按这台机器的主频折算,7.5 ns 大约是二十几个时钟周期,基本上就是两次链表下标读写加上一次 56 字节对象的构造析构;而 49 ns 里包含分配器的加锁、空闲块查找、簿记与可能的系统调用,是完全不同量级的动作。右两组 O0 柱子给出重要提醒:关掉优化后池化路径涨到 85 ns 上下,倍差收窄到 1.3–1.4 倍。原因是 O0 下 alloc()/release() 不被内联,free list 操作保留为真实函数调用与指针追踪,而裸分配的 malloc 本身是预编译库函数、不受本工程优化档位影响,两边的差距被未优化的机械动作稀释。线上构建普遍开 O2,评估这类微结构优化必须用发布档位测,这个口径与 variant 与虚函数分派实测的 O0 反转结论同源。
| 场景 | 实现 | O2 (ns/次) | O0 (ns/次) | O2 百万次耗时 |
|---|---|---|---|---|
| churn 即时轮换 | 对象池 | 7.51 | 84.66 | 7.51 ms |
| churn 即时轮换 | 裸 new/delete | 49.07 | 110.23 | 49.07 ms |
| steady 稳态轮换 | 对象池 | 7.39 | 85.46 | 7.39 ms |
| steady 稳态轮换 | 裸 new/delete | 48.91 | 116.63 | 48.91 ms |
另一个值得注意的现象是两个场景几乎同速:池化路径 7.51 对 7.39 ns,裸分配路径 49.07 对 48.91 ns。存活数量不影响单次成本——对象池只认 free list 的弹入弹出,与存活 1 个还是 256 个无关;malloc 一侧则因为热点块在分配器缓存里反复回收复用,churn 与 steady 也测不出差别。完整的七轮中位记录如下。
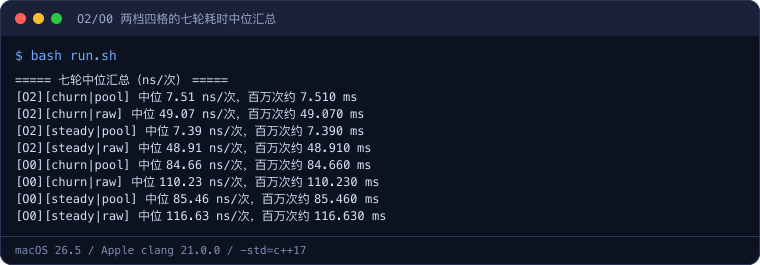
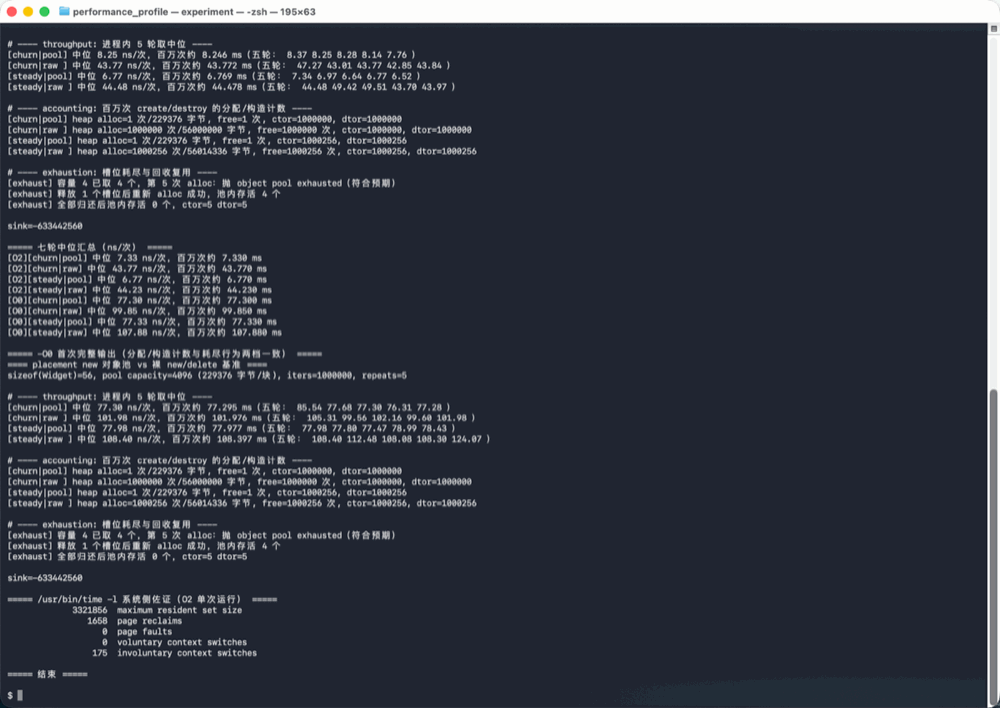
图中 O2 首次完整输出里,四组场景各自的五轮样本波动都很小:churn 池化五轮为 9.65、8.15、7.70、7.73、7.66 ns,首轮冷启动之后收敛到 7.7 ns 上下,steady 池化五轮更是全部落在 7.33–7.35 ns 的窄带里,说明这个数字不是单次毛刺;进程内五轮中位与外层七轮中位(7.73 ns 对 7.51 ns)也互相印证。下方 sink 校验值两实现完全一致,先对齐语义再比耗时。
六、分配计数账:省下的是 100 万次分配,不是构造
耗时曲线回答快多少,计数器回答省了什么。百万次 create/destroy 的分配与构造分解如下,数字逐行取自运行记录。
[churn|pool] heap alloc=1 次/229376 字节, free=1 次, ctor=1000000, dtor=1000000
[churn|raw ] heap alloc=1000000 次/56000000 字节, free=1000000 次, ctor=1000000, dtor=1000000
[steady|pool] heap alloc=1 次/229376 字节, free=1 次, ctor=1000256, dtor=1000256
[steady|raw ] heap alloc=1000256 次/56014336 字节, free=1000256 次, ctor=1000256, dtor=1000256
这张账有三个读法。第一,构造与析构次数两边完全相同,都是整整 100 万次(steady 场景多出的 256 次来自预热阶段先建的存活对象)——placement new 对象池从不跳过构造,对象的初始化语义与裸 new 严格一致,省下来的纯粹是分配器流量。第二,堆分配次数从 100 万次降到 1 次,申请字节从 5600 万字节降到 22.9 万字节,相差约 244 倍;注意 5600 万是累计申请量而非同时驻留量,free 及时归还后峰值驻留并不高,但分配器的簿记与锁竞争是按次数计费的,std::function 的小对象缓冲阈值测的正是同一笔费用。第三,池的 22.9 万字节是全程常驻的预付成本,哪怕某时刻一个存活对象都没有,这块内存也不还给系统。
耗尽与复用行为由一个容量 4 的小池单独验证:
[exhaust] 容量 4 已取 4 个,第 5 次 alloc:抛 object pool exhausted(符合预期)
[exhaust] 释放 1 个槽位后重新 alloc 成功,池内存活 4 个
[exhaust] 全部归还后池内存活 0 个,ctor=5 dtor=5
第五次申请准确抛出 object pool exhausted,归还一个槽位后立即分配成功,最终 ctor 与 dtor 都是 5 次,证明复用路径上每个构造都有配对析构,没有对象泄漏在槽位里。系统侧的 /usr/bin/time -l 佐证同样干净:最大驻留集约 3.1 MB,页错误为 0,自愿上下文切换 0 次、非自愿 26 次——整个基准没有一次因为缺页或调度进入内核等待,这正是预付内存想要的确定性。
七、工程取舍:什么时候值得上对象池
把实测收敛成决策依据,先看适合的场景。第一类是高频、同类型、短生命周期的小对象洪流:网络报文、协议帧、AST 临时节点、游戏实体、交易事件,单次分配成本乘以百万级 QPS 就是实打实的 CPU 账单,多线程下 malloc 的分配器锁还会变成争用源,这一点与 shared_ptr 引用计数争用里的全局串行点是同类问题。第二类是延迟敏感、要求抖动可预测的路径:预付内存把缺页、系统调用和堆膨胀提前到启动阶段,运行期耗时方差极小,本基准五轮样本的窄带就是证据。第三类是容量可预估、需要硬上限的系统,固定容量天然提供背压锚点。
代价也要照单全收。其一是类型与尺寸固定,一个池只服务一个 T, heterogeneous 对象要按类型分池,或退化为分尺寸级别的块池。其二是容量不自动增长,耗尽即异常,调用方必须设计限流或归还策略,把异常路径当成正常容量管理的一部分来测。其三是生命周期纪律更严:池指针不能 delete、不能跨池归还、池析构前所有对象必须先 release,这些约束编译器只能挡住一部分,代码评审与封装(把池藏在工厂接口后面)比约定更可靠。其四是非线程安全——这个实现的 free list 没有任何原子操作,多线程使用要么每线程一个池(推荐,无共享即无争用),要么外加同步,而加锁会吃掉一部分收益。其五是内存常驻且按最大容量预付,存活数长期很低时利用率不如通用分配器。
如果判断下来确实需要池化,但不想自己维护 placement new,工程上还有两条渐进路线:先用标准容器加 std::vector<T> 预留容量配合索引句柄,得到连续内存与零按对象分配,代价是对象生命管理换成 slot 版本号;再进一步可以评估第三方内存分配器(如 jemalloc、tcmalloc 的线程缓存),它们在 malloc 接口下就把小对象分配压到十几纳秒,不改业务代码。vector/deque/list 遍历实测里 list 逐节点分配的缓存代价,也可以作为「连续内存 + 索引」路线的旁证。一句话:先有分配计数证明 new 真是瓶颈,再上对象池;不要为想象中的性能预付复杂度。
实验环境
- 机器/系统:MacBook Pro(Intel Core i7-9750H,6 物理核 12 逻辑线程,16 GB)/ macOS 26.5.2
- 工具版本:Apple clang 21.0.0(clang-2100.1.1.101),编译参数
-std=c++17 -Wall -Wextra,O2/O0 双档各 7 轮取中位 - 日期:2026-11-12
- 完整命令:
make产出bin/bench-O2与bin/bench-O0→bash run.sh两档各跑 7 次按场景/实现取 ns/次中位,进程内每格 5 轮取中位 → 重载operator new统计百万次 create/destroy 的堆分配次数与字节数,Widget静态计数器核对 ctor/dtor → 容量 4 小池验证耗尽抛错与回收复用 →/usr/bin/time -l采集 RSS、缺页与上下文切换
代码获取
完整可复现工程(对象池模板、可计数 Widget、operator new/delete 全套重载、churn/steady 两场景、耗尽演示与 O2/O0 双目标编排)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-placement-new-object-pool
- 复现方式:克隆后进入该目录执行
bash run.sh,约半分钟输出四格七轮耗时中位、分配构造计数账、耗尽复用验证与系统侧资源数据;其他平台与分配器(glibc malloc、jemalloc)下的纳秒数字需重新实测,不要直接沿用本篇数据。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的对象模型与内存管理分组。模式层面的全景梳理见低延时设计模式全景,本篇补上 placement new 对象池的实测成本数据;分配计数方法与 std::function 堆分配阈值、variant 与虚函数分派共用同一套 operator new 重载口径,三篇可以串成「小对象怎样避开逐次堆分配」的完整证据链;多线程下分配器锁与簿记的争用机理,与 shared_ptr 引用计数争用的全局串行点分析互相参照。
总结
在百万次 create/destroy 的正面对打里,placement new 对象池把一次 new 的两件事拆到两个时间点:内存分配提前为池构造时的一次 229376 字节大块申请,热路径上只剩 free list 弹入弹出加 placement new 构造与显式析构。实测 O2 下单次成本 7.51 ns 对裸 new/delete 的 49.07 ns、快约 6.5 倍,steady 场景同量级;O0 下因函数不内联倍差收窄到 1.3 倍,说明收益依赖发布档位的内联优化。分配账显示堆分配从 100 万次降到 1 次、累计申请量从 5600 万字节降到 22.9 万字节,而构造析构两边都是整整 100 万次——省的是分配器流量与抖动,不是对象初始化本身;容量 4 小池验证了耗尽即抛 object pool exhausted、归还即可复用且 ctor/dtor 严格配对。工程上它适合高频同型小对象、延迟敏感与容量可预估的场景,代价是固定类型、硬容量、生命周期纪律与单线程假设,上线前先用分配计数器确认 new 真是瓶颈,再决定预付这份复杂度。