CFS nice 权重:静态权重表的理论比例与 SMT 超额订阅下的实测比例
调过 nice 值的工程师大多有个朴素预期:nice 差多少,CPU 时间就按权重表比例分多少。内核源码 kernel/sched/core.c 里确实躺着一张 sched_prio_to_weight 静态权重表,nice 0 对应 1024,每降一级权重大约乘 1.25。但这张表描述的是同一个运行队列上、时间片粒度的 vruntime 推进比例,不是任意拓扑下整机 CPU 时间的最终分配比例。一旦机器只有一颗物理核、两个 SMT 兄弟线程,而可运行任务数又超过线程数,调度域负载均衡会介入,实测比例会被拓扑放大。
本篇是进程调度主题下的一篇实测文,调度器整体工作方式见 进程调度,调度类(CFS 与实时调度类的层级关系)见 Linux 调度类,同类实测方法学可参照 上下文切换的开销与观测 与 minor/major 缺页单次成本实测。
本文要回答的问题
- nice 值是怎么换算成 CFS nice 权重的,权重表里 nice -10、0、10、20 各自对应多少?
- 两组 nice 不同的纯计算进程抢 2 个 vCPU,理论 CPU 时间比应该怎么算?
- 实测比例与理论比例差多少,
getrusage与/proc/PID/stat两个口径为什么会不一致? - 为什么在 1 物理核 2 SMT、两倍超额订阅的拓扑下,权重差异会被放大成近似「谁占住核」的二元格局?
- 这些数字的适用边界是什么,工程上能不能拿 nice 当精确的 CPU 配额手段?
一、nice 值如何变成 CFS 权重
CFS(Completely Fair Scheduler,完全公平调度器)不直接跟踪进程的 nice 值做决策,它维护的是每个调度实体的 vruntime(虚拟运行时间)。物理时间推进多少 vruntime,与权重成反比:权重大的任务,同样跑 1ms 物理时间,vruntime 只涨一点点,于是在按 vruntime 排序的红黑树里更晚被排到队尾,获得更多运行机会。换算关系可以写成:
# 内核实际使用的换算(delta_exec 为物理运行时间,单位纳秒)
vruntime_delta = delta_exec * 1024 / weight
# time slice 方向的直观形式:
# 任务分到的时间片 = 调度周期 × 该任务权重 / 同队列总权重
nice 值到权重的映射是静态的,内核启动时就写死在 sched_prio_to_weight[40] 数组里,nice 每升高一级(优先级降低一级),权重约乘 0.8,连续降三级大约减半。本篇涉及的四个档位如下:
| nice 值 | 静态权重 weight | 相对 nice 0 的权重比 |
|---|---|---|
| -10 | 2304 | 2.25 |
| 0 | 1024 | 1.00 |
| 10 | 262 | 0.256 |
| 20 | 15 | 0.0146 |
这张表是后面所有「理论比」的唯一来源。需要注意它的适用前提:比例成立的场景是同一个 cfs_rq(CFS 运行队列)上的任务在同一个调度周期内瓜分时间片。任务一旦被负载均衡搬到别的 CPU、或者队列上的任务数与核数关系发生变化,整机层面观测到的 CPU 时间比就不再是简单的权重之比。
二、实验设计:两组燃烧进程两倍超额订阅
实验在一台上海云主机上进行:Intel Xeon Platinum 8374C @2.70GHz,虚拟机看到 2 个 vCPU,底层是 1 颗物理核的 2 个 SMT 兄弟线程(lscpu 显示 1 core、2 threads per core),系统为 Ubuntu 22.04.5,内核 5.15.0-190-generic。
负载程序 nice_bench 是一个纯 CPU 燃烧进程:启动后固定跑 9 秒墙钟,结束时用 getrusage(2) 自报用户态累计时间 utime。每组实验拉起 4 个进程,分成 A、B 两组各 2 个,对 2 个 vCPU 形成 2 倍超额订阅;采样窗口取中间 8 秒,避开进程拉起与退出的扰动。四组 nice 组合各重复 5 次:
| 组合 | A 组 nice | B 组 nice | 理论 A/B 权重比 |
|---|---|---|---|
| base | 0 | 0 | 1.00 |
| n10 | 0 | 10 | 3.91 |
| n20 | 0 | 20 | 68.27 |
| neg10 | -10 | 0 | 2.25 |
测量采用双口径互相校验。进程内口径是 getrusage 返回的 utime,毫秒级浮点;外层口径由采样脚本独立读取 /proc/PID/stat 第 14 列的 utime,单位是 jiffy。本机 CLK_TCK=100,即 1 jiffy 等于 10ms,这是内核记账的原生粒度。两个口径一个来自进程自身、一个来自 procfs,统计路径完全独立,能暴露量化粒度带来的偏差。
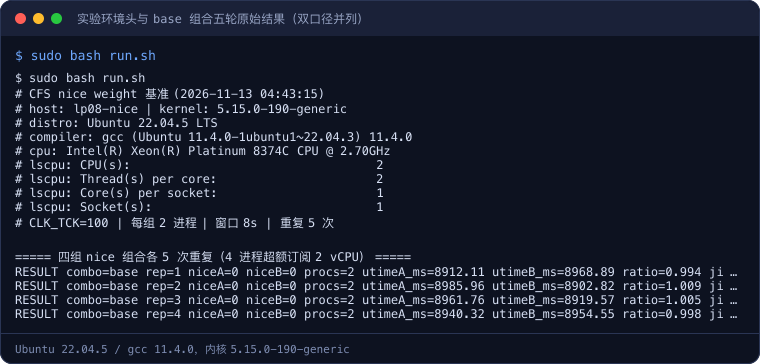
这张终端卡给出了环境头与 base 组合的前五条 RESULT 行。读的时候抓两列:ratio 是 getrusage 口径的 A/B 时间比,jratio 是 jiffy 口径的 A/B 时间比。base 组两边 nice 相同,两个口径都在 1.00 附近抖动,先验证了「同权重应当均分」这个基线本身是成立的,后面三组的偏离才有参照物。
三、理论比怎么算
理论比不需要测量,直接用权重表做除法。以 n10 组合为例,A 组 nice 0 权重 1024,B 组 nice 10 权重 262,若两组任务同处一个运行队列瓜分调度周期,时间比就是 1024/262 ≈ 3.91。四组的完整理论值:
base:  1024 / 1024 = 1.00
n10:   1024 / 262  = 3.91
n20:   1024 / 15   = 68.27
neg10: 2304 / 1024 = 2.25
neg10 组合值得单独说一句:它与 n10 的权重差距其实不大(2.25 倍对 3.91 倍),只是方向相反——A 组拿负 nice 提权,B 组保持默认。负 nice 需要 root 或 CAP_SYS_NICE 能力才能设置,这也是实验全程用 sudo 跑的原因。理论上这两组应该呈现明显不同的实测比值,但后面的数据会显示,在本机拓扑下它们收敛到了几乎相同的数字。
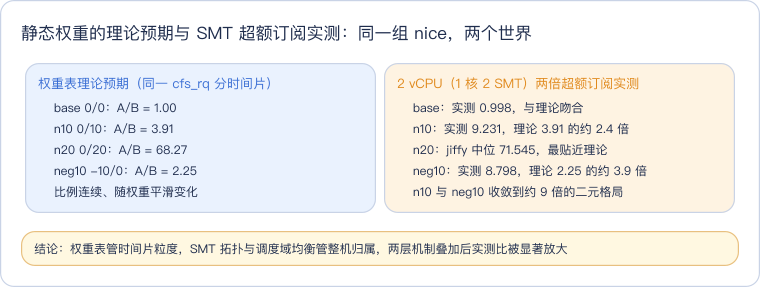
下面这张对比卡把「权重表承诺的世界」和「本机实测的世界」并排放在一起,先给结论,再用数据逐项展开。
四、实测数据:五轮完整结果与双口径差异
五轮重复的全部原始数字如下,ratio 为 getrusage 口径、jratio 为 /proc jiffies 口径,均取 A 组总和除以 B 组总和:
| 组合 | 轮次 ratio | ratio 中位 | 轮次 jratio | jratio 中位 |
|---|---|---|---|---|
| base | 0.994 / 1.009 / 1.005 / 0.998 / 0.996 | 0.998 | 1.001 / 1.013 / 1.006 / 0.998 / 0.998 | 1.001 |
| n10 | 9.131 / 9.245 / 9.231 / 9.168 / 9.240 | 9.231 | 9.500 / 9.457 / 9.493 / 9.357 / 9.487 | 9.487 |
| n20 | 53.933 / 57.148 / 43.988 / 59.233 / 57.301 | 57.148 | 71.682 / 71.409 / 71.545 / 71.591 / 71.455 | 71.545 |
| neg10 | 8.799 / 8.798 / 8.762 / 8.787 / 8.819 | 8.798 | 9.439 / 9.391 / 9.397 / 9.419 / 9.365 | 9.397 |
中位汇总段原样摘录如下,与日志逐字一致:
MEDIAN combo=base   ratio=   0.998 jratio=   1.001 n=5
MEDIAN combo=n10    ratio=   9.231 jratio=   9.487 n=5
MEDIAN combo=n20    ratio=  57.148 jratio=  71.545 n=5
MEDIAN combo=neg10  ratio=   8.798 jratio=   9.397 n=5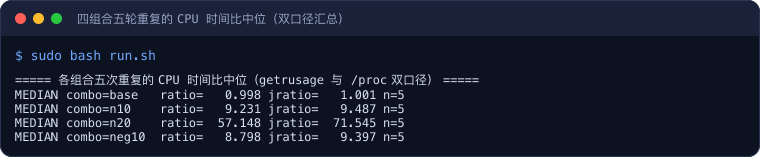
数据图把四组的理论比与两个口径的实测中位画在同一根对数轴上。对数轴是必要的:n20 的比值在 60-70 量级,base 在 1 附近,线性轴会把 base、n10、neg10 三根柱子压成一团无法分辨。
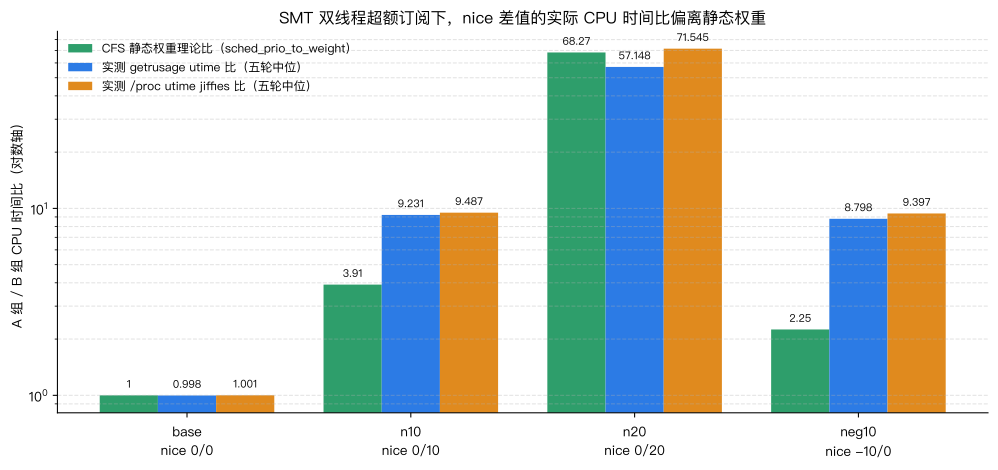
读这张图抓住三个落差。第一,base 组三根柱几乎等高,说明无权重差异时双口径与理论完全一致。第二,n10 与 neg10 的理论柱一高一低(3.91 对 2.25),实测柱却几乎齐平,都落在 9 附近,拓扑效应盖过了权重差。第三,n20 是唯一实测与理论同量级的组合:jiffy 中位 71.545 对理论 68.27,偏差约 5%,而 getrusage 口径只有 57.148 且五轮离散度很大。
n20 的双口径分裂要从 10ms 量化粒度解释。B 组 nice 20 的权重只有 15,在 8 秒窗口里总共只拿到约 0.3 秒 utime,jiffy 记账恰好是 22 个 tick。22 个 tick 意味着单个 tick(10ms)的进出就占总量的约 4.5%,而 getrusage 的毫秒级浮点读数在任务被频繁细碎调度时,对这段不足 0.3 秒的运行时间更敏感,五轮 ratio 从 43.988 摆到 59.233。反倒是粗糙的 jiffy 口径,因为每轮都稳定记到 22 个 tick,jratio 稳在 71.4-71.7 的窄带内。小样本观测时,粗粒度计数器不一定比细粒度时钟差。
五、SMT 拓扑如何把权重差异放大成二元格局
理论比与实测比的落差,根子在这台机器的拓扑:不是 2 颗独立物理核,而是 1 颗物理核上的 2 个 SMT 兄弟线程。SMT 兄弟共享同一颗核的执行单元、L1/L2 缓存和负载端口,操作系统把它们当作两个独立 CPU 记账,但它们并不是两条互不干扰的跑道。
四个任务、两个 CPU,调度器的行为分两层展开。第一层是时间片粒度的 CFS 权重分配,也就是权重表描述的世界:同一个 cfs_rq 上,nice 0 的任务每次拿到的时间片是 nice 10 任务的约 3.91 倍。第二层是调度域负载均衡:内核周期性地(以及任务唤醒时)在 SMT 调度域内比较各 CPU 的负载,倾向于把同权重、同组的任务摊平到两个兄弟线程上,让两个硬件线程都不空转。
两层叠加后出现的局面是:A 组的两个 nice 0(或负 nice)任务权重高、连续运行能力强,负载均衡很容易把它们分别安置到两个 SMT 线程上并长期占满;B 组的两个低权重任务只能在 A 组任务时间片用完、tick 重平衡触发、或任务因调度让出的缝隙里被插入运行。由于两个硬件线程都已被高权重组占住,低权重组获得的不再是「按权重切走一块时间片」,而是「等占核者出现空隙时补位」。这解释了两个看似反常的结果:
- n10 实测 9.231,远高于理论 3.91。权重差距在时间片层面只有约 4 倍,但占核效应把 B 组的实际运行窗口压缩到了 A 组的九分之一左右。
- neg10 实测 8.798,与 n10 几乎相同,尽管理论比只有 2.25。一旦高权重组占住两个线程,2.25 倍和 3.91 倍的权重差异都已足够维持「占核者 vs 补位者」的二元格局,继续加大权重比也不会线性改变结果,两个组合因此收敛到同一个约 9 倍的平台。
n20 反而最贴近理论(71.5 对 68.27),是因为 B 组权重 15 已经低到几乎退出竞争,A 组近乎独占整机,此时观测到的比值主要由两边极端的权重比决定,拓扑放大的边际空间反而变小了。
这套机制也划清了一条适用边界:上述数字是 SMT 小机器、超额订阅场景的产物。在拥有多颗独立物理核、任务数不超过核数的机器上,每个任务可以稳定占有一个完整核,nice 权重只在核内队列发生竞争时才起作用,实测比例会向理论值回归。SMT 机器上的 9 倍平台不可与独立物理核机器横向比较。
六、perf stat 调度事件佐证
仅有时间账还不够,需要调度侧事件证明「频繁让出与重平衡」确实在发生。对 n10 组合的整棵进程树跑 perf stat,采集上下文切换与迁移计数:
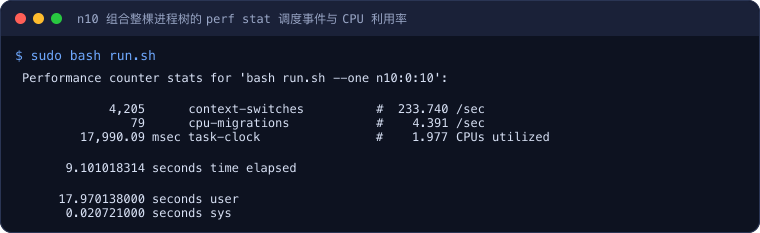
三个事件各自说明一个事实。context-switches 为 4205 次、每秒 233.74 次,9 秒窗口里四个燃烧进程被切换了四千多次,说明低权重 B 组确实在被反复插入与换下,而不是一次调度后睡到结束。cpu-migrations 为 79 次、每秒 4.39 次,任务在两个 SMT 线程之间持续迁移,印证调度域负载均衡在主动摊平负载。task-clock 17990.09 毫秒对应 1.977 CPUs utilized,墙钟 9.10 秒里两个 vCPU 几乎被吃满(2 个 CPU 的理论上限是 18.2 秒 task-clock),竞争是实打实的整机饱和,不存在空闲 CPU 让 B 组安静运行。
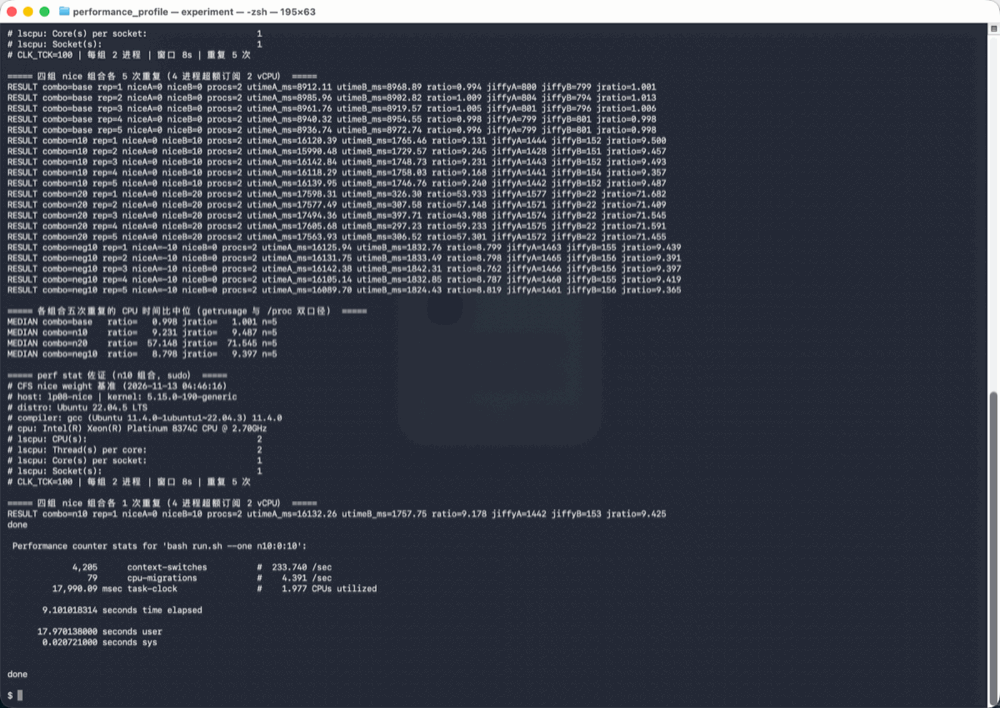
这张整窗记录从上到下分三段:开头是环境头与 base、n10、n20、neg10 四组合共二十条 RESULT 原始行,中段是四条 MEDIAN 双口径汇总,末段是 n10 的 perf stat 输出。对照阅读时可以重点看 n20 五行的 jiffyB 列——五轮全部是 22,这正是上一节双口径分裂分析的直接来源。
七、测量边界与工程含义
把本次实验的边界讲清楚,比记住具体数字更重要:
- 未做
taskset绑核,任务在两个 SMT 线程间自由迁移,迁移本身就是观测现象的一部分;绑核后的比例会不同,绑核技术与影响见 线程亲和性。 - 未触碰 cgroup 的
cpu.weight等控制项,所有结论仅针对 CFS nice 权重这一条路径;需要精确配额应走 cgroup CPU 控制器,而不是靠 nice 估算。 - 数据来自 1 物理核 2 SMT、2 倍超额订阅的虚拟机,不能外推到独立物理核机器,也不能外推到任务数少于核数的无竞争场景。
- 设置负 nice 需要 root 或
CAP_SYS_NICE;普通用户只能调高自己进程的 nice 值(降低优先级)。 - nice 影响的是普通进程的 CFS 调度,对实时调度类无效;实时任务的优先级体系见 Linux 实时调度。
- 本次未采集运行队列延迟(run queue latency)数据,调度侧证据以上述 perf stat 三个事件为准,不对未观测的延迟量做推断。
工程上的直接结论有三条。其一,nice 是相对优先级旋钮,不是精确配额工具:权重表给的是时间片层面的比例,整机实际分配还要经过拓扑与负载均衡的再加工,拿 3.91 这样的理论值去做容量规划是危险的。其二,SMT 小规格机器上,nice 差异容易被放大成占核与否的二元格局,想让低优先级任务保住确定的 CPU 份额,应使用 cgroup 配额或独立物理核绑核。其三,观测极低份额任务时,jiffy 的 10ms 量化粒度会主导误差,单次实验不足为凭,本篇采用的五轮重复取中位、双口径互证是必要的取证方式;同类基准的方法学可参照 STREAM 内存带宽实测。
实验环境
- 机器/系统:上海云主机,2 vCPU(1 物理核 2 SMT 兄弟线程),Intel Xeon Platinum 8374C @2.70GHz,Ubuntu 22.04.5 LTS
- 工具版本:gcc (Ubuntu 11.4.0-1ubuntu1~22.04.3) 11.4.0;内核 5.15.0-190-generic;CLK_TCK=100(jiffy 10ms)
- 日期:2026-11-13
- 完整命令:
make && sudo bash run.sh(四组合各 5 次重复,另对 n10 跑一次 perf stat 佐证)
代码获取
实验源码、运行脚本与完整结果已同步到公开仓库:
github.com/derekzhuo/geek-doc.cn — experiments/linux-cfs-nice-weight-throughput
克隆后进入该目录执行 make && sudo bash run.sh 即可复现全部四组合五轮测试与 perf stat 采样,原始输出与本篇引用的结果逐行对应。
这一篇在知识体系里的位置
本篇落在进程调度模块的「调度策略与实测」分支。向上承接 CFS 的整体工作方式:进程调度 讲调度时机与运行队列,Linux 调度类 讲 CFS 与实时调度类的层级;向旁边的实测篇目对齐方法学:上下文切换的开销与观测 用 perf 事件量化切换成本,minor/major 缺页单次成本实测 示范双口径与重复取样,STREAM 内存带宽实测 展示基准测试的完整取证流程。工程延伸方向上,线程亲和性 对应本篇测量边界里的绑核手段,Linux 实时调度 则是 nice 管不到的另一条调度路径。
总结
CFS nice 权重的静态表(nice 0 为 1024,nice 10 为 262,nice 20 为 15,nice -10 为 2304)只承诺同一运行队列上时间片粒度的 vruntime 推进比例;在 1 物理核 2 SMT、四个燃烧进程两倍超额订阅的实测里,base 组实测 0.998 与理论 1.00 吻合,但 n10 实测 9.231、neg10 实测 8.798,分别远高于理论的 3.91 和 2.25,且两者收敛到同一个约 9 倍平台——高权重组经调度域均衡占满两个 SMT 线程后,低权重组只能在重平衡缝隙里补位,权重差异被拓扑放大成「占核者与补位者」的二元格局;n20 的 jiffy 中位 71.545 最贴近理论 68.27,而 getrusage 口径因 B 组仅 22 个 tick、10ms 量化粒度占比过高而离散,双口径互证与五轮取中位是这类小份额测量的必要纪律。工程上 nice 是相对优先级旋钮而非配额工具,精确 CPU 份额应交给 cgroup 或绑核,且 SMT 小机器的实测比例不可与独立物理核机器横比。