搜索引擎如何观察网站:它看到什么,又凭什么给你排名
最后更新:2026-09-09
本主题要回答的问题
- 搜索引擎到底通过哪些途径“观察”一个网站?它看到的你,和真实的你一样吗?
- 同样是被抓取,为什么有的站被疯狂抓取却没有任何排名,有的站抓得不多却能稳定带来搜索访客?
- “排名”这一下到底是怎么发生的?哪些信号算数、哪些只是站长自己的想象?
讲搜索引擎原理的文章很多,但大多停留在“抓取、索引、排名”三个名词上(我们自己也有一篇讲这条流水线的入门文:搜索引擎工作原理:抓取、索引与排名)。这篇换个视角:站在搜索引擎那一端,看它如何像一个调查记者一样观察你的网站——它有哪些信息来源、观察到什么会加分、什么会减分、为什么“看见你”和“愿意推荐你”是两回事。
为了不说空话,本文的机制部分依据 Google 搜索中心(Google Search Central)的公开文档,实证部分用的是我们自己运维的一个技术教程站在 2026 年 8—9 月连续 30 天的服务器访问日志(只引用脱敏后的聚合数字)。你会看到,真实日志里发生的事情,比任何“SEO 秘籍”都更能说明搜索引擎是怎么工作的。
一、搜索引擎的“眼睛”长在哪:三条观察通道
很多人以为搜索引擎对网站的了解全部来自爬虫。其实不是。它关于一个站的信息档案,由三条通道共同喂出来,三条通道的“主动方”还各不相同:
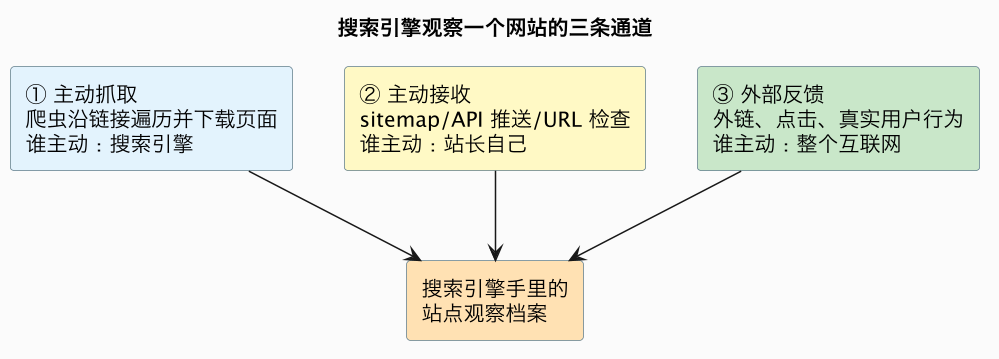
三条通道看到的东西不一样,可信度也不一样,这件事对后面理解排名特别关键:
| 通道 | 谁主动 | 你能控制什么 | 典型证据形态 |
|---|---|---|---|
| ① 主动抓取 | 搜索引擎 | 让不让抓、抓得顺不顺(robots、速度、结构) | 访问日志里的爬虫请求、状态码、抓取频率 |
| ② 主动接收 | 站长 | 告诉它“我有这些页、这些是新的” | sitemap.xml、IndexNow/Bing 推送、百度推送、Search Console 的 URL 检查 |
| ③ 外部反馈 | 第三方与用户 | 间接经营:内容被引用、被点击、被读完 | 反向链接、锚文本、SERP 点击率、回访与停留 |
这里先埋一个反直觉的点:通道①②是“你自己说自己好”,通道③才是“别人说你好”。 你在页面里把关键词堆满、把 sitemap 提交得再勤,都属于自证;而别的网站为什么链你、真实用户搜到之后点不点你、点进去几秒就走还是认真读完——这些是搜索引擎无法被你直接控制的旁证。任何一个成熟的排名系统,都不会只凭自证下结论。
第二条通道里几个工具值得分清:robots.txt 是“君子协定”式的抓取许可,告诉爬虫哪些路径别来抓,但它本身不是“不收录”指令——一个没有任何正文、只被外链指向的 URL,即便被 robots 禁抓,仍可能以“无简介”的形式出现在结果里;真正的不收录要用 noindex。sitemap.xml 是你主动交出去的“站内地址清单”;IndexNow 是 Bing、Yandex 等支持的“页面有更新,请来重抓”的即时 ping 协议;Google Search Console(类似的还有 Bing 网站管理员工具、百度搜索资源平台)里的 URL 检查,则允许你手动把一个地址“排队送检”。这些机制在搜索引擎验证与提交里有完整操作说明,这里只要记住:它们都只能加速“被观察”,不能代替“被认可”。
二、它如何“观察”一个站:抓取阶段的真实行为
2.1 抓取不是免费的:抓取预算从哪来
互联网上有海量网页,而搜索引擎的算力是有限的,所以它对每个站愿意花多少抓取次数有个动态配额,Google 官方称之为抓取预算(Crawl Budget)。官方文档把它拆成两个因子的交集:抓取速率上限(爬虫从你服务器抓内容而不把你拖垮的最大速率,你站越快越稳,这个上限越高)和抓取需求(它有多想来抓——首页等重要页需求高,长期没人链接、没人访问的页需求低)。文档里还有一句让很多 SEO 文章尴尬的原话:大多数规模不大的站点根本不需要担心抓取预算,真正会被它卡住的,是页面数量上万、且夹杂大量重复参数 URL 和软 404 的大站。
预算会被什么浪费掉,官方和我们的日志给出的答案高度一致:无限重复的参数页(?page=1、?sort=price 之类)、内容雷同的薄页、一长串重定向链、以及大量 404。把这些清掉,等于把有限的观察机会留给真正重要的页面。
2.2 同一时间,不同爬虫性格完全不同
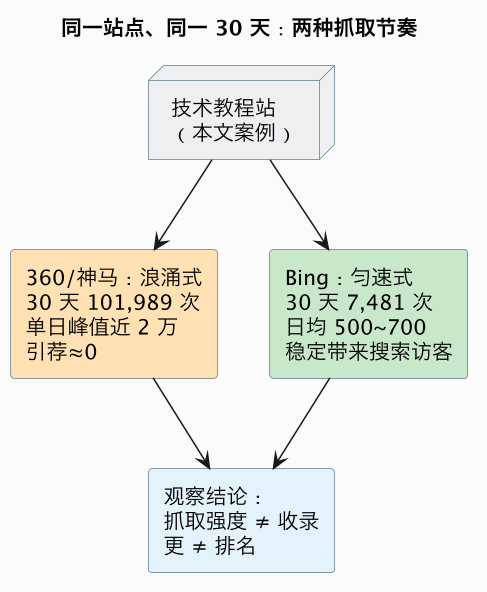
这是最有意思的部分。在我们这个技术教程站 2026 年 8 月 7 日到 9 月 5 日的 30 天里,服务器一共收到 283,820 次请求,其中 212,024 次(74.7%)来自各类机器人。把几大搜索引擎爬虫拆开看,行为差异大到不像同一个物种:
| 爬虫(30 天) | 抓取次数 | 去重 IP | 抓取节奏 | 搜索引荐(真实访客) |
|---|---|---|---|---|
| 360 / 神马(YisouSpider) | 101,989 | 2,268 | 浪涌式,9 月 2、4 日两天合计近 3.5 万次 | 埋点侧几乎为 0 |
| Bing(bingbot) | 7,481 | 574 | 匀速,近期日均 500~700 次 | 唯一稳定、成规模带来搜索访客 |
| Google(Googlebot 系) | 4,895 | 41 | 平时零散,主动验证当天从几十跳到 1,358 | 几乎为 0 |
| 百度(Baiduspider) | 3,745 | 278 | 8 月中有一波,近期回落到日均几十 | 观测窗内为 0 |
| 搜狗(Sogou) | 430 | 10 | 低位 | 0 |
光看这张表就能纠正两个流行误解。第一,“爬得越勤 = 越喜欢你 = 排名越好”是错的。 360/神马以占全部请求 35.9% 的碾压级抓取量横扫全站,去重 IP 多达 2,268 个,却是典型的“先把整站抓回去入库再说”,短期内并不对应任何搜索引荐;反而是抓取量只有它十几分之一的 Bing,节律最克制,引荐最实在。第二,主动提交确实能立刻换来观察,但只换来观察。 8 月 25 日我们在 Google Search Console 完成验证并提交 sitemap,当天 Google 的抓取量就从日常几十次跳到 1,358 次——送检通道非常灵敏;可在那之后的十几天里,它引荐来的真实搜索访客依然接近零。“叫得动爬虫”和“拿得到排名”,中间隔着的正是本文第三章要讲的信任与评估。
2.3 抓到了,不等于看懂了、存下了
爬虫取回一份 HTML 之后,还要过解析和渲染这一关。现代 Googlebot 用的是常青版 Chromium 内核,能执行 JavaScript,但“能”不代表“马上、一定”:Google 官方描述过两波索引的工作方式——第一波先按原始 HTML 入库,JavaScript 渲染往往排在第二波,存在明显延迟;渲染失败、超时或依赖的接口报错时,页面就可能只以空壳形态被记录。这就是为什么纯前端渲染(SPA,Single Page Application,单页应用)在 SEO 上天然吃亏,也是我们坚持用静态站点生成、让正文直接出现在 HTML 里的原因,更细的机制见前端框架与 SEO。
三、从观察到排名:一下查询背后发生了什么
页面被观察、入库之后,真正的排名发生在用户输入查询的那几百毫秒里。把它想成一场逐层收窄的选拔赛会比较准确:
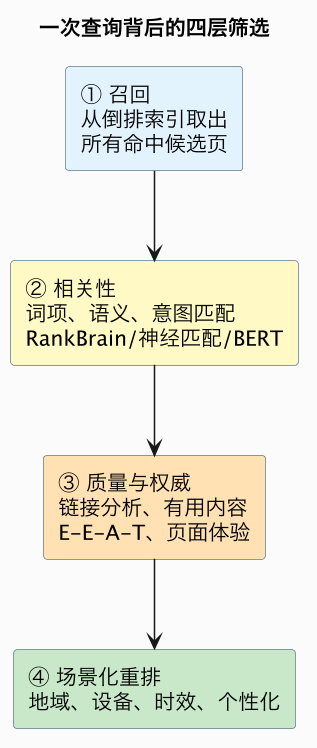
第一层召回靠的是倒排索引(Inverted Index)这种“词 → 包含它的文档列表”的数据结构,引擎不必实时扫描全网,取几个词的列表求交集即可。这层解决“有没有资格参赛”,机制细节在搜索引擎工作原理里讲过,不再展开。
第二层解决“你答的是不是这个问题”——相关性。 早期主要靠词项匹配:标题、正文、图片 alt、乃至指向该页的锚文本里有没有查询词。现代引擎大量引入语义模型,Google 公开点名过的相关系统包括:RankBrain(把没见过的查询映射到已知含义的机器学习系统)、神经匹配(Neural Matching,理解查询与页面在概念上的对应)、BERT(基于 Transformer 的双向语言模型,擅长处理介词、长难句里的细微语义)。这一层最重要的进化是从“匹配字面”走向“匹配意图”:搜“苹果笔记本充电发烫”,一篇通篇堆砌“苹果”二字的采购页排不过一篇真正解释电源管理的文章。搜索意图通常分为信息型(想了解)、导航型(想找某个站)、交易型(想买)、商业调研型(想比较)四类,页面满足的是哪一类,决定了它该和谁竞争。
四、实证:为什么抓了上万次,却没有排名
现在可以回答开头那个最扎心的问题了。把 30 天数据按“抓取”和“引荐”两个维度并排看,会出现一个教科书式的错位:
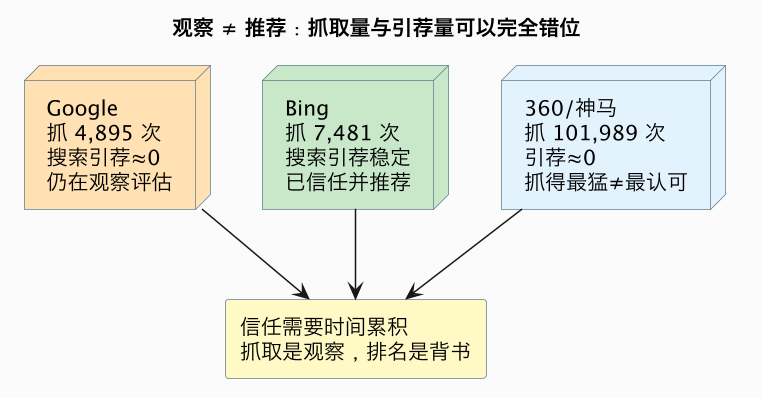
Google 抓了近 5,000 次却没有带来搜索访客,而 Bing 抓得更少却稳定导流——这不是 Google“针对”谁,而是不同引擎的收录节奏、对新站的信任阈值本来就不同。行业里把新站这段“只抓不排、或排名剧烈波动”的时期称为评估期(俗称“沙盒效应”,Sandbox Effect)。需要诚实说明:“沙盒”是从业者根据大量观测总结的经验概念,Google 从未承认存在这样一个按时间生效的惩罚性开关。官方的解释更朴素:新站缺少历史数据、缺少第三方旁证(外链、品牌搜索、稳定的用户反馈),系统对它的质量判断没有把握,于是只观察、少推荐,等信号攒够了再逐步放量。从日志看,这个解释与实际完全自洽——我们 8 月 21 日开始用埋点统计真实读者时,全站只有 10 个 UV(独立访客)/天;随着 Bing 收录放量和持续的内容上新,到 9 月初站稳在约 90 UV/天。搜索引擎不是某天早上突然“解封”了你,而是在连续观察中慢慢确认:这站活着、稳定、内容真的有人用。
把“观察到却不推荐”的几种典型情形拆开,各自的对策也不同:
| 现象 | 真实含义 | 该做什么 |
|---|---|---|
| 抓取正常,索引量很低 | 抓到了但没看懂/没认可:JS 空壳、重复页、薄内容 | 把正文放进服务端直出 HTML,canonical 收敛重复页,参考前端框架与 SEO |
| 有索引、有曝光,没点击 | 相关性够了,但标题/摘要在结果页没有吸引力 | 打磨 title 与 description,匹配真实意图,参考内容与关键词 SEO |
| 有点击,但排名长期停滞 | 内容能用,但权威与用户反馈不足 | 攒第三方旁证:被引用、被讨论、主题成体系,理解什么是网站权重 |
| 抓得极猛、零引荐(如本期 360) | 入库型抓取潮,处于评估早期 | 不用慌也不用喜,保证供给节奏;必要时评估 robots 限速省带宽 |
| 故障期大量 503 后排名下滑 | 可观察性受损,信任被打折 | 先恢复可用性(比一切优化都优先),再等待重新观察 |
五、反推:怎样被正确地观察、被信任地推荐
把整条逻辑链反过来,SEO 就不再是玄学,而是一张分工清楚的行动表:
| 做法类别 | 作用于哪一阶段 | 具体动作 |
|---|---|---|
| 把路修通 | 观察 / 抓取 / 索引 | 稳定可用、速度快;sitemap 与推送主动告知;robots、canonical、301 收敛重复与旧链;正文直出 HTML;结构化数据 |
| 把答对好 | 相关性 | 围绕真实搜索意图组织内容,一个页面答透一个问题,标题/首段/锚文本自然出现核心词,主题成簇互链 |
| 把信任攒足 | 质量 / 权威 | 写作者真懂行(亮出经验与来源)、持续更新、争取同行的自然引用、打磨 Core Web Vitals 与移动端体验 |
| 别耍小聪明 | 全阶段(反向) | 堆砌关键词、买卖外链、隐藏文本、采集伪原创——全是“为排名而非为用户”的痕迹,短期或许骗得过观察,长期骗不过基于人工评估校准的模型 |
我们这个站本身就是这套逻辑的样本:静态生成保证每个页面打开就是完整正文(看得懂),sitemap 加 IndexNow/百度推送保证更新当天就被发现(叫得动),死链逐条 301、故障当天修复(不丢分),然后把力气主要花在持续写有实测、有代码、能解决真问题的内容上(攒信任)。完整的改造过程记录在本站的 SEO 落地实践。30 天里最能说明问题的不是爬虫数字,而是那个慢变量:真实独立访客从 10 涨到 90,且连续站稳。抓取可以一夜之间暴涨,信任只能按周、按月地累积。
一句话总结
搜索引擎通过爬虫主动抓取、站长主动提交、互联网外部反馈三条通道观察网站,其中前两条是“你自证”、第三条才是“别人旁证”;观察阶段它受抓取预算约束、对不同站点表现出完全不同的抓取节奏(我们 30 天日志里,360 狂抓 10 万次零引荐、Bing 匀速 7 千次却稳定带量),而且“抓到”不等于“看懂、入库”;排名发生在查询时刻,经召回 → 相关性 → 质量权威 → 场景重排四层筛选,相关性靠语义与意图、质量靠链接与 E-E-A-T 等第三方旁证。所以新站“只抓不排”不是被惩罚,而是观察在累积、信任尚未建立——把路修通让它看得懂,把内容答对让它认得准,把信任交给时间和真实用户,排名是这一切的结果而不是可以单独刷出来的开关。
第三层解决“凭什么信你”——质量与权威。 这是候选页之间拉开差距的主战场,也是本文开头“第三条通道”发挥作用的地方:
| 层 | 回答的问题 | 主要信号 | 证据来源性质 |
|---|---|---|---|
| 召回 | 哪些页提到了这个主题 | 倒排索引中的词项、结构化数据 | 内容自身 |
| 相关性 | 哪页真正回答了这个查询 | 标题/正文、锚文本、语义模型、意图匹配 | 内容自身 + 链接语境 |
| 质量权威 | 哪页最值得信任 | 链接分析、有用内容系统、E-E-A-T、品牌提及 | 大量来自第三方旁证 |
| 场景重排 | 此刻、此设备、此地哪页最合适 | 地域、设备、时效、新鲜度、个性化 | 查询时实时计算 |
关于质量,有两个被传得很玄、其实官方讲得很清楚的概念。一个是链接分析:Google 起家的 PageRank 把链接当作投票,被越多高质量页面引用的页面越重要;今天原始 PageRank 工具栏分数早已取消,但“互联网因信任你而自发形成的引用”仍是核心信号之一,Google 搜索团队也多次在公开场合把“内容”和“指向网站的链接”列为最重要的信号梯队。注意是“因信任而形成”——买卖来的、批量互刷的低质链接,会被专门的反垃圾系统识别并贬值甚至惩罚,链接的“质”远重于“量”。另一个是 E-E-A-T:经验(Experience)、专业(Expertise)、权威(Authoritativeness)、可信(Trust)四个词。需要澄清的是,E-E-A-T 不是某个自动打分的数值,而是《搜索质量评估员指南》给真人评估员用的评判框架——Google 雇人按这套标准给结果页打分,再用这些人工评价去校准算法,让算法学会奖励“由真正懂行的人、为帮助用户而写”的内容;医疗、金融、法律这类“错了会害人”的 YMYL(Your Money or Your Life,关乎你的钱与生活)主题,标准最严。页面体验也是可量化的一环,即 Core Web Vitals(核心网页指标):LCP(最大内容绘制,管加载快慢)、INP(交互到下一次绘制,管响应跟不跟手,2024 年已取代 FID)、CLS(累积布局偏移,管页面会不会乱跳),指标怎么测见核心指标与工具。
第四层是场景化重排:同样的查询,在手机上、在某个城市、在某件突发新闻刚发生时,结果顺序可以不同。它提醒我们排名从来不是一个固定名次,而是“查询 × 用户 × 场景”的函数。
服务器的每一个回应都在被记账,状态码本身就是观察材料。我们这 30 天里最有说服力的一个自然实验是可用性:8 月 7—20 日站点处于故障期,日志里躺着 29,713 个 503(服务暂时不可用)响应;8 月 21 日修复之后,连续十几天 503 归零。你可以把这件事理解成“调查记者上门采访连续两周吃闭门羹”——它短期内不会立刻把你拉黑,但会明显降低回访频率和信任评价,等你恢复后,它也需要重新观察一段时间才敢放心推荐你。同期还能看到 3,784 次 301(永久重定向)持续命中,说明旧地址被正确地导向了新地址、历史权重没有白白浪费;重定向规则和可索引性的完整清单在技术 SEO:可索引性与页面结构。