ptmalloc、jemalloc、tcmalloc 多线程争用实测:吞吐与尾延迟拐点在哪
C/C++ 服务里 malloc/free 看起来只是一行库调用,但在多线程进程中,分配器的内部结构往往决定了锁争用的烈度:glibc 自带的 ptmalloc 用 arena 加锁保护,jemalloc 靠多 arena 分片稀释争用,tcmalloc 则把每线程缓存放在最前面。三者的设计文档都能讲出一套道理,真正到了 2 个 vCPU 的小规格实例上、线程数超过核数时谁先掉速,只能靠同一个申请流逐档测量。本篇用一份固定随机种子的多线程基准,在同一台 2 vCPU/8 GiB 云主机上对照三者的总吞吐与单点延迟,再用 perf stat 的上下文切换与缺页计数给锁争用做旁证。用户态内存管理的内核侧背景可先读缺页异常的 minor 与 major 成本实测,应用层绕开通用分配器的做法见 C++ arena/池化分配器基准:为什么高频小块要自己管内存。
本文要回答的问题
- 同样的 malloc/free 申请流,三个分配器的总吞吐差多少倍?
- 线程从 1 增到 2 再到 4(超过物理核数),谁的吞吐先塌、谁能保住线性度?
- p99、p999 尾延迟的差距比平均吞吐更悬殊,根源在各自结构的哪一层?
perf stat的上下文切换、CPU 迁移、缺页计数能否佐证锁争用的推断?- 小规格云主机上的结论,换到多核大机器还成立吗?
一、三个分配器的结构差异:锁放在哪一层
先把三者的设计摊在同一张卡上,后面的每一组数字都对应这里的某条结构差异。
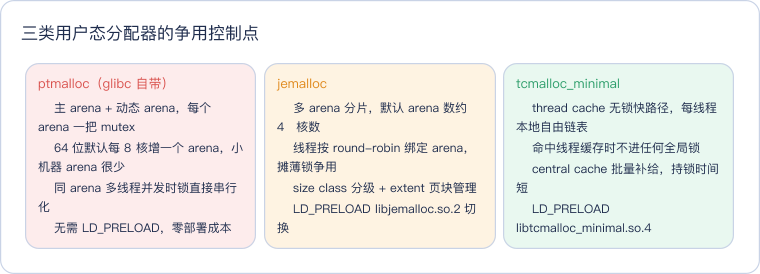
读这张卡只看一条主线:锁离单次 malloc 有多远。ptmalloc 的锁在每次分配的必经路径上;jemalloc 用 arena 分片降低撞上同一把锁的概率;tcmalloc 干脆把最常见的小块申请收进每线程私有缓存,正常情况下连共享状态都不碰。
下图把一次申请在三种结构里的走向画出来,颜色与卡片一致:红色是带锁的共享控制点,绿色是无锁的线程本地路径。
三条路径的共享层级依次后移,这正是后面 tcmalloc 尾延迟最低、ptmalloc 随线程数恶化的结构性原因。
二、基准设计:同一份申请流,只换分配器
基准程序 alloc_bench 让每个工作线程维护 4096 个存活分配组成的稳态环形工作集,按 6:3:1 的比例申请 64 B、1 KiB、16 KiB 三种对象,每轮做「申请 → 触写第一页 → 随机替换一个存活项并释放」。三个分配器跑的是同一份二进制、同一套固定随机种子(种子含线程号,保证同档位逐位一致的申请流),唯一变量是 LD_PRELOAD。线程数扫 1、2、4 三档,每档三轮;机器只有 2 个 vCPU,4 线程是两倍超额订阅,刻意把争用压出来。总吞吐按全进程墙钟计算,单点延迟只从前 2 万次申请里采样,所有线程样本合并排序取 p50/p99/p999。
三轮中位数汇总如下。
| 分配器 | 1 线程吞吐 | 2 线程吞吐 | 4 线程吞吐 | 1 线程 p99 | 2 线程 p99 | 4 线程 p99 |
|---|---|---|---|---|---|---|
| ptmalloc | 23.79 M/s | 27.78 M/s | 23.22 M/s | 250 ns | 343 ns | 351 ns |
| jemalloc | 35.63 M/s | 36.10 M/s | 30.09 M/s | 136 ns | 162 ns | 190 ns |
| tcmalloc | 60.74 M/s | 56.04 M/s | 49.97 M/s | 44 ns | 67 ns | 81 ns |
下图左面板是三档线程数下的总吞吐柱,右面板是 p99 延迟随线程数的折线(对数轴)。
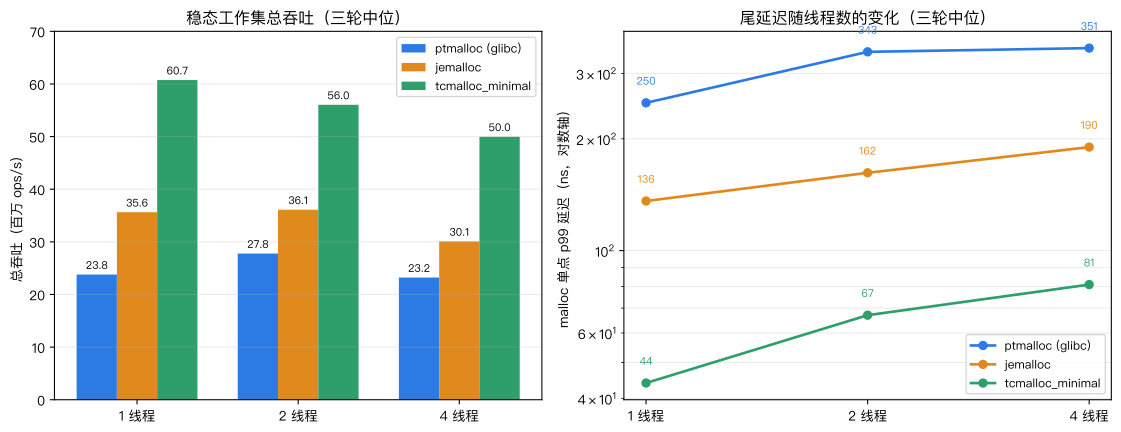
左图先看单线程:tcmalloc 60.7 M/s 对 ptmalloc 23.8 M/s,约 2.55 倍差距,此时没有任何跨线程争用,差距全部来自快路径本身的指令数——线程缓存命中只是摘下本地链表节点,ptmalloc 则要进 arena 锁、查 bin。右图更关键:ptmalloc 的 p99 从单线程 250 ns 抬到 4 线程 351 ns,tcmalloc 只从 44 ns 抬到 81 ns。两者的倍数差距从 5.68 倍缩小到 4.33 倍,但绝对延迟差反而从 206 ns 拉大到 270 ns——ptmalloc 的尾延迟在争用下恶化得更快,tcmalloc 的数值始终低一个量级。
三、拐点:ptmalloc 为什么在 4 线程不升反降
把三档吞吐归一化看扩展性,比看绝对值更能暴露拐点。
| 分配器 | 1 线程 | 2 线程(相对 1 线程) | 4 线程(相对 1 线程) |
|---|---|---|---|
| ptmalloc | 23.79 M/s | 27.78 M/s(1.17×) | 23.22 M/s(0.98×) |
| jemalloc | 35.63 M/s | 36.10 M/s(1.01×) | 30.09 M/s(0.84×) |
| tcmalloc | 60.74 M/s | 56.04 M/s(0.92×) | 49.97 M/s(0.82×) |
ptmalloc 在 2 线程时还有 17% 的增长,到 4 线程直接跌回单线程水平之下——这就是锁串行化的典型形状:两个 vCPU 上跑四个线程,arena 数量不够分摊,线程在 mutex 上排队与唤醒的开销吃掉了全部并行收益。tcmalloc 与 jemalloc 的 4 线程回落则主要是超额订阅的调度税(只有两个核,四个线程必然时间片轮转),而非锁本身:它们 4 线程仍分别有单线程 82%、84% 的效率。
perf stat 在 4 线程档各跑一次,给出的旁证与这个解释方向一致。
 Performance counter stats for 'env LD_PRELOAD= ./alloc_bench -t 4 -n 2000000':

            164.81 msec task-clock                #    1.537 CPUs utilized
               133      context-switches          #  806.981 /sec
                17      cpu-migrations            #  103.148 /sec
             9,529      page-faults               #   57.817 K/sec

       0.107248455 seconds time elapsed

 Performance counter stats for 'env LD_PRELOAD=/usr/lib/x86_64-linux-gnu/libjemalloc.so.2 ./alloc_bench -t 4 -n 2000000':

            128.21 msec task-clock                #    1.532 CPUs utilized
                96      context-switches          #  748.762 /sec
                10      cpu-migrations            #   77.996 /sec
             8,368      page-faults               #   65.267 K/sec

       0.083662419 seconds time elapsed

 Performance counter stats for 'env LD_PRELOAD=/usr/lib/x86_64-linux-gnu/libtcmalloc_minimal.so.4 ./alloc_bench -t 4 -n 2000000':

             90.30 msec task-clock                #    1.731 CPUs utilized
                52      context-switches          #  575.851 /sec
                 5      cpu-migrations            #   55.370 /sec
             6,624      page-faults               #   73.355 K/sec

       0.052172518 seconds time elapsed
完成同样 200 万次迭代,task-clock 从 164.8 ms 降到 90.3 ms,上下文切换从 133 次降到 52 次,CPU 迁移从 17 次降到 5 次。锁等待越短,线程越少被调度器剥下 CPU,切换与迁移自然同步下降;缺页计数 9529 → 6624 的差异则来自 tcmalloc 按 size class 批量预留页块、触页模式更集中。计数与吞吐数据互相印证,不是单看一个指标下结论。上下文切换本身的成本拆解见上下文切换的成本到底有多大:一次 syscall 与线程切换的量化实测。
终端全景如下,注意左半区 glibc 九行的 ops_per_s 始终在 21.5–28.0 M 徘徊,右半区 tcmalloc 九行落在约 49.6–61.1 M 区间。
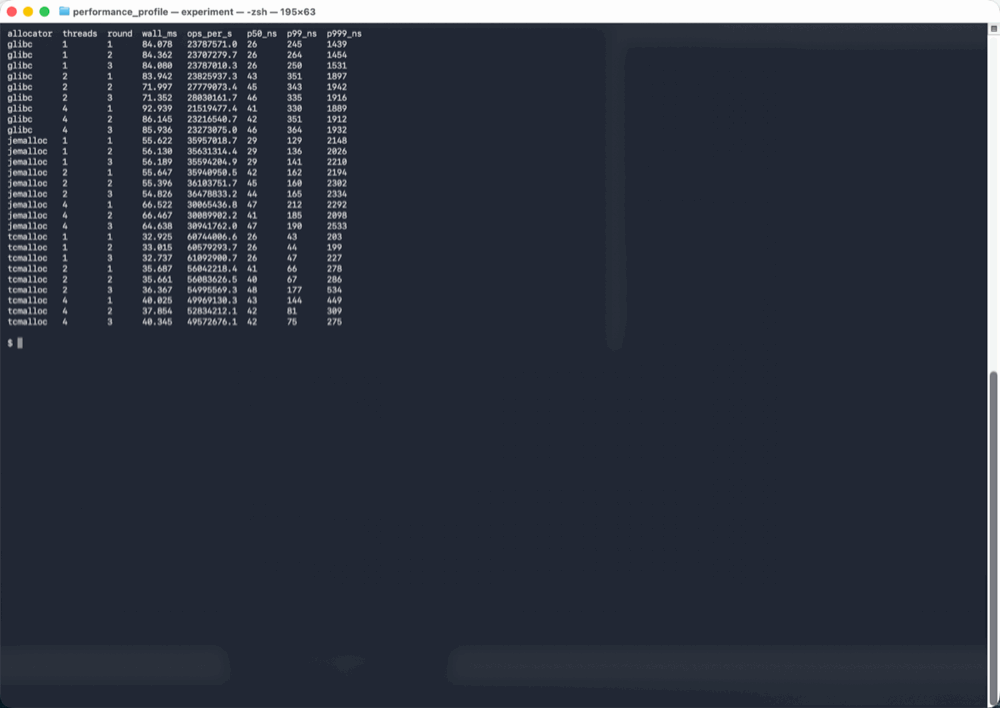
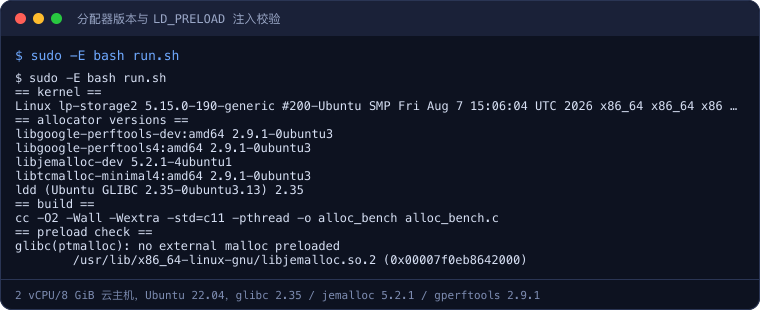
环境头与预加载校验的终端卡如下,ldd 输出证明每一档实际注入的分配器与声称的一致——这类 LD_PRELOAD 实验不做注入校验,结论就没有根基。
四、p999 里的反直觉细节与选型边界
均值漂亮不等于尾巴干净。看 p999(千分位最差 1‰)的三轮中位:ptmalloc 四线程约 1912 ns,jemalloc 反而约 2292 ns,tcmalloc 只有约 309 ns。jemalloc 的 p999 比 ptmalloc 还差,原因是它的 arena 补给走 extent 分配与页级元数据维护,低频但更重;稳态吞吐占优,可一旦样本落到 arena 扩容或脏页 purging 的窗口,单次延迟会被拉得很长。tcmalloc 的中心缓存批量补给把这种重操作 amortize 到成百上千次快路径里,p999 仍压在三百纳秒出头。
由此得到选型口径:
| 场景 | 建议 | 依据 |
|---|---|---|
| 高频小块、线程数常超核数的在线服务 | tcmalloc_minimal | 吞吐 2.5 倍于 ptmalloc,p99/p999 低一个量级 |
| 多核大机器、希望分片扩容又保留碎片控制 | jemalloc | arena 随核数扩,p999 长尾需配合 dirty page 参数评估 |
| 无部署条件、分配不在热路径 | ptmalloc 默认即可 | 零接入成本,低频 malloc 场景差距无感 |
| 延迟敏感且分配模式固定 | 应用层 arena/对象池 | 直接绕开通用分配器,见同簇 arena 实测篇 |
边界也要讲清楚:本次只有 2 vCPU,arena 数量优势在几十核的大机器上才完全展开,届时 jemalloc 的相对表现会比这里好看;工作集是 4096 项的常驻环形负载,不模拟大块突发与长生命周期碎片,这类场景需要另设基准。任何百分比都不应脱离这两个前提外推。
这一篇在知识体系里的位置
本篇属于进程与内存管理交叉的「用户态分配器」一环:向下对接缺页异常 minor/major 成本的内核侧机制,向旁边与上下文切换成本实测共享调度税的分析方法,向上承接应用层 C++ arena/池化分配器与字符串 SSO/移动语义的避分配实践。
实验环境
- 机器/系统:腾讯云 2 vCPU / 8 GiB 竞价实例,Ubuntu 22.04.5 LTS,内核 5.15.0-190-generic
- 工具版本:glibc 2.35(ptmalloc)、jemalloc 5.2.1(libjemalloc.so.2)、gperftools 2.9.1(libtcmalloc_minimal.so.4)、gcc 11.4.0、linux-tools perf
- 日期:2026-11-17
- 完整命令序列:
make
sudo -E bash run.sh
# 脚本内部:三分配器 × 线程 1/2/4 × 三轮矩阵,ldd 校验预加载;
# 4 线程档追加 perf stat -e task-clock,context-switches,cpu-migrations,page-faults代码获取:基准程序、Makefile 与矩阵脚本见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-malloc-ptmalloc-jemalloc-tcmalloc/。克隆后 make && sudo -E bash run.sh 即可复现,三轮原始 CSV 与 perf 输出在 results/ 目录。
总结
同一申请流实测显示:单线程下 tcmalloc 以 60.7 M/s 达到 ptmalloc 23.8 M/s 的约 2.55 倍;4 线程超额订阅时 ptmalloc 吞吐跌回单线程水平、p99 抬到 351 ns,而 tcmalloc 仍保有单线程 82% 的效率、p99 仅 81 ns,perf 的切换与缺页计数同步佐证锁争用解释;小规格延迟敏感场景 tcmalloc 优先,但 arena 分片优势在多核大机上的表现需要另测,不能照搬本篇百分比。