脏页回写调参:dirty_ratio 三档实测,过程卡顿与 fsync 尾部怎样取舍
业务日志里偶尔出现几秒的写停顿,iostat 看到云盘 util 打满,应用线程却卡在 write() 或 fsync() 上——这类问题十有八九绕不开页缓存的脏页回写。Linux 的缓冲写并不直接触盘,数据先留在页缓存里标记为脏,再由内核按两条水位线安排回写:dirty_background_ratio 触发后台 flusher 异步写盘,dirty_ratio 则是硬线,越线后应用自己在 write() 里被限流睡住。调这两个参数到底能改变什么,不能靠感觉,需要一次控制变量的突发写实测。本篇在一台 2 vCPU/8 GiB 云主机上,用自写的 C 基准程序发起 2560 MiB 缓冲写,对照宽松、中等、收紧三档阈值,把逐块写延迟、收尾 fsync 延迟和 vmstat 回写活动同时量出来。页缓存与直接 I/O 的路径差异可先回顾直接 I/O 与页缓存:绕过缓存到底绕过了什么,存储观测的整体地图见存储性能观测全景:从块设备到文件系统。
本文要回答的问题
dirty_background_ratio与dirty_ratio两条水位线各自触发什么动作,卡顿点是怎么产生的?- 三档阈值跑同一个 2560 MiB 突发写,总吞吐几乎相同,调参真正改变的是哪个维度?
- 为什么宽松档前半程飞快,却在收尾
fsync()上背了一笔 8 秒的账? - vmstat 的
bo与wa列怎样证明三档实验里云盘始终是同一个瓶颈? - 怕过程抖动的业务和怕尾部延迟的业务,各自该把阈值往哪个方向调?
先用一张对照卡把三档实验中最有决策价值的一组数字固定下来,卡中每个数字都来自后文三档实测的原始日志。
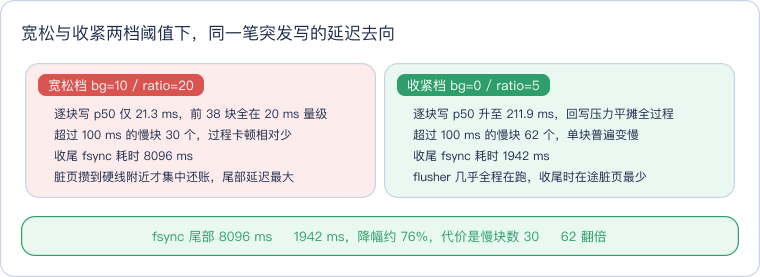
读这张卡先抓住一个反直觉点:左右两栏没有谁绝对更快,变化的是延迟落在什么位置。宽松档把磁盘 I/O 尽量推迟,写过程受益、收尾遭殃;收紧档让回写与写入并行发生,过程变慢但尾部被削平。三档总吞吐都在 153 MiB/s 附近,说明这次调参没有创造任何带宽,只是在同一条云盘管道上重新安排排队节奏。
一、两条水位线:脏页怎样从后台回写走到前台限流
缓冲写的快,本质是赊账。write() 把数据拷进页缓存并标记脏页后立即返回,磁盘 I/O 被推迟到稍后的回写阶段。推迟到什么程度,由 /proc/sys/vm/ 下两个百分比参数决定,百分比的基数是可用内存而非总内存。dirty_background_ratio 是后台线:脏页占比越过它,内核唤醒 flusher 线程(每个后备设备一组,旧内核里是 pdflush/writeback 线程)异步回写,应用本身不被拦。dirty_ratio 是硬线:脏页占比越过它,正在写的进程进入 balance_dirty_pages() 主动限流,睡在回写完成的等待队列上,表现为 write() 调用本身耗时几百毫秒。
读这张图抓住两条主线。绿色主线是理想路径:脏页越过后台线后 flusher 异步排空,应用全程不被拦,write() 维持在二十毫秒级。红色主线是失控路径:写入速度持续高于回写速度,脏页水位顶到硬线,应用被内核按在 balance_dirty_pages() 里限流,这就是逐块日志里那些上百毫秒毛刺的来源。橙色的 fsync() 是最后一道关:它不发起新的写法,只是等本文件的脏页全部落盘,所以它的耗时完全取决于收尾那一刻还压着多少账。紫色的调参动作移动的是两条水位线的位置,并不改变 flusher 往云盘写数据的实际速率。
二、实验设计:三档阈值、一个基准程序与可复位的测量
基准程序 dirty_bench 的逻辑刻意做小,避免引入多余变量:打开一个普通文件,按 32 MiB 一块连续缓冲写,总共 2560 MiB、80 块,每块用 clock_gettime(CLOCK_MONOTONIC) 单独计时,全部写完后调用一次 fsync() 并计时,最后给出总耗时与吞吐。三档实验之间执行 echo 3 > /proc/sys/vm/drop_caches 清空页缓存,保证每档起点一致;每档同时起一个 vmstat 1 采样后台回写活动。编排脚本用 trap 注册复位动作,无论正常结束还是中途中断,都会把两个 sysctl 写回实验前的原始值。
三档阈值的设置与对应内存水位如下,百分比按 8 GiB 内存的可用部分折算,给出粗略的绝对量级帮助建立直觉,真实触发点以内核当时的可用内存计算为准。
| 档位 | dirty_background_ratio | dirty_ratio | 粗略水位(按 8 GiB 估) | 设计意图 |
|---|---|---|---|---|
| 宽松 loose | 10 | 20 | 后台线约 0.8 GiB,硬线约 1.6 GiB | 尽量推迟回写,模拟默认偏宽松的桌面/大内存思路 |
| 中等 medium | 5 | 10 | 后台线约 0.4 GiB,硬线约 0.8 GiB | 折中,常见数据库主机的调优起点 |
| 收紧 tight | 0 | 5 | 后台线压到最低,硬线约 0.4 GiB | flusher 几乎常驻,回写与写入全程并行 |
档位切换只动两个 sysctl,其余条件完全不变,这是典型的单变量对照。需要强调的是,dirty_background_ratio=0 并不是关闭后台回写,而是让后台线低到只要有少量脏页就唤醒 flusher;真正关闭回写没有安全的生产做法。除了 ratio 系列,内核还提供 dirty_background_bytes/dirty_bytes 字节口径参数,两组参数互斥,写了字节口径 ratio 自动失效,大内存机器上字节口径比百分比更精确。
三、三档实测:吞吐持平,延迟分布完全不同
三档各跑一遍后的关键指标如下,全部数字来自逐块基准日志与汇总表,保留原始精度。
| 指标 | 宽松 10/20 | 中等 5/10 | 收紧 0/5 |
|---|---|---|---|
| 逐块写延迟 p50 | 21.3 ms | 192.6 ms | 211.9 ms |
| 逐块写延迟最大值 | 673.9 ms | 602.7 ms | 499.1 ms |
| 超过 100 ms 的块数(共 80 块) | 30 | 52 | 62 |
| 收尾 fsync 延迟 | 8096 ms | 4232 ms | 1942 ms |
| 端到端吞吐 | 152.5 MiB/s | 153.1 MiB/s | 153.0 MiB/s |
vmstat bo 峰值(块/秒) | 245808 | 237596 | 233696 |
vmstat wa 峰值 | 98% | 96% | 97% |
case(bg_ratio/ratio),chunk_lat_p50_ms,chunk_lat_max_ms,chunks_gt100ms,fsync_ms,throughput_MiB_s,vmstat_bo_peak,vmstat_wa_peak_pct
loose,21.339,673.887,30,8096.2,152.5,245808,98
medium,192.552,602.703,52,4232.4,153.1,237596,96
tight,211.892,499.059,62,1941.7,153.0,233696,97
这张汇总表要竖着读两列、横着读一行。竖看 p50 与慢块数:阈值越收紧,中位块越慢、慢块越多,说明回写被摊进了写过程;但最大块延迟反而从 673.9 ms 降到 499.1 ms,因为硬线更低,单次限流攒不出那么大的债务,毛刺的尖峰被削矮。横看吞吐一行:三档差异不到 0.5%,2560 MiB 除以总耗时都落在 16.7 秒上下,云盘的 QoS 上限把三档牢牢压在同一个天花板上。bo 峰值 23.4 万到 24.6 万块每秒、wa 峰值 96% 到 98%,三档同样接近,说明无论阈值怎么排,磁盘侧都曾被打满,瓶颈从未离开过那块 virtio 云盘。
宽松档的收尾账可以直接看原始日志的最后三行,80 块里前 38 块几乎全是 20 毫秒的轻快写入,最后一笔 fsync 单独背了 8 秒。
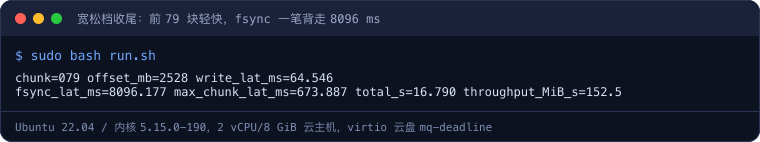
这张终端卡和对照表互相印证:宽松档的 fsync_lat_ms=8096.177 与 max_chunk_lat_ms=673.887 出现在同一份日志里,过程中最大的一块也不到 0.7 秒,真正的大头藏在收尾。换成收紧档,同位置的 fsync 只有 1941.749 ms,但 80 块里 62 块超过 100 ms。阅读逐块日志会发现前 7 块还在 20 到 28 毫秒的地板上,第 8 块(113.2 ms)起跳后整体抬升到 110 到 230 毫秒一线,其间约 10 块会回落到 20 毫秒量级——那正是 flusher 与应用并行运转、写入被持续限流、又随水位涨跌间歇性松绑的形态。
四、逐块曲线与 vmstat:延迟是怎样被搬移的
把三档的逐块耗时散点和 fsync 柱放在一张图里,延迟搬移的走向比表格更直观。
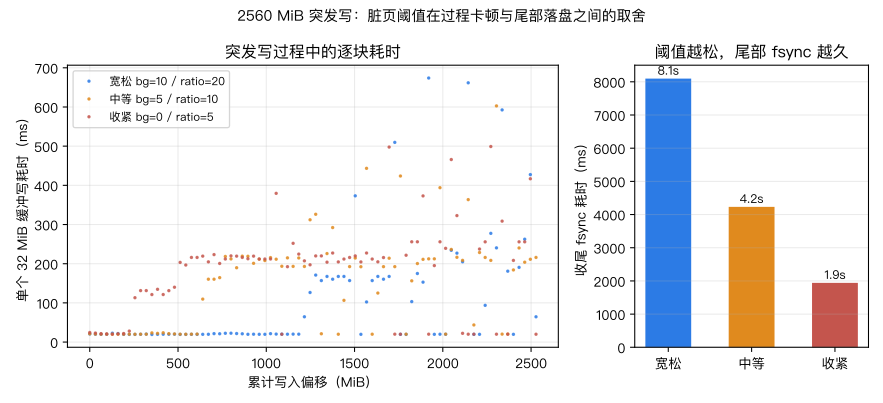
左图的散点按块号展开,建议对照三档各自的形状读。宽松档的点明显分成两层:前 38 块贴着 20 毫秒的地板,第 39 块之后散点突然跳上 100 到 670 毫秒的高层,并夹杂若干回落到底板的点——回落点对应 flusher 阶段性排空、水位短暂跌回硬线以下。收紧档几乎没有地板区,散点从第 8 块起整体抬升到 200 毫秒一线,尖峰反而最矮。中等档形态居中,前期有一小段地板,随后进入高位震荡。右图三根 fsync 柱从 8096 ms 单调降到 1942 ms,与左图散点的抬高幅度恰好反向:过程里提前还掉的账,收尾时不必再还。
vmstat 的时间序列给出了磁盘侧的旁证。以收紧档为例,采样一开始 bo 就冲到 23.4 万块每秒量级并全程维持,wa(I/O 等待占 CPU 百分比)长时间在 70% 到 97% 之间;18 个采样里进程队列列 b 有 14 个落在 2 到 4 个任务的不可中断睡眠区间,其余时刻为 0 到 1 个——多数时间都有进程被限流睡住,这就是应用侧卡顿的直接形态。
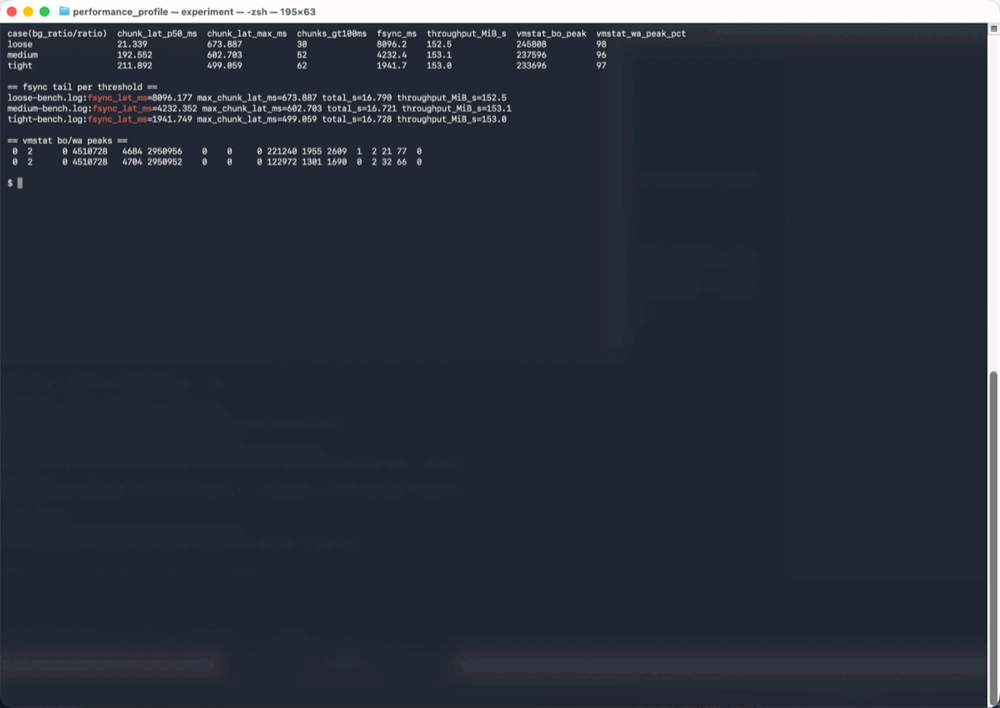
这张汇总屏把三档的 p50、最大块延迟、慢块数、fsync 与吞吐并排陈列,读图时盯住最右两列即可:吞吐柱三档几乎齐平,fsync 柱逐档缩短近一半。配合 vmstat 前后快照还能看到脏页计数的变化,例如宽松档跑完 sync 后 nr_dirty 从实验中的高水位回落到几十页,nr_writeback 只剩零星在途页,说明 8 秒 fsync 等的就是这一大批脏页从页缓存走进块设备队列的完整过程。vmstat 各列的详细口径可查vmstat 速查:r/b 队列、si/so 与 bi/bo 怎样读,块设备侧的 util、aqu-sz 与延迟线则用iostat 怎么看:await、aqu-sz 与 %util 的真实含义接续观测。
五、机理收口:为什么调参提不了吞吐,以及按业务选型
三档吞吐持平是必然结果。管道的出口速率由云盘 QoS 决定,实测天花板约 153 MiB/s;脏页阈值只能改变应用写入速率与 flusher 回写速率之间的配对方式,改变不了出口本身。宽松档让应用先按内存速度猛写、债台高筑,再被硬线限流和收尾 fsync 强制清偿;收紧档让应用从一开始就按磁盘速度匀速写,债务始终维持在低位。两种模式下,2560 MiB 数据通过同一条管道的总时间自然差不多,区别只是谁在等、等多久、等在哪个系统调用里。
选型因此不是找一组「最优参数」,而是先回答业务怕哪一种等待。
| 业务画像 | 典型诉求 | 调参方向 | 代价与前提 |
|---|---|---|---|
| 交互式服务、在线交易、消息网关 | 单次写延迟稳定,怕请求毛刺 | 收紧:bg 调到 1 到 5,ratio 5 到 10 | p50 抬高、CPU 的 wa 占比上升,需接受匀速变慢 |
| 日志归集、批量 ETL、离线导入 | 过程快、吞吐优先,结尾可容忍长 fsync | 保持宽松或默认值 | 收尾停顿与突发内存占用变大,崩溃恢复时间变长 |
| 数据库(MySQL/PostgreSQL 等) | checkpoint 可控、fsync 延迟可预期 | 中等偏紧,常配合字节口径精确控制 | 必须结合自身 WAL/checkpoint 机制联调,避免双重限流 |
| 大内存机器、多盘并发写 | 百分比口径误差大 | 改用 dirty_bytes 系列按字节设限 | 注意 ratio 与 bytes 两组参数互斥 |
还有两个外推边界必须交代。其一,本篇全部数字绑定 2 vCPU/8 GiB、内核 5.15.0-190、单块 virtio 云盘、mq-deadline 调度器与 153 MiB/s 的 QoS 天花板;换本地 NVMe,回写速率可能数倍于本实验,硬线被触碰的频率会明显下降,三档差距可能收敛。其二,单进程顺序写是最简单的形态,多线程并发写、多文件 fsync、cgroup v2 IO 控制并存时,限流会在多个线程间分摊,等待画像需要按同一套方法重新实测,不能直接引用本篇的绝对值。
实验环境
- 机器/系统:云主机 2 vCPU / 8 GiB,Ubuntu 22.04,内核 5.15.0-190,单 NUMA node;virtio 云盘,队列调度器 mq-deadline
- 工具版本:自写基准程序 dirty_bench(gcc 编译,
-O2 -Wall -Wextra);vmstat 来自 procps,1 秒间隔采样;三档 sysctl 依次为vm.dirty_background_ratio=10 vm.dirty_ratio=20、5/10、0/5 - 日期:2026-11-17
- 完整命令:
sudo bash run.sh,脚本自动编译基准程序、记录实验前原始阈值并通过 trap 复位,逐档执行 drop_caches、启动 vmstat、运行./dirty_bench dirty.bin 2560 32、收尾 sync 并保存/proc/vmstat前后快照;该脚本会修改全局脏页阈值,应在可自由重置的专用实验机上运行
代码获取:突发写基准程序、三档调参脚本与 vmstat 原始采样见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-dirty-writeback-tuning/。克隆后 make && sudo bash run.sh 复现,三档原始日志与汇总 CSV 在 results/ 目录。
这一篇在知识体系里的位置
本篇属于存储栈的页缓存与回写专题,向上承接 I/O 路径的基础分岔:直接 I/O 与页缓存:绕过缓存到底绕过了什么解释缓冲写为什么天然带这笔脏页债,存储性能观测全景:从块设备到文件系统给出从文件系统到块设备的完整观测地图。工具层面,本篇的 flusher 活动证据靠 vmstat 速查:r/b 队列、si/so 与 bi/bo 怎样读 的 bo/wa 列取得,磁盘侧的排队与利用率诊断对应iostat 怎么看:await、aqu-sz 与 %util 的真实含义。同属云主机实测范式的内存侧文章zswap 压缩交换 vs 裸 swap:内存超配下回收延迟与 PSI 停顿的四格实测,展示了同一类「单变量三档对照加计数器旁证」的方法在回收子系统上的应用,可以对照阅读。
总结
脏页回写调参改变的从来不是带宽,而是延迟分布。在 2 vCPU/8 GiB 云主机上对 2560 MiB 突发写做三档对照后,三条结论可以直接带走。第一,三档吞吐全部压在云盘 QoS 的 153 MiB/s 天花板上,差异不足 0.5%,vmstat 的 bo 峰值与 96% 到 98% 的 wa 证明瓶颈始终在磁盘侧。第二,阈值收紧把回写压力从收尾搬进过程:逐块 p50 从 21.3 ms 升到 211.9 ms、超百毫秒慢块从 30 个增到 62 个,但 fsync 从 8096 ms 降到 1942 ms,最大单块毛刺也从 673.9 ms 削到 499.1 ms。第三,选型按业务最怕的等待决定:在线交互类业务往收紧方向换稳定,批量导入类业务保留宽松换过程速度,数据库取中间值并与自身 checkpoint 机制联调,大内存机器优先用字节口径。所有绝对数字只对本次实验机型成立,换介质、换内核、换并发模型后,应照同一套三档方法在自己的机器上重新实测。