链接器速度实测:mold、lld、gold 与 ld.bfd 的全量和增量链接对照
上一篇 LTO 链接时优化实测 把视角放在编译器的链接期优化上,这一篇把镜头对准链接器本身。编译流程的最后一步是把成百上千个 .o 拼成可执行文件,这一步内部做了什么,可以先回顾从源码到运行的编译链接装载全过程。工程小的时候链接只是一闪而过的进度条,工程涨到几百个翻译单元、CI 每天重建上千次时,链接器速度就成了开发者等待时间的主要来源。本篇用同一组多翻译单元工程,把 GNU 传统的 ld.bfd、Google 出身的 gold、LLVM 的 lld 和以并行设计著称的 mold 放在同一台机器上实测,全量链接与增量链接分开计时。
本文要回答的问题
- 四款链接器在同一工程上的全量链接耗时差多少,排序是否和网上的口碑一致?
- mold 以快著称,为什么在这个基准里没有跑出领先优势?
- ld.bfd 第一轮 10.4 秒、热身后只剩 0.5 秒,这个十几倍的差距从哪来?
- 只改一个翻译单元时,四款链接器的增量链接各能省下多少时间?
- 不同工程规模和 CI 场景下,链接器应该按什么条件选择?
一、四款链接器的出身与设计取向
选型之前先看清四个选手的设计目标,它们不是同一时代、同一思路的产物。
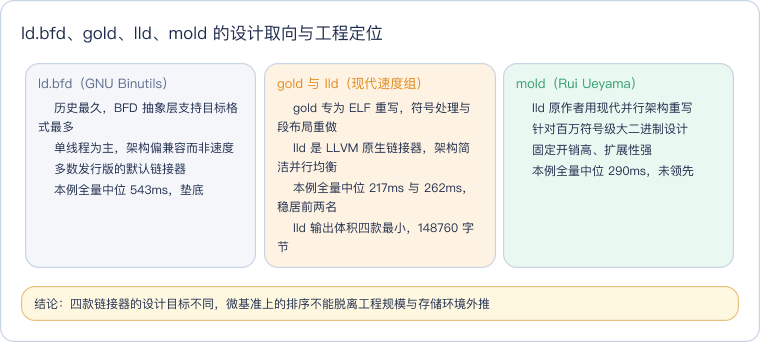
读这张卡抓住一条主线:ld.bfd 追求的是覆盖面和兼容性,gold 是第一次为速度重写 ELF 链接,lld 把链接器嵌进 LLVM 的一体化工具链,mold 则赌的是多核时代超大型工程的并行扩展性。后三者的差距在小工程里往往只剩毫秒级的固定开销差异,真正的分野要到几十万、上百万符号的二进制里才拉开。
二、链接管道:四款链接器插在哪一步
理解耗时差异,先要明确链接器在构建管道里的位置。编译器把每个翻译单元编译成 .o 之后就退出了,剩下的工作全部由链接器接管。
这张图里前两步属于编译器,后三步属于链接器,四款工具替换的是同一个位置,输入输出完全一致:吃进同一批 .o,吐出语义等价的 ELF 文件。符号解析阶段要把所有对象的符号表汇总成一张全局符号表,判定每个全局符号由哪个对象定义、哪些引用还悬而未决;段合并与重定位阶段则把同类型的段收拢到统一地址布局,再回头修改指令里的地址占位。重定位的底层机制专门拆过第二步的细节。四款链接器的速度差异,本质上就是对这张全局符号表和段布局的算法与并行策略不同。
三、基准工程与测量口径
基准工程由生成脚本 gen_tus.sh 产出:tu0000.cpp 到 tu2999.cpp 共 300 个同构翻译单元,每个 TU 定义若干全局函数和一个带外部链接的常量,再加 main.cpp 与 sumparts.cpp 两个固定文件,合计 302 个对象文件;另一档把 TU 数量扩到 1000,合计 1002 个对象。每个 TU 的结构刻意保持同构,让符号表规模随 TU 数量近似线性增长,两档之间的耗时变化就能反映链接器的扩展性,而不是被个别重型文件带偏。
测量口径有三个要点。第一,全量链接每轮先删掉已有二进制,再链接全部对象,连做 7 轮取中位数;增量链接每轮只改 tu0000.cpp 里的一个常量,重编该 TU(单独计时,约 36–38ms,不计入链接耗时)后重新链接,连做 5 轮取中位。第二,全程用中位数而不是平均值,因为容器环境下单次测量会被调度抢占和页缓存冷热打出离群尖峰,中位数对尖峰不敏感,这和并发基准测量方法的口径一致。第三,每轮链接出的二进制都跑一遍并打印 checksum 与 64 位 hash,四款链接器的输出在两档规模下全部完全一致,先证明语义等价,再比较速度。
四、全量链接实测:本环境的排序是 gold、lld、mold、bfd
两档工程、四款链接器的全量与增量链接中位耗时画在下图,左侧是全量链接,右侧是只改一个 TU 后的增量重链。
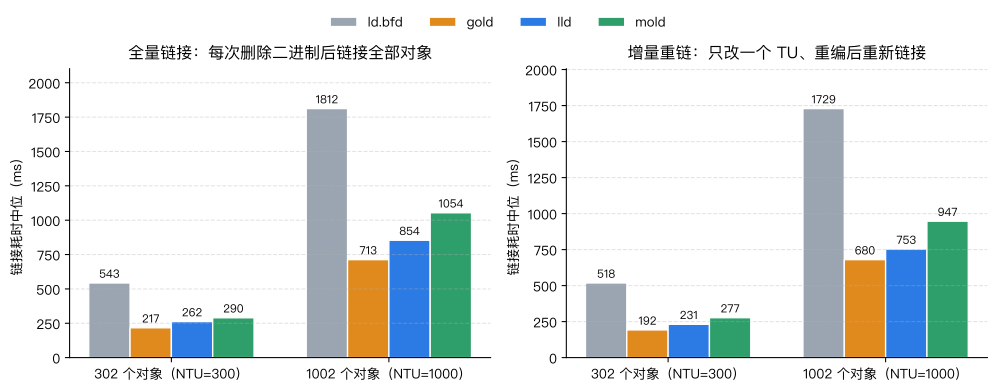
左图先看全量链接。302 个对象这一档,gold 以 217ms 居首,lld 262ms 次之,mold 290ms 第三,ld.bfd 543ms 垫底,gold 比 ld.bfd 快了约 2.5 倍。规模扩到 1002 个对象后排序不变,但差距被放大:ld.bfd 涨到 1812ms,gold 713ms、lld 854ms、mold 1054ms,gold 与 ld.bfd 的差距拉开到 2.54 倍。右图的增量重链保持同一排序,绝对值与全量非常接近——这一点第六节专门解释。
| 链接器 | 302 对象全量中位 | 1002 对象全量中位 | 302 增量中位 | 1002 增量中位 |
|---|---|---|---|---|
| ld.bfd | 543 ms | 1812 ms | 518 ms | 1729 ms |
| gold | 217 ms | 713 ms | 192 ms | 680 ms |
| lld | 262 ms | 854 ms | 231 ms | 753 ms |
| mold | 290 ms | 1054 ms | 277 ms | 947 ms |
302 对象这一档的完整原始输出如下,注意四行 full 记录里的 checksum 与 hash 完全相同,证明四款链接器产出的程序运行结果一致。
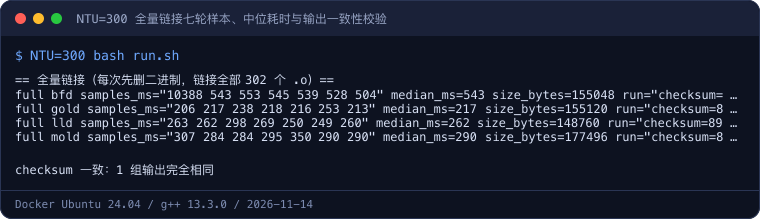
终端记录里每个链接器都保留了全部 7 个原始样本而不是只给一个加工后的中位值,读者可以直接观察离散程度。ld.bfd 那行的第一个样本 10388ms 与后面六个 500ms 量级的样本格格不入,这不是测量错误,而是冷缓存效应,下一节展开。
1002 对象档的增量样本同样完整保留在原始日志里,四款链接器的重编单 TU 耗时都在 36–38ms,说明增量实验里编译器侧的成本是恒定的,差异全部来自重链阶段。
## NTU=1000 增量链接五轮样本(节选自 run2-ntu1000.log)
incremental bfd  relink_samples_ms="1729 1762 1709 1695 1749" relink_median_ms=1729 recompile_median_ms=38
incremental gold relink_samples_ms="683 550 680 588 689"      relink_median_ms=680  recompile_median_ms=37
incremental lld  relink_samples_ms="675 762 682 801 753"      relink_median_ms=753  recompile_median_ms=36
incremental mold relink_samples_ms="954 962 852 761 947"      relink_median_ms=947  recompile_median_ms=38
五、10.4 秒离群值:冷缓存与 page cache
ld.bfd 的七轮全量样本是 10388、543、553、545、539、528、504ms,首轮比后续轮次慢了将近 20 倍。这个数字没有被中位数掩盖,但需要解释清楚它是什么。
第一轮链接发生在所有 .o 刚刚编译完成、容器页缓存尚未预热的时点。链接器要打开并读入 302 个对象文件,首轮这些文件的内容和元数据不在 Linux 页缓存(page cache)里,每次 open、read、fstat 都要穿透到挂载卷背后的真实存储;从第二轮开始,对象文件的内容已经被内核缓存进内存,同样的读取全部命中页缓存,耗时立刻回落到 500ms 量级。ld.bfd 恰好是本轮第一个执行的链接器,独自承担了冷启动成本;gold、lld、mold 开跑时缓存已经热了,它们的首轮样本因此没有出现同类尖峰。
这组数据给出两个工程提示。其一,任何构建耗时测量都不能只跑一轮就下结论,冷缓存、调度抢占、频率爬升都会污染首轮数据,预热加多轮取中位是必要纪律;反过来看,冷缓存数字也不是毫无意义——CI 上的干净构建(clean build)面对的正是冷环境,ld.bfd 在冷启动下的十倍劣化会原样传导到流水线等待时间。其二,本实验的工程目录位于 Docker Desktop 的挂载卷上,挂载边界让文件元数据操作比原生 Linux 文件系统多出一层转发开销,这个边界对需要打开大量小文件的链接阶段尤其不友好,下一节讨论 mold 时还会回到这一点。
六、增量链接:ld.bfd 为什么几乎不省时
增量场景模拟开发者最常见的动作:改一个常量、重编一个 TU、重新链接。直觉上输入只变了一个对象,链接器应该大幅省时,但数据显示四款工具的表现并不相同。
| 链接器 | 302 对象全量 | 302 对象增量 | 增量/全量 | 1002 对象全量 | 1002 对象增量 | 增量/全量 |
|---|---|---|---|---|---|---|
| ld.bfd | 543 ms | 518 ms | 95% | 1812 ms | 1729 ms | 95% |
| gold | 217 ms | 192 ms | 88% | 713 ms | 680 ms | 95% |
| lld | 262 ms | 231 ms | 88% | 854 ms | 753 ms | 88% |
| mold | 290 ms | 277 ms | 96% | 1054 ms | 947 ms | 90% |
ld.bfd 的增量重链耗时达到全量的 95%,几乎没有省到时间。原因在它的工作方式:传统链接器每次启动都要重新扫描全部对象、重建整张全局符号表、重新规划所有段的地址布局,哪怕只有一个 .o 变化,旧的链接上下文也不会被复用——链接本身是无记忆的,变化的只是输入文件之一。gold 和 lld 在数据结构上做了针对性优化,符号表的合并路径更短、字符串去重和段布局的开销更低,因此每一轮的绝对耗时本来就小,增量场景随之受益;lld 在 1002 对象档把增量压到全量的 88%,是四款里比例最低的。
需要澄清一个概念:这里的「增量链接」指构建系统层面的增量(只重编变化的 TU 再完整重链),不是某些工具链支持的、把重定位留到加载期的可重链接技术。换句话说,四款链接器每次都在做完整链接,差异来自各自的算法效率,而不是谁跳过了工作。对日常开发而言,这条结论的价值在于:ld.bfd 主导的老工程里,改一行代码也要付全额链接成本,切到 gold 或 lld 的收益在开发迭代中会被每天放大几十次。
七、体积、正确性与结论的外推边界
速度之外还有两个维度必须交代。输出体积上,302 对象档 lld 的 148760 字节最小,ld.bfd 155048、gold 155120 接近,mold 177496 字节最大;1002 对象档延续同一规律,mold 的 572304 字节比 lld 的 481264 大约 19%。mold 默认的段对齐和压缩策略更偏向速度而非紧凑度,对闪存或固件场景要把这个差额计入。正确性上,两档工程四款链接器的 checksum 与 hash 每次运行完全一致(300 档 checksum 为 89307.089187,1000 档为 984372.552092),没有出现任何链接器产出语义偏差的情况。
最重要的是说清结论的边界。mold 在这个基准里输给 gold 和 lld,并不意味着它的并行设计失败,而是微基准的两个条件正好压住了它的长处。第一,mold 的核心优势是用多线程摊薄超大规模符号表的处理成本,它的官方案例针对的是百万级符号、几十 MB 的大型二进制;本实验最大一档只有 1002 个对象、产物不足 0.5MB,并行线程的启动与同步固定开销占了大头,多核红利没有足够的工作量来摊薄。第二,实验跑在 Docker Desktop 挂载卷上,文件密集型操作要经过挂载转发,mold 高效的并行 IO 在这条路径上反而放大了元数据转发的占比;在原生 Linux 文件系统上,同档工程的绝对耗时整体会更低,mold 的相对表现也会改善。因此本篇的排序应当读作「小到中型工程、容器挂载卷环境」这一具体条件下的结论,不能外推成 mold 不如 gold 的普遍判断;大型原生 Linux 工程仍应按自己的工程实测重新排名。
八、按场景选型
把实测结论翻译成可执行的选择条件,而不是给万能推荐。
| 场景 | 建议 | 依据 |
|---|---|---|
| 几百到一两千个对象的中型 C++ 工程 | gold 或 lld | 本例两档均为前两名,lld 体积更小、与 Clang/LLVM 工具链衔接最好 |
| 老旧发行版、依赖 BFD 特殊特性或嵌入式交叉工具链 | 继续 ld.bfd | 目标格式与脚本兼容性最广,切换前先验证 linker script 行为 |
| 百万符号级超大型原生 Linux 工程 | 实测 mold 与 lld | mold 的并行架构在这个量级才有足够工作量摊薄固定开销 |
| CI 干净构建为主、存储为挂载卷或网络盘 | 优先 gold/lld | 冷缓存与文件元数据开销占比高,小工程 mold 固定成本不占优 |
| 本地高频增量开发 | lld 或 gold | 本例增量耗时最低,改一行的重链成本比 ld.bfd 低一半以上 |
| 对二进制体积极度敏感的固件场景 | lld | 两档工程产出体积均为四款最小 |
切换链接器的工程成本很低,通用做法是给编译器加 -fuse-ld=lld、-fuse-ld=gold 或 -fuse-ld=mold:CMake 3.29 及以上可以直接设 -DCMAKE_LINKER_TYPE=LLD,旧版本把该参数放进 CMAKE_EXE_LINKER_FLAGS,手写 Makefile 则在链接命令里追加同一参数(或把 LD 指向 ld.lld、ld.gold、mold);但切换后必须像本篇一样跑通全量测试并核对产物校验值,Sanitizer 运行时开销实测 里提到的各类插桩构建也要分别验证,因为插桩会改变段结构,个别链接器对特殊段的容忍度不同。
这一篇在知识体系里的位置
本篇属于 C++ 性能实测系列的构建链路分组,向上承接编译、链接、加载全过程与重定位机制的原理铺垫,与 LTO 链接时优化实测 互为表里——那篇讨论链接期优化「做什么」,本篇讨论执行链接的工具「跑多快」。测量口径上与并发基准测量方法保持同一套预热、多样本、中位统计纪律。
实验环境
- 机器/系统:macOS 主机运行 Docker Desktop,容器内 Ubuntu 24.04,内核 6.5.11-linuxkit,Intel i7-9750H,12 vCPU;工程目录位于容器挂载卷,文件密集型操作存在挂载转发开销,结论外推到原生 Linux 文件系统时需重新实测
- 工具版本:g++ 13.3.0;ld.bfd(GNU Binutils)2.42、GNU gold 1.16、LLD 18.1.3、mold 2.30.0;编译参数
-O2 -std=c++17 -Wall - 日期:2026-11-14
- 完整命令:
NTU=300 bash run.sh与NTU=1000 bash run.sh,分别完成 302、1002 个对象的全量 7 轮与增量 5 轮计时
代码获取
完整可复现工程(生成脚本 gen_tus.sh、Makefile、run.sh、README 与实测 results.txt)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/cpp-linker-mold-lld-gold-benchmark
- 复现方式:克隆后进入该目录执行
bash run.sh,默认跑出 302 对象档的四款链接器全量、增量耗时与校验值;NTU=1000 bash run.sh可复现千对象档,机器上需预装 binutils、gold、lld 与 mold。
总结
在 302 与 1002 个对象的两档 C++ 工程、Docker 挂载卷环境下,链接器速度的实测排序稳定为 gold、lld、mold、ld.bfd,gold 全量中位 217ms/713ms、比 ld.bfd 快约 2.5 倍,lld 产出体积最小;ld.bfd 首轮 10.4 秒的冷缓存尖峰来自页缓存未命中,增量重链仍达全量 95% 则因为它每次重建全量符号表与段布局;mold 未领先是并行固定开销在小工程与挂载卷上无法被摊薄,并非架构失效,百万符号级原生 Linux 工程需另行实测;选型上中型工程与 CI 优先 gold/lld,超大型工程实测 mold 后再定,兼容性敏感场景保留 ld.bfd。