cgroup v2 cpu.max 实测:CFS 带宽控制如何把配额限制放大成尾延迟毛刺
给容器设过 CPU 限制的工程师,多半写过 cpu.max 这样一行配置:"50000 100000"。它的字面意思很简单——每 100ms 周期内,这个 cgroup 里的任务最多用 50ms CPU 时间,等价于 0.5 个核。但字面意思没有告诉你的是:当双线程负载在周期中段就把 50ms 配额吃光之后,剩下的时间里任务不是「慢一点运行」,而是被整个冻结,直等下一个周期配额补齐。请求如果恰好在冻结窗口内执行,它的延迟就要凭空垫上一段与自身计算量无关的等待时间,P99、P999 尾延迟因此被拉出数量级的毛刺。
本篇是进程调度与容器资源管理交叉处的一篇实测文。CFS 如何按权重分配时间片,见姊妹篇 CFS nice 权重:静态权重表的理论比例与 SMT 超额订阅下的实测比例;容器与虚拟机的资源隔离语义差异见 容器与虚拟机的区别,容器性能问题的整体排查框架见 容器性能分析。
本文要回答的问题
- cgroup v2 cpu.max 的 quota/period 两个数字怎么换算成核数,CFS bandwidth control 在周期内具体做了什么?
- 同样的双线程定长请求负载,跑在 0.5 核、1 核、2 核三档配额下,吞吐和 P50/P95/P99/P999 延迟各差多少?
- 为什么三档的 P50 几乎不变,差距全部集中在尾延迟?被节流冻住的时间记到了谁的账上?
- cpu.stat 里的 nr_periods、nr_throttled、throttled_usec 怎么读,它们与尾延迟数字能不能对上?
- 配额给到 2 核满配是不是就永不节流?这些结论的适用边界在哪里?
一、cpu.max 的工作机制:周期配额与节流冻结
cgroup v2 的 CPU 控制器用一个文件 cpu.max 表达带宽上限,格式是 "$MAX $PERIOD"(两个数都是微秒),例如 "50000 100000" 表示 period 固定 100ms,每个周期刷新出 50ms 的运行配额。配额与核数的换算直接做除法:quota 除以 period,50000/100000 = 0.5 核,100000/100000 = 1 核,200000/100000 = 2 核。quota 可以大于 period,也可以写成 "max" 表示不限。
内核侧的实现是 CFS bandwidth control:每个 cgroup 维护一个按周期补充的配额池,任务每运行 1ns 就从池子里扣 1ns。池子里还有余额时任务正常参与 CFS 调度;一旦余额在周期中段归零,这个 cgroup 里所有还想运行的任务都会被打上节流标记、从运行队列摘下,直到该周期结束、下一个周期配额重新补齐才被唤醒挂回。注意这是 cgroup 级别的连坐:一个线程把配额吃光,同组其他线程一起被冻。
读这张图抓住一条主干和一个旁路。主干是绿色起点到橙色冻结的循环:每个 100ms 周期配额补齐,任务消耗,余额归零即被摘下,等下个周期再挂回,周而复始。旁路是紫色节点——节流本身不改变请求的计算量,但请求前后用 CLOCK_MONOTONIC 打点量出的是墙钟时间,任务被冻结的那段时间会原样计入落在窗口内的请求延迟。图中颜色对应角色:绿色是周期边界的正常事件,蓝色是负载运行,红色是配额耗尽这个根因点,橙色是冻结动作,紫色是延迟后果。
这也解释了为什么节流主要伤害尾延迟而不是均值:一个周期 100ms,假设配额 50ms 在周期前半段就被吃光,后半段约 50ms 全组冻结。绝大多数请求在配额充足的窗口里跑完,延迟只反映自身计算量;只有刚好跨过冻结边界的那一小撮请求,会额外垫上最长接近一个周期的等待。平均值被海量正常请求稀释,分位越高,撞上冻结窗口的样本越集中,P999 于是比 P50 难看两个数量级。
二、实验设计:三档配额、双线程定长负载与两套测量口径
实验在一台 2 vCPU / 8GiB 的云主机上进行,系统 Ubuntu 22.04,内核 5.15.0-190-generic,cgroup v2 层级(stat -fc %T /sys/fs/cgroup 输出 cgroup2fs)。负载程序 burner 用 C11 线程库写两个工作线程,在固定 10 秒墙钟内不断执行定长纯计算请求(每个请求固定 200000 次 xorshift 迭代),每个请求前后用 CLOCK_MONOTONIC 打点,结束后合并两个线程的样本排序,输出吞吐与 P50/P95/P99/P999/最大值。
驱动脚本 run.sh 负责 cgroup 的全生命周期:在 /sys/fs/cgroup 下建一个临时 cgroup,写入对应档位的 cpu.max,启动 burner 后把 PID 写入 cgroup.procs,运行前后各读一次 cpu.stat 求增量,退出时自动 rmdir 清理。三档配置各重复 5 轮,共 15 轮,全部数字汇总进一份 CSV。三档的语义如下:
| 配置 | cpu.max 写入值 | quota/period | 等价核数 | 与本机核数关系 |
|---|---|---|---|---|
| p50 | 50000 100000 | 0.5 | 0.5 核 | 配额小于核数,必然周期性节流 |
| p100 | 100000 100000 | 1.0 | 1 核 | 配额小于核数,双线程竞争下半程节流 |
| p200 | 200000 100000 | 2.0 | 2 核 | 配额等于整机满配,理论上不应节流 |
测量分两套独立口径。负载口径是 burner 自己打点算出的吞吐与延迟分位,单位纳秒;内核口径是 cpu.stat 四个计数器的前后差值:nr_periods 是经过的调度周期数,nr_throttled 是其中触发节流的周期数,throttled_usec 是累计被限流的总时长,usage_usec 是实际占用的 CPU 时间。10 秒墙钟、100ms 周期,正常情况下一轮约经过 100 个周期,这给了后面判断「每个周期都节流」一个直观的分母。
下面是 p50 档位第一轮 burner 打点输出的原始日志摘录(程序以 KEY=VALUE 自报指标),延迟数字与汇总 CSV 第一行逐字对应:
THROUGHPUT_REQ_PER_SEC=1042.74
LAT_P50_NS=486555
LAT_P95_NS=507086
LAT_P99_NS=76452597
LAT_P999_NS=78988229
LAT_MAX_NS=84420024
读这六行先建立量级感:同样是这个负载,P50 只有 486555ns(约 0.49ms),而 P99 已经到 76452597ns(约 76.45ms),最大值 84.42ms,头尾相差超过 170 倍。一个定长纯计算请求,自身耗时波动不可能有这么大,差距只能来自请求之外的等待——这正是节流冻结留下的指纹。
三、五轮中位数全景:一张卡和一张表
每个档位 5 轮重复,文中所有汇总数字均由 15 轮原始汇总 CSV 重算中位数得到(中位数对单轮抖动不敏感,比单轮值更适合做档位间对比)。先给结论卡,四个大数字全部取自五轮中位数:
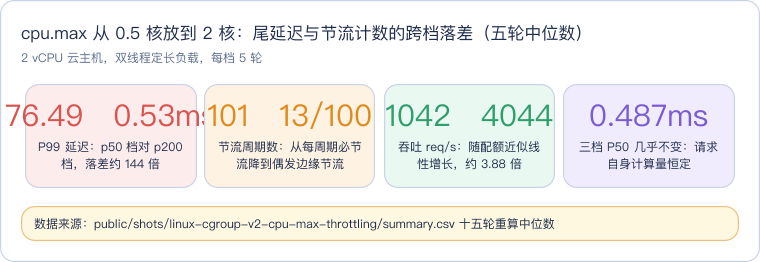
卡片把全篇的核心矛盾压缩在四行里:尾延迟两个数量级的落差、节流周期从全中到偶发、吞吐近四倍的线性增长,而 P50 纹丝不动。下面的明细表给出完整分位与计数器,延迟单位已从纳秒换算成毫秒(保留两位),计数器为五轮中位数:
| 指标(五轮中位数) | p50(0.5 核) | p100(1 核) | p200(2 核) |
|---|---|---|---|
| 吞吐 req/s | 1042.55 | 2081.11 | 4043.99 |
| P50 | 0.49ms | 0.49ms | 0.49ms |
| P95 | 0.50ms | 0.50ms | 0.50ms |
| P99 | 76.49ms | 4.01ms | 0.53ms |
| P999 | 78.95ms | 52.51ms | 2.47ms |
| 最大延迟(五轮中位) | 约 82.1ms | 约 57.8ms | 约 10.95ms |
| nr_periods / nr_throttled | 101 / 101 | 100 / 100 | 100 / 13 |
| throttled_usec 累计 | 14943999(约 14.94s) | 9800452(约 9.80s) | 19380(约 0.019s) |
| usage_usec 实际占用 | 约 5.05s | 约 10.08s | 约 19.72s |
先横着读 P50 和 P95 两行:三档都是 0.49ms 与 0.50ms,完全重合。这证明 burner 的单个请求计算量确实恒定,配额限制没有让请求本身「算得更慢」,CFS 节流改变的是任务能不能上 CPU,而不是上了 CPU 之后的执行速度。再竖着读每一列的分位尾巴:p50 档从 P95 的 0.50ms 跳到 P99 的 76.49ms,断层就发生在 P95 到 P99 这一段,意味着约 1% 到 5% 的请求撞上了冻结窗口;p200 档的分位曲线则平滑得多,P999 也只有 2.47ms。
四、数据图解读:吞吐线性、中位数钉死、尾巴分叉
三档的延迟分位与吞吐画在同一张数据图里,所有数值都来自上面那份 15 轮汇总 CSV:
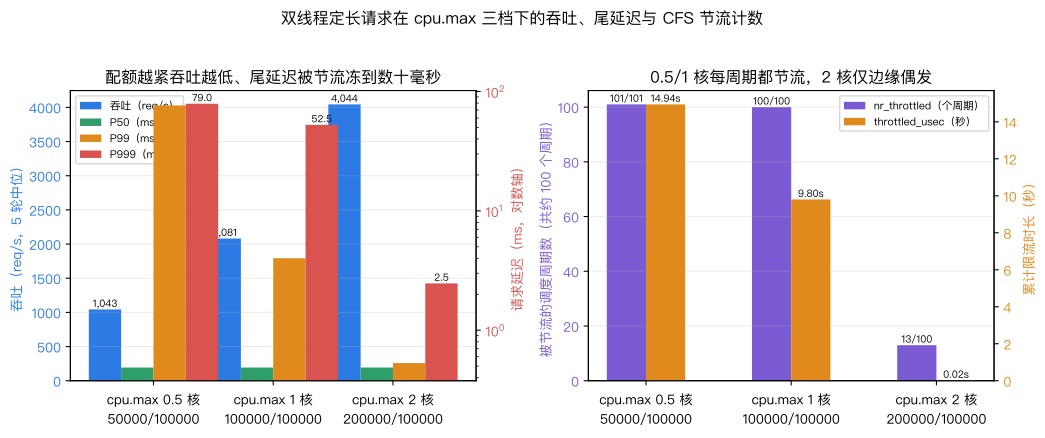
读这张图抓三条线索。第一条是吞吐柱,从 1042.55 到 2081.11 再到 4043.99,配额每翻一倍吞吐也翻近一倍,比值 1:1.996:3.879——在配额小于等于核数的区间里,cpu.max 是一个线性且可预测的容量阀门,这也是容器做容量规划时少数能直接按比例推算的指标。第二条是贴在底部的 P50/P95 折线,三档几乎重合成一条水平线,印证上一节的判断:配额管的是运行机会,不管单次执行速度。
第三条也是最关键的一条,是 P99/P999 在 p50、p100 两档的剧烈翘起。p50 档 P99 与 P999 分别是 76.49ms 和 78.95ms,两个高分位挤在一起,说明撞冻结的请求拿到的等待时间高度集中——它们大多垫满了大半个周期的冻结。p100 档呈现另一种形态:P99 回落到 4.01ms,但 P999 仍有 52.51ms,呈现明显的双峰分布。原因是 1 核配额给双线程竞争留下了半个周期的余量,多数周期里冻结来得晚、冻得短,只有约千分之一的请求恰好赶上周期末尾配额耗尽,垫上了接近完整周期的等待。p200 档整条分位线都压在低位,尾延迟退化到只剩调度与排队的常规噪声。
五、cpu.stat 对账:节流计数与尾延迟严丝合缝
延迟侧的推断需要内核计数器背书,把三档的 cpu.stat 增量与延迟数字并排对账,机制就闭环了。
p50 档五轮的 nr_throttled 全部等于 nr_periods(101/101 或 100/100 量级,五轮中位 101/101),也就是每一个调度周期都触发了节流,没有例外。累计 throttled_usec 中位 14943999,约 14.94 秒——10 秒墙钟里两个线程合计被冻了近 15 秒(冻结是按 cgroup 内任务维度累计的,双线程同时冻住会双倍记账)。同期 usage_usec 只有约 5.05 秒,恰好对应 0.5 核 × 10 秒的配额总量,说明配额被精确执行,一个周期都没有透支。P99 稳定在 76ms 上下、五轮离散极小,正是「每周期必冻、冻结位置固定」的直接产物。
p100 档同样是每个周期都节流(中位 100/100),但 throttled_usec 降到约 9.80 秒,usage_usec 升到约 10.08 秒,与 1 核 × 10 秒的配额吻合。节流依旧每周期发生,只是发生时点更靠后、冻结更短,于是 P99 大幅好转而 P999 残留长尾——计数器解释了为什么这一档的分位曲线是双峰而不是整体平移。
p200 档是最需要如实说明的一档。配额等于整机 2 核满配,但节流计数不是零:五轮 nr_throttled 分别是 11、15、11、13、18,中位数 13/100,即约 13% 的周期仍记录了节流事件,只是 throttled_usec 五轮都在 1.7 万到 2.8 万微秒之间,累计中位仅 19380(约 0.019 秒),占 10 秒墙钟的万分之二。原因在于配额核算是跨周期的瞬时账面操作:双线程在个别周期里同时唤醒、突发运行,瞬时扣费速率可能短暂超过周期补充节奏,内核照样记一次节流,但下个 tick 之前配额就已补齐,冻结时长极短,P999 因此只有 2.47ms 而没有出现 p50/p100 那样的毛刺。结论必须写准:2 核满配不等于永不节流,而是节流从「周期性、长冻结」退化为「偶发、微秒级边缘事件」;工程上把 cpu.max 设成与核数相等时,不能假设 nr_throttled 恒为零,监控告警应看 throttled_usec 的量级而不是这个计数器是否为零。
六、适用边界与工程含义
先把结论的生效条件钉死,再谈怎么用。
- 数字只对同核数(2 vCPU)、同 CFS period(100000us 默认值)、同负载形态(双线程 CPU 密集定长请求)成立。换到 4 核、8 核机器,或把 period 调成其他值,节流周期数、冻结时长与尾延迟的对应关系都要重跑,不能照搬本表的绝对数字。
- 本实验负载是纯计算型,没有 IO 等待、锁竞争与睡眠。真实服务里请求还会叠加 IO 延迟、运行队列排队与噪声邻居,cpu.max 节流只是尾延迟的来源之一,排查手段可参照 perf sched 调度分析。
- 实验通过临时 cgroup 隔离,未做 taskset 绑核,任务在两个 vCPU 间自由迁移;cgroup 只约束配额总量,不约束落在哪个核上。
- 容器场景下 cpu.max 通常由运行时写入(例如 Docker 的
--cpus参数最终就翻译成 quota/period),容器与虚拟机资源限制的语义差别见 容器与虚拟机的区别,容器性能治理的完整视角见 容器性能分析。
工程上有四条可直接落地的判断。第一,cpu.max 是线性吞吐阀门但不是线性延迟阀门:配额翻倍能线性换回吞吐,却只在跨过「配额大于实际需求」的临界点后才能消除长尾,容量规划要同时核算吞吐需求和延迟 SLO,不能只按核数比例切配额。第二,尾延迟问题先查 cpu.stat 的 nr_throttled 与 throttled_usec,P99 毛刺与这两个计数器同周期抬头,基本就能锁定带宽控制,而不是先怀疑代码回归。第三,配额要留余量:把 cpu.max 恰好设成平均用量等于配额,意味着每个周期都在节流边缘运行,本篇 p100 档 P999 52ms 的残留长尾就是代价。第四,满配档的边缘节流属于正常现象,告警阈值应建在 throttled_usec 占周期总时长的比例上,而不是 nr_throttled 是否归零。
实验环境
- 机器/系统:云主机 2 vCPU / 8GiB,Ubuntu 22.04 LTS,内核 5.15.0-190-generic,cgroup v2(cgroup2fs)
- 工具版本:gcc
-O2 -std=c11 -pthread(系统默认 gcc 11.4.0);CFS period 固定 100000us - 日期:2026-11-15
- 完整命令:
make && sudo ROUNDS=5 DURATION=10 THREADS=2 bash run.sh(三档各 5 轮共 15 轮,脚本对每轮前后快照 cpu.stat 求增量,退出自动 rmdir 临时 cgroup)
代码获取
实验源码、运行脚本与 15 轮完整结果已同步到公开仓库:
github.com/derekzhuo/geek-doc.cn — experiments/linux-cgroup-v2-cpu-max-throttling
克隆后进入该目录执行 make && sudo ROUNDS=5 DURATION=10 THREADS=2 bash run.sh 即可复现三档各 5 轮测试,终端会打印每轮节流次数,并在 results/summary.csv 落出与本篇同口径的 15 行汇总数据。
下图汇总了三档各 5 轮的关键终端输出行,包括每轮吞吐、P99 与节流计数,可与正文表格逐行对照:
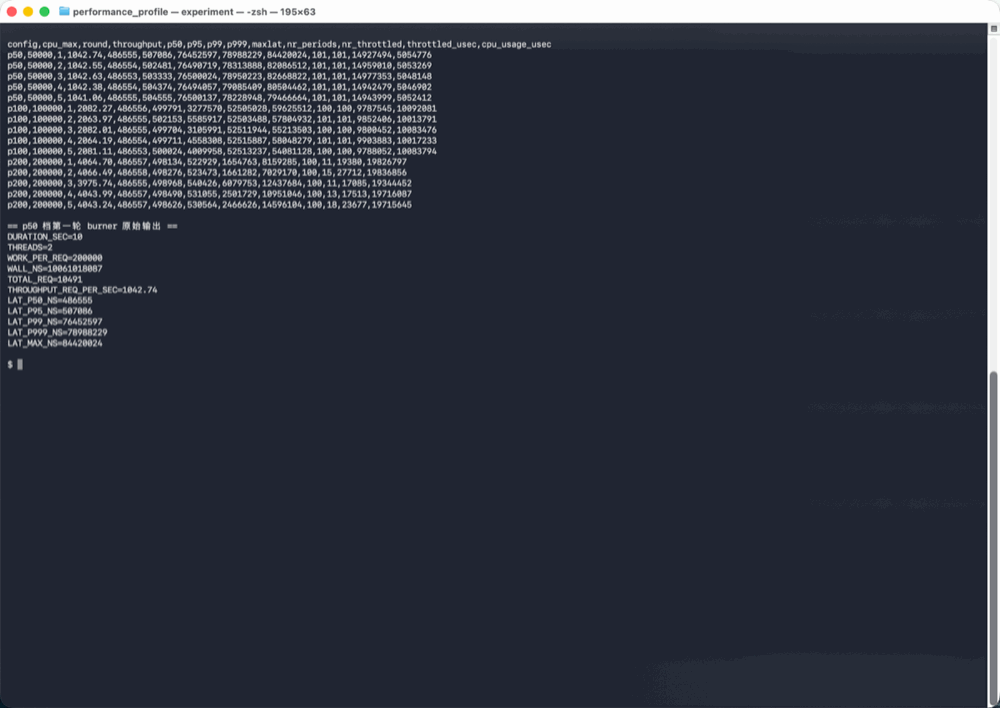
这张汇总图按 p50、p100、p200 三段排列,每段五轮。对照时先看 p50 段五行的节流计数,全部与经过周期数相等;再看 p200 段,节流计数在 11 到 18 之间小幅波动而吞吐稳定在 4000 req/s 上下,边缘节流与正常高吞吐并存,正是第五节结论的原始出处。
这一篇在知识体系里的位置
本篇落在容器资源管理与进程调度的交叉点。向调度原理方向,CFS nice 权重:静态权重表的理论比例与 SMT 超额订阅下的实测比例 是直接姊妹篇:nice 权重管同一运行队列内的时间片比例,cpu.max 管 cgroup 级别的周期总配额,一个是相对优先级、一个是硬上限,两者在内核里分属 CFS 的不同机制层。向容器方向,容器与虚拟机的区别 解释 cgroup 限制与虚拟机配额的语义差异,容器性能分析 给出容器侧性能问题的排查全貌。向工具方向,调度延迟的细粒度观测可继续读 perf sched 调度分析。
总结
在 2 vCPU 云主机上对双线程定长负载施加 0.5 核、1 核、2 核三档 cgroup v2 cpu.max 配额、各跑 5 轮的实测表明:吞吐随配额近似线性(五轮中位数 1042.55、2081.11、4043.99 req/s),三档 P50 钉死在约 0.49ms,因为 CFS 带宽控制只冻结任务的运行机会、不拖慢单次执行;配额小于核数时每个 100ms 周期都节流(p50 档 101/101、p100 档 100/100),冻结时间原样计入撞窗口请求的墙钟延迟,把 P99 抬到 76.49ms 与 4.01ms、P999 抬到 78.95ms 与 52.51ms,而 p200 满配档仍有 13/100 的边缘节流、累计冻结仅约 0.019 秒,P99/P999 回落到 0.53ms/2.47ms——满配不等于永不节流,只是节流退化为微秒级偶发事件。工程上配额要按延迟 SLO 留余量,尾延迟排查先看 cpu.stat 的 nr_throttled 与 throttled_usec,且上述绝对数字只对同核数、同 period 环境成立,换机器必须重跑。