cgroup memory.max 回收实测:触到内存上限后,回收、PSI 停顿与 OOM kill 如何分流
给容器配内存限制时,常见的写法是丢一个 memory.max=300MiB 进去,然后期待它「到顶就别再涨」。但 cgroup v2 的内存控制并不是一道闸门:任务触到上限后,内核做的第一件事通常不是杀进程,而是逼着这个 cgroup 自己回收页,回收期间任务的缺页处理被拖慢,表现为 PSI(Pressure Stall Information,压力停顿信息)涨上去;只有回收不动、又没有 swap 可换出时,OOM killer 才会进场。本文的 cgroup memory.max 回收主题,就是把这条「触限 → 回收 → 停顿或被杀」的链路在一台 2 vCPU/8GiB 云主机上完整跑一遍,用计数器而不是猜测说话。
本篇是容器资源管理簇的内存侧实测,CPU 侧的配额机制见姊妹篇 cgroup memory.max 回收的 CPU 侧对照:cgroup v2 cpu.max 节流实测;cgroup 作为容器三大支柱之一的整体定位见 容器实现原理导读,容器与虚拟机资源语义的差别见 容器与虚拟机的区别。
先给一张全篇的分流骨架,后面每一节都在为这张卡补证据:
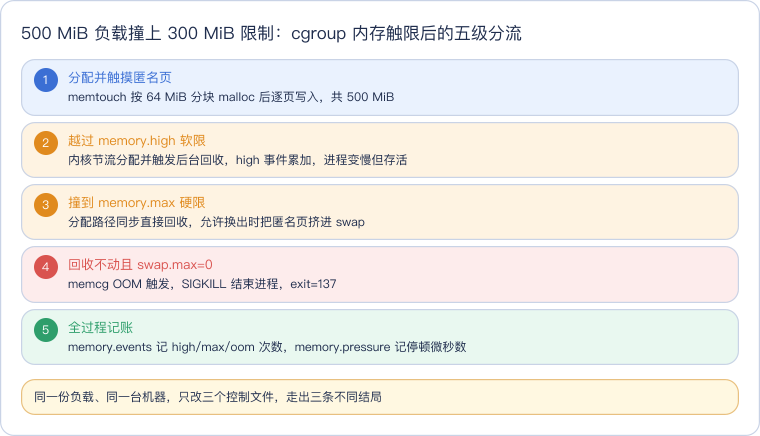
本文要回答的问题
memory.high和memory.max都是内存上限,触线后内核的动作有什么本质不同?- 一份 500 MiB 的匿名页负载跑在 300 MiB 限制里,为什么还能正常退出?RSS 被钉在哪里、时间花在哪?
- 加上 swap 和禁掉 swap(
memory.swap.max=0)两种硬限配置,结局为什么一个存活、一个 0.145 秒内被杀? - PSI 的
total数字怎么读?为什么 0.5 秒间隔的周期性采样在这个实验里完全不可用? - 自己写脚本复现 cgroup memory.max 回收实验时,有哪几个会让限制静默失效或把驱动脚本误杀的坑?
一、两条阈值与三种结局:high、max 与 OOM 的判定次序
cgroup v2 内存控制器里与上限相关的控制文件有三个:memory.high 是软限,memory.max 是硬限,memory.swap.max 单独约束换出量。它们不是并列的三选一,而是按严格次序参与每次内存申请的判定。
任务每次通过缺页拿到新匿名页时,内核先看 cgroup 当前用量是否越过 memory.high。越线不会让申请失败,而是把这次分配强制减速(节流),并唤醒后台回收线程在本 cgroup 范围内回收页,同时 memory.events 里的 high 计数加一。只要回收能腾出页,任务就一直活着,代价是墙钟时间被拉长。如果用量继续涨到 memory.max,节流手段升级:分配路径进入同步直接回收,任务自己在内核态里一页一页往外腾;此时若 swap 可用,匿名页被换出,max 计数累加但进程仍存活。若 swap 也被 memory.swap.max=0 堵死、直接回收又无页可腾,内核才宣告这个 memcg(memory cgroup 的内核简称)OOM,在 cgroup 内部选进程杀掉。
读这张图抓住两个颜色和一条主干。蓝色是负载侧的正常申请,红色是两个关键判定点:中央的阈值判定决定走哪条路,右下角的 OOM 是唯一的致命结局;两个橙色节点都是回收动作,区别只在后台节流与同步直接回收;绿色是三条路径里两条的共同终点——腾页成功就存活。图里没有画出来但同样重要的是:回收期间任务不是静止等待,而是在缺页处理里被拖慢,这段拖慢时间会被 PSI 逐微秒累计,这正是后面四相位停顿数字的来源。
三个控制文件的语义差异用一张表收口,后文的 B/C/D 三个相位就是这张表的逐行验证:
| 控制文件 | 性质 | 触线后内核动作 | 任务结局 | 对应事件计数 |
|---|---|---|---|---|
memory.high | 软限 | 分配节流 + 后台回收 | 变慢,不杀 | memory.events 的 high |
memory.max(swap 可用) | 硬限 | 同步直接回收 + 换出 | 明显变慢,不杀 | max |
memory.max + memory.swap.max=0 | 硬限且无退路 | 直接回收失败即 OOM | cgroup 内选进程 SIGKILL | max、oom、oom_kill |
二、实验设计:一份 memtouch、四个相位、三个脚本坑
负载程序 memtouch 的行为刻意做得简单可重复:按 64 MiB 分块 malloc,然后对每一页写入一个重复字节,强制物理页真正分配(只 malloc 不写入只会拿到惰性映射,不产生缺页),每完成一块打印累计触摸量和当前 RSS,共 500 MiB。驱动脚本 run-lp07.sh 串行跑四个相位,每个相位独立建一个名为 pp-lp07 的临时 cgroup,跑完即删:
| 相位 | memory.high | memory.max | memory.swap.max | 预期结局 |
|---|---|---|---|---|
| A 基线 | max | max | max | 500 MiB 一口气跑完,零事件 |
| B 软限 | 300 MiB(314572800 字节) | max | max | 节流回收,存活 |
| C 硬限加 swap | max | 300 MiB | max(用 2G swapfile) | 直接回收加换出,存活 |
| D 硬限禁 swap | max | 300 MiB | 0 | cgroup OOM,进程被杀 |
每个相位前后各采一次 memory.events、memory.pressure 与四个控制文件的快照,负载自身输出落 workload.log,退出码和墙钟耗时落 summary.txt。复现这套脚本时有三个坑,每一个都在这次实验里真实咬过人,值得单独画清楚:
三个坑分别挂在这张图的前三步上。第一个是 cgroup 目录的生命周期:脚本每个相位都先 rmdir 再 mkdir 出全新目录,如果在重建之前写限制,那行配置会随旧目录一起被删掉,新目录里 memory.max、memory.high 的 effective 值全部显示 max,限制静默失效——负载跑得飞快且事件全零,看上去「一切正常」,实际上什么都没限。脚本因此把写限制的语句放在 reset_group 之后,并让 memtouch 启动时自报一行 effective 值供核对。
第二个坑是入组 PID 的写法。往 cgroup.procs 写 PID 必须在子 shell 里写 $BASHPID,即真正要被限的那个子进程;如果图省事写主脚本的 $$,被移进受限 cgroup 的是驱动脚本自身,D 相位的 OOM killer 会连同脚本一起杀掉,后续相位全部中断。第三个坑是 PSI 采样频率,问题比较隐蔽,留到第五节专门讲。
三、B 与 C:限流里跑完 500 MiB,RSS 钉死在 300 MiB
先看软限相位 B 的负载原始输出。无限制的 A 相位里,RSS 随触摸量线性涨到 501 MiB、169ms 跑完;B 相位从触摸到 320 MiB 那一刻起形态突变:
[22ms] touched   64 MiB, RSS   65 MiB
[44ms] touched  128 MiB, RSS  129 MiB
[66ms] touched  192 MiB, RSS  193 MiB
[87ms] touched  256 MiB, RSS  257 MiB
[142ms] touched  320 MiB, RSS  300 MiB
[210ms] touched  384 MiB, RSS  300 MiB
[276ms] touched  448 MiB, RSS  300 MiB
[327ms] touched  500 MiB, RSS  300 MiB
[327ms] done, 500 MiB touched, checksum 8, RSS 300 MiB
程序逻辑上仍把 500 MiB 全部触摸了一遍(末行 checksum 正常、退出码 0),但从 320 MiB 这一档开始,RSS 被牢牢钉在 300 MiB,多摸出来的 200 MiB 空间是内核一边回收一边腾出来的。时间账同样清楚:前 256 MiB 用了 87ms,与 A 相位的 88ms 几乎重合;越过软限后每个 64 MiB 档位要花 55 到 68ms,是限外速度的三倍多,整相位耗时 0.372s,接近基线 0.194s 的两倍。这正是第一节机制图里「节流 + 后台回收」的可观测形态:进程没死,但每次缺页都在为回收买单。
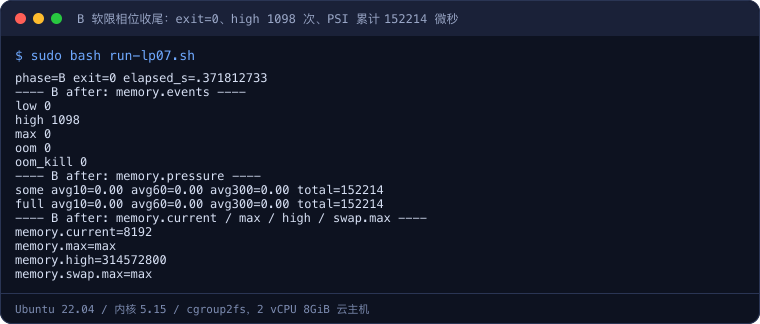
相位后的计数器给了定量背书。B 的 memory.events 里 high 累计 1098 次,max、oom、oom_kill 全为 0;memory.pressure 的 some 与 full 两行 total 都是 152214µs,即整个相位任务因内存回收累计停顿约 152.2ms——占 0.372s 墙钟时间的四成以上。注意 some 与 full 相等是合理的:本相位 cgroup 里基本只有 memtouch 一个任务,它一停顿,组内就没有可运行任务,some(至少一个任务停顿)与 full(全部任务停顿)自然重合。
C 相位把软限换成 memory.max=300MiB 并保留 swap。负载输出的形态与 B 几乎同构:RSS 同样钉在 300 MiB、500 MiB 全部摸完、退出码 0,耗时 0.377s。差别在计数器:max 累计 1097 次而 high 为 0,PSI some total 为 91484µs(约 91.5ms),比 B 还低一截。原因是这台机器上挂了一块 2G swapfile,硬限下的直接回收有明确的换出目的地,匿名页被写入 swap 后立刻腾出物理页,回收路径反而比软限里「节流等待后台回收」的周转更快;存活的前提是 swap 还有容量,且换出的页短期内不再被访问——本负载触摸完即不再回头读,恰好满足这个条件。
下面这张终端卡摘自主驱动日志的 B 相位收尾,有效配置、退出码、high 计数与 PSI 累计值在同一段输出里,可以和上面的负载日志逐行对照:
四、D 相位:禁掉 swap 后,0.145 秒结束的 cgroup OOM
D 相位只改一个地方:memory.swap.max=0,把硬限下最后一条换出退路堵死。负载日志在 256 MiB 处戛然而止,连 320 MiB 那一行都没有打出来:
effective: memory.max=314572800 memory.high=max memory.swap.max=0
[24ms] touched   64 MiB, RSS   65 MiB
[46ms] touched  128 MiB, RSS  129 MiB
[69ms] touched  192 MiB, RSS  193 MiB
[90ms] touched  256 MiB, RSS  257 MiB
摘要行记录的退出码是 137,即 128+9(SIGKILL),整相位只活了 0.145s,比无限制的基线还短——它不是跑完的,是被处决的。相位后 memory.events 显示 max 仅 37 次、oom=1、oom_kill=1,PSI some total 只有 586µs。这组数字里最反直觉的是 PSI 极低:回收停顿几乎没积累就 OOM 了。机理上说得通:禁掉 swap 后,cgroup 里全是刚触摸过的匿名页,没有可丢弃的文件页,也没有换出目的地,直接回收第一次尝试就发现无页可腾,内核没有理由让任务长时间卡顿等待,直接进入 OOM 流程。也就是说,PSI 高意味着「在回收中挣扎」,OOM 来得快时反而看不到高 PSI,判断内存限制是否致命不能只看压力指标。
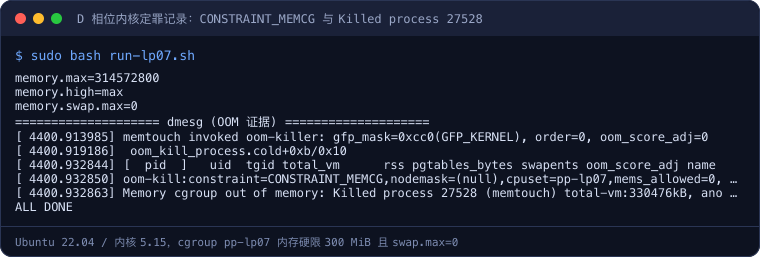
内核环形缓冲区里留了完整的定罪记录,下面是原始 dmesg 摘录:
[ 4400.913985] memtouch invoked oom-killer: gfp_mask=0xcc0(GFP_KERNEL), order=0, oom_score_adj=0
[ 4400.919186]  oom_kill_process.cold+0xb/0x10
[ 4400.932844] [  pid  ]   uid  tgid total_vm      rss pgtables_bytes swapents oom_score_adj name
[ 4400.932850] oom-kill:constraint=CONSTRAINT_MEMCG,nodemask=(null),cpuset=pp-lp07,mems_allowed=0,oom_memcg=/pp-lp07,task_memcg=/pp-lp07,task=memtouch,pid=27528,uid=0
[ 4400.932863] Memory cgroup out of memory: Killed process 27528 (memtouch) total-vm:330476kB, anon-rss:306528kB, file-rss:1632kB, shmem-rss:0kB, UID:0 pgtables:644kB oom_score_adj:0
两个字段值得逐字读。其一是 constraint=CONSTRAINT_MEMCG,它明确这是 cgroup 级 OOM 而非整机 OOM——机器本身还有大量空闲内存,杀进程的依据是 pp-lp07 这个 cgroup 的账爆了,这与系统级 OOM 的排查路径完全不同。其二是 anon-rss:306528kB,约 299 MiB,加上少量文件页和页表开销恰好顶在 300 MiB 硬限附近,被杀时的账面与限制值严丝合缝。同类「进程莫名消失、应用日志一片空白」的排查手法,见 cgroup memory.max 回收失控后的 OOM killer 排查。
同一段证据也以终端卡形式留存,取自主驱动日志末尾回收的 dmesg 段:
五、PSI 为什么不能画时间曲线:短相位下的采样口径坑
实验最初设计了一个周期性采样器:每 0.5s 读一次 memory.pressure 的 total 写进 *.psi.log,打算画一条 PSI 随时间爬升的曲线。实际跑完四个相位,每份 psi.log 都只有一行零值:
1794767860.155380180 some_total_us=0 full_total_us=0原因出在时间尺度的错配上。四个相位的墙钟耗时只有 0.145s 到 0.377s,全部短于 0.5s 的采样间隔:采样器第一次醒来之前,相位已经结束、cgroup 已经在清理流程中,它读到的要么是尚未开始的零值,要么是空目录前的最后一眼。拿这种日志画 PSI 时间曲线,只会得到一条误导性的零直线,仿佛全程没有任何内存压力——而 B 相位 after 快照里的 152214µs 明明记着 152ms 的真实停顿。
可靠的口径是 memory.pressure 里的累计 total:它是单调递增计数器,相位开始前在 before 快照里读一次、结束后在 after 快照里再读一次,两者之差就是这个相位的全部停顿,与相位多短无关。本文所有 PSI 数字都来自各相位 after.txt 的累计值(before 均为 0,所以 after 值即相位增量),没有引用任何 psi.log 的零值,也不提供 PSI 时间曲线。这个坑具有通用性:观测亚秒级短负载的资源压力时,周期采样的奈奎斯特极限会先于内核指标失效,优先选累计计数器做前后快照差分,需要时间序列时再把采样间隔压到相位时长的十分之一以下。
六、四相位全景对照与工程含义
把四个相位的核心数字并排,分流骨架就从机制图落成了数据表:
| 指标 | A 无限制 | B high=300MiB | C max=300MiB 加 swap | D max=300MiB 禁 swap |
|---|---|---|---|---|
| 退出码 | 0 | 0 | 0 | 137(SIGKILL) |
| 墙钟耗时 | 0.194s | 0.372s | 0.377s | 0.145s |
| high 事件 | 0 | 1098 | 0 | 0 |
| max 事件 | 0 | 0 | 1097 | 37 |
| oom / oom_kill | 0 / 0 | 0 / 0 | 0 / 0 | 1 / 1 |
| PSI some 累计停顿 | 0 | 152214µs | 91484µs | 586µs |
| 结束时 RSS | 501 MiB(进程存活) | 300 MiB | 300 MiB | 约 299 MiB 时被杀 |
这些数字画成了下面的双面板数据图,左面板是四相位 PSI some 累计停顿柱,右面板是 high、max、oom_kill 三类事件计数:
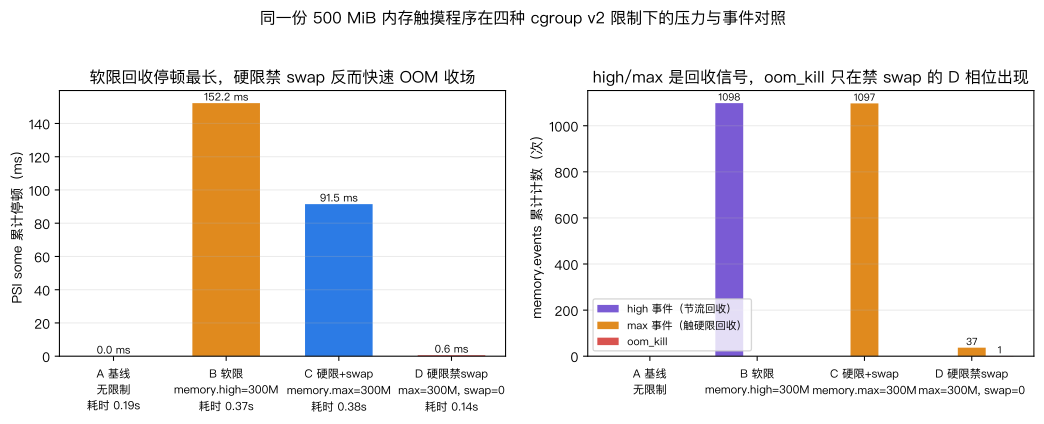
读这张图按「先右后左、柱与事件配对」的顺序。右面板先建立定性骨架:high 事件只出现在 B、max 事件只出现在 C 和 D,而 oom_kill 全图只有 D 相位一根红柱,三类事件各属其位,证明两个阈值确实走了不同的内核路径,没有混用计数器。回到左面板读停顿:A 为零是基线本分;B 的 152.2ms 是全图最高柱,对应软限下上千次节流回收的累计代价;C 回落到 91.5ms,对应 swap 换出路径更快的周转;D 只有 0.586ms 的贴地小柱却配着唯一的 oom_kill——这张图最想传达的就是这个反差:停顿最久的相位活着,几乎不停顿的相位死了,PSI 衡量的是挣扎过程,不是致命性。
下图是四相位在终端里的完整收尾输出,B 段的 high 1098、C 段的 max 1097、D 段的 exit=137 与 oom_kill 1 依次排列,最底部是 D 相位的 dmesg OOM 记录:
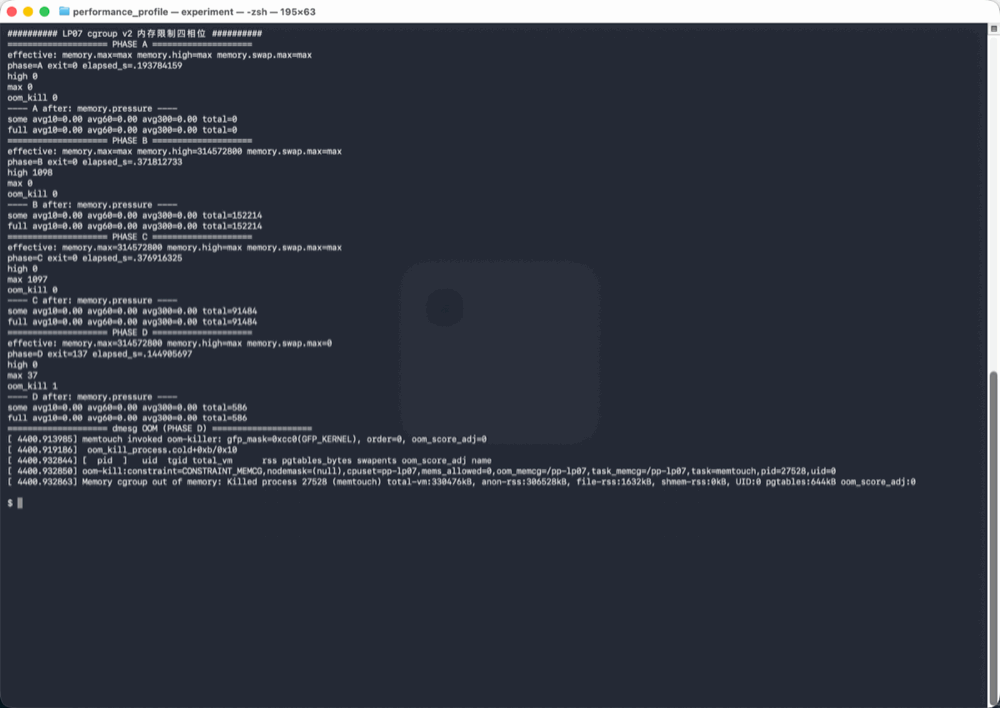
对照这张终端输出时,先逐段确认每相位首行的 effective 配置与预期一致(这是排查限制静默失效的第一着眼点),再看 D 段底部四行 dmesg 中的 constraint=CONSTRAINT_MEMCG 与 oom_memcg=/pp-lp07,两处字段共同把杀进程行为锁定在 cgroup 账目而非整机内存。
工程上可以带走五条判断。第一,memory.high 是用来「软性压速」的,适合给共享租户留缓冲;memory.max 是硬边界,配合 swap 时它的实际效果是「物理内存上限」而非「总内存上限」,配 memory.swap.max=0 才是严格的总内存封顶。第二,容量规划要同时算物理内存和 swap 账:C 相位能活是因为 2G swapfile 接住了约 200 MiB 匿名页,机器 swap 耗尽时 C 的行为会向 D 退化。第三,监控不要只盯 PSI:高 PSI 是回收挣扎的信号,而快速 OOM 的 PSI 可能很低,memory.events 的 oom_kill 计数才是致命性指标,告警应同时挂这两类信号。第四,排查 cgroup OOM 先在 dmesg 里找 CONSTRAINT_MEMCG,确认是组内账目爆掉,再回头查限制值与突发分配,不要按整机内存不足的思路扩容。第五,复现实验时限制写入必须放在 cgroup 目录重建之后、入组写 $BASHPID 而非 $$、短相位用累计计数器差分而非周期采样——这三条任何一条做错,都会得到一份看似合理实则作废的数据。容器场景下这些文件通常由运行时代写(Docker 的 --memory 与 --memory-swap 最终就翻译成这几个控制文件),容器侧性能治理的全貌见 容器性能分析,在容器内做深度观测的权限与作用域问题见 容器/cgroup 中的 perf。
结论的适用边界也要钉死:全部数字来自 2 vCPU/8GiB、内核 5.15、cgroup v2 统一挂载的同一台云主机,负载是单次分配、触摸后不回访的纯匿名页程序;换成多任务竞争、频繁回访热页、带文件页缓存或 NUMA 多节点的场景,回收效率、swap 代价与 PSI 形态都会变化,绝对数字不可照搬,可复用的是阈值判定次序与计数器口径。
实验环境
- 机器/系统:云主机 2 vCPU / 8GiB,Ubuntu 22.04 LTS,内核 5.15,cgroup v2 统一挂载(cgroup2fs)
- 工具版本:gcc 系统默认版本,
gcc -O2编译 memtouch;实验前由脚本自建 2G swapfile(/swapfile-lp,swapon 优先级 -2) - 日期:2026-11-16
- 完整命令:
sudo bash run-lp07.sh(脚本自动完成 swap 准备、四相位 cgroup 重建与限制写入、PSI 前后快照、dmesg 清空与 OOM 记录回收)
代码获取
实验源码、驱动脚本与四相位完整原始输出已同步到公开仓库:
github.com/derekzhuo/geek-doc.cn — experiments/linux-cgroup-v2-memory-max-reclaim-psi
克隆后进入该目录,在 cgroup v2 环境下以 root 执行 sudo bash run-lp07.sh 即可复现全部四个相位,结果落在 results/ 目录,与本篇同口径。注意 D 相位的 OOM kill(exit=137、dmesg 出现 CONSTRAINT_MEMCG)是预期行为而非脚本失败,脚本通过临时 cgroup 隔离,不会影响宿主上的其他进程。
这一篇在知识体系里的位置
本篇落在容器资源管理的内存侧。向上承接容器三大支柱的整体框架,容器实现原理导读 说明 cgroup 在内核里如何与 namespace、rootfs 正交协作,namespaces 与 cgroups:容器的内核底座 给出资源限额的内核概念原点。横向对比上,容器与虚拟机的区别 解释 cgroup 软/硬限与虚拟机内存配额的语义差异,姊妹篇 cgroup v2 cpu.max 实测 用同一套「限制文件 + 事件计数 + 实测对照」方法讲 CPU 带宽控制,两篇合起来覆盖 cgroup 两大主力控制器。向下延伸到排错与观测:进程被 cgroup OOM 杀死后的日志排查见 OOM killer 排查,容器内性能剖析的权限边界见 容器/cgroup 中的 perf,容器性能问题的完整排查框架见 容器性能分析。
总结
在 2 vCPU/8GiB、内核 5.15 的 cgroup v2 环境里,让同一份 500 MiB 内存触摸程序依次跑无限制、memory.high=300MiB、memory.max=300MiB 加 swap、memory.max=300MiB 且 swap.max=0 四个相位,可以看清 cgroup memory.max 回收的完整分流:软限相位靠 1098 次节流回收把 RSS 钉在 300 MiB、进程存活但耗时翻倍(0.372s)并累计 152.2ms PSI 停顿;硬限加 swap 相位以 1097 次 max 事件换出匿名页,停顿反而降到 91.5ms;硬限禁 swap 相位无页可腾、0.145s 内即触发 CONSTRAINT_MEMCG 级 OOM,exit=137、oom_kill=1 而 PSI 仅 586µs——高 PSI 标志回收挣扎,快速 OOM 反而没有高停顿,两类信号必须同时监控。复现这套实验有三个硬要点:限制只能在 cgroup 目录重建之后写入否则静默失效,入组要写子 shell 的 $BASHPID 而非主脚本 $$,亚秒级短相位的 PSI 只能用累计 total 前后差分、0.5s 周期采样只会采到零值。