bpftrace 定位内存增长:用 uprobe 聚合 malloc 调用点的完整流程
线上服务有一种常见症状:RSS 曲线只涨不跌,日志没有 OOM、接口没有报错,重启能缓几天。传统工具在这种场景下并不好用——perf record 采到的调用栈又碎又多,Valgrind 要拖慢进程几十倍,没法对常驻服务上手。bpftrace 的 uprobe 提供了第三条路:在不重编目标程序、不中断服务的前提下,给指定函数动态挂探针,把 malloc 的次数和字节数按调用点实时聚合。bpftrace 的基础语法与内核态用法见 bpftrace 入门:eBPF 动态追踪的脚本化实践,火焰图怎么读见火焰图解读热点:on-CPU 与 off-CPU 的判读方法,用户态分配器本身的锁争用见 ptmalloc、jemalloc、tcmalloc 多线程争用实测。本篇在 2 vCPU/8 GiB 云主机上,用一个含三个分配点的示例程序,完整走一遍从探针设计到数据对账的流程。
本文要回答的问题
- uprobe 挂在 malloc 上和挂在业务函数上,两种思路各适合什么场景?
- 为什么
ustack在 Ubuntu 22.04 的 glibc 上只能打出一个栈帧,怎么绕开? - 只统计 malloc 调用次数为什么会误导排查,字节聚合讲出的故事有什么不同?
-p附加已运行进程与-c拉起新进程,两种挂载方式在观测完整性上差在哪?- 聚合出来的数字怎样和程序源码的设计值逐一对账,确认探针没有漏报?
一、排查路径:从症状到调用点的五步
先把整个定位流程固定成一张可复用的步骤卡,后面每一节对应卡片上的一环。
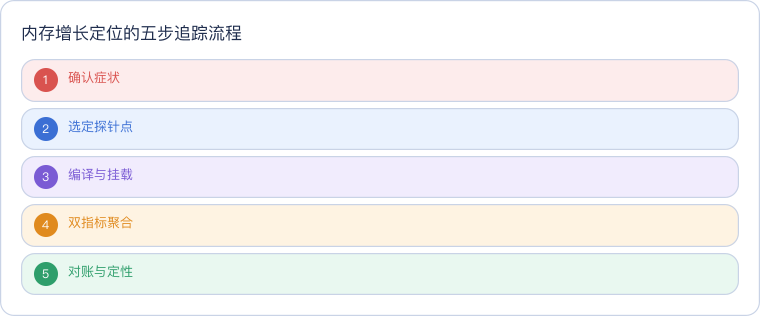
读这张卡抓住一个原则:探针点的选择决定了后面所有数据的语义。挂在 libc 的 malloc 上,拿到的是全进程视角,所有线程、所有库的分配都进同一个池子;挂在业务函数上,拿到的是调用点视角,每个数字直接对应一行源码。本次示例程序符号完全可控,主线走业务函数探针,malloc 探针只留一个总量计数器做对账。
二、uprobe 的工作机制:内核帮忙设的断点
uprobe 不是内核探针,而是用户态动态探针。它的工作位置在进程地址空间与内核追踪机制的交界处,下图画出一次 malloc 被统计的完整路径。
蓝色是业务代码原本的执行流,红色断点由内核在挂载时写入目标函数入口(原始指令被保存),执行到该地址时陷入内核、橙色事件回调跑完 bpftrace 的聚合逻辑,再回到绿色 BPF map 累计,最后恢复原指令继续执行。整个过程不需要停机、不需要重编被追踪的二进制,开销只发生在被命中的调用上。
示例程序 malloc_hotspots.c 故意造了三个形态不同的分配点,对应线上三类典型角色。
static __attribute__((noinline)) void hot_path_a(void)   /* 64 B,每轮 1500 次 */
static __attribute__((noinline)) void loader_b(void)     /* 4 KiB,每轮 400 次 */
static __attribute__((noinline)) void session_c(void)    /* 256 B,每轮 750 次 */
主循环跑 24 轮、轮间睡眠 600 毫秒,总运行约 15 秒;所有分配都不释放,模拟「只涨不跌」。注意 noinline 属性——这件事的重要性第四节展开。
三、探针脚本:次数与字节双聚合
bpftrace 脚本在三个业务函数入口各挂一个 uprobe,分别做 count() 与定长 sum(),再在 libc malloc 上挂一个总量探针。

业务函数的申请大小在源码里写死,所以字节聚合直接用常量 sum(64)、sum(4096)、sum(256);如果目标函数的 size 是参数,则应挂 malloc 并取 arg0。脚本每 5 秒打印一次快照,退出时输出最终 map,既能看累计值,也能看增长斜率。
运行方式选 -c 而不是 -p,是有意为之的观测完整性选择。脚本让 bpftrace 自己拉起目标进程,从第一条指令开始挂载,动态链接器的重定位、printf 的缓冲初始化这些启动期分配都落在 malloc 总量探针的统计范围内;如果改成 -p <pid> 附加到已运行进程,挂载之前发生的分配全部漏采,启动期占全进程 malloc 总量的比例就无从得知。-p 的语义是「从现在开始看」,适合观察长期运行进程的稳态增长,而本篇的对账需要「从第一笔分配开始看」,因此运行脚本统一走 -c,由 bpftrace 代管目标进程的完整生命周期。
四、两个真实的坑:ustack 失效与 PIE 符号
最初的脚本设计是挂在 libc 的 malloc 上,再用 ustack(12) 按调用栈聚合,这也是 bpftrace 手册里的标准写法。实测连续踩中两个问题,值得单独讲清楚。
第一个是栈帧断裂。Ubuntu 22.04 的 glibc 编译时没有保留帧指针,bpftrace 的 ustack 靠 RBP 链回溯用户栈,走到 __libc_malloc 之后就断了,输出里只剩一个库函数帧加一串裸地址,调用点完全不可读。DWARF 级别的用户态栈展开不在 bpftrace 0.14 的能力范围内,靠编译选项救不了系统库。
第二个是符号解析。目标程序默认 PIE 编译,运行时加载在随机地址,裸地址无法稳定映射回函数名;即使加了 -fno-omit-frame-pointer,栈链断在 glibc 里,PIE 又让最后一公里的符号化失败。实测中先加 -fno-pie -no-pie 解决地址问题,再把三个分配函数标 __attribute__((noinline)) 保证它们不被编译器内联消失,最后干脆把探针从 malloc 下沉到业务函数入口——探针位置本身就是调用点语义,彻底不依赖栈回溯。这也是第三节脚本最终形态的由来。
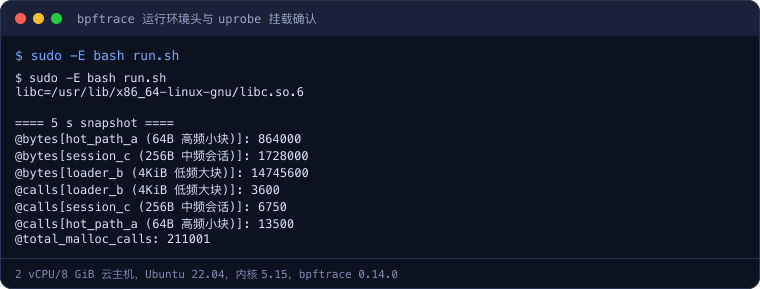
终端卡记录了一次干净运行的环境头,注意 libc 路径经过 readlink -f 规范化,bpftrace 不接受符号链接形式的 uprobe 路径。
五、聚合结果:调用次数第一的不是内存元凶
程序退出时的最终聚合如下,全部为 bpftrace 原始输出。
@bytes[hot_path_a (64B 高频小块)]: 2304000
@bytes[session_c (256B 中频会话)]: 4608000
@bytes[loader_b (4KiB 低频大块)]: 39321600
@calls[loader_b (4KiB 低频大块)]: 9600
@calls[session_c (256B 中频会话)]: 18000
@calls[hot_path_a (64B 高频小块)]: 36000
@total_malloc_calls: 269779
先做对账,确认探针可信。源码设计值是 24 轮 × 每轮 1500/400/750 次,预期调用数 36000、9600、18000,与 @calls 三个值完全相等;字节数用次数乘块大小反算,36000×64=2304000、9600×4096=39321600、18000×256=4608000,与 @bytes 逐项吻合。业务侧三个调用点合计 63600 次,而 malloc 总量探针报 269779 次,差额来自动态链接器、printf 与运行时启动期的内部分配——这正是「库函数探针给全进程视角、业务探针给归因视角」的量化演示。
再看两个排名的错位。
| 调用点 | 调用次数 | 次数占比 | 申请字节 | 字节占比 |
|---|---|---|---|---|
| hot_path_a(64 B) | 36000 | 56.6% | 2.20 MiB | 5.0% |
| session_c(256 B) | 18000 | 28.3% | 4.39 MiB | 10.0% |
| loader_b(4 KiB) | 9600 | 15.1% | 37.50 MiB | 85.1% |
如果只按调用次数排名,hot_path_a 以 56.6% 高居榜首,很容易被误判为元凶;但按字节聚合,loader_b 用 15.1% 的调用次数拿走了 85.1% 的内存。线上排查里这对应两种完全不同的修复:前者优化调用频率或上对象池,后者检查加载器的缓存上限与释放时机。双指标聚合的价值就在这里——次数回答「谁最忙」,字节回答「谁吃内存」。
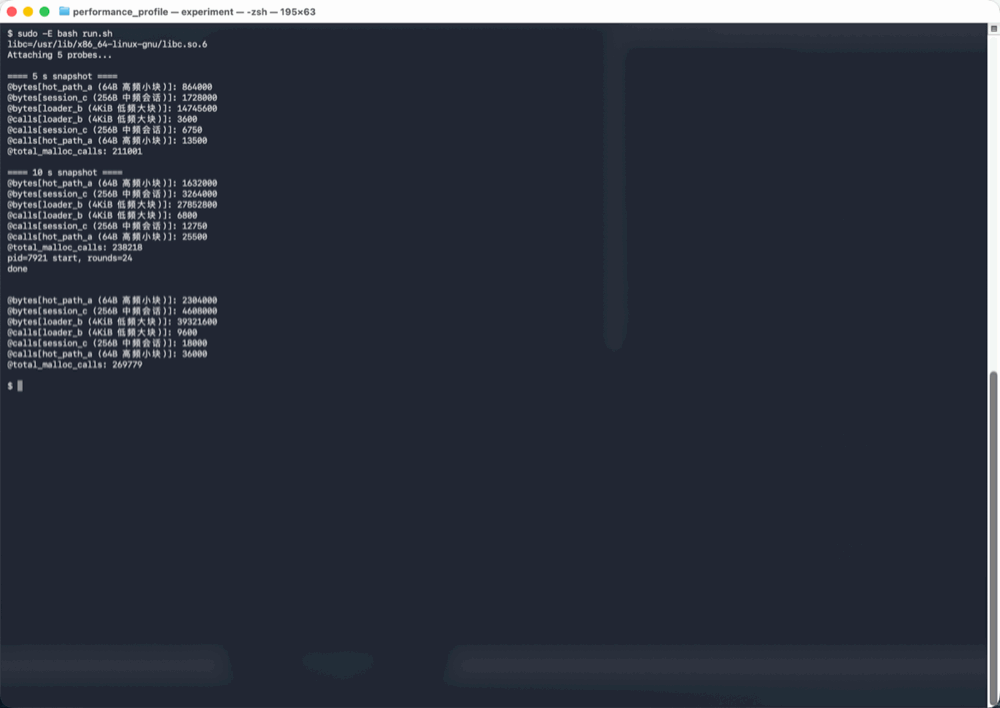
5 秒与 10 秒快照还提供了增长斜率:5 秒时三个计数为 13500/3600/6750(正好 9 轮),10 秒时为 25500/6800/12750(17 轮),与 600ms × 轮数 的时间轴对齐,说明探针没有丢事件、聚合实时可信。
终端全景如下,三组快照的计数随时间单调增长,最终 map 中 loader_b 的字节数比另外两个调用点高出一个数量级。
六、探针开销:用一次对照运行量化
uprobe 每次命中都要把进程从用户态陷入内核再返回,「开销可接受」不能只靠定性判断。同一台机器、同一个二进制,裸跑三次的墙钟时长都是 14.42 秒,挂载 4 个 uprobe(三个业务函数加 malloc 总量探针;脚本里另有一个 interval 定时探针,bpftrace 实际共附着 5 个探针)后三次都是 15.23 秒,差值稳定在 0.81 秒、相对开销 5.6%。这 0.81 秒分摊到全程 33 万次陷头(业务侧 63600 次加 malloc 总量 269779 次)上,单次探针的综合代价在微秒量级。
这个数字的适用边界要讲清楚。示例程序每轮之间有 600 毫秒睡眠,24 轮共 24 次睡眠占了绝大部分墙钟时间(24×0.6 秒已达 14.4 秒),5.6% 是「低频归因型剖析」的开销水平。把同样的探针挂到没有睡眠、纯计算的紧密循环上,百万级 QPS 时陷入开销会线性累加,尾延迟会被明显抬高。线上操作的稳妥做法是先在灰度环境按真实流量比例挂载,用 bpftrace 自带的 map 计数观察命中频率,确认每秒陷头数在几万以内再上生产;归因明确后及时摘除探针,uprobe 不是常驻组件。
七、落地边界:什么时候该换工具
这套方法有明确的适用范围。uprobe 每次命中都有一次陷入内核的开销,实测在万级 QPS 的热路径上可以接受,但若目标函数每秒命中百万次,应改用编译期插桩或采样型 profiler;bpftrace 聚合在 BPF map 容量上有上限,调用点过万时需要配合 map 扩容或换用带聚合代理的方案。另外 uprobe 挂的是用户态函数,内核内部分配(slab、页分配器)看不到,那一类问题要回到 /proc/slabinfo 与 perf 的内核探针。
挂在 libc malloc 上的全进程探针还有两个工程细节。其一,malloc 命中频率通常是业务函数的数倍——本次实测全进程 269779 次对业务侧 63600 次,比例约 4.2 倍,差额来自动态链接器、printf 缓冲与运行时初始化,直接在 malloc 上做带字符串 key 的聚合会让 BPF map 压力成倍放大;其二,生产二进制往往经过 strip,没有函数符号时只能挂文件偏移,版本升级后偏移会漂移,脚本必须纳入版本管理并在发布流程里校验。生产环境挂载前先在灰度机验证符号表与 map 容量,是这类动态探针能不能长期维护的分水岭。
八、四类内存剖析工具怎么选
同样面对「内存只涨不跌」,不同工具的工作位置决定了它们能回答的问题,把本篇方法放进对照表里更容易看清取舍。
| 工具 | 工作原理 | 对目标进程的要求 | 典型开销 | 最适合回答的问题 |
|---|---|---|---|---|
| bpftrace uprobe | 动态断点 + 内核态聚合 | 留符号即可,不必重编 | 每次命中一次陷头,万级 QPS 内可接受 | 哪个调用点在分配、次数与字节各是多少 |
| perf record + 火焰图 | 采样,栈上按概率取点 | 带符号表更易读 | 采样率相关,通常个位数百分比 | 哪些函数占了最多 CPU 时间 |
| Valgrind memcheck | 指令级模拟,全程跟踪分配 | 无特殊要求 | 数十倍减速、数倍内存 | 确定性泄漏定位、越界读写,只能离线跑 |
| 分配器自带统计(jemalloc prof) | 库内采样,进程内聚合 | 替换或预加载分配器 | 低,但绑定特定分配器 | 堆分布与增长趋势,无法覆盖 glibc 默认环境 |
四条路径并不互斥。线上应急先用 bpftrace 做无侵入归因,拿到可疑调用点后在测试环境用 Valgrind 做确定性确认;性能问题本身仍归 perf 与火焰图;长期趋势监控则交给分配器原生统计。uprobe 方案的独特生态位是「不重启、不重编、不换分配器」,代价是要求二进制保留可挂的符号,且观测结果只覆盖被显式挂上探针的函数。
这一篇在知识体系里的位置
本篇是 eBPF 用户态追踪的专项实战:基础概念与语法承接 bpftrace 入门,结果判读与火焰图热点解读互补,分配器层面的争用机制在 ptmalloc/jemalloc/tcmalloc 实测,应用层绕开通用分配器的工程做法见 C++ arena/池化分配器基准。
实验环境
- 机器/系统:腾讯云 2 vCPU / 8 GiB 竞价实例,Ubuntu 22.04.5 LTS,内核 5.15.0-190-generic
- 工具版本:bpftrace 0.14.0(LLVM 后端,BTF 位于 /sys/kernel/btf/vmlinux)、gcc 11.4.0、glibc 2.35
- 日期:2026-11-17
- 完整命令序列:
make
sudo -E bash run.sh
# 脚本内部:非 PIE 编译 → ldd/readlink 解析 libc 路径 →
# bpftrace -c 拉起目标,5 秒一次快照,退出打印最终聚合 map代码获取:示例程序、bpftrace 脚本与运行脚本见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-bpftrace-malloc-stack-profiling/。克隆后 make && sudo -E bash run.sh 即可复现,原始聚合输出在 results/ 目录。
总结
bpftrace uprobe 可以在不重编、不重启目标的前提下把 malloc 归因到具体调用点;实测中 ustack 会被无帧指针的 glibc 截断,可靠做法是业务函数入口探针加非 PIE、noinline 编译;双指标聚合显示调用次数第一的 hot_path_a 只占 5% 字节,而 15% 次数的 loader_b 吃掉 85% 内存,次数与字节两个排名必须一起看,再用源码设计值逐项对账后才能下结论。