ext4 和 xfs 元数据性能差多少:2 万小文件创建、遍历与删除实测
业务里有一类服务天生不吃大文件吞吐而吃元数据操作:包管理解压、构建系统的产物目录、对象存储的本地缓存、邮件队列,每一项都是成千上万的小文件与目录项。给这类服务选文件系统时,ext4 和 xfs 是最常见的两个候选,网上的结论却经常互相矛盾——有人说 xfs 大文件强、小文件弱,有人说新版 ext4 早已追平。这些说法大多缺少同盘、同负载、同挂载选项的对照。本篇在一台 2 vCPU/8 GiB 云主机上,用同一块物理盘上的两个等大 loop 设备分别建 ext4 与 xfs,跑完全相同的 2 万小文件工作负载,把创建、遍历、删除三阶段的耗时逐项量出来。文件系统在 I/O 栈中的位置可先回顾存储性能观测全景:从块设备到文件系统,页缓存对读写测量的干扰见页缓存命中率怎么测:mincore 实测冷热读与直接 I/O 的真实差距。
本文要回答的问题
- 同样建 2 万个小文件,ext4 和 xfs 各花多少时间,差距有没有稳定性?
- 目录遍历加
lstat的组合成本,两个文件系统谁更快? - 删除为什么比创建便宜,两个文件系统的删除差距从哪来?
- loop 设备做对照会不会让结论失真,哪些边界必须交代清楚?
- 真实业务选型时,这组数据应该怎么用、不能怎么外推?
一、对照实验怎样只留一个变量
文件系统对比最容易犯的错误是变量不隔离:两块不同的盘、两套不同的挂载参数、两次运行时缓存状态不同,测出来的差距不知道该记在谁头上。本次实验把这些变量逐一钉死,只保留「文件系统实现」一个差异。
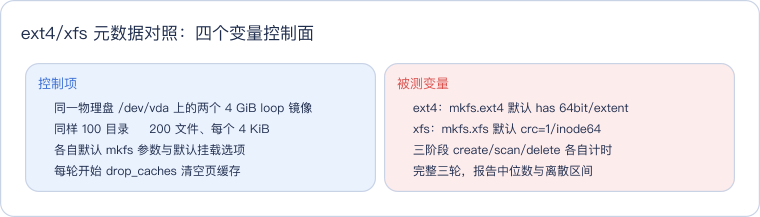
读这张对比卡抓住一条主线:所有物理条件都相同,loop 层带来的额外开销对两个文件系统完全一致,它只会同时抬高两者的绝对值,不会改变相对差距。
实验拓扑如下,两个 loop 设备背后是同一个物理盘上的两个独立镜像文件,各自挂载到独立目录,基准程序依次对两棵目录树做同样的操作。
图中绿色与橙色分别是两个被测文件系统的挂载点,蓝色是 loop 层,灰色是共享的物理盘。基准程序 meta_bench 用 CLOCK_MONOTONIC 自己给每个阶段打时间戳,输出墙钟毫秒与 ops/s,不依赖外部计时命令。
基准没有直接套用 filebench 之类的通用框架,而是自写约两百行 C 程序,原因是单变量对照对负载确定性的要求很高:filebench 的 fileserver 模型混合了创建、读、写、追加与属性操作,内部还有工作线程调度与 think time,报告数字里混着调度噪声,出了差距很难定位到具体的元数据操作。自写基准把负载钉死成「100 目录各 200 个 4 KiB 文件、三阶段顺序执行、单线程提交」,每个文件的操作路径完全一致,代价是放弃了综合负载的真实感——它回答的是「同一组元数据操作在两个文件系统上的成本差」,而不是「某台业务机换文件系统后整体快多少」,后者仍需用业务录制的 trace 另做回放。
二、创建 2 万文件:ext4 领先约 58%
创建阶段的工作内容是:先建 100 个目录,再在每个目录里 open 新建 200 个文件、写入 4 KiB 数据、关闭,全部完成后做一次 sync 把脏页和日志推下去。三轮的中位数如下。
| 文件系统 | 三轮中位耗时 | 中位 ops/s | 三轮区间 |
|---|---|---|---|
| ext4 | 482.80 ms | 41425 | 482.1–517.6 ms |
| xfs | 761.29 ms | 26271 | 557.3–788.6 ms |
ext4 的创建吞吐比 xfs 高约 58%。这个差距不是偶然的抖动:ext4 三轮都在 482–518 ms 的窄带里,xfs 第一轮 557 ms、后两轮升到 761–789 ms。第一轮偏快与 loop 镜像自身的块分配状态有关——镜像文件是 truncate 出来的稀疏文件,第一次写穿时宿主机物理块的分配摊薄了部分文件系统层面的差异;后两轮目录树被删了又建,镜像内部的空闲空间形态稳定,差距才显出稳态值。
先说明为什么选 4 KiB 这个尺寸。文件系统的创建成本由两部分构成:数据块写入与元数据事务;文件越小,元数据占比越高,4 KiB 恰好是常见页面大小与默认块尺寸,一次写满一个块、不触发额外的 extent 分裂,测得的差距几乎全部来自目录项、inode 与日志路径,正是本次要隔离的变量。若换成 1 MiB 大文件,数据块写入会主导耗时,两个文件系统在元数据上的差距会被摊薄到几个百分点以内,那将是另一个实验的命题。
差距的来源可以从两类元数据操作解释。创建一个文件要同时改三组结构:目录项(dentry)、inode 表、以及日志(journal/log)。ext4 的目录项默认走 htree 哈希索引,inode 与目录块在块组里尽量就近分配,4 KiB 小文件的数据块和 inode 常常落在同一个块组,机械层面的寻址跳转少。xfs 的元数据按 B+ 树组织,inode 64 位动态分配,每次创建还伴随 allocation group 内的空间管理事务;在单盘、小目录、小文件的场景里,B+ 树的多路更新与日志缓冲的固定开销摊不到足够多的并发上,单线程路径反而更重。
下图把三阶段的中位数放在同一根对数轴上,创建阶段两根柱子的高度差就是上面 58% 的来源。
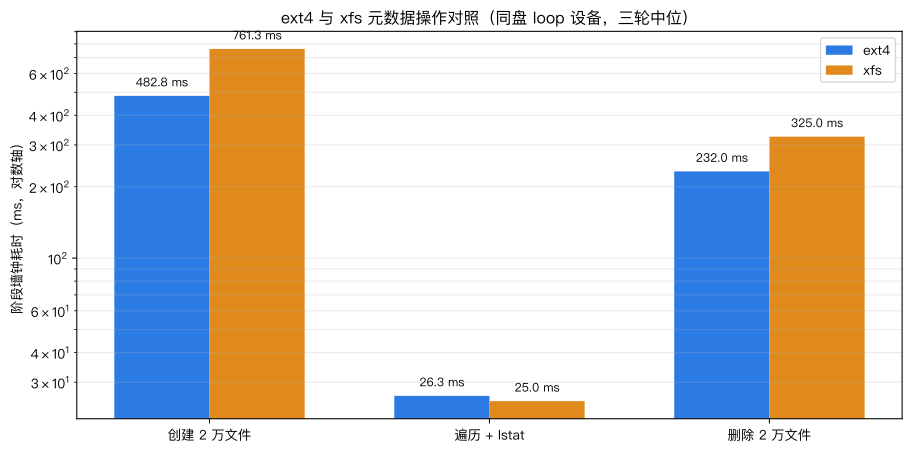
读图时注意纵轴是对数刻度:遍历阶段 25 ms 与创建阶段 500–760 ms 相差近 20 倍,线性轴会把短阶段压成看不见的一条缝,对数轴才能同时呈现三个量级。
三、遍历加 stat:xfs 反超约 5%
扫描阶段对每个目录 opendir/readdir 遍历全部目录项,并对每个文件做一次 lstat,统计的是「枚举目录项 + 取 inode 属性」的组合成本。
| 文件系统 | 三轮中位耗时 | 中位 ops/s | 三轮区间 |
|---|---|---|---|
| ext4 | 26.28 ms | 760910 | 26.3–27.1 ms |
| xfs | 24.97 ms | 801085 | 24.0–25.8 ms |
这一阶段方向反过来了:xfs 快约 5%,两者都在 25 ms 上下,绝对值差距只有 1.3 ms。遍历 2 万个目录项本质是顺序读目录块再批量查 inode,几乎没有写事务,xfs 的 B+ 树在纯读路径上的顺序扫描效率占了一点便宜;但这个差距在工程上接近噪声水平,不能作为选型主依据。
值得一提的是缓存状态。每轮扫描前都执行了 drop_caches,但创建阶段留下的元数据刚被写过、在页缓存里仍有热度,drop 之后重新读入的是 loop 镜像上的连续块,因此扫描能跑到每秒 76–80 万次操作。这说明「元数据慢」通常慢在写路径的事务与分配,而不是读路径的枚举。
再拆开看这 25 毫秒花在哪。readdir 只枚举目录项,ext4 的目录块与 xfs 的 B+ 树叶子在这种规模下都是一两轮顺序读就能拿全;真正按文件逐个发起的是 lstat,每一次都要按目录项里的 inode 号去查 inode 表,取大小、权限、时间戳等属性。2 万次 lstat 的 inode 访问是否连续,取决于创建时 inode 的分配位置——这也是为什么本实验把目录布局和创建顺序也钉成同一个变量。另外两边都挂着默认的 relatime,纯 lstat 不触发 atime 更新,扫描阶段没有隐藏的写回成本;如果业务挂载用了强制更新 atime 的 strict 模式,枚举路径会额外混入 inode 写,本篇的扫描数字就不能直接套用。
四、删除阶段:ext4 仍领先,但差距收窄到 40%
删除阶段逐个 unlink 全部文件再 rmdir 空目录,最后 sync。
| 文件系统 | 三轮中位耗时 | 中位 ops/s | 三轮区间 |
|---|---|---|---|
| ext4 | 231.98 ms | 86216 | 231.7–233.6 ms |
| xfs | 325.03 ms | 61532 | 318.2–325.2 ms |
删除比创建便宜,是因为它不写任何数据块,只回收目录项、inode 与空间记录,写事务的数量和体积都小一截。ext4 删除仍比 xfs 快约 40%,但相对差距比创建阶段的 58% 收窄——回收路径上 xfs 的 B+ 树删除与 extent 释放是相对成熟的路径,劣势没有创建时那么大。
三轮数据的离散度也值得看:ext4 三阶段的最大最小偏差都在 8% 以内(离散最大的 create 档约 7.4%),xfs 创建阶段第一轮与后两轮相差约 27%。做容量规划时,稳态值应取后两轮而不是首轮,这也是实验坚持三轮而不是一发定音的原因。
完整 18 行阶段记录原样摘录如下,每个 fs/round/phase 组合都可与公开仓库里的运行日志逐行对账。
-- fs=ext4 round=1 phase=create
fs=ext4 round=1 phase=create files=20000 dirs=100 elapsed_ms=517.634 ops_per_s=38637.3
-- fs=ext4 round=1 phase=scan
fs=ext4 round=1 phase=scan entries=20000 dirs=100 elapsed_ms=26.284 ops_per_s=760909.7
-- fs=ext4 round=1 phase=delete
fs=ext4 round=1 phase=delete files=20000 dirs=100 elapsed_ms=233.582 ops_per_s=85623.1
-- fs=xfs round=2 phase=create
fs=xfs round=2 phase=create files=20000 dirs=100 elapsed_ms=788.593 ops_per_s=25361.6
-- fs=xfs round=3 phase=delete
fs=xfs round=3 phase=delete files=20000 dirs=100 elapsed_ms=325.159 ops_per_s=61508.4
终端全景如下,18 行三阶段记录与环境信息同屏可见,注意 ext4 三行 create 稳定在 482–518 ms,xfs 后两轮 create 在 761–789 ms。
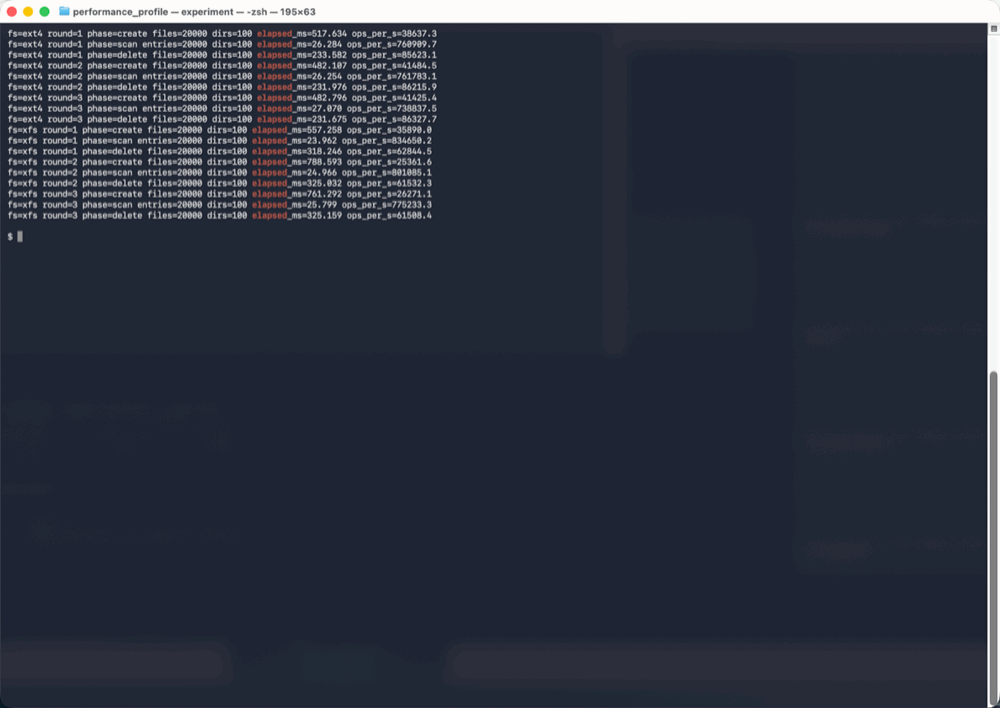
同一份日志的终端卡摘录了脚本启动段,内核版本、mkfs 版本与挂载选项是解读全部数字的前提。
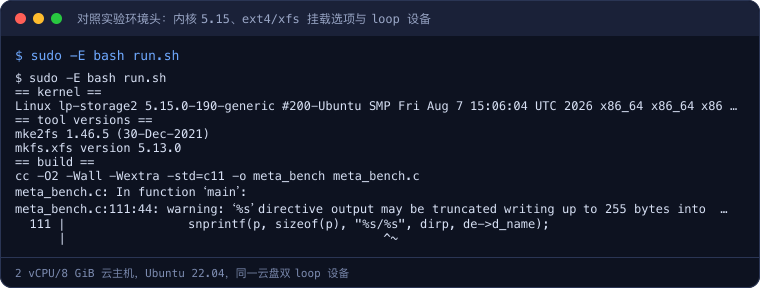
环境头里有两个数字决定结论的外推边界:ext4 的挂载选项是默认的 rw,relatime,xfs 显示为 rw,relatime,attr2,inode64,logbufs=8,logbsize=32k,noquota——后五个参数并非手动调优,而是 mkfs.xfs 默认几何在挂载时的回显,两边都没有人为加 nobh、logbsize= 之类的定制参数,因此反映的是「装机默认态」的差距;loop 设备的 I/O 多一层映射,绝对值不能直接等同于裸盘生产性能,但相对排序在同类云盘上成立。
五、选型决策:什么场景该把这组数据用上
把三阶段结果合起来看,可以得到一张按工作负载形态归类的决策表。
| 工作负载特征 | 更优选择 | 实测依据 |
|---|---|---|
| 海量小文件频繁创建/删除(解压、缓存、队列) | ext4 | 创建快 58%、删除快 40%,单线程写路径事务更轻 |
| 只读为主的目录枚举、扫描任务 | 两者接近 | 遍历仅差 5%(约 1.3 ms),按团队熟悉度选 |
| 大文件流式读写、高并发多线程 | 需另测 | 本实验单盘单线程小文件,不覆盖该场景 |
| 单目录百万级条目、超大容量卷 | 倾向 xfs | inode 动态分配与 AG 并行是结构性优势,需专项压测 |
最后两行的边界必须说清楚:本次测的是单块云盘、单线程基准、2 万文件的中小规模场景。xfs 的设计强项在高并发、大目录、大容量——多个 allocation group 可以并行处理不同线程的元数据事务,而本次只有一个线程提交操作,这项优势完全没有被激活。反过来,ext4 在小文件写路径上的领先也不应外推成「ext4 全面更快」,数据库大文件、并发 append、TiB 级卷上的结论需要另一组实验。
落地建议是:先按业务的真实操作比例(create/stat/delete 各占多少、线程数多少、单目录条目量级)设计对照,再用本篇的 meta_bench 改参数复现,而不是直接照搬任何一个百分比。
如果结论指向 ext4,迁移时还有两个工程细节要先验证。第一是日志模式:ext4 默认 data=ordered,元数据走日志、数据块先写盘再提交元数据事务,已经是一致性与性能的折中点;改成 data=writeback 能再压一点写延迟,但崩溃后可能出现陈旧数据块,不该为基准数字随意切换。第二是目录分片:单目录条目涨到十万级以上时,htree 索引的查找深度与目录块数量都会变化,本篇每目录 200 条的结论不能线性外推,落地前应按业务真实的单目录条目数重跑同一基准。反过来,如果业务后续要上 TiB 级卷或多线程并发创建,xfs 的 allocation group 并行才是主战场,那是另一组需要专门设计的实验,而不是本篇数据的延伸。
这一篇在知识体系里的位置
本篇补上了存储栈里「文件系统层」的实测一环:向上承接存储性能观测全景的观测指标体系,与直接 I/O 与页缓存、脏页回写调参共同覆盖缓存与回写路径;块设备层的队列行为见块设备队列深度:fio iodepth 1 到 32 的吞吐拐点与延迟代价。后续大文件与并发场景的对照将另开专篇。
实验环境
- 机器/系统:腾讯云 2 vCPU / 8 GiB 竞价实例,Ubuntu 22.04.5 LTS,内核 5.15.0-190-generic,单块 80 GiB 云盘
- 工具版本:mkfs.ext4(e2fsprogs 1.46.5)、mkfs.xfs 5.13.0、gcc 11.4.0;loop 设备两个 4 GiB 镜像
- 日期:2026-11-17
- 完整命令序列:
make
sudo -E bash run.sh
# 脚本内部:truncate 建双镜像 → losetup → mkfs.ext4/mkfs.xfs → 挂载 →
# 三轮 drop_caches + meta_bench create/scan/delete → trap 自动卸载清理代码获取:基准程序、Makefile 与对照脚本见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-filesystem-ext4-xfs-meta/。克隆后 make && sudo -E bash run.sh 即可复现,三轮原始日志在 results/ 目录。
总结
同盘双 loop 的 2 万小文件对照显示:创建阶段 ext4 以 482.8 ms 对 761.3 ms 领先约 58%,删除阶段领先约 40%,遍历加 stat 则是 xfs 以约 5% 的微弱优势反超;小文件频繁写删的业务默认选 ext4 有实测支撑,但这一结论不能外推到 xfs 擅长的大文件、高并发与超大目录场景。