块设备队列深度:fio 实测 iodepth 1 到 32 的吞吐拐点与延迟代价
调存储性能时,iodepth 是 fio 作业里最常被随手调大的参数,直觉是「队列越深、在途请求越多、吞吐越高」。这个直觉只对一半:在设备没有被压满之前,加深队列确实能喂饱后端;一旦撞上云盘的 QoS 上限,继续加深队列换不来一个 IOPS,只会把请求堆在块层队列里,尾延迟成倍上涨。本篇在一台 2 vCPU/8 GiB 云主机上,用 fio 加 libaio 跑 4K 随机读、direct=1,把块设备队列深度从 1 扫到 32,每档重复三轮,量化吞吐拐点在哪、拐点之后延迟付了多少代价。存储观测的整体坐标系可先回顾存储性能观测全景:从块层到文件系统的指标地图,fio 作业文件各参数的含义见fio 基准测试作业写法:job file 全参数解读。
本文要回答的问题
- 块设备队列深度在 Linux 块层里具体指哪一段队列,iodepth 调大之后请求堆积在什么位置?
- iodepth 从 1、2、4 加到 8、16、32,IOPS 分别是多少,吞吐拐点出现在哪一档?
- 为什么 iodepth 4 这一档三轮结果从 2459 漂到 6075 IOPS,云盘的突发信用机制如何干扰测量?
- 进入 QoS 平台之后,p50、p99、p99.9 延迟各上涨多少,能不能用 Little 定律对账?
- 线上业务应该把 iodepth 设成多少,什么条件下本篇的数字不能照搬?
先用一张流程卡把全篇的测量主线固定下来,卡中每个数字都来自后文 18 份 fio 原始 JSON 的汇总。
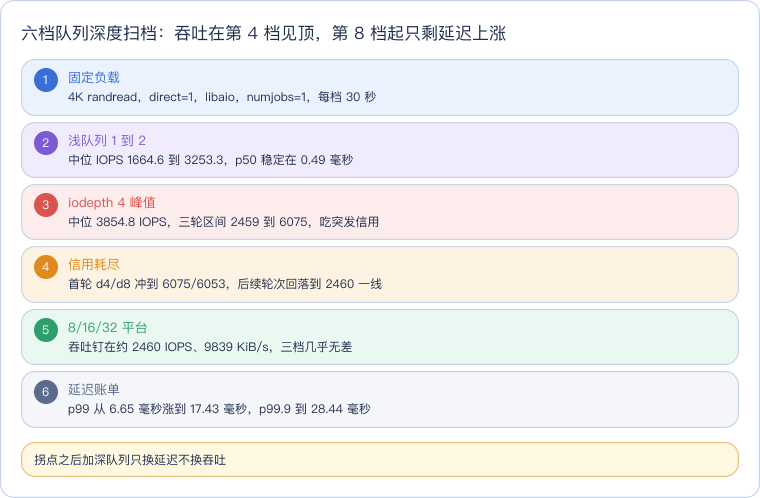
读这张卡抓住一条主线:前三步是吞吐随队列深度爬升的阶段,后三步是吞吐封顶、延迟独自上涨的阶段,分水岭就在 iodepth 4 到 8 之间。
一、块设备队列深度是什么:请求从 io_submit 到硬件队列
fio 的 iodepth 限制的是单个作业同时在途的异步 IO 数:作业通过 libaio 的 io_submit 一次性提交一批请求,在已提交但未完成的请求数达到 iodepth 之前不会阻塞,完成一个再补一个。这些请求进了内核之后要经过 blk-mq(多队列块层)的两级队列——先挂在软件队列上等待调度,再由调度器派发到硬件队列,最后由 virtio 驱动送给云盘后端。本篇环境里 nr_hw_queues 只有 1,调度器是 mq-deadline,iodepth 调大之后多出来的请求就堆积在软件队列与单条硬件队列入口处。
读这张图注意堆积点:云盘后端的处理能力是固定的 QoS 配额,当提交速率超过后端消化速率时,请求不会丢,而是逐级回压到硬件队列入口和软件队列里排队。iodepth 设的是「允许多少个请求同时在这条链路上」,队列越深,允许排的队越长,但队首请求的完成时间不受 iodepth 控制——它只取决于后端多快能放行。这正是后面平台期延迟线性上涨的根因。整条链路的事件级跟踪可以用 blktrace 跟踪块层 IO:从系统调用到设备完成 还原,而 direct=1 绕过页缓存的含义见直接 I/O 与页缓存:buffered IO、direct IO 与 O_SYNC 的取舍。
二、实验设计:六档深度乘三轮,专门暴露不稳定性
实验只动 iodepth 一个变量,其余参数全程固定,保证吞吐与延迟的变化只能归因于队列深度。作业文件用 2 GiB 测试文件、4K 块、随机读、直接 IO,单作业跑完 30 秒时间窗;iodepth 依次取 1、2、4、8、16、32,每档连跑三轮,共 18 次作业,全部输出 JSON 留档。
| 参数 | 取值 | 设计意图 |
|---|---|---|
| ioengine | libaio | 真异步,iodepth 才生效 |
| rw / bs | randread / 4k | 最小随机读,压后端 IOPS 而非带宽 |
| direct | 1 | 绕过页缓存,数字反映设备本身 |
| numjobs | 1 | 隔离 iodepth 单变量,不引入并发作业 |
| size / runtime | 2 GiB / 30 秒 | 时间窗足够长,避免冷启动主导均值 |
| iodepth | 1、2、4、8、16、32 | 倍增扫档,覆盖浅队列到深队列 |
| 重复轮次 | 3 轮 | 暴露云盘突发信用造成的档间漂移 |
这里有两个参数选择需要交代。其一,ioengine 必须是 libaio 这类真异步引擎:同步引擎下每个线程同一时刻只能有一个在途请求,iodepth 写得再大也退化成 1,实验的自变量直接失效;libaio 通过 io_submit 批量下发、io_getevents 收割完成,才允许单作业维持深度队列。其二,numjobs 固定为 1 是为了把「队列深度」与「并发作业数」两个变量彻底分开——多作业场景下总在途数是 numjobs 乘 iodepth 的乘积,混在一起测无法回答本篇的问题。
重复三轮是这套设计的关键。云盘普遍带突发信用(burst credit)机制:账户或卷上积累的信用额度允许短时间跑在基准 QoS 之上,额度耗尽后回落到保底性能。单轮测量很可能正好撞上信用窗口,把瞬时峰值当成可持续吞吐;三轮连跑让信用在第一轮被消耗,后两轮呈现的才是稳态。每次作业记录 IOPS、带宽、完成延迟的 p50/p99/p99.9/max,汇总表取三轮中位数,同时保留 min/max 区间用来判断稳定性。测试文件固定 2 GiB 并配合 norandommap、randrepeat=0,让每轮随机访问的块分布互不重复,避免缓存命中伪造设备性能。
三、吞吐曲线:第 4 档见顶,第 8 档进入 QoS 平台
六档三轮的中位结果如下,延迟单位从原始纳秒换算成毫秒,全部数字取自 18 份 JSON 的汇总。
| iodepth | IOPS 中位 | IOPS 三轮区间 | 带宽中位 | p50 | p99 | p99.9 |
|---|---|---|---|---|---|---|
| 1 | 1664.6 | 1136.2–2307.4 | 6658 KiB/s | 0.49 ms | 2.18 ms | 14.75 ms |
| 2 | 3253.3 | 2388.5–3566.4 | 13013 KiB/s | 0.49 ms | 2.24 ms | 14.61 ms |
| 4 | 3854.8 | 2459.3–6075.2 | 15419 KiB/s | 0.78 ms | 3.16 ms | 17.43 ms |
| 8 | 2460.0 | 2457.2–6053.0 | 9839 KiB/s | 3.16 ms | 6.65 ms | 19.27 ms |
| 16 | 2459.8 | 2459.7–2461.8 | 9839 KiB/s | 6.46 ms | 10.68 ms | 22.68 ms |
| 32 | 2459.5 | 2459.2–2459.9 | 9837 KiB/s | 13.04 ms | 17.43 ms | 28.44 ms |
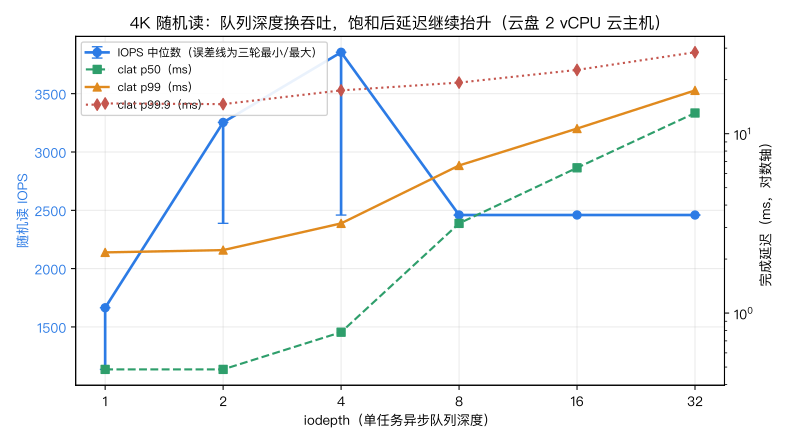
读这张图分两段。浅队列段,iodepth 1 到 2 的中位 IOPS 从 1664.6 接近翻倍到 3253.3,因为单请求串行下发时后端大量时间在等下一个请求,队列深度 2 就让管道里始终有活;iodepth 4 的中位达到全实验最高的 3854.8 IOPS、带宽 15419 KiB/s(约 15.1 MiB/s),但这一档的三轮区间宽得异常:2459.3 到 6075.2,最大值是最小值的 2.5 倍。对照原始轮次,第一轮 iodepth 4 跑出 6075.2、紧接着 iodepth 8 也有 6053.0,两个 6000 级读数都出现在信用充足的首轮;第二轮 iodepth 4 已经回落到 2459.3,第三轮为 3854.8。换句话说,3854.8 这个中位数本身是被突发信用抬高的,不代表可持续性能。
第二段从 iodepth 8 开始,曲线彻底躺平:8、16、32 三档中位 IOPS 分别是 2460.0、2459.8、2459.5,带宽都是 9839 KiB/s 上下(约 9.6 MiB/s),三轮区间在 16 和 32 两档收窄到不足 3 IOPS。这就是云盘的 QoS 保底平台,约 2460 次 4K 读每秒。带宽与 IOPS 在 4K 块大小下本就是同一枚硬币的两面:2460 乘 4 KiB 约等于 9840 KiB/s,与实测带宽逐项吻合,说明平台期没有出现请求合并或短读,每个完成的 IO 都是实打实的 4K 随机读。拐点因此有两个口径:峰值口径在 iodepth 4,但不可持续;稳态口径在 iodepth 8,再深的队列对吞吐毫无贡献。
四、延迟账单:Little 定律把平台期对账得严丝合缝
吞吐封顶之后,代价全部转移到延迟上。先看 p50:iodepth 1 和 2 都是 0.485 毫秒,说明浅队列下请求几乎不排队,完成延迟就是后端的裸处理时间;从 iodepth 8 起 p50 跳到 3.16 毫秒,16 档 6.46 毫秒,32 档 13.04 毫秒,几乎随队列深度线性翻倍。尾延迟涨得更猛,p99 从平台入口的 6.65 毫秒涨到 32 档的 17.43 毫秒,p99.9 从 19.27 毫秒涨到 28.44 毫秒;iodepth 1 时 p99.9 已有 14.75 毫秒,说明这块云盘即使空载也存在后端调度毛刺,深队列只是把毛刺整体抬高。
平台期的数字可以用 Little 定律严格对账。稳定系统里,系统中平均请求数 L 等于到达速率 λ 乘以平均逗留时间 W,即 L = λW;在 QoS 平台上 λ 钉在约 2460 IOPS,iodepth 就是系统中的平均在途请求数 L,于是预测平均完成时间 W = iodepth / IOPS。
| iodepth | Little 定律预测 W = d/IOPS | 实测 p50 | 偏差 |
|---|---|---|---|
| 8 | 8 / 2460.0 = 3.25 ms | 3.16 ms | 约 3% |
| 16 | 16 / 2459.8 = 6.50 ms | 6.46 ms | 约 1% |
| 32 | 32 / 2459.5 = 13.01 ms | 13.04 ms | 约 0.2% |
预测值与实测 p50 的偏差不超过 3%,这说明平台期的行为完全是一个固定服务率的排队系统:后端每秒放行约 2460 个请求,队列里排多少个,每个请求就老实地等多少个服务时隙。iodepth 从 8 加到 32,投入的在途请求翻了 4 倍,买到的 IOPS 一个没多,平均延迟却从 3.16 毫秒涨到 13.04 毫秒——这是一笔纯亏损的交换。反过来,Little 定律也给出了容量规划的反算法:知道设备保底 IOPS 和业务能接受的平均延迟,就能反推合理的队列深度上限,而不是凭感觉把 iodepth 写成 32 或 64。
五、原始记录对账:环境头、18 行汇总与终端全景
下面的终端卡摘录实验启动时的环境头,内核版本、调度器、硬件队列数与 fio 版本是解读全部数字的前提条件。
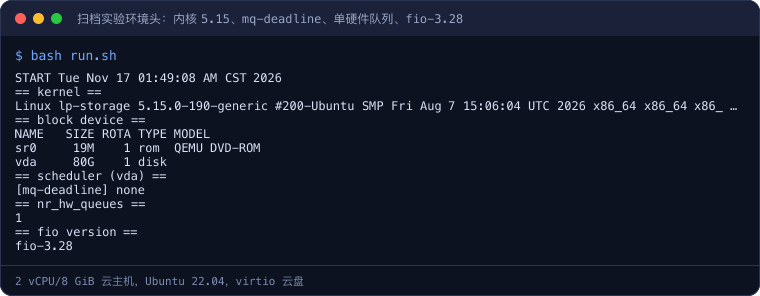
环境头里有两个数字决定了实验的外推边界:nr_hw_queues 为 1,意味着所有请求最终汇入一条硬件队列,不存在多队列并行摊薄延迟的空间;调度器是 mq-deadline,它会对饿死请求做截止时间提升,深队列下的尾延迟分布与 none 或 bfq 调度器不会完全相同。
18 次作业的汇总行原样摘录如下,每一行对应一个「轮次乘深度」组合,三轮的离散程度直接印证了第三节对突发信用的判断。
iodepth,iops_median,iops_min,iops_max,bw_KiBps_median,p50_ns_median,p99_ns_median,p999_ns_median,max_ns_median
1,1664.6,1136.2,2307.4,6658,485376,2179072,14745600,27273927
2,3253.3,2388.5,3566.4,13013,485376,2244608,14614528,30232463
4,3854.8,2459.3,6075.2,15419,782336,3162112,17432576,63959681
8,2460.0,2457.2,6053.0,9839,3162112,6651904,19267584,29784266
16,2459.8,2459.7,2461.8,9839,6455296,10682368,22675456,62719014
32,2459.5,2459.2,2459.9,9837,13041664,17432576,28442624,54964049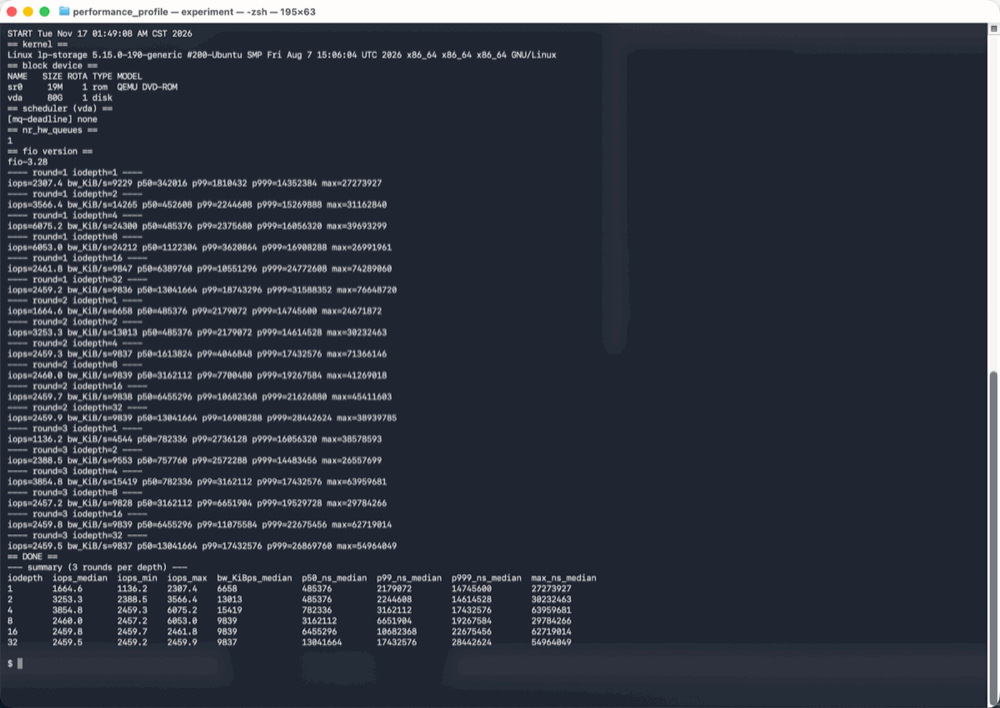
这一屏把 18 次作业的逐行输出按轮次排开,读的时候先纵向看第一轮:iodepth 4 和 8 两行的 IOPS 高悬在 6000 一线,与同档第二、三轮的 2460 形成刺眼落差,这就是突发信用窗口只在实验开头敞开的直接痕迹;再横向看 iodepth 16、32 两块,三轮读数齐刷刷钉在 2460 附近,说明信用耗尽后的平台测量重复性极好,平台结论不是单次偶然。max 列还有一个细节:iodepth 4 的最大延迟达到 63.96 毫秒、iodepth 16 为 62.72 毫秒,深队列与信用切换时刻都会制造偶发长尾,线上 SLO 若卡尾延迟,这类最大值比中位数更值得盯。日常巡检这类设备侧指标的工具口径见iostat 怎么看:tps、await、aqu-sz 与利用率的正确读法。
六、拐点判读与工程外推边界
把测量结果翻译成配置建议,要先分清两类业务目标。延迟敏感型业务(在线交易、元数据操作、同步日志)应守在浅队列:iodepth 1 到 2 的 p50 只有 0.49 毫秒、p99 约 2.2 毫秒,代价是吞吐上限 3300 IOPS 左右,且 iodepth 1 这一档三轮区间 1136 到 2307 本身也有波动,容量评估要按下沿做。吞吐优先型批处理可以把队列放到 4,但必须按保底值而非峰值做规划——iodepth 4 的 6075 IOPS 是信用窗口里的瞬时读数,可持续的只有 2460 一线;一旦业务本身是长时压测,信用会在开局几分钟内烧完,实测必然回落到平台。iodepth 8 以上在这块盘上没有任何存在意义:三档吞吐相同,32 档的 p99.9 却比 8 档贵出约 48%。
外推边界要讲清楚。第一,本篇全部数字绑定「单硬件队列、mq-deadline、virtio 云盘、4K 随机读、numjobs=1」这一配置;本地 NVMe 通常有多条硬件队列和几万 IOPS 的服务率,拐点位置深得多,需要重测。第二,numjobs 与 iodepth 是两个维度,多作业并发会同时抬高总在途数,云盘按卷限速时总吞吐仍撞同一道 QoS,但排队行为更接近多服务台模型,Little 定律里的 L 要换成所有作业在途数之和。第三,写流量、混合读写、更大块尺寸触发的是带宽或 IOPS 的不同限速维度,不能引用本篇的 IOPS 平台值;写路径还多出日志、缓存刷脏等环节,行为模型与纯读不同。第四,突发信用的额度与恢复速率因云厂商和卷规格而异,评测任何云盘都应像本篇一样连跑三轮以上、同时报告中位数与区间,只报单次峰值的基准报告没有规划价值。第五,调度器换成 none 或 bfq 后,深队列的派发顺序与尾延迟分布会改变,平台吞吐大概率重合,但 p99.9 的具体毫秒数不能照搬。
实验环境
- 机器/系统:云主机 2 vCPU / 8 GiB,Ubuntu 22.04,内核 5.15.0-190-generic(x86_64),virtio 块设备 vda 80G,单硬件队列(nr_hw_queues=1),调度器 mq-deadline
- 工具版本:fio-3.28,ioengine=libaio,direct=1,4K randread,测试文件 2 GiB,每档 runtime=30 秒、time_based=1,numjobs=1
- 日期:2026-11-17
- 完整命令:
bash run.sh;脚本先输出uname -a、块设备清单、/sys/block/vda/queue/scheduler、硬件队列数与fio --version,随后按 round=1..3、iodepth=1/2/4/8/16/32 双层循环执行IOD=$d fio iodepth.fio --output-format=json,每份 JSON 落盘并实时摘出 iops、bw、p50、p99、p99.9、max 一行,18 档跑完后删除测试文件
代码获取
代码获取:完整 fio 作业文件、扫档脚本与 18 份原始 JSON 见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-blk-mq-iodepth-scaling/。克隆后 bash run.sh 即可复现。
这一篇在知识体系里的位置
本篇属于 Linux 存储栈实测系列的块层队列专题,向上承接块层与 IO 栈的整体地图:存储性能观测全景 给出从文件系统到设备的指标坐标系,直接 I/O 与页缓存 解释了本篇 direct=1 为什么是必要前提。工具链上,fio 作业各参数的完整语义见fio 基准测试作业写法,线上验证队列堆积与设备延迟用iostat 怎么看,需要把请求在块层的排队过程逐事件还原时用blktrace 跟踪块层 IO。这套「固定单变量、多轮重复、中位数加区间、Little 定律对账」的实测方法,与同站点内存子系统的实测篇目共用同一套证据口径。
总结
在单硬件队列、mq-deadline 的 virtio 云盘上,块设备队列深度从 1 扫到 32 的结论分两段:iodepth 1 到 4 是吞吐爬升段,中位 IOPS 从 1664.6 涨到峰值 3854.8,但第 4 档三轮区间宽达 2459 到 6075,高读数来自云盘突发信用、不可持续;信用耗尽后 iodepth 8、16、32 三档全部钉在约 2460 IOPS、9839 KiB/s 的 QoS 平台,吞吐零增益,p50 却从 3.16 毫秒涨到 13.04 毫秒,p99 从 6.65 涨到 17.43 毫秒,p99.9 到 28.44 毫秒。平台期实测 p50 与 Little 定律预测值偏差不超过 3%,证明深队列只是在固定服务率的排队系统里拉长等待时间。工程上延迟敏感业务守 iodepth 1 到 2,吞吐型业务最多放到 4 且按保底值规划,8 以上纯属为延迟付费;所有数字只对本机型与本配置成立,换 NVMe、换调度器、换读写模型都需要按同样的多轮扫档方法重新实测。