page cache 命中率怎么测:mincore 实测冷热读与直接 I/O 的真实差距
很多人判断一段存储负载快不快,习惯问一句「走没走 page cache」。走缓冲 I/O 就预期命中内存、延迟低微秒级;走 O_DIRECT 就预期绕过缓存、延迟是磁盘级。这个二分法在数据集稳定小于内存时大致成立,但在小内存虚拟机、云盘有 QoS 限速、页缓存被持续回收的真实环境里,它会给出方向性错误的结论。本篇用一台 2 vCPU / 8 GiB 的云主机,把一个 512 MiB 文件在四种读路径下各跑三轮,用 mincore(2) 直接数驻留页、用 /proc/diskstats 核对真实落盘读取,把 page cache 命中率从「感觉」变成可复现的数字。缓冲 I/O 与直接 I/O 的机制差异先放在 直接 I/O 与页缓存怎么选,本篇只回答「命中率怎么量、量出来差多少」。
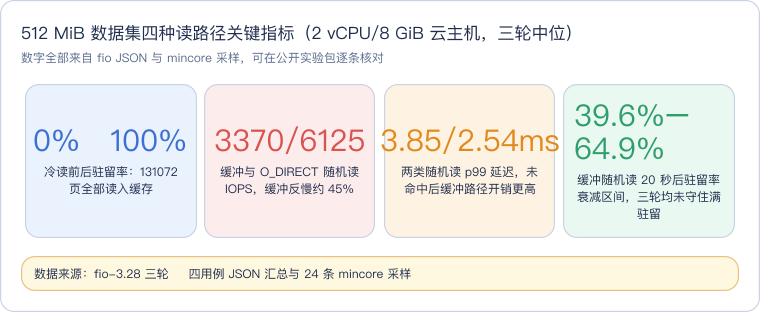
这张卡先给出全篇的量级锚点:前两个数字描述同一件事的两面——冷读确实把文件完整带进了缓存,但缓存没能守住;后两个数字说明驻留率塌方之后,缓冲路径在延迟和吞吐上都输给了直接 I/O。后面各节会用 mincore 轨迹与 diskstats 对账,逐一解释这些数字是怎么产生的。
本文要回答的问题
- 一个文件当前到底有多少页在页缓存里,除了看
/proc/meminfo的 Cached 总账,有没有按文件量化的手段? - 冷读把文件读进缓存后,再读一遍(热读)一定更快吗?在小内存虚拟机上会不会反而更慢?
- 缓冲随机读开局 100% 驻留,为什么跑着跑着性能衰减到只有
O_DIRECT的一半? - 云盘 QoS 把直接 I/O 压在稳定的 6k IOPS 时,缓冲路径的页查找与回收成本会怎样改写对比结果?
- 自己上手测 page cache 命中率,需要哪几个一手数据源,各自回答什么问题?
一、命中率是变量,不是「是否 buffered」的开关
页缓存的基本模型不复杂:read() 进入 VFS 后先在文件的 address_space 页树里按偏移查页,命中就把页内容拷到用户态缓冲区返回,未命中才分配新页、向块层提交 bio 从设备读入,读回的页留在缓存里供后续访问。同一次缓冲读,命中与未命中的延迟可以差出两到三个数量级,所以决定性能的不是「走没走缓冲路径」,而是这条路径上命中的比例——也就是 page cache 命中率。
下图把读路径与本篇的观测点画在一起。命中分支在页缓存处短路返回,未命中分支才下沉到块层与云盘;右侧的 mincore 观测工具只查询页的驻留位,本身不触发任何磁盘 I/O,因此可以在负载前后无损采样。
读这张图抓住两条分支:命中分支不出页缓存,延迟由内存拷贝与页树查找决定;未命中分支要绕行块层和云盘,延迟由设备决定。观测工具挂在页缓存侧面而不是 I/O 路径上,这是它能给出「真实命中率」而不是「估算命中率」的关键——bcc 工具集里的 cachestat 走的是内核命中率计数(hits/misses 累加),适合在线观察趋势;而 mincore(2) 直接回答「这个文件的哪些页此刻在内存里」,适合实验中对单个数据集做精确切片。
二、两个一手数据源:mincore(2) 数页,diskstats 对账
只看一个数据源容易自欺欺人,本篇的量化建立在两份可以交叉对账的记录上。
第一份是 mincore(2)。系统调用的入参是一段 mmap 映射与长度,内核在向量里逐页回填驻留位,最低位为 1 表示该页在内存中。注意映射时要用 PROT_NONE:只占虚拟地址空间、不授予读写权限,mincore 不会因此触发缺页读盘,采样动作对缓存状态零扰动。核心实现只有二十来行:
void *map = mmap(NULL, st.st_size, PROT_NONE, MAP_PRIVATE, fd, 0);
if (map == MAP_FAILED) { perror("mmap"); return 1; }
if (mincore(map, st.st_size, vec) < 0) { perror("mincore"); return 1; }
size_t resident = 0;
for (size_t i = 0; i < pages; i++)
    if (vec[i] & 1) resident++;
printf("resident_pages=%zu total_pages=%zu resident_ratio=%.2f%%\n",
       resident, pages, 100.0 * resident / pages);
512 MiB 文件按 4 KiB 页算共 131072 页,工具输出驻留页数与驻留百分比。它给出的是某一时刻的驻留率快照,负载前后各采一次,就能算出这个文件在负载期间被回收了多少页。
第二份是 /proc/diskstats。每个设备一行计数器,第三列是累计读扇区数(每扇区 512 字节),第一列是累计读完成次数。在每个用例前后各取一行做差,就知道这次 fio 运行真实从云盘读了多少数据、发了多少个 I/O。mincore 回答「页在不在内存」,diskstats 回答「有没有真的读盘」,两者对得上,结论才站得住。辅助侧证用 /proc/meminfo 的 Cached 与 Dirty 看全局缓存水位的涨跌。页缓存回收与 slab 的关系可以对照 slabtop 与页缓存回收 进一步展开。
三、实验设计:一个数据集,四条读路径,三轮重复
数据集固定为一个 512 MiB 的文件 cache-test.bin,块大小统一 4 KiB,I/O 引擎 libaio。有两个设计细节直接决定结论是否可信。
第一,数据集用 O_DIRECT 预写。普通缓冲写会把 512 MiB 数据全部带进页缓存,开局就不是冷的;预写时加 --direct=1 绕过缓存,写完再 sync,保证实验开始前文件对页缓存是「干净陌生」的。
第二,每轮开头执行 echo 3 > /proc/sys/vm/drop_caches 清干净页缓存,再按固定顺序跑四个用例,每个用例前后都采 meminfo、diskstats 与 mincore 三样,整套序列重复三轮:
| 用例 | 访问模式 | direct | iodepth | 时长/范围 | 设计意图 |
|---|---|---|---|---|---|
| cold-seq | 顺序全文件读 | 0 | 1 | 读完 512 MiB | 冷读,测未命中路径的真实带宽 |
| hot-seq | 顺序全文件读 | 0 | 1 | 读完 512 MiB | 紧接冷读,mincore 显示 100% 驻留 |
| rand-cached | 随机读 | 0 | 8 | 20 秒 | 开局全驻留,观察驻留率衰减过程 |
| rand-direct | 随机读 | 1 | 8 | 20 秒 | 绕过页缓存的对照组 |
fio 作业用环境变量切换 rw、direct、iodepth 与 runtime,同一份 read.fio 支撑四个用例,作业文件的完整写法与参数含义见 fio 基准测试作业写法。随机读加了 norandommap=1 与 randrepeat=0,避免访问图案被 fio 的默认映射「记住」而虚高命中率。
四、驻留率轨迹:0% → 100% → 衰减 → 归零
三轮实验共采到 24 条 mincore 记录,每个用例前后各一条。第一轮的完整轨迹如下,这是全篇最核心的一份原始记录:
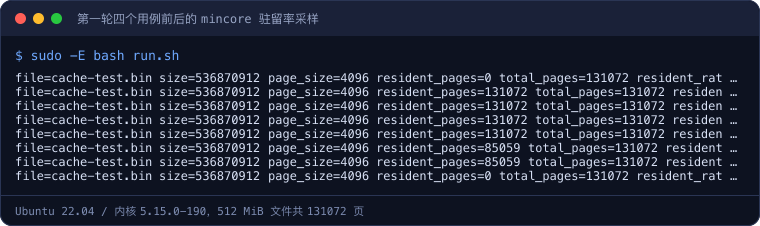
读这八行要按用例边界切成四段。drop_caches 之后起点是 0.00%,缓存里一个文件页都没有;冷顺序读把 131072 页全部读入,冷读结束与热读开始前都是 100.00%;热读之后驻留率仍是 100.00%,说明热读本身没有驱逐这个文件的页;真正的衰减发生在缓冲随机读期间,采样掉到 64.89%(85059 / 131072 页);最后的 0.00% 出现在 O_DIRECT 随机读之后——直接 I/O 路径在读穿缓存的同时会失效该文件的缓存页,Cached 总账同步从 594896 kB(约 581 MiB)跌到 254708 kB(约 249 MiB)。
三轮的衰减终点并不相同,下图把三轮驻留率阶梯与四个用例的 IOPS 放在一起对照。左半的阶梯图是三轮各自的完整生命周期,右半的柱状图是三轮 IOPS 中位数:
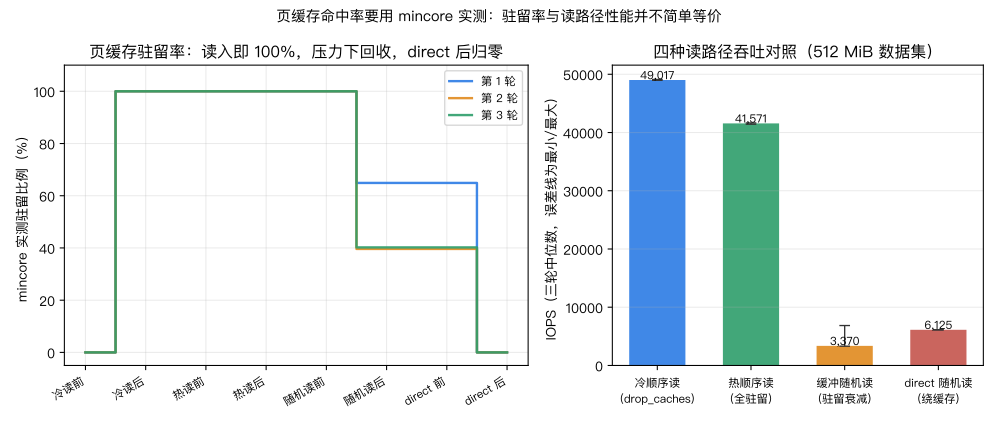
左半图里三轮的前半段完全重合(0% 到 100% 的冷读填充、热读期间维持满驻留),分叉点在缓冲随机读:第一轮衰减到 64.89%,第二、三轮分别衰减到 39.63% 与 40.22%,而三个 direct 用例之后无一例外回到 0%。右半图的性能序与直觉相反:两个顺序读在四万到五万 IOPS 一档,缓冲随机读只有 3370 IOPS,反而比 direct 随机读的 6125 IOPS 低了近一半。柱状的高低和驻留率阶梯的走势要连起来读——随机读的性能差距正是在驻留率衰减的过程里拉开的。
终端汇总视图把 mincore 采样与 fio 摘要排在同一屏,驻留百分比、IOPS 与带宽逐行对应,可以直接核对每个数字出自哪一轮的哪个用例:
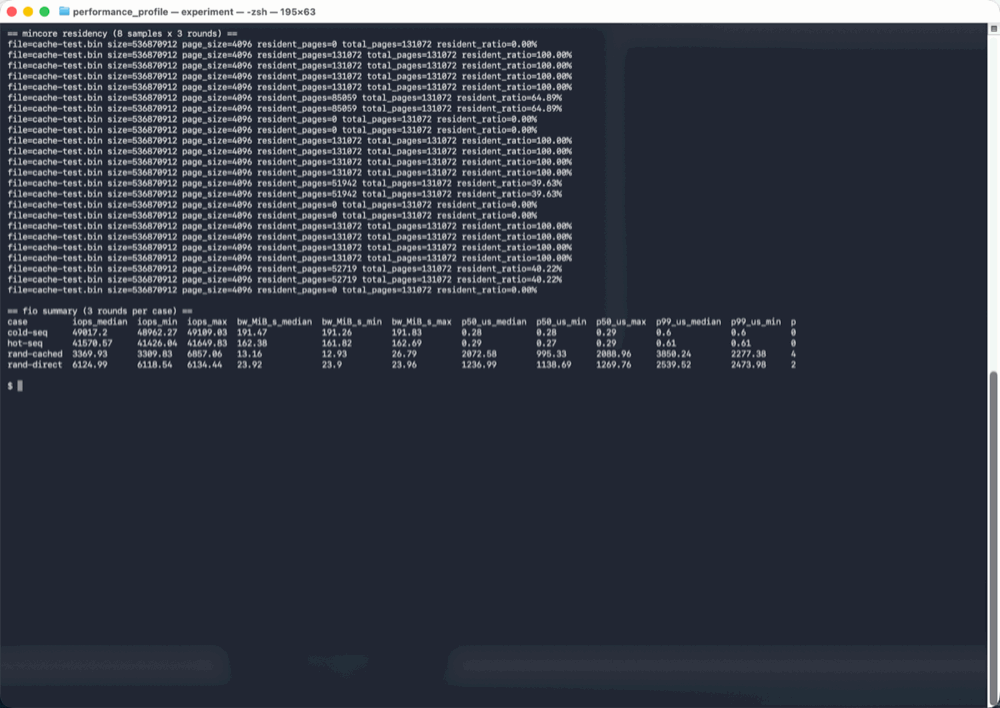
这张汇总里值得停留的是 rand-cached 一行:三轮成绩 6857、3310、3370 IOPS,波动远大于其他三个用例。原因就在它上方的驻留率列——第一轮衰减终点 64.89%,开局高驻留阶段贡献了大量命中,把均值拉到 6857;后两轮内存水位更紧,衰减到四成左右,命中率塌方后均值直接腰斩。用例间的稳定性差异本身就是结论:direct 路径三轮极差只有 16 IOPS,而缓冲路径的成绩随回收节奏漂移。
五、四用例性能对照与两个反直觉结果
三轮中位数汇总如下,全部数字取自 fio JSON 输出与 summary.csv,没有人工修饰:
| 用例 | IOPS 中位(区间) | 带宽 MiB/s | p50 | p99 | 用例后驻留率 |
|---|---|---|---|---|---|
| cold-seq | 49017(48962–49109) | 191.5 | 0.28 µs | 0.60 µs | 100% |
| hot-seq | 41571(41426–41650) | 162.4 | 0.29 µs | 0.61 µs | 100% |
| rand-cached | 3370(3310–6857) | 13.2 | 2073 µs | 3850 µs | 39.6%–64.9% |
| rand-direct | 6125(6119–6134) | 23.9 | 1237 µs | 2540 µs | 0%(缓存失效) |
case,iops_median,iops_min,iops_max,bw_MiB_s_median,bw_MiB_s_min,bw_MiB_s_max,p50_us_median,p99_us_median,p999_us_median
cold-seq,49017.2,48962.27,49109.03,191.47,191.26,191.83,0.28,0.6,1.3
hot-seq,41570.57,41426.04,41649.83,162.38,161.82,162.69,0.29,0.61,1.48
rand-cached,3369.93,3309.83,6857.06,13.16,12.93,26.79,2072.58,3850.24,5603.33
rand-direct,6124.99,6118.54,6134.44,23.92,23.9,23.96,1236.99,2539.52,4145.15
反直觉之一:热顺序读没有更快,反而慢了 15%
冷读 49017 IOPS、191.5 MiB/s,热读 41571 IOPS、162.4 MiB/s。mincore 明明显示热读全程 100% 驻留,为什么热读更慢?diskstats 的对账拆穿了「100% 驻留 = 零读盘」的想当然。第一轮热读期间,vda 累计读扇区从 28391909 涨到 29441261,净增 1049352 个扇区,折合 512.4 MiB——几乎等于整个文件的大小;第二轮同样净增 1052576 扇区(约 514 MiB),读 I/O 请求数增加约两千次。
机理是顺序读的预读抖动。内核看到顺序访问会按窗口递增预读,新预读进来的页需要缓存槽位;这台虚拟机只有 8 GiB 内存、缓存水位本来就紧,旧页被不断挤走,下一轮扫描到文件后段时,前段被挤走的页又要重新读盘。于是「100% 驻留」只是每个采样瞬间的切面,动态过程里页在持续进出。缓冲路径还比直接路径多一次内核页到用户态缓冲区的拷贝,带宽口径上再吃一道亏。冷读反而占了「缓存全空、预读页全部立刻被消费」的便宜,没有抖动。
反直觉之二:缓冲随机读跑不过 O_DIRECT
3370 对 6125 IOPS,p99 延迟 3.85 ms 对 2.54 ms,缓冲路径全面落后。把驻留率轨迹和 diskstats 拼起来看,原因有两层。
第一层是命中率塌方后的固定开销照付。随机读 20 秒内驻留率从 100% 衰减到四到六成半,未命中的访问同样要走查页、分配缓存页、等待 I/O、回填页树的完整流程,命中的访问才省掉设备等待;衰减之后大量请求两头的成本都付了——先付页树查找的钱,再付读盘的钱。diskstats 显示第一轮缓冲随机读期间真实读盘约 332 MiB、后两轮各约 203–208 MiB,与驻留率跌幅吻合。
第二层是云盘 QoS 把 direct 路径托在一个稳定的高位。direct 随机读三轮稳定在 6125 IOPS 附近、带宽 23.9 MiB/s,极差极小,说明云盘把这个实例的随机读额度钉在约 6k IOPS。direct 路径没有页查找、没有回收压力,I/O 直接下发,把额度吃得很满;缓冲路径在同等额度下还要穿插内存管理开销与预读干扰,吞吐自然落在额度线以下。这个对比的适用边界要讲清楚:它成立于「数据集大于有效缓存、设备有稳定 QoS 上限」的云主机场景;如果数据集真的放得下内存、驻留率能维持在接近 100%,缓冲随机读仍是微秒级延迟的赢家,不要把本篇结论外推成「direct 总是更快」。
六、把命中率测量用到自己的系统上
实验方法可以直接迁移到生产排障,按粒度选工具。
在线趋势观察用 cachestat(bcc/eBPF 版本),它每秒输出 hits、misses 与命中率,适合回答「这个实例整体的页缓存效率在掉吗」;它的口径是全系统计数,不区分文件。需要按文件量化时,用本篇的 mincore 采样法:对目标文件 mmap 加 mincore(2),在业务高峰前后或压测各相位取样,得到该文件的驻留率变化曲线。怀疑「名义热读实则在读盘」时,用 /proc/diskstats 前后两行做差对账:每个扇区固定 512 字节,读扇区增量乘以 512 就是真实读盘字节数(除以 2 得到的是 KiB 数),再与 mincore 的驻留页变化交叉验证。更系统的存储观测指标布局见 存储性能观测全景。
判读时记住三条经验:其一,驻留率是瞬时切面,100% 不代表负载期间零读盘,必须配 diskstats 对账;其二,驻留率衰减速度比绝对值更能说明问题,持续下滑意味着缓存相对数据集太小或被邻居负载挤压;其三,缓冲与 direct 的选型要在实测命中率下做,而不是在「buffered 等于命中」的假设上做。
实验环境
- 机器/系统:2 vCPU / 8 GiB 云主机,Ubuntu 22.04,内核 5.15.0-190-generic,数据盘 vda(virtio-blk 云盘)
- 工具版本:fio-3.28,libaio I/O 引擎;自写 mincore_check(gcc 编译,mmap + mincore(2) 统计驻留页)
- 日期:2026-11-17
- 数据集:512 MiB 单文件,4 KiB 块,
O_DIRECT预写避免污染缓存;每轮先echo 3 > /proc/sys/vm/drop_caches - 完整命令序列:
fio --name=prep --filename=cache-test.bin --ioengine=libaio --rw=write \
    --bs=1m --size=512m --direct=1 --group_reporting
sync
sudo sh -c 'echo 3 > /proc/sys/vm/drop_caches'
# 四个用例由 run.sh 按 cold-seq / hot-seq / rand-cached / rand-direct 顺序驱动,
# 每个用例前后采集 /proc/meminfo、/proc/diskstats 与 mincore_check,整套重复三轮
sudo -E bash run.sh代码获取:mincore(2) 观测小工具、fio 作业与三轮原始数据见公开仓库 derekzhuo/geek-doc.cn 的
experiments/linux-page-cache-hit-ratio-measure/。克隆后make && sudo -E bash run.sh复现。
这一篇在知识体系里的位置
本篇属于存储栈中「页缓存有效性」的实测环节。机制层面,缓冲 I/O 与直接 I/O 的完整数据流与选型框架在 直接 I/O 与页缓存怎么选,本篇给它补上了量化命中率的方法与一组反直觉证据;工具层面,fio 作业参数与压测设计见 fio 基准测试作业写法,缓存回收与 slab 水位的观测见 slabtop 与页缓存回收,整套存储指标的分工见 存储性能观测全景。内存侧的回收压力与 OOM 背景则与内存调优类文章相邻,理解驻留率为什么会衰减时可以对照阅读。
总结
page cache 命中率是必须实测的变量:mincore(2) 按文件数驻留页、/proc/diskstats 对账真实读盘,两份一手数据交叉才能还原真相。本次 512 MiB 数据集实测中,热顺序读在 100% 驻留下仍因预读抖动读盘约一个文件大小、反慢于冷读 15%;缓冲随机读的驻留率从 100% 衰减到 39.6%–64.9%,未命中后页查找与回收成本照付,3370 IOPS 跑不过云盘 QoS 托底、稳定在 6125 IOPS 的 O_DIRECT。「走没走 buffered」决定不了性能,实测出来的命中率才可以。